
데모용 AI 에이전트를 만드는 것과 4,000만 개발자 를 위한 에이전트를 운영하는 것은 서로 다른 엔지니어링 문제입니다. Postman은 Agent Mode, 즉 API 테스트, 문서화, 탐색, 구현 전반에 걸쳐 AI 네이티브 방식으로 작업할 수 있는 방법을 만들기 시작했습니다. 팀은 모델 품질과 프롬프트 설계가 가장 어려운 문제일 것이라고 예상했습니다. 더 깊은 과제는 수년간 인터페이스 중심의 가정, 넓은 표면적, 전문화된 개념을 가진 성숙한 제품에 에이전트를 통합하는 데서 비롯되었습니다.
이 게시물에서 Postman과 AWS는 성숙한 제품을 AI 에이전트가 이해할 수 있게 만드는 과정에서 나타난 아키텍처 패턴을 설명합니다. 이러한 패턴에는 도구 확산 제어, 스키마 기반 읽기 노출, 기능이 아닌 컨텍스트를 주요 병목으로 취급하는 것이 포함됩니다.
또한 Agent Mode 가 Amazon Bedrock 을 사용하여 모델 유연성, 지리적으로 범위가 지정된 교차 리전 추론, 모델별 영데이터 보존(zero data retention), 다층 프롬프트 캐싱을 구현하는 방법도 설명합니다. 이러한 교훈은 팀이 프로덕션 에이전트를 프로토타입 이상으로 발전시키는 데 도움이 될 수 있습니다.
Postman이 Agent Mode를 만든 이유
Agent Mode 는 테스트, 문서화, 탐색, 구현 전반에서 AI 네이티브 방식으로 제품과 작업하기 위한 Postman의 진입점입니다. Postman은 11년에 걸쳐 발전해 왔으며, 개발자와 사용자는 사이드바를 확장하거나, 탭을 확인하거나, 요청을 열면서 인터페이스를 통해 정보를 찾는 법을 익혔습니다. 그 인식을 에이전트를 위해 다시 설계하는 과정은 제품의 API, 사용자 경험, 제품 지식 분배에 있는 구조적 가정을 드러냈습니다. 에이전트는 화면을 탐색하는 대신 데이터를 기반으로 추론합니다. 그림 1은 Agent Mode가 애플리케이션과 직접 작동하는 방식을 보여줍니다.
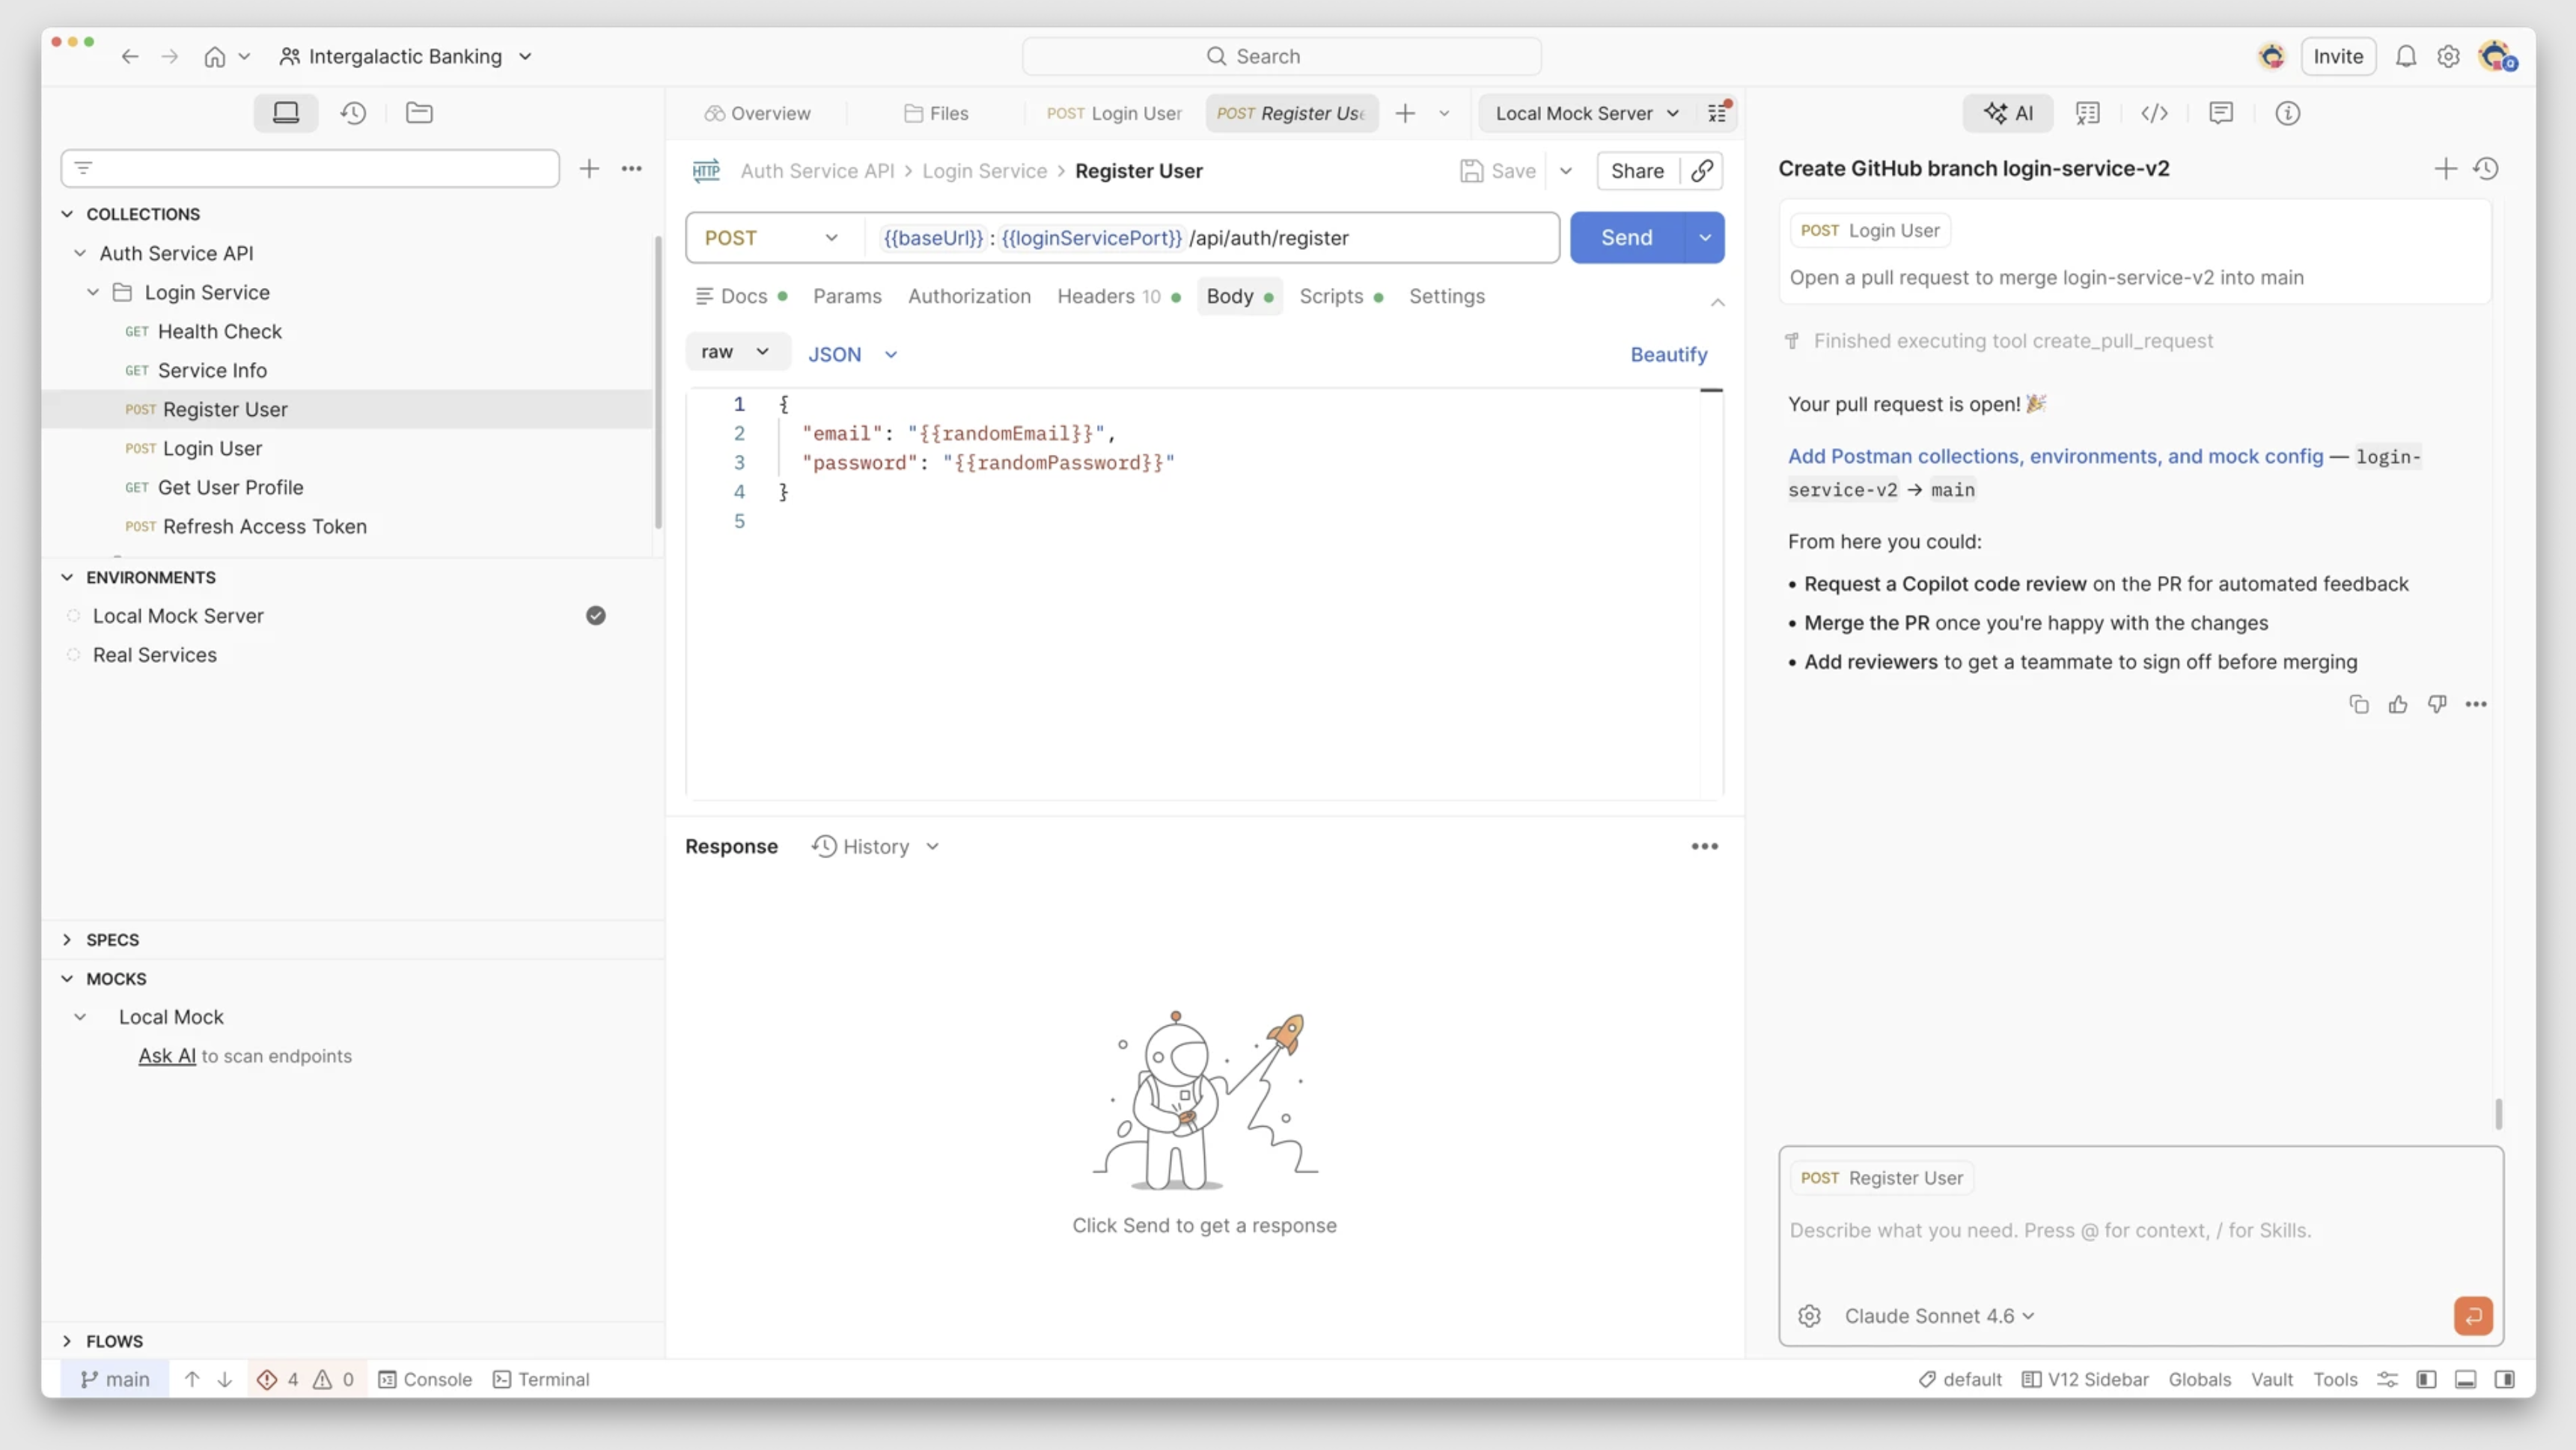
그림 1: Agent Mode는 Postman 애플리케이션과 직접 작동합니다. 이 예시에서는 사용자가 인터페이스를 탐색할 필요 없이 풀 리퀘스트를 열고 다음 단계를 제안합니다
Agent Mode 는 Amazon Bedrock에서 실행되며, 이는 에이전트 뒤에 있는 파운데이션 모델에 대한 관리형 액세스를 제공합니다. Postman의 글로벌 개발자 커뮤니티를 지원하는 것은 급격한 트래픽 폭증을 수반하는 가변적이고 지연 시간에 민감한 수요를 만들어냅니다. Amazon Bedrock을 통해 Postman은 자체 모델 서빙 인프라를 운영하지 않으면서도 이 프로덕션 워크로드를 확장할 수 있고, 모델 선택의 유연성과 처리량, 지리적 처리, 비용에 대한 제어권을 유지할 수 있습니다. 그림 2는 다음 섹션에서 구성 요소를 살펴보기 전에 프로덕션 아키텍처에 대한 개략적인 보기를 제공합니다.
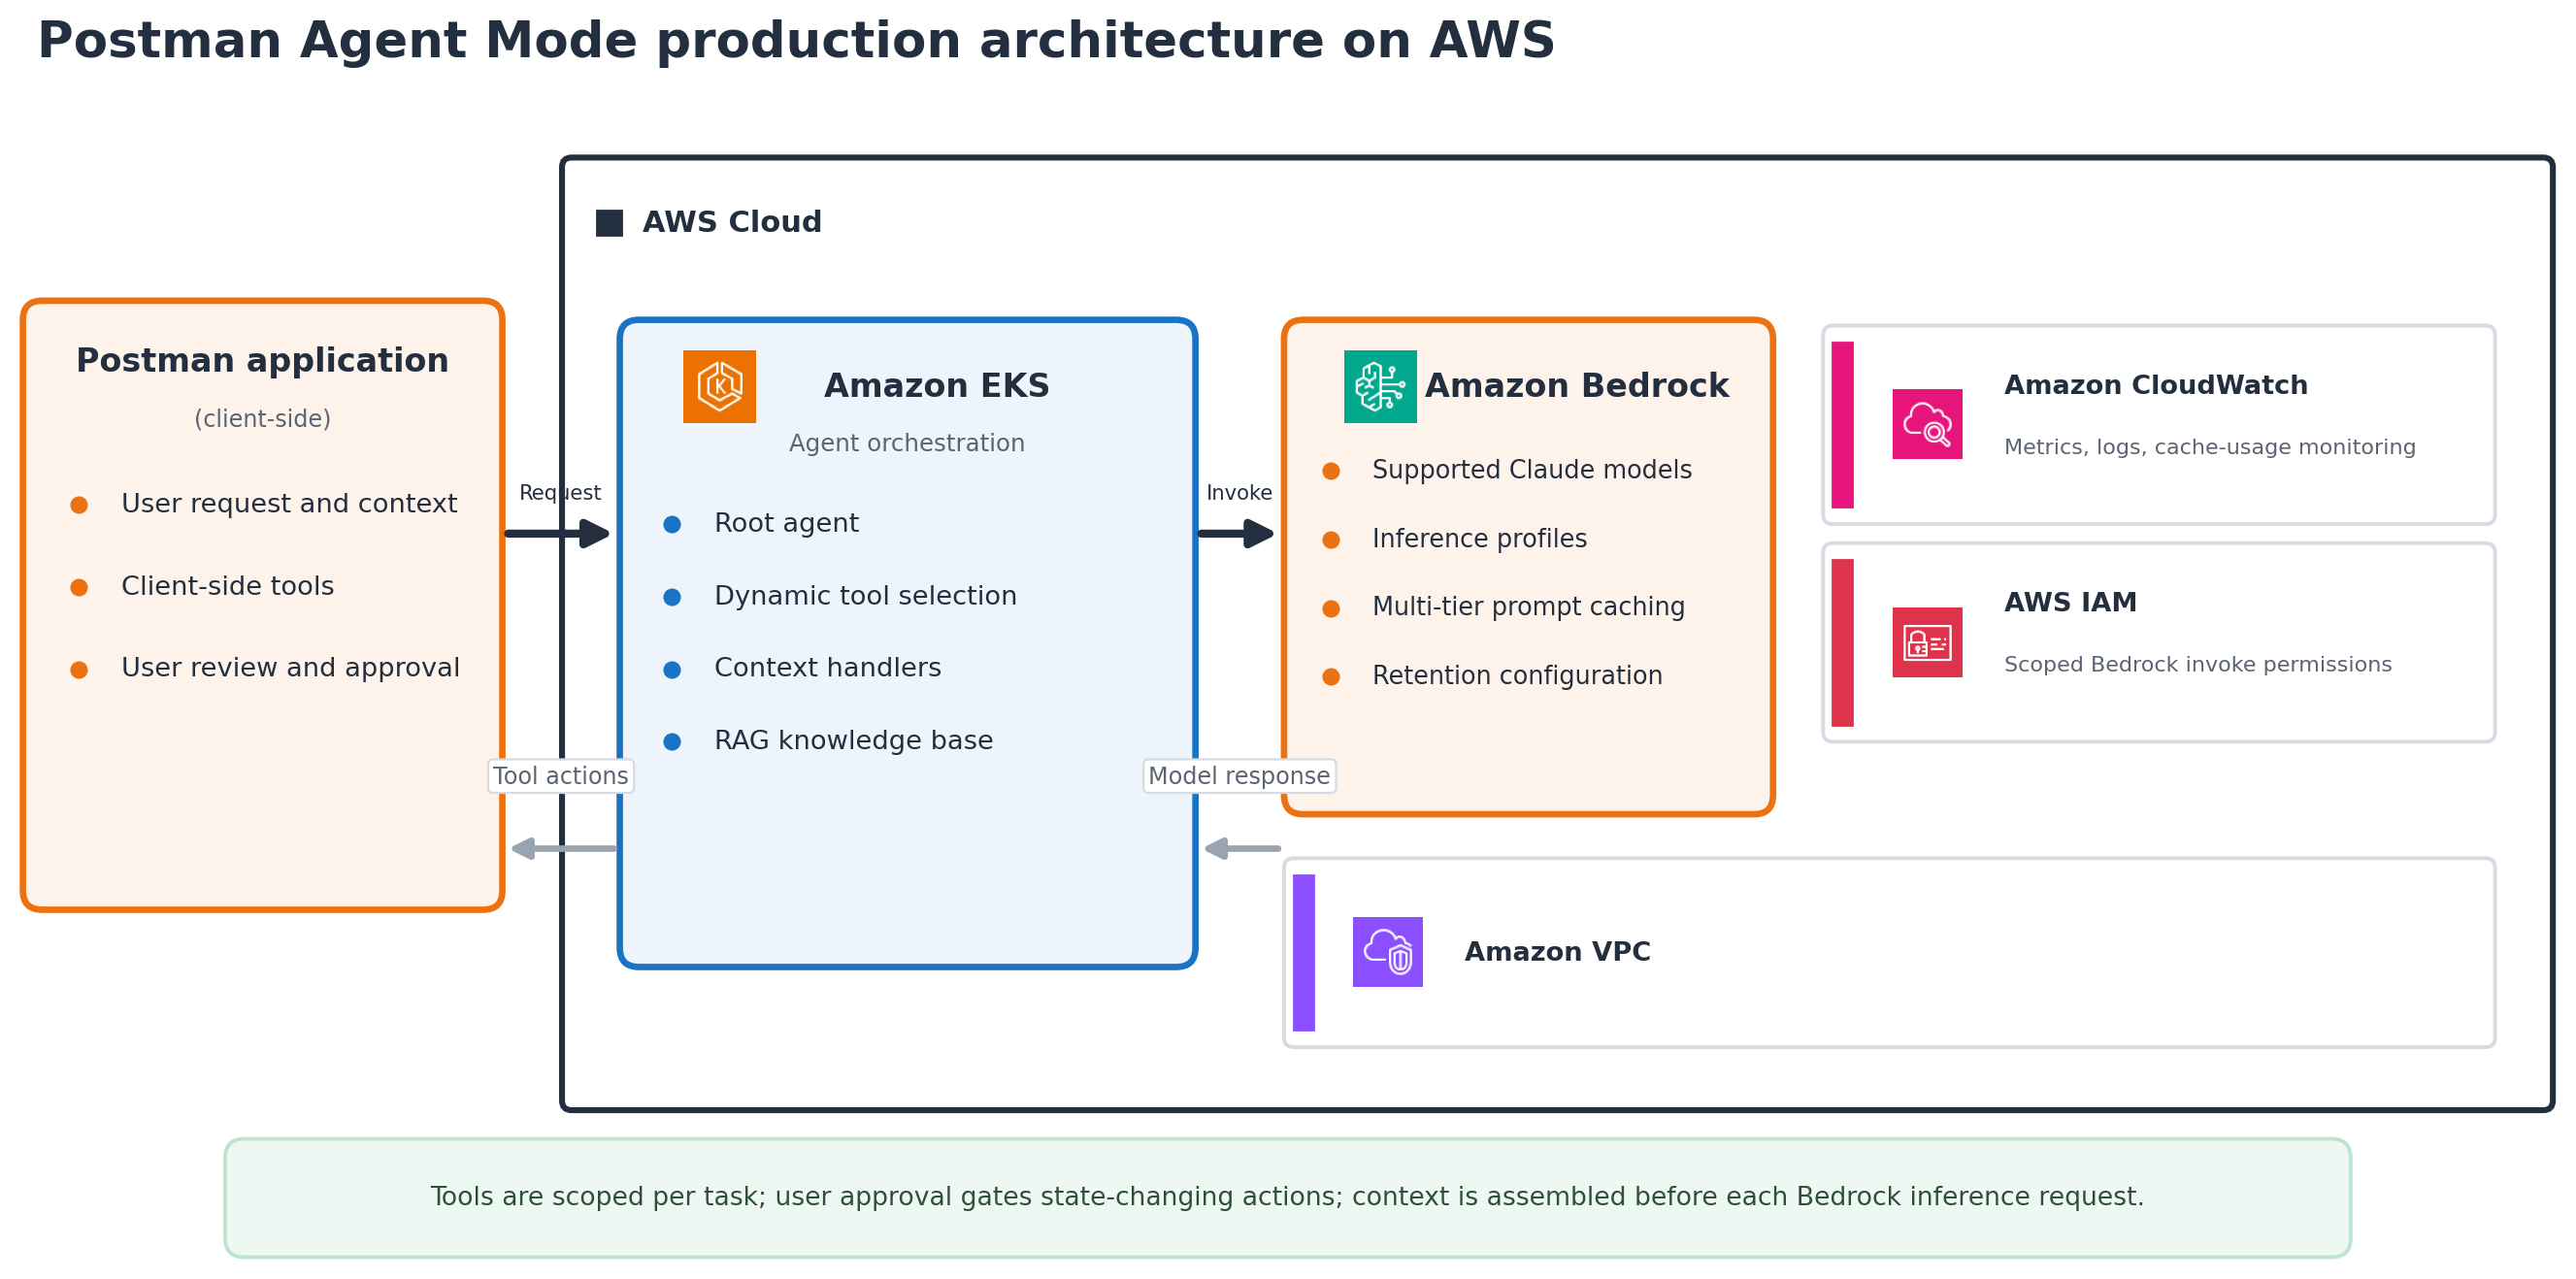
그림 2: Postman Agent Mode는 클라이언트 측 도구, 에이전트 오케스트레이션, 목적에 맞게 구축된 컨텍스트, Amazon Bedrock 모델 추론을 결합합니다. 도구는 각 작업에 맞게 범위가 지정되며, 애플리케이션 상태를 수정하는 작업에는 사용자 승인이 유지됩니다
인간의 감독은 프로덕션 설계의 일부입니다. Agent Mode는 애플리케이션 상태를 수정하는 작업 전에 사용자 승인을 요구합니다. Postman은 또한 사용 가능한 도구를 작업에 맞게 범위를 지정하고, 목적에 맞게 구축된 컨텍스트를 선택하며, 모델별 데이터 보존 설정을 적용합니다. 이러한 제어는 의도하지 않은 작업과 불필요한 데이터 노출을 줄이며, 프로덕션 테스트와 모니터링은 여전히 필요합니다. 책임 있는 AI 통제 수단으로서 Postman은 Amazon Bedrock Guardrails 를 사용하여 개인 식별 정보(PII)가 기본 대규모 언어 모델(LLM)에 도달하기 전에 삭제합니다. 엔터프라이즈 관리자는 Agent Mode의 가드레일 설정에서 이를 켤 수 있습니다.
도구 확산 처리
Agent Mode에서 도구는 에이전트가 Postman 내부에서 작동하는 방식을 정의합니다. 초기에 팀은 매우 원자적인 도구, 즉 요청 열기, 한 필드 업데이트, 특정 메타데이터 가져오기 같은 작고 정밀한 작업으로 기울었습니다. 그 접근 방식은 초기 반복에서 정확성과 제어를 지원했지만, 몇 가지 문제도 드러냈습니다.
많은 실제 워크플로는 긴 도구 호출 시퀀스를 필요로 합니다. 각 단계가 빠르더라도 모든 작업이 다음 작업이 시작되기 전에 모델로 돌아가야 했기 때문에 전체 경험은 느리게 느껴졌습니다. 사용자들은 마음속으로 하나의 작업으로 묶어둔 작업들을 에이전트가 단계별로 수행하는 것을 지켜봐야 했습니다.
Postman의 테스트에서는 표시되는 도구 집합이 대략 40개를 초과하자 도구 선택 오류가 증가했습니다. 에이전트는 존재하지 않는 도구를 호출하거나, 유효한 스키마에도 불구하고 잘못된 인수를 전달하거나, 의미상 타당해 보이지만 문맥상 잘못된 도구를 선택할 수 있었습니다. 더 크거나 최신 모델은 이러한 행동을 줄였지만 없애지는 못했습니다.
일정 크기를 넘어서는 도구 집합에서는 더 많은 도구를 노출할수록 에이전트의 효과가 떨어질 수 있습니다. 현재 아키텍처는 필요와 문맥에 따라 도구를 선택하고 개별 실행 스레드를 격리합니다. 모델은 현재 작업과 관련된 도구만 봅니다. Figure 3이 이 동적 선택 과정을 보여줍니다.
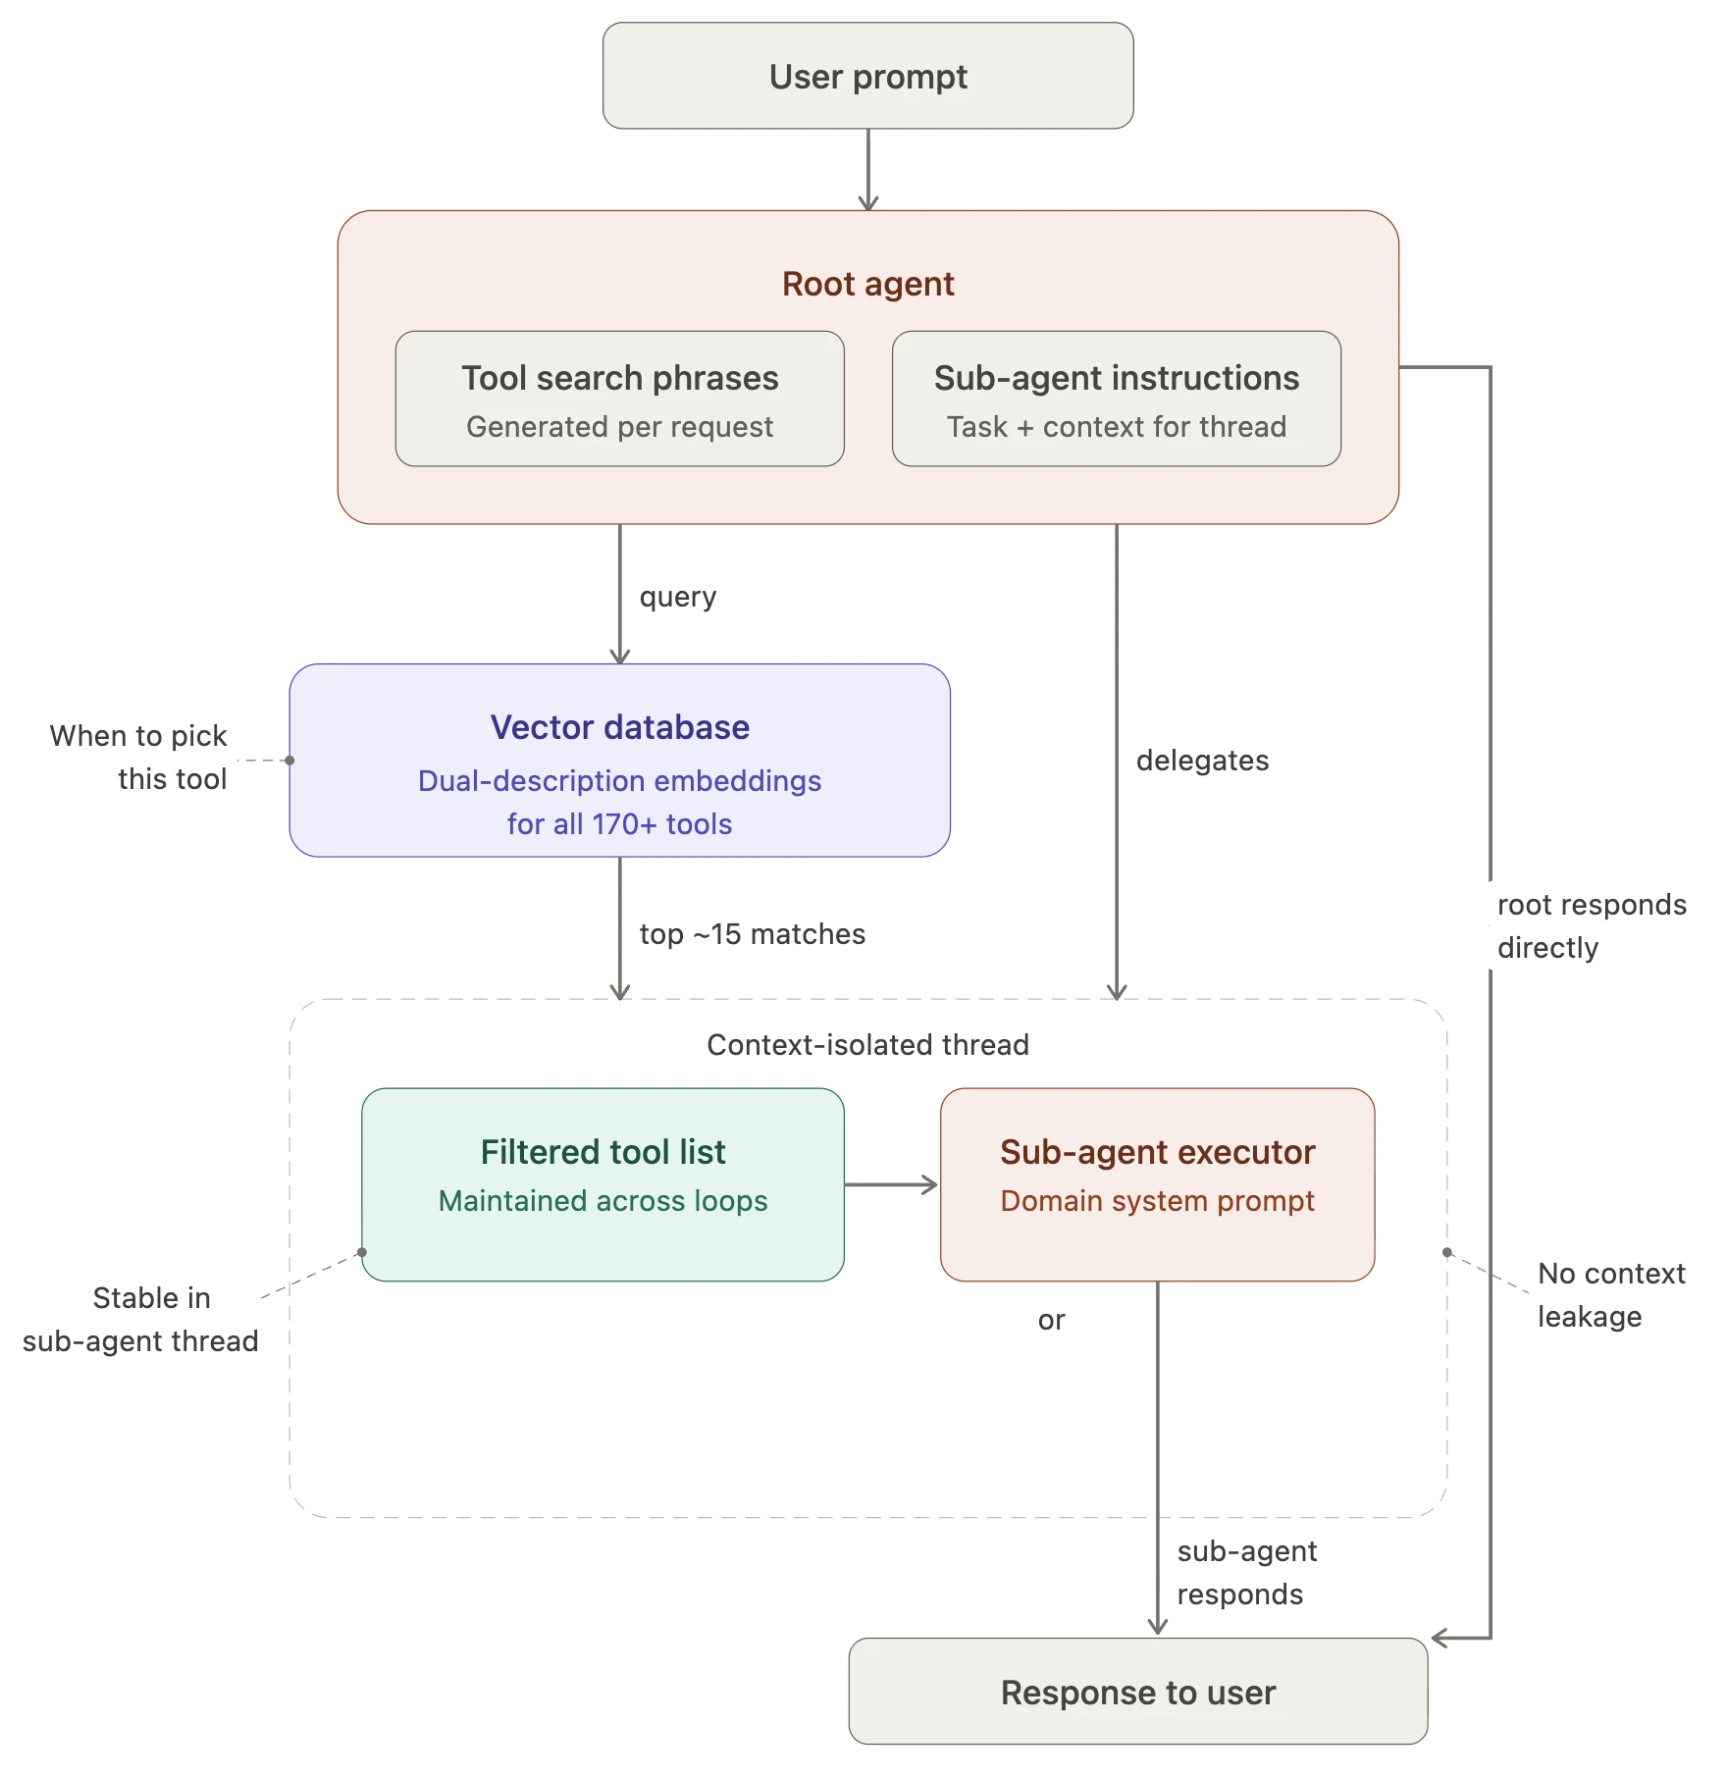
Figure 3: 루트 에이전트가 도구 임베딩의 벡터 데이터베이스를 질의하여 170개 이상의 도구를 요청과 관련된 약 15개로 좁힙니다. 그런 다음 해당 도구들을 컨텍스트가 격리된 서브 에이전트에 전달하므로, 모델은 작업에 필요한 도구만 봅니다
더 미묘한 문제는 많은 클라이언트 API가 인터페이스 상태에 암묵적으로 결합되어 있었다는 점입니다. 요청을 수정하는 도구는 특정 요소가 열려 있어야 했고, 다른 도구들은 부작용으로 새 탭을 열었습니다. 에이전트는 요청 탭을 열어 읽어야 했으며, 데이터를 추론하는 대신 인터페이스 상호작용을 모방해야 했습니다. Postman은 도구를 탭에서 적극적으로 분리하고 있으며, 그 Native Git 기능이 이 접근 방식을 광범위하게 활용합니다. 예를 들어, Agent Mode 는 이제 열려 있는 탭 없이도 백그라운드에서 요청을 보낼 수 있지만, 여전히 사용자 승인이 필요합니다.
빌더를 위한 교훈: 도구 카탈로그를 컨텍스트 예산의 일부로 취급하세요. 작업별로 모델에 노출되는 도구를 동적으로 범위 지정하고, "에이전트가 할 수 있는 것"을 "UI가 우연히 열어 둔 것"과 분리하세요.
스키마 기반 읽기 노출
API Catalog 같은 제품의 경우 Postman은 여러 개의 좁은 뷰를 단일 질의 도구로 통합했습니다. 이러한 제품들은 여러 서비스에 걸친 서비스 가동 시간, 테스트 결과, 엔드포인트 응답 시간 같은 구조화된 데이터를 노출합니다.
기반이 되는 ClickHouse 테이블의 스키마가 주어지면, 에이전트는 조인과 WHERE 절을 포함한 복잡한 질의를 생성할 수 있습니다. 이는 분석 질문에 답하기 위해 필요한 개별 도구의 수를 크게 줄입니다:
SELECT toString(service_id) AS service_id,
    countMerge(total_events_state) AS total_requests,
    countMerge(error_events_state) AS total_errors,
    round(countMerge(error_events_state) * 100.0
        / countMerge(total_events_state), 4) AS error_rate_pct,
    avgMerge(avg_latency_state) AS avg_latency_ms,
    quantileMerge(0.95)(p95_latency_state) AS p95_latency_ms
FROM http_events_summary_1d
WHERE service_id IN ('...list of service IDs')
    AND bucket_1d >= today() - 7
GROUP BY service_id
HAVING p95_latency_ms < 100
    AND total_requests > 0
ORDER BY error_rate_pct DESC;
이 접근 방식을 사용하면 엔지니어링 작업이 질문당 하나의 도구 만들기 에서 데이터를 한 번 잘 모델링하기로 이동합니다. 그러면 에이전트는 팀이 개별 도구로 전 열거할 수 있었던 것보다 훨씬 다양한 질의를 생성할 수 있습니다.
빌더를 위한 교훈: 잘 구조화된 데이터가 있는 곳에서는 단일 목적 읽기 도구를 늘어놓는 대신, 질의 엔진에 대한 스키마 인식 읽기 접근 권한을 에이전트에 부여하세요. 도구 수를 데이터 모델링과 맞바꾸면 더 나은 확장 곡선을 얻을 수 있습니다.
컨텍스트가 진짜 병목이었다
Postman은 처음에 누락된 도구 가 가장 큰 장애물일 것이라고 가정했습니다. 실제로는 누락되거나 불완전한 컨텍스트 가 누락된 기능보다 더 많은 실패를 일으켰습니다.
컨텍스트란 에이전트가 사용자가 Postman에서 어디에 있는지, 어떤 엔티티가 활성 상태인지, 어떤 상태가 이미 설정되었는지에 대한 이해를 말합니다. 그 컨텍스트가 잘못되었거나 없으면 올바른 도구조차 효과가 없었습니다. Figure 4는 에이전트에 제공되는 두 가지 형태의 컨텍스트를 구분합니다.
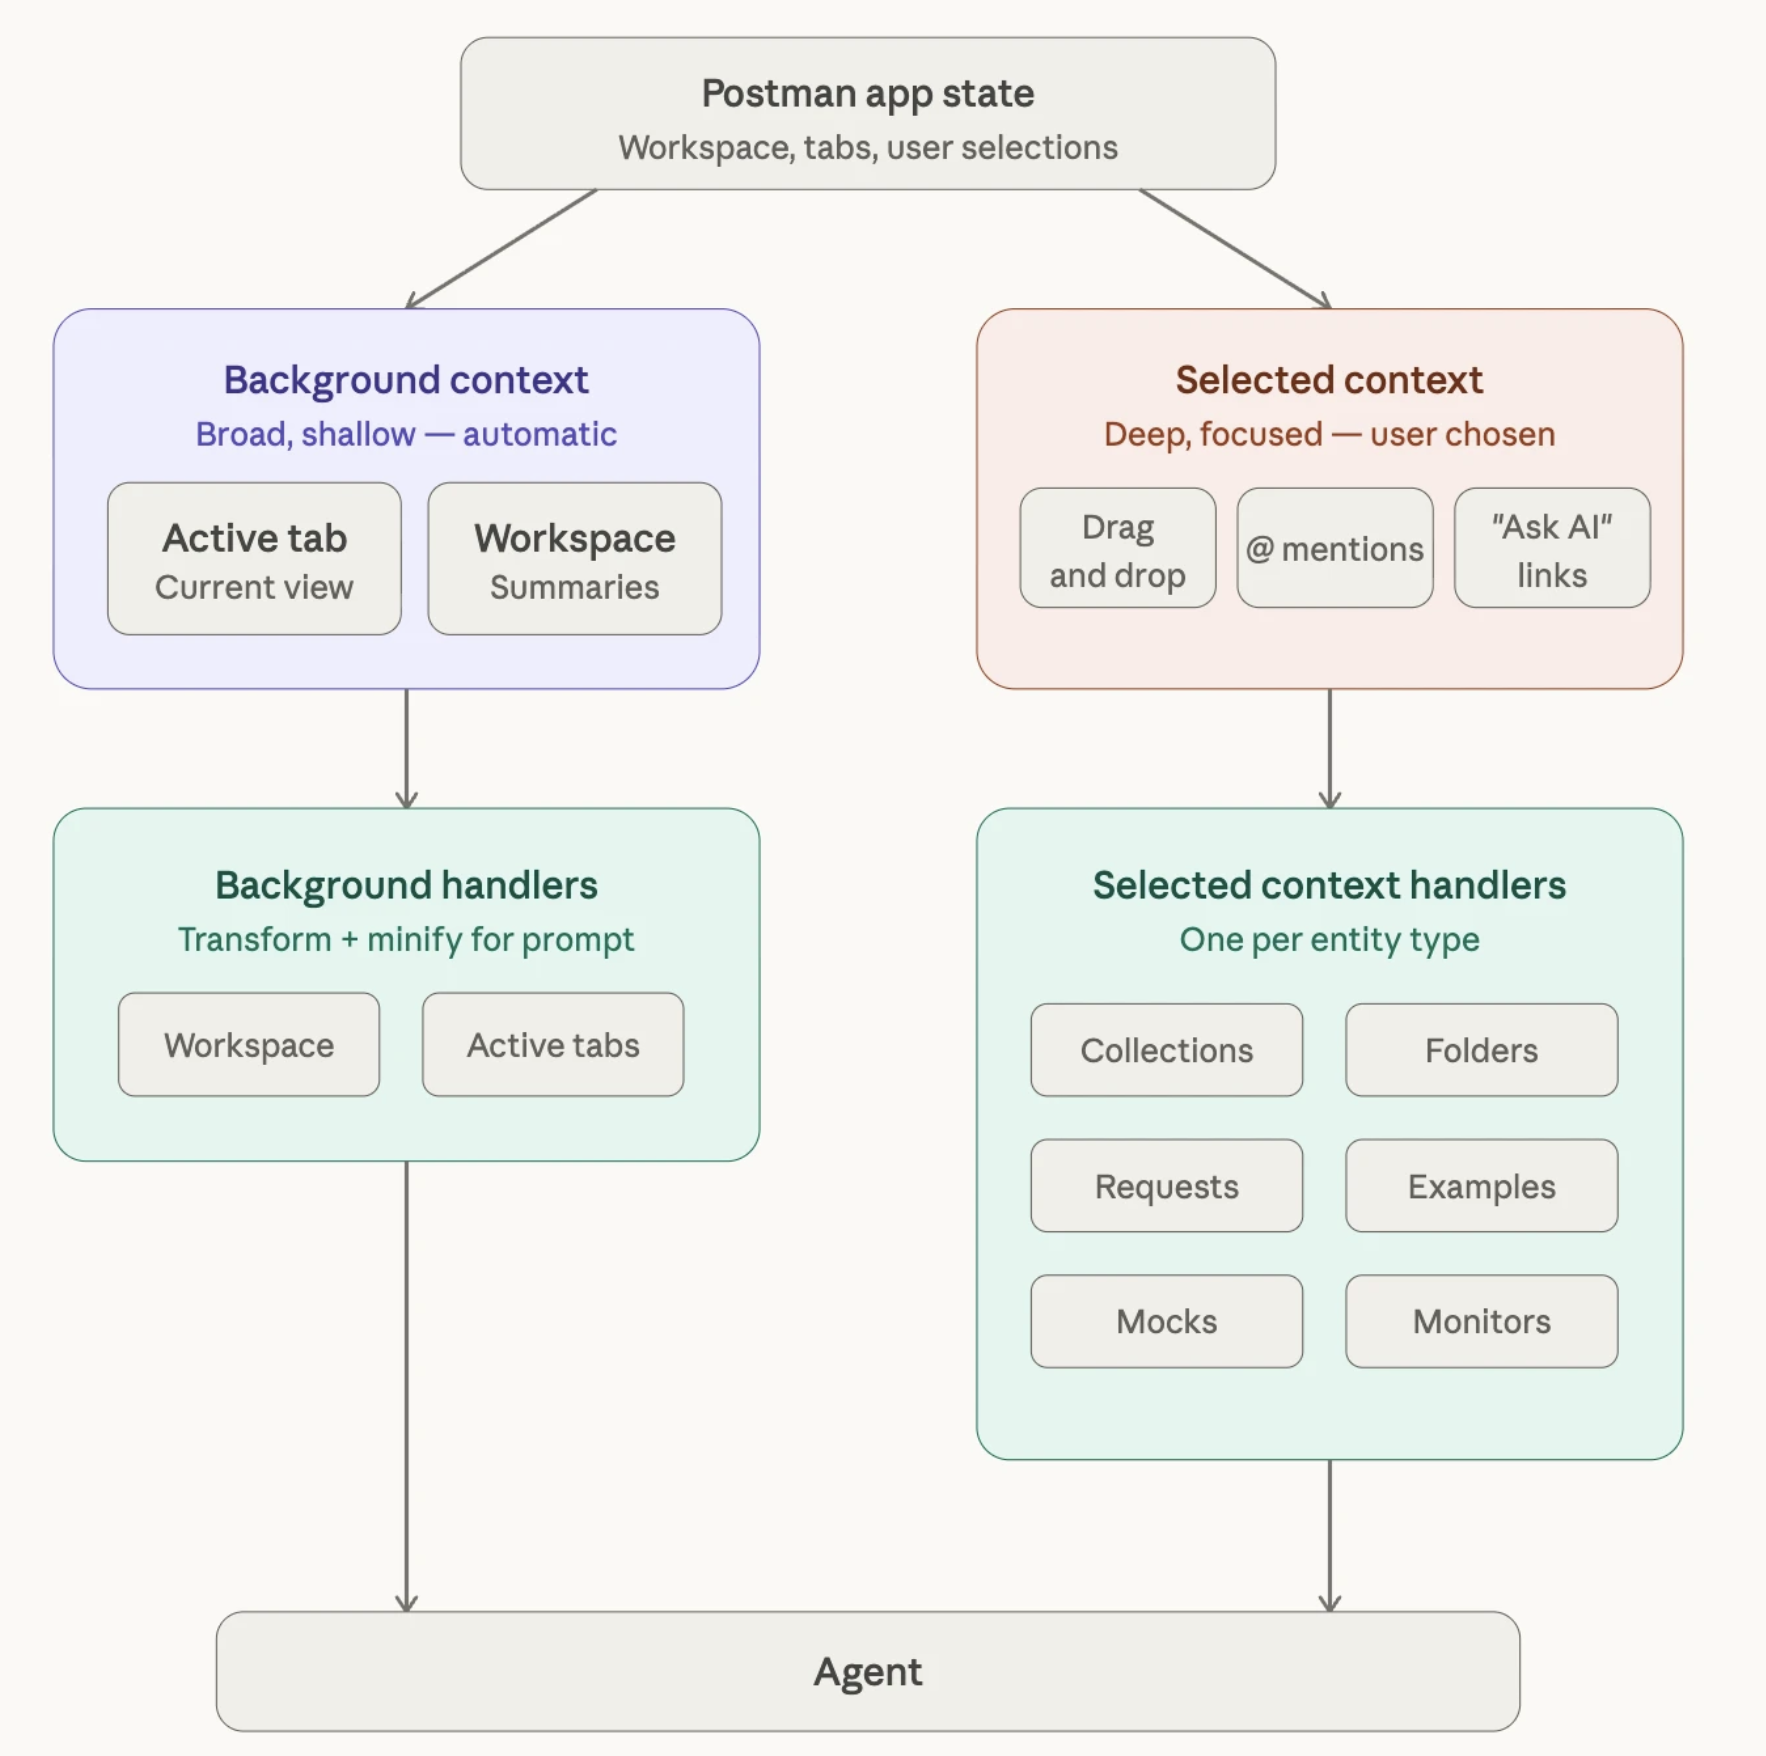
Figure 4: 두 종류의 컨텍스트가 에이전트에 전달됩니다. 넓고 얕은 배경 컨텍스트는 자동으로 수집되어 프롬프트용으로 축소됩니다. 깊고 집중된 선택 컨텍스트는 사용자가 선택하며 엔티티 유형별 전용 핸들러를 통해 라우팅됩니다. 각 핸들러는 엔티티를 에이전트가 필요로 하는 정보로 정제합니다
과제는 구조적인 것이었습니다. 11년 동안 개발자와 사용자는 인터페이스를 통해 정보를 찾는 법을 익혔습니다. 그 인식을 에이전트용으로 다시 설계하려면 각 워크플로에 무엇이 중요하고 무엇이 잡음인지 판단하기 위해 여러 번의 반복이 필요했습니다. 기존 인터페이스 데이터 모델을 직렬화하는 것은 유용한 컨텍스트를 만들지 못했는데, 그 객체들은 추론이 아니라 렌더링과 데이터 전송을 위해 만들어졌기 때문입니다. 그래서 Postman은 각 엔티티를 에이전트가 알아야 할 사항으로 정제하는 전용 컨텍스트 핸들러를 만들었습니다.
더 많은 객체가 핸들러를 갖게 되면서 다음 문제는 잘림(truncation)이었습니다. 많은 필드에는 요청 설명, OpenAPI 사양, 요청 페이로드 같은 개방형 사용자 생성 데이터가 들어 있습니다. 이 데이터는 컨텍스트 창을 채울 수 있습니다. 컨텍스트 예산을 신중하게 관리하는 것은 규모가 커질 때 필수적이며, 각 핸들러가 별도의 잘림 및 확장 로직을 필요로 하지 않는, 팀이 탐색 중인 파일시스템 기반 접근 방식을 뒷받침합니다.
빌더를 위한 교훈: 모델에 렌더링용 데이터 모델을 먹이지 마세요. 목적에 맞게 설계된 컨텍스트 핸들러를 만들고, 컨텍스트 창을 희소하며 적극적으로 관리되는 예산으로 취급하세요. 잡음은 모델이 한계에 도달하기 훨씬 전에 신호를 밀어냅니다.
모든 것을 하나로 합치기
Agent Mode가 발전하면서 시스템이 서로 다른 문제를 해결하는 세 가지 구별되는 구성 요소를 통합해야 한다는 것이 명확해졌습니다.
- 클라이언트 측 도구는 Postman 애플리케이션에 존재하며 에이전트가 취할 수 있는 최종 작업, 예를 들어 요청 열기, 설정 수정, 컬렉션 실행, 인증 검사 등을 나타냅니다. Agent Mode는 웹 검색 및 에이전트 루프 관리 같은 기능을 위해 서버 측 도구도 사용하지만, 대부분의 도구는 Postman 애플리케이션에서 작동합니다.
- 일반 에이전트 지침은 시스템 수준의 동작을 정의합니다. 여기에는 Agent Mode가 얼마나 능동적이어야 하는지, 불확실성을 어떻게 전달하는지, 그리고 어떤 기본 제품 지식을 갖추고 있는지가 포함됩니다.
- 지식 베이스는 검색 증강 생성(RAG) 방식을 사용합니다. Postman은 여러 요청 프로토콜, 목(mock) 서버, 모니터, 문서화, API Network, 워크스페이스 거버넌스, 변수, 헬퍼, 코드 생성, 요청 설정, 컬렉션 실행을 포함하는 방대한 제품 표면을 보유하고 있습니다.
정적 프롬프트에 이 모든 내용을 담는 것은 불가능했고, 대부분은 특정 쿼리와 무관했습니다. 초기 시딩을 위해 팀은 Postman의 Learning Center를 사용하여 간결한 기능별 아티클을 생성했습니다. 런타임에는 Agent Mode가 들어오는 쿼리와 사용 가능한 컨텍스트를 기반으로 지식 아티클을 선택합니다. 예를 들어, 사용자가 목 서버를 선택하면 Agent Mode가 관련 아티클을 자동으로 주입합니다. 이를 통해 필요할 때 깊이 있는 정보를 제공하면서도 에이전트를 기본적으로 가볍게 유지할 수 있습니다. 지식 베이스는 애플리케이션과 함께 발전하므로, 팀은 새로운 기능과 함께 Agent Mode 문서를 출시할 수 있습니다.
Amazon Bedrock에서 에이전트 모드 실행
앞서 설명한 세 가지 구성 요소는 모두 동일한 런타임 동작, 즉 파운데이션 모델(FM)에 대한 추론 호출로 귀결됩니다. Postman의 규모에서는 트래픽이 버스트 형태이며 개발자 주도로 발생합니다. 라우팅, 캐싱, 지리적 처리 제어 기능은 Postman이 트래픽 버스트를 수용하고, 추론 비용을 관리하며, 워크로드별 처리 요구 사항을 충족하는 데 도움이 됩니다. Amazon Bedrock은 여기서 가장 중요한 네 가지 기능을 제공합니다.
Claude 계열 전반의 모델 유연성
Agent Mode는 특정 모델에 종속되지 않습니다. Through Amazon Bedrock 모델 추론 API, Postman은 지원되는 Anthropic Claude 모델에 접근하여 각 워크로드를 적절한 모델로 라우팅할 수 있습니다. 더 빠른 모델은 대용량의 지연 시간에 민감한 상호작용을 처리하고, 더 큰 모델은 비용보다 품질이 중요한 복잡한 추론을 담당할 수 있습니다. 지원되는 Claude 모델 간의 전환은 새로운 통합 작업이 아니라 주로 설정 변경입니다. 이러한 유연성은 앞서 설명한 도구 난립 및 컨텍스트 문제를 직접적으로 해결합니다. Postman의 테스트에서 더 새롭고 더 큰 모델은 도구 환각(hallucination)을 줄였으며, Postman은 통합을 다시 구축하지 않고도 지원되는 모델을 채택할 수 있습니다. See Amazon Bedrock의 AWS 리전별 지원 모델.
높은 처리량을 위한 교차 리전(Region) 추론
개발자 트래픽은 간헐적으로 치솟기 때문에 한 AWS 리전에서 피크 수요에 맞춰 프로비저닝하면 비용이 많이 들 수 있습니다. Agent Mode는 Amazon Bedrock 교차 리전 추론 추론 프로파일에 정의된 대상 리전들 간에 요청을 자동으로 라우팅합니다. 런타임에 애플리케이션은 선택된 추론 프로파일 ID 또는 Amazon Resource Name(ARN)을 Converse 또는 InvokeModel에서 modelId로 전달합니다. 프로파일, 적용 가능한 AWS Identity and Access Management(IAM) 및 서비스 제어 정책, 그리고 할당량은 Bedrock이 선택할 수 있는 모든 대상 리전을 허용해야 합니다.
- 지리적 추론 프로필 정의된 지리(예: 미국 또는 유럽 연합) 내의 지원되는 리전 간에만 요청을 라우팅합니다. 이 옵션은 처리량 증가와 구성된 지리적 처리 경계를 결합합니다.
- 글로벌 추론 프로파일은 트래픽 폭주 시 추가 처리량을 제공하기 위해 전 세계의 지원되는 대상 리전 간에 요청을 라우팅할 수 있습니다. 이는 워크로드가 지리적으로 제한된 처리 경계를 요구하지 않는 경우에만 적합합니다.
Postman은 워크로드별로 추론 프로파일을 선택할 수 있습니다. 최대 가용 처리량을 위해 글로벌 프로파일을 사용하거나, 처리가 프로파일에 정의된 지역 내에 머물러야 하는 경우 지리적 프로파일을 사용할 수 있습니다. 이 선택은 각 Bedrock 추론 요청에 사용되는 modelId에서 명시적으로 나타납니다.
# Schematic Converse request
response = bedrock_runtime.converse(
    modelId="<geographic-inference-profile-id-or-arn>",
    messages=messages,
    system=system_blocks,
)
데이터 상주 및 엔터프라이즈 관리 기능
엔터프라이즈 고객에게는 허용된 처리 지역이 처리량만큼이나 중요할 수 있습니다. 지역 추론 프로파일은 선택된 지역(geography) 내에서 프로파일이 지원하는 대상 리전으로 Bedrock 라우팅을 제한합니다. 이는 추론이 Postman 자체의 AWS 환경 내에서 실행된다는 의미가 아닙니다. Amazon Bedrock은 해당 프로파일에 적합한 AWS 리전에서 요청을 처리하며, 전송 중 및 저장 시 데이터가 암호화됩니다. AWS는 Bedrock이 프롬프트와 완성 결과를 AWS 모델 학습에 사용하거나 제3자에게 배포하지 않는다고 밝히고 있습니다. Postman은 지원되는 Agent Mode 모델에 대해 data_retention_mode를 none으로 설정하여 영 데이터 보존(zero data retention)을 구성했습니다. 가용성과 동작은 모델에 따라 다르므로 각 프로덕션 모델은 현재 Amazon Bedrock 데이터 보호 및 보존 문서.
비용을 관리하기 위한 프롬프트 캐싱
프로덕션 에이전트는 매 턴마다 상당한 양의 안정적인 컨텍스트를 재전송하는데, 여기에는 시스템 지침, 일반적인 에이전트 동작, 핵심 도구 세트, 선별된 지식, 대화 컨텍스트가 포함됩니다. 변경되지 않은 접두부를 요청 시마다 다시 처리하는 것은 불필요한 지연과 비용을 초래합니다.
에이전트 모드는 사용합니다 Amazon Bedrock 프롬프트 캐싱 안정적인 프롬프트 접두어를 재사용하기 위함입니다. 시스템 프롬프트, 에이전트 지침, 핵심 도구 정의를 포함하는 거의 변경되지 않는 코어는 1시간 캐시 체크포인트를 사용합니다. 더 자주 변하는 컨텍스트는 캐시 히트 시 갱신되는 5분 체크포인트를 사용합니다. Bedrock은 수명이 더 긴 체크포인트가 수명이 더 짧은 체크포인트보다 앞에 나타나도록 요구합니다. 유휴 상태의 컨텍스트는 만료되기 때문에 짧은 계층은 대화형 세션에 적합하며, 반면 1시간 계층은 더 높은 캐시 쓰기 비용을 여러 번의 읽기에 걸쳐 분산할 수 있습니다. 캐시의 이점과 지원되는 TTL은 선택한 모델에 따라 달라집니다. 팀은 cacheReadInputTokens 및 cacheWriteInputTokens 사용량 필드를 통해 동작을 검증하고 자체 워크로드에 대한 첫 토큰까지의 시간을 측정할 수 있습니다.
# Schematic cache checkpoints in Converse content blocks
{"cachePoint": {"type": "default", "ttl": "1h"}}  # stable core
{"cachePoint": {"type": "default", "ttl": "5m"}}  # variable layer
빌더를 위한 핵심 포인트: 추론을 단순한 모델 선택 문제가 아니라 라우팅 및 캐싱 문제로 취급하세요. 워크로드별로 Claude 모델을 선택하고, 적절한 크로스 리전 추론 프로파일을 선택하며, 각 계층이 변경되는 빈도에 맞는 TTL로 안정적인 프롬프트 접두어를 캐시하십시오.
프로덕션에서 에이전트를 확장하기 위한 모범 사례
Postman의 여정에서 얻은 교훈을 Amazon Bedrock에서 개발하는 빌더들을 위해 정리했습니다:
- 토큰만큼 신중하게 예산을 관리하십시오. 작업별로 노출되는 도구를 동적으로 선택하십시오. Postman의 테스트에서 표시되는 도구 집합이 커질수록 도구 선택 오류가 증가했습니다.
- 도구를 늘리기보다는 스키마를 인식하는 읽기를 선호하십시오. 데이터를 잘 모델링하고 에이전트가 이를 쿼리하도록 하십시오.
- 에이전트 동작을 인터페이스 상태에서 분리하십시오. 도구가 열린 탭을 필요로 한다면, 에이전트는 데이터를 직접 추론하는 것이 아니라 인터페이스를 탐색하고 있는 것입니다.
- 맥락을 의도적으로 구성하라. 목적에 맞게 만들어진 컨텍스트 핸들러는 렌더링 모델을 직렬화하는 방식보다 항상 더 뛰어납니다.
- 컨텍스트 창을 희소한 자원으로 관리하십시오. 절단(truncation)과 확장(expansion) 전략은 어설픈 부가 기능이 아니라 일급 설계 문제입니다.
- 기능과 함께 문서를 제공하세요. RAG 지식 베이스는 제품과 발맞춰 함께 진화할 때만 계속 유용하게 유지됩니다.
- Bedrock에서 라우팅하고 캐싱하세요. 각 워크로드에 적합한 Claude 모델을 매칭하고, 처리량과 지리적 요구 사항에 따라 크로스 리전(cross-Region) 추론을 선택하며, 안정적인 프롬프트 접두어에는 계층형 캐싱을 적용하세요.
결론
에이전트 모드(Agent Mode)를 구축하면서 Postman은 대규모 언어 모델의 역량과 성숙한 제품의 구조 사이의 간극, 즉 인터페이스 가정, 결합된 클라이언트, 방대한 도구 카탈로그, 문서와 팀에 분산된 지식이라는 문제와 마주해야 했습니다. 동적 도구 선택, 스키마 기반 읽기, 그리고 신중한 컨텍스트 엔지니어링은 다음 규모에서 반복 가능한 패턴으로 자리 잡았습니다. Postman의 개발자 커뮤니티. Amazon Bedrock 관리형 모델 접근을 제공하며, 리전 간 추론, 모델 의존적 보존 정책 제어, 그리고 프롬프트 캐싱 생산 아키텍처를 지원하는.
첫 번째 에이전트를 구축하든 기존 에이전트를 확장하든, 이러한 패턴들은 팀이 흔히 겪는 에이전트 통합 및 확장 문제를 피하는 데 도움이 될 수 있습니다.
자세한 내용은 다음을 참조하세요: Amazon Bedrock 문서, 여기에 다음에 대한 지침이 포함됩니다. 교차 리전 추론, 프롬프트 캐싱, 그리고 데이터 보호 및 보존. 관련 구현 지침은 다음 문서를 참조하세요: Amazon Bedrock에서 프롬프트 캐싱을 효과적으로 활용하기 그리고 Amazon Bedrock, 처리량 향상을 위한 글로벌 교차 리전 추론 기능 발표 AWS Machine Learning 블로그에 게시되었습니다. 제품을 살펴보려면 다음을 참조하십시오. Postman Agent Mode 문서.
Postman의 프로덕션 구현은 독점적이며 공개 샘플 저장소로 제공되지 않습니다.