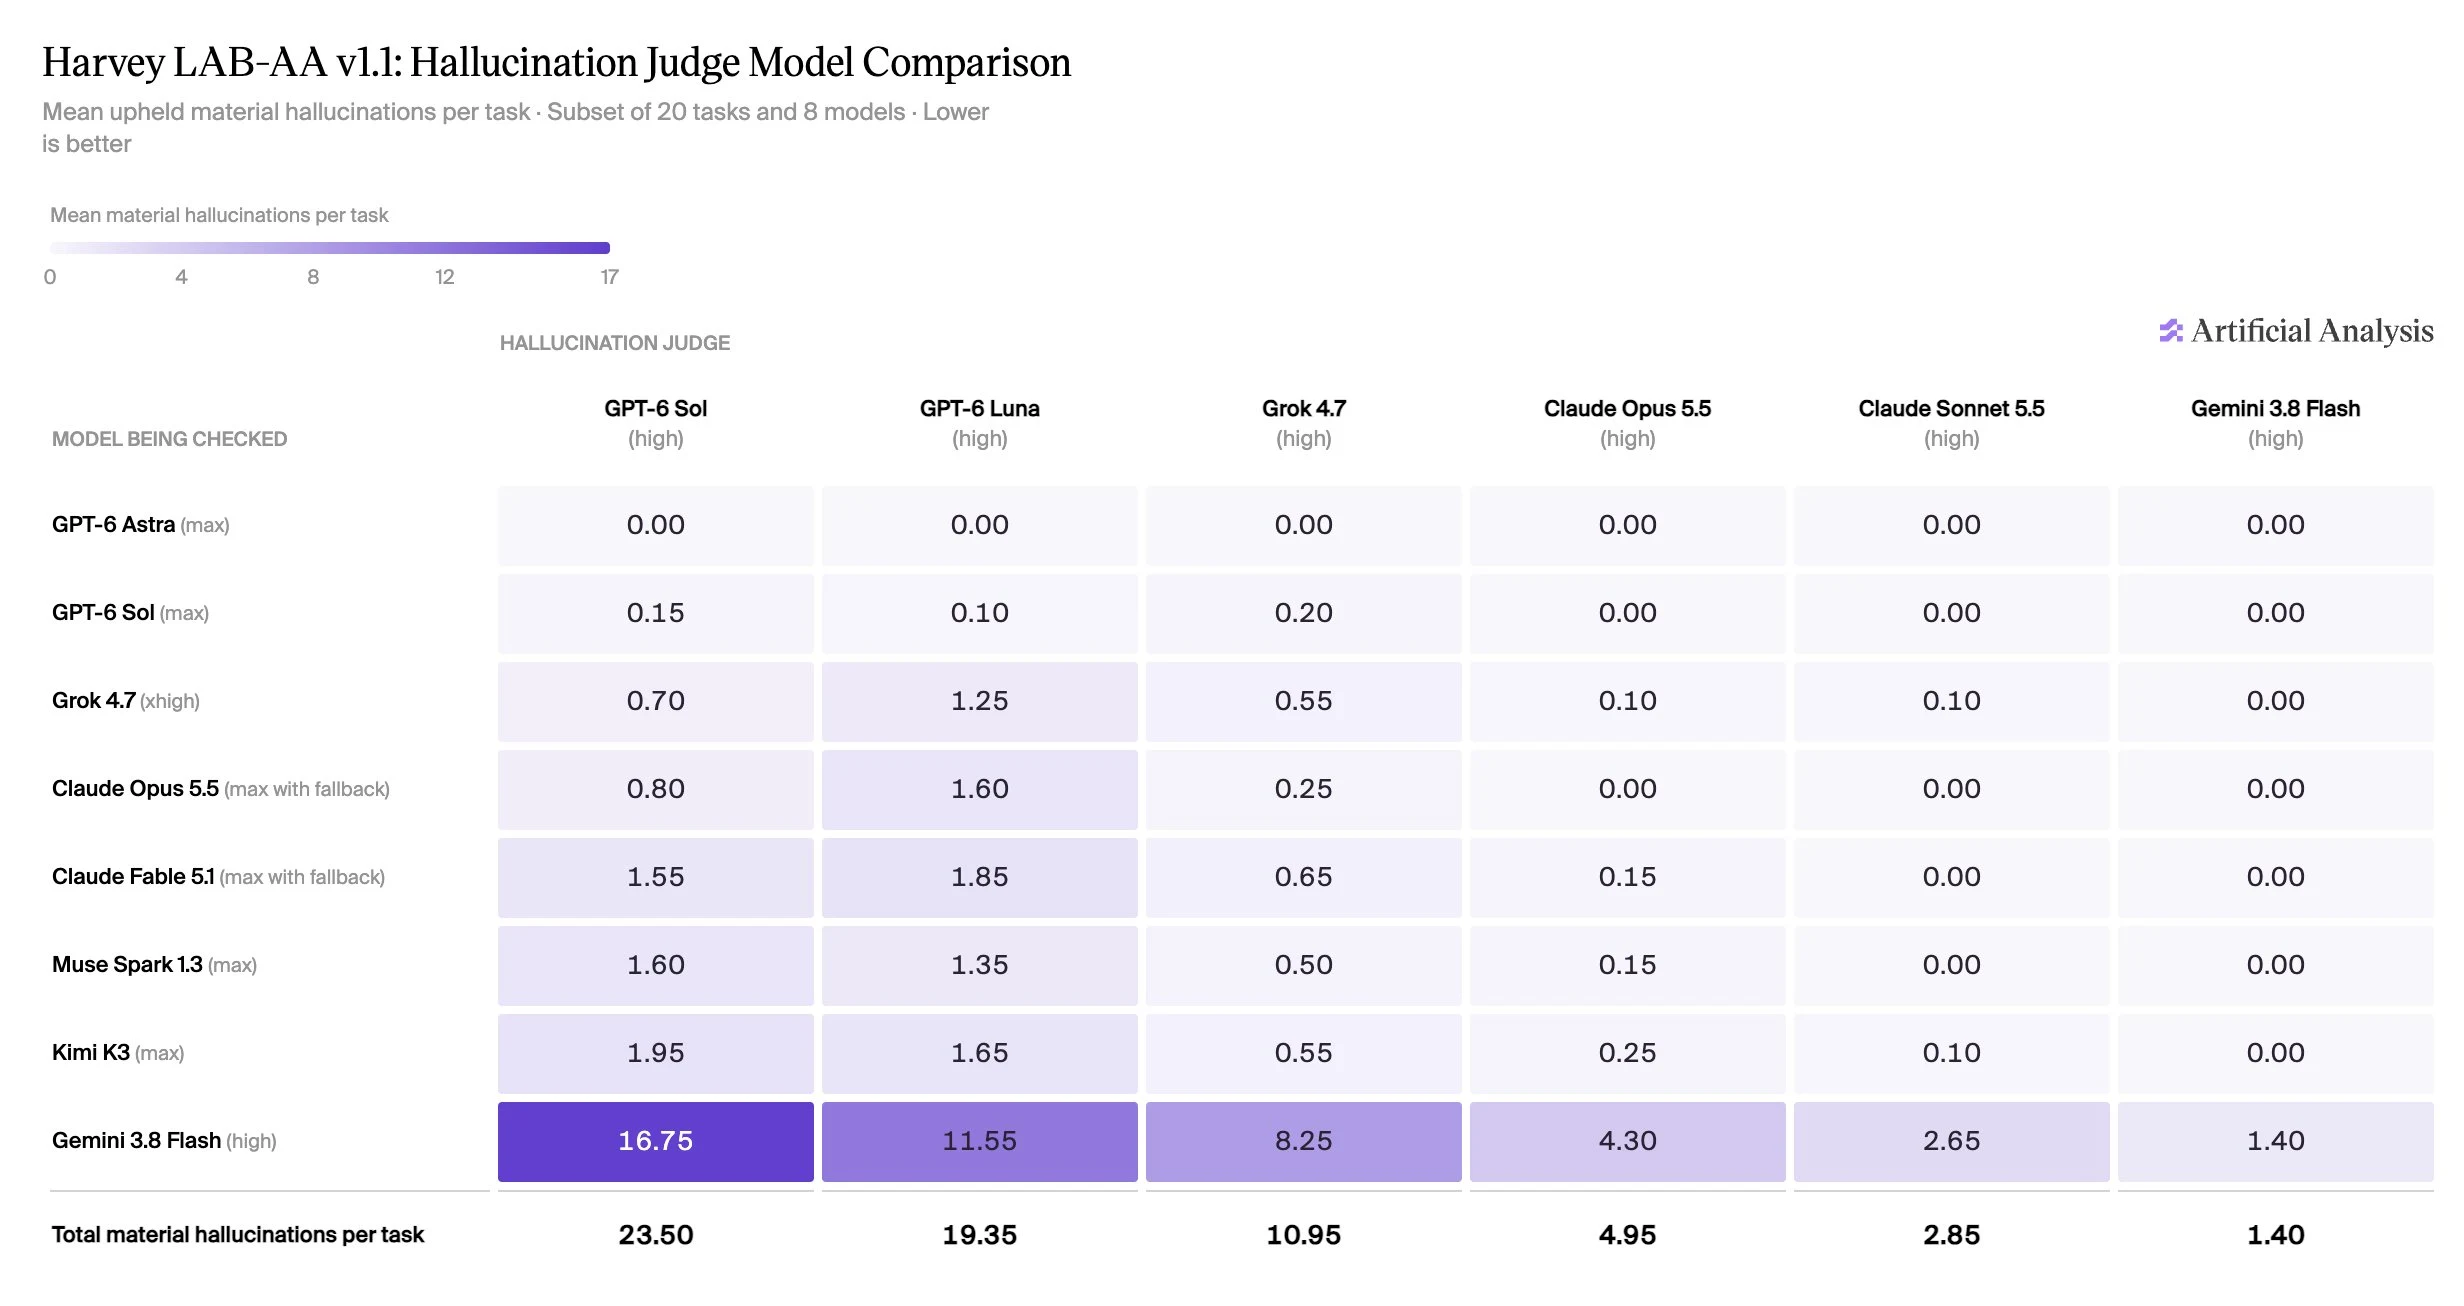
동일한 20개 작업과 8개 모델의 고정된 하위 집합에서 나온 동일한 산출물을 대상으로 6개의 환각 검사기를 비교했습니다. 우리는 GPT-6 Sol (high), GPT-6 Luna (high), Grok 4.7 (high), Claude Opus 5.5 (high), Claude Sonnet 5.5 (high) 및 Gemini 3.8 Flash (high)를 사용하여 2단계 검사를 수행했으며, 프로덕션 사용을 위해 GPT-6 Sol (high)을 선택했습니다.
이 20개 작업 하위 집합에서 GPT-6 Sol과 GPT-6 Luna는 일반적으로 더 많은 중대한 환각을 식별한 반면, Claude Sonnet 5.5와 Gemini 3.8 Flash는 훨씬 적게 식별했습니다. Claude Opus 5.5는 모든 모델 행에서 Grok 4.7과 Claude Sonnet 5.5 사이에 위치했습니다. 전체적으로 Opus는 99개의 중대한 환각을 인정한 반면, Grok은 219개, Sonnet은 57개, GPT-6 Sol은 470개였습니다. GPT-6 Sol은 원본 문서에 포함되지 않은 일반 법률 지식을 제외하는 등 오류 표시에 보수적인 접근 방식을 사용함에도 불구하고 더 많은 중대한 환각을 식별했습니다.
6개 검사기 모두 GPT-6 Astra의 산출물에서 중대한 환각을 발견하지 못했으며, GPT-6 Sol은 작업당 0에서 0.20까지의 범위를 보였습니다. 두 모델 모두 모든 검사기에서 중대한 환각이 가장 적은 모델에 속했습니다. 이 비교는 검사기 간 행동 차이를 보여줄 뿐, 이러한 수치만으로 정확성을 입증하거나 자기 선호 가능성을 배제할 수는 없습니다.