
vLLM은 이제 Vera Rubin NVL72을 지원합니다!
NVIDIA Vera Rubin은 에이전트 기반 인추론을 위해 만들어진 차세대 플랫폼입니다. Inferact, NVIDIA, Red Hat, 그리고 vLLM 커뮤니티는 발표된 이후로 Vera Rubin NVL72에서 vLLM을 구동하고 있으며, 오늘날에는 Vera Rubin NVL72에서 vLLM이 실행됩니다. 이때 매일 컨테이너 빌드가 이루어지고 DeepSeek, Moonshot AI, Z.ai, MiniMax의 모델도 지원됩니다.
이 글은 현재 상황을 미리 살펴보는 내용이며, 지금까지의 작업에서 주목할 만한 몇 가지 점이 있습니다:
- 베라 루빈 NVL72 하드웨어: GB200 NVL72의 NVFP4 FLOPS는 5배, HBM 대역폭은 약 2.4배, 양방향 NVLink 대역폭은 1.7배이며, softmax에 대한 지수 연산 속도는 2-4배 더 빠릅니다.
- Day-0 지원: Rubin은 Blackwell의 아키텍처 패밀리에 기반을 두고 있으므로, vLLM의 Blackwell 커널은 Rubin과 호환됩니다. 이로 인해 vLLM은 DeepSeek, Kimi, GLM, MiniMax과 같은 다양한 모델을 Rubin에서 지원할 수 있습니다.
- 루빈 튜닝된 커널: FlashInfer 0.7.0을 통해 vLLM은 루빈 튜닝된 주의력, GEMM, MoE 커널을 얻었습니다. 우리는 또한 루빈에 맞게 MiniMax Sparse Attention(MSA) 프리필 커널도 튜닝했습니다.
- 지역 인식 MoE: Rubin의 증가된 HBM 대역폭을 최대한 활용하기 위해, 우리는 CUDA 13.4의 지역성 도메인을 활용하여 MoE 가중치를 분할합니다. 이를 통해 SM들은 가중치를 자신에게 가장 가까운 메모리에서만 읽을 수 있습니다.
- 초기 성능: 초기 결과에 따르면 vLLM은 인터랙티비티 수준을 맞추고 MLPerf에서 GB300 NVL72보다 3.7배 더 높은 VLM 처리량과 함께, AgentX에서 GB200 NVL72에 비해 7.8배 더 높은 GPU 처리량을 보여주는 인상적인 성능 향상을 보입니다. 이제 시작일 뿐이며, 최적화가 계속되면서 더 많은 성능 향상이 기대됩니다.
루빈이 추론에 대해 어떻게 변경했는가
확대하려 클릭그림 1. NVIDIA Vera Rubin NVL72와 GB200 NVL72의 Per-GPU 비교. GPU의 각 부분을 강조하려면 해당 지표 위에 마우스를 올리세요. "표 표시"를 선택하면 모든 값이 표시됩니다. 출처: NVIDIA Vera Rubin NVL72 및 GB200 NVL72 사양 페이지, 그리고 NVIDIA Rubin 개발자 블로그.
베라 루빈 플랫폼
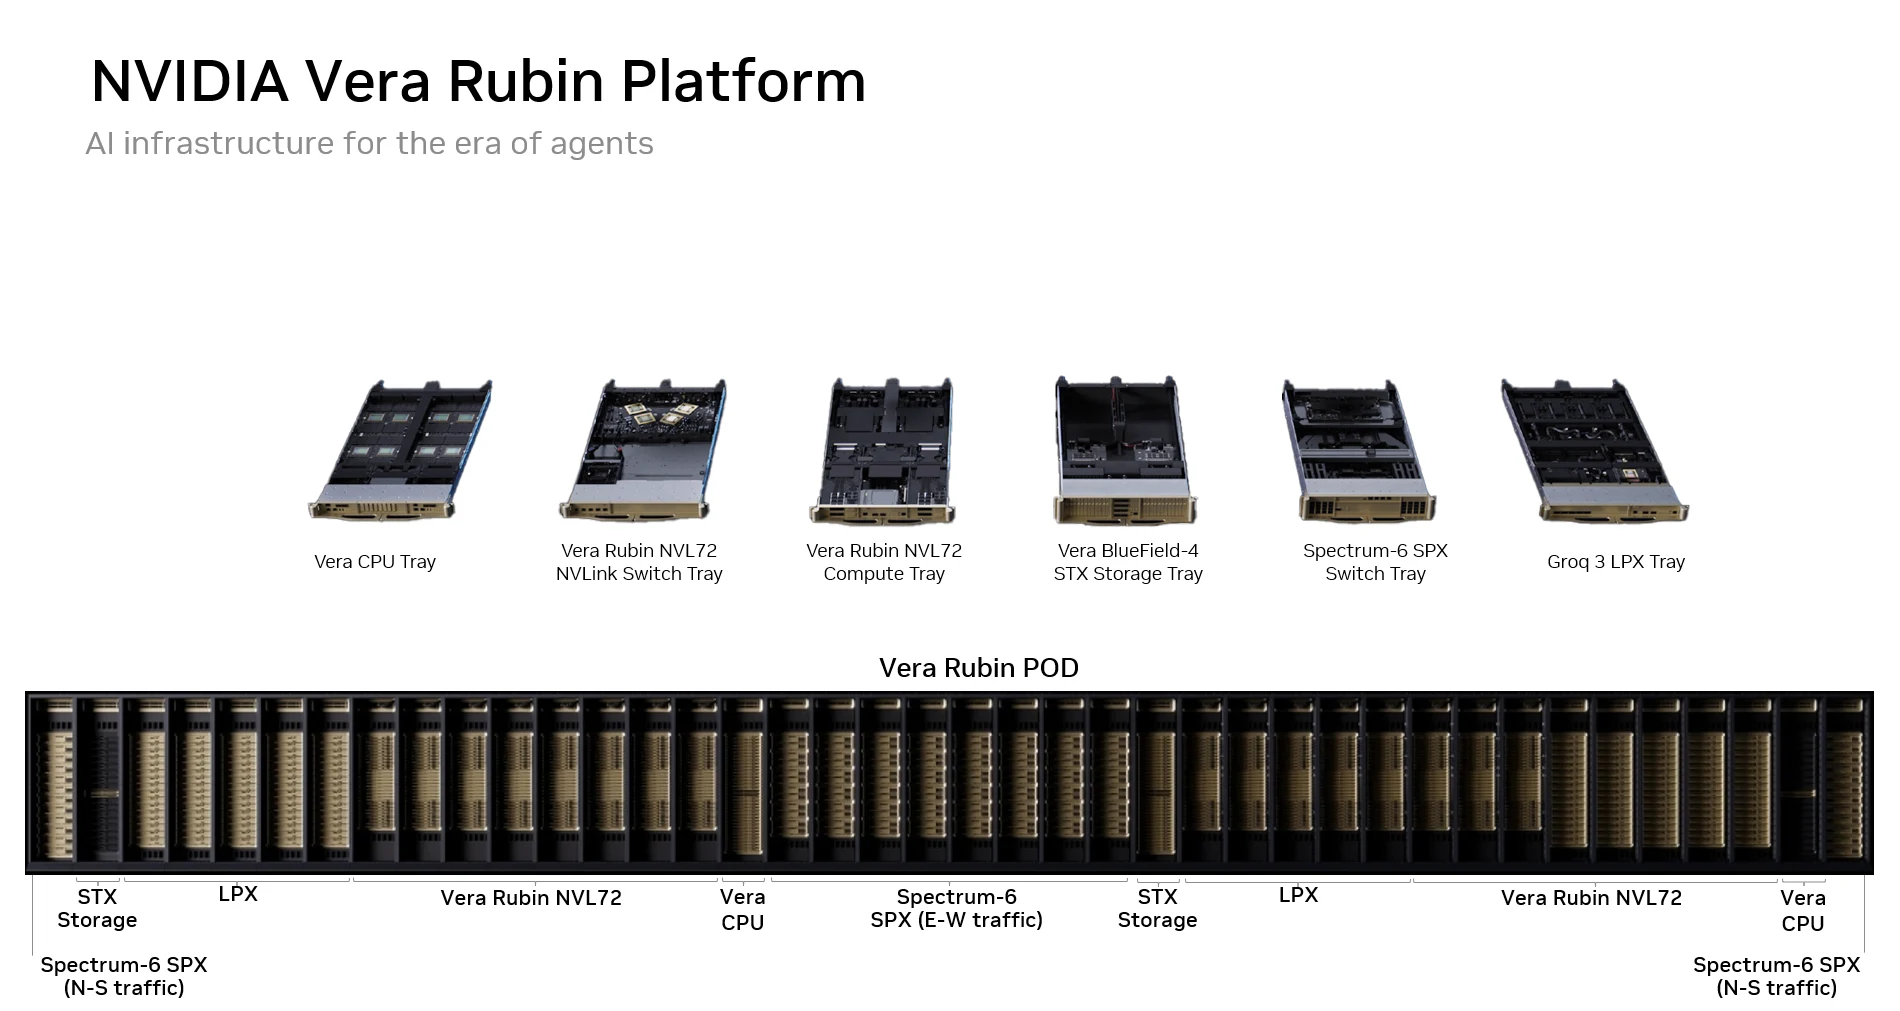
Vera Rubin 플랫폼은 랙 구성 요소의 극도한 공동 설계를 통해 훌륭한 성능을 제공합니다. 이 플랫폼에는 에이전트형 AI 워크로드를 위한 다섯 가지 새로운, 독특하고 특별히 설계된 랙 규모 시스템이 포함됩니다: Vera Rubin NVL72, Vera CPU 랙, Groq 3 LPX, Spectrum-6 SPX, 그리고 BlueField-4 STX 스토리지입니다.
단일 Vera Rubin NVL72는 GB200 NVL72보다 5배 더 많은 NVFP4 인출 FLOPS와 2.4배 더 높은 메모리 대역폭을 제공합니다. 스케일업 네트워크 측면에서 6세대 NVLink는 Blackwell보다 최대 1.7배 더 많은 대역폭을 제공하여, 프로덕션 에이전트 서비스 시나리오에서 훨씬 더 나은 사용자 경험을 가져옵니다.
소프트맥스. 특히 루빈은 소프트맥스 성능도 향상시켰는데, 이는 LLM 인텔리전스의 핵심 연산입니다. 루빈은 NVIDIA GB200에 비해 2배의 FP32 처리량과 4배의 BF16/FP16 처리량을 제공하여, 소프트맥스가 더 빠른 행렬 연산에 맞춰 성능을 유지할 수 있도록 합니다.
메모리. 루빈의 HBM은 HBM3e에서 HBM4로 업그레이드되었으며, GB200 NVL72에 비해 최대 2.4배 더 높은 대역폭을 제공합니다. 더 강력한 컴퓨팅 성능과 함께 루빈 GPU는 GEMM, MoE(전문가 혼합), 주의 등 중요한 LLM 인식 작업을 가속화하며, 전체 처리량이 훨씬 높고 디코드 지연 시간이 줄어듭니다(자세한 내용은 아래를 참조하세요).
네트워킹. Rubin 플랫폼에서 인터-GPU 네트워킹도 크게 향상되었습니다. 6세대 NVLink는 이전 세대보다 1.7배 더 높은 네트워크 대역폭을 제공합니다. 이로 인해 AllReduce 및 All2all과 같은 집합적 통신 작업과 기타 통신 작업이 빨라지고, 대규모 LLM 인퍼닝의 속도와 확장성도 향상됩니다(예: prefill/decode disaggregation, wide expert parallelism).
vLLM 루빈 지원 상태
vLLM 커뮤니티는 Rubin이 공개된 직후 그 활성화 작업에 착수했습니다. vLLM 커뮤니티의 중요한 구성원인 NVIDIA, Inferact 및 Red Hat의 엔지니어들이 협력하여 모든 사용자가 Rubin 플랫폼에서 임의의 모델을 쉽게 배포할 수 있도록 기여했습니다.
이 섹션에서는 vLLM의 지속적인 Rubin 전용 지원에 초점을 맞춥니다. 즉, 지역성 도메인을 활용하는 방식과 Rubin 하드웨어에서 바로 사용할 수 있도록 한 사용자 경험 개선 사항입니다.
지역 도메인 지원
아미페르 이후로 NVIDIA GPU는 불규칙한 전역 메모리 접근 기능을 지원해 왔습니다. NVIDIA CUDA 13.4의 로케이션 도메인 기능을 통해 애플리케이션은 계산과 데이터를 동일한 로케이션 도메인 내에 배치함으로써 불규칙한 전역 메모리 접근을 최대한 활용할 수 있습니다. SM은 다른 도메인의 HBM보다 더 높은 대역폭과 낮은 지연 시간으로 자신의 로케이션 도메인 내에서 전역 메모리를 접근할 수 있습니다. 그린 컨텍스트와 CUDA 스트림을 통해 각 로케이션 도메인에 하나의 커널을 실행할 수 있어 각 커널이 로컬 메모리를 접근할 수 있습니다. 이 기능은 MoE 디코딩과 같은 메모리에 의존하는 워크로드를 주로 가속화합니다. 로케이션 도메인은 현재 활발한 설계 및 개발 단계에 있습니다. 이 섹션에서는 MoE 디코딩을 예시로 삼아 자세히 살펴보겠습니다.
확대하려 클릭그림 3. MoE 전진 방식에서 두 지역성 도메인에 대한 Split-N. 가중치 W는 N/2 지점에서 열로 나뉘며, 각 도메인의 SM은 자신의 HBM에서 W의 절반만을 읽기 때문에 각 도메인은 자체 로컬 메모리 대역을 사용합니다. 입력 X과 출력 C는 두 도메인 모두에 존재합니다. Pause, Prev/Next 또는 스텝 칩을 사용하여 단계를 진행할 수 있습니다.
MoE 디코딩은 HBM에서의 읽기 무게를 활용하므로, 우리의 목표는 지역성 영역 전반의 메모리 처리 속도를 최적화하는 것입니다. Rubin의 새로운 지역성 영역 기능을 처음으로 살펴보면서, 그림 3에 나타난 바와 같이 FC1과 FC2 모두에서 split-N 전략을 사용합니다. 무게 열을 세로로 나누고 각 샤드를 각 지역성 영역의 전체 메모리에 배치하며, 각 영역의 SM들을 해당 로컬 샤드 내로 제한합니다. 이는 대부분의 크로스-디멘션 메모리 접근을 제거하여 커널 성능과 전력 절약을 향상시킵니다. 디코드 과정에서 활성화 메모리가 비교적 작기 때문에, 두 메모리 영역에 걸쳐 비로컬화하지 않으면 최소한의 오버헤드만 발생합니다.
SM들은 항상 동일한 도메인으로 분할될 수는 없습니다. 기본적으로 지역 도메인 생성 과정에서는 동일한 분할을 시도할 때 그 SM들을 포함하지 않습니다. 두 분할 모두에 동일한 SM을 갖도록 하려면 도메인을 생성할 때 cudaDevSmResourceGroupBackfill (백필름 모드)를 활성화해야 합니다(더 자세한 내용은 공식 지역 도메인 문서를 참조하십시오). 우리의 성능 연구에서 기본 모드(두 도메인 모두에 200개의 SM만 사용됨)와 백필름 모드(전체 212개의 SM이 사용됨)를 모두 포함했습니다.
그림 4은 다양한 병렬 전략에서 예비 MoE 계층의 전방 시간(FC1 + FC2)과 지역성 도메인이 활성화된 경우와 비활성화된 경우를 비교합니다. MiniMax M3 MoE 구조를 예시로 사용합니다. 지역성 도메인을 활성화하면, 작은 토큰 전방 설정에서 평균적으로 1.2배의 속도 향상을 얻을 수 있습니다. 다른 TP 및 EP 서빙 전략에도 이러한 추세가 유지됩니다. 212개의 SM 중 200개만 사용되는 기본 모드에서도 지역성 도메인을 활성화하면 비슷한 이점을 얻을 수 있습니다. 주요 이유는 소형 토큰 디코딩에서 전진 통과 과정이 무게 로딩에 의해 지배되며, 지역화 도메인은 더 높은 HBM 처리량을 가능하게 한다는 것입니다. 이러한 초기 결과는 단지 시작점일 뿐이며, Rubin에서 지역화의 성능 이점을 극대화하기 위해 추가적인 조정과 최적화가 필요합니다.
확대하려 클릭그림 4. Rubin 상의 MiniMax M3 MoE 계층에서 각 랭크별 예비 FC1 + FC2 지연 시간(비국소화 vs 국소화, 낮은 값이 더 좋음), 그리고 각 쌍 위의 속도 향상(비국소화 ÷ 국소화 지연 시간)을 나타냅니다. 탭을 클릭하면 병렬 전략(TP2, TP4, EP2, EP4)으로 전환되며, 토글 버튼을 통해 백필 모드(212개의 모든 SM)와 기본 모드(212개 중 200개의 SM)로 전환됩니다. 균형된 라우팅 방식이며, 통신 시간은 포함되지 않습니다.
데이-0 사용성
사용성은 항상 vLLM의 최우선 과제입니다. 현재 사용자들은 CUDA 13.4와 PyTorch 2.15를 사용하여 생성된 야간 이미지를 vLLM의 Docker Hub에서 다운로드하고 사용할 수 있습니다. 즉, vllm/vllm-openai:cu134-nightly를 Rubin 하드웨어용으로 이용할 수 있습니다.
블랙웰 소프트웨어 스택 호환성. 루빈은 블랙웰의 아키텍처 제품군을 기반으로 하며, 확장된 tcgen05 텐서 코어 명령어를 사용합니다. 이는 새로운 GPU 컴파일 대상(sm107)이지만, 블랙웰 제품군 대상(sm100f)용으로 제작된 커널도 이에 실행될 수 있습니다. 실제로 vLLM의 블랙웰 커널, 특히 GEMM이 많이 사용되는 것들, 예를 들어 애널리틱과 MoE는 어떠한 변경도 없이 루빈에서 이미 실행될 수 있습니다.
일일 컨테이너 빌드. Rubin의 일일 컨테이너 빌드는 이미 제공됩니다 (#55953), #53443와 #54640를 통해 CUDA 13.4의 Rubin 빌드 경로에 활성화되었으며, #56545와 #59288를 통해 Rubin 의존성 업데이트가 이루어집니다.
모델 커버리지. 이러한 부품들이 설치되면, vLLM은 Rubin에서 DeepSeek, Kimi, GLM, MiniMax 등 다양한 모델을 제공할 수 있게 됩니다.
루빈으로 튜닝된 커널
점차적으로 루빈 특정 하드웨어 기능과 성능을 활용하는 커널들이 출시되고, FlashInfer, vLLM의 MSA 포크(vllm-project/MSA), Humming(vllm-project/humming) 등의 커널 라이브러리로 업스트림되고 있습니다. 현재 vLLM은 루빈 성능을 최대화하기 위해 밀도형 NVFP4 또는 MXFP4 GEMM, NVFP4 MoE, FP8 attention, FP8 MSA prefill 등 몇 가지 중요한 커널을 통합했습니다.
성능
Vera Rubin NVL72 GPU를 사용하여 vLLM의 성능을 평가하는 데 두 가지 대표적인 벤치마크를 사용합니다: SemiAnalysis AgentX(우리의 이전 글에서 자세히 설명됨)와 MLPerf Inference v6.1입니다.
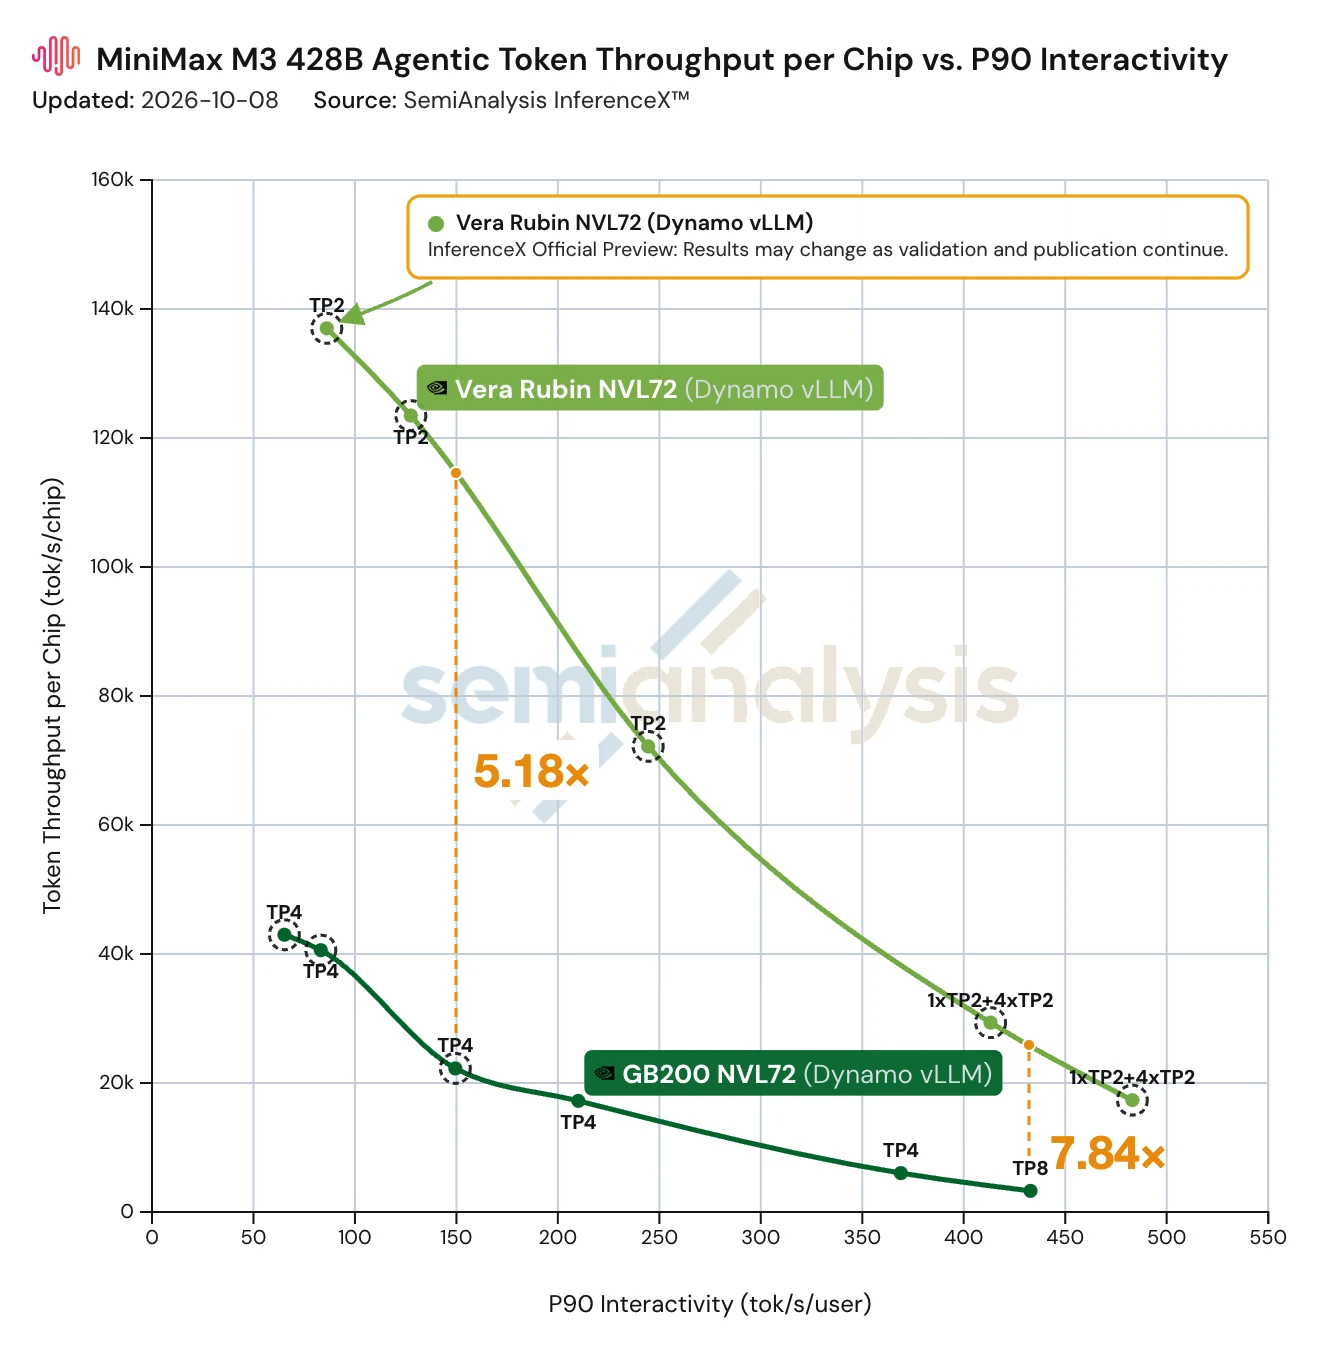
AgentX에서 vLLM이 Vera Rubin NVL72에 MiniMax M3를 실행할 때, NVIDIA GB200과 동일한 상호작용 수준에서 7.84배의 처리량을 제공하며, 150 TPS 제약 조건 하에서는 5.18배 더 높은 처리량을 달성합니다. 이는 플랫폼의 인출 능력에 대한 매우 초기적인 관찰 결과입니다. Vera Rubin NVL72 노드를 더 많이 확보할수록 테스트 범위를 넓히고 최적화 작업을 가속화할 수 있으며, 작업이 진행됨에 따라 더 큰 성능 향상이 기대됩니다.
MLPerf Inference v6.1 라운드는 vLLM을 NVIDIA Vera Rubin NVL72 플랫폼에 도입하기 위한 첫 번째 테스트 환경이었습니다. 비전 언어 모델(VLM) 벤치마크에서, vLLM을 백엔드 인추팅 엔진으로, Dynamo을 프론트엔드 라우터로 사용하여 Qwen3-VL-235B-A22B 모델을 배포한 결과, Vera Rubin NVL72는 오프라인, 서버 및 대화형 환경에서 GB300 NVL72보다 3.7배 더 높은 처리량을 제공했습니다. 발표된 MLPerf Inference v6.1 결과에 대한 자세한 내용은 NVIDIA의 블로그 글에서 확인할 수 있습니다.
다음 단계
“로마는 하루에 세워진 것이 아닙니다.” Vera Rubin NVL72 GPU의 사용성과 성능을 개선하는 과정은 흥미진진한 여정이 될 것입니다. 가까운 미래에 우리는 공동체로서 협력하여 Rubin GPU에 더 많은 새로운 기능을 추가할 계획입니다. 그 기능에는 다음과 같은 것들이 포함되지만 이에 국한되지 않습니다:
- FlashInfer MegaMoE를 통해 sm107 FlashInfer MegaMoE를 vLLM에 통합하세요.
- MoE 계층에 대한 로케일 도메인을 완전히 활성화합니다.
- PDL과 Lamport 동기화를 통해 서로 다른 계층이나 핵심 부분들 사이의 더 많은 겹치는 기회를 발견하고 활용하세요.
- 지연에 민감한 사용 사례를 위한 메가 커널을 살펴보세요.
- Kimi K3용으로 Rubin에서 KDA와 MLA 커널을 최적화하세요.
- DeepSeek-V4.1-Flash에 Rubin CSA 및 HCA 커널을 통합하세요.
- Rubin MSA 디코드 커널을 완료하고 통합하세요.
- FlashInfer를 통해 CFT counted-write MoE all-to-all 커널을 vLLM에 통합합니다.
감사의 말
이 작업은 Inferact, NVIDIA, Red Hat 및 더 넓은 vLLM 커뮤니티의 협력으로 이루어졌습니다. 특별한 감사를 드립니다:
- NVIDIA는 Vera Rubin NVL72에 대한 조기 접근과 개발 전반의 긴밀한 협력을 제공합니다.
- 인페럿과 NVIDIA는 루빈 협력을 이끌고, 성능 조정을 추진하며, MSA 커널을 통합하고, 지역성에 대한 인식을 갖춘 MoE의 성능을 분석하는 데 기여했다.
- NVIDIA와 Red Hat은 Rubin을 위한 매일의 Docker 빌드를 설정하고 활성화하는 작업을 수행합니다.
- vLLM 커뮤니티는 전 과정에서 지속적인 지원과 기여를 해주었습니다.
부록: Vera Rubin NVL72에서 vLLM을 실행하기
Rubin의 커널 설정을 표시합니다vLLM은 이미 루빈용을 위해 고도로 최적화된 커널 몇 가지를 통합했습니다. 이 섹션에서는 루빈 GPU에서 최대 성능을 구현하기 위한 해당 설정에 대해 다룹니다.
- CuTe-DSL dense NVFP4 또는 MXFP4 GEMM. 기본적으로 NVFP4/MXFP4 모델 점검점에 대해 활성화되지만,
--linear-backend flashinfer_cutedsl를 사용하여 NVFP4를,--linear-backend flashinfer_cutlass를 사용하여 MXFP4를 설정하면 활성화된다는 것을 확인할 수 있습니다. - CuTe-DSL NVFP4 MoE.
--moe-backend flashinfer_cutedsl를 통해 활성화할 수 있습니다. - CuTe-DSL로 마스킹된 그룹화된 GEMM이 “배치된” 전문 형식에서 NVFP4 W4A4 MoE에 적용됩니다. 이는
--enable-expert-parallel --data-parallel-size N --all2all-backend deepep_low_latency|nixl_ep를 사용하는 배포에 적용되며, 여기서N>1입니다. 이 경우--moe-backend auto|flashinfer_cutedsl모두 이 커널로 해석됩니다. - CuTe-DSL FP8 BMM은 정적 퍼텐서 FP8 W8A8 선형 레이어에 사용됩니다. 기본적으로 활성화되어 있으며, FlashInfer 자동 튜닝기를 통해 활용될 수 있습니다.
- Trtllm-gen FP8 주의. 활성화하려면
--kv-cache-dtype fp8또는 FP8 KV 캐시를 지정하는 체크포인트를 통해 FP8 KV 캐시를 사용하거나--attention-backend FLASHINFER|FLASHINFER_MLA를 설정해야 합니다. DeepSeek 스타일의 MLA 예비 충전을 위해서는-ac.mla_prefill_backend=TRTLLM_RAGGED -ac.use_prefill_query_quantization=true도 추가해야 합니다. - CuTe-DSL FP8 MSA 프리필. 이 기능을 활성화하려면
--kv-cache-dtype fp8또는 FP8 KV 캐시를 지정하는 체크포인트를 통해 FP8 KV 캐시를 설정하고, 또한--attention-config.minimax_m3_msa_decode_backend=cutlass를 설정해야 합니다.