
일수 | 압비사에서 발행
양자위 | 공식 계정 QbitAI
게임을 하면서 동시에 자신을 업그레이드하나요?
훌륭하네요, 화웨이는 이번에 AI가 《놀이하면서 강해짐》을 배우게 만들었군요?!
최근 연구에 따르면, 화웨이 노아방록 실험실과 UCL 등의 팀이 Memento 3이라는 AI 지능형 시스템을 개발했습니다.
ARC-AGI-3 공개 세트에 있는 25개의 게임과 183개의 레벨을 모두 클리어했습니다.
아직는 무의식적인 시도와 실험을 통해 헤쳐나온 것이 아니었다.
인간이 같은 일련의 레벨을 완료하는 데 17135번의 조작이 필요합니다.
그리고 Memento 3는 7518번만 사용되었으며, 인간보다 약 56% 적은 횟수로 사용되었고, 결국 100점에 달하는 RHAE 성적을 얻었습니다 (Relative Human Action Efficiency, 상대적 인간 행동 효율).
더 이상 말도 안 되는 것은, 이 시스템은 Claude Opus 5를 기반 모델로 사용했으며, 전체 과정에서 모델 가중치를 업데이트하지 않았고 게임에 맞게 미세 조정도 하지 않았습니다.
그냥 스스로 게임을 하면서 규칙을 생각해내고 코드를 작성한다. 잘못된 부분이 있으면 반성하고 수정하기도 한다.
그런 다음에는… 전체 만점으로 클리어했다.
비교해보면, Claude Opus 5는 ARC Prize 공식 표준 테스트 환경에서 평균 RHAE가 약 40.7점에 불과합니다.
같은 기반 모델에 스마트체인지 시스템을 적용하자 성적이 직접 59.3점으로 급상승했습니다.
아직 끝나지 않았어.
이 방법은 수수께끼 게임을 플레이하는 데만 사용되지 않고, 연구팀은 이를 Atari의 클래식 게임인 Pong을 플레이하도록도 했습니다.
결국 AI는 스스로 제어 전략을 찾아냈고, 이후 대형 모델에 요청하지 않고도 3라운드 연속으로 상대를 21:0으로 이겼다.
아니요, 대형 모델들은 이후의 작업에 참여하지 않는데, 게임을 이렇게 잘 할 수 있다는 건?!
이 연구의 제목에 바로 핵심이 숨겨져 있습니다:
모델 기반의 재귀적 자기개선, 세계 모델을 기반으로 한 재귀적 자기향상.
화웨이 AI는 25종의 게임을 직접 클리어했으며, 조작 횟수는 인간보다 56% 더 적습니다.
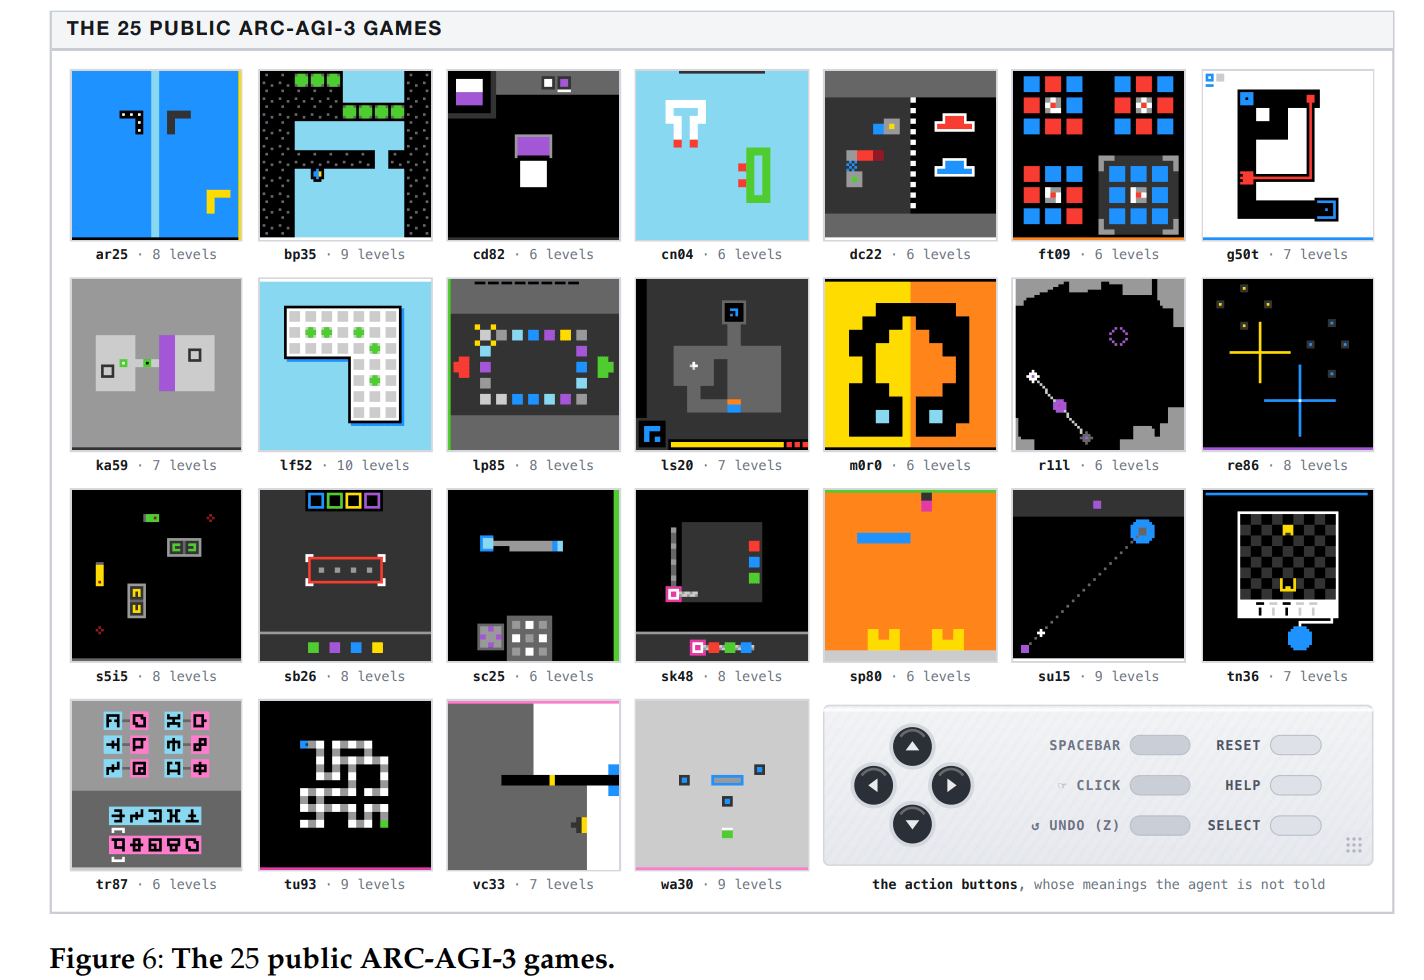
먼저 이 25개의 게임이 도대체 어떤 것들인지 말해보겠습니다.
그것들은 ARC Prize가 출시한 ARC-AGI-3에서 나왔습니다. AI 평가에 관심이 있는 분이라면 ARC 시리즈에 익숙할 것입니다.
하지만 이 세대에는 매우 명확한 변화가 있었습니다:
더 이상 문제를 제시하고 풀이하는 방식만이 아닙니다. 이번에는 AI를 낯선 게임 세계에 투입하는 것입니다.
규칙은 AI가 스스로 추측해야 하는 것이고, 목표는 AI가 스스로 찾아야 하는 것이며, 조작이 어떤 결과를 낳는지도 AI가 스스로 시험해보아야 합니다.
AI: 모든 것이 나에게 달려 있잖아~
이 25개의 공개 게임은 총 183개의 레벨을 포함하며, 그래픽은 대부분 단순한 픽셀, 블록, 색상 및 그래픽으로 구성되어 있습니다.
첫눈에 보면 마치 몇 십 년 전의 작은 게임 모음집과 비슷해 보인다.
하지만 이 소박한 그림 스타일에 속아서는 안 됩니다.
AI에게 있어서 어떻게 작동하는지 하는 것은 가장 어렵지 않지만, 가장 골치 아픈 것은 이 세계가 어떻게 작동하는지 전혀 모르는 것입니다.
특수 바닥에 올라갔을 때 무슨 일이 일어나나요? 문이 열리지 않아요. 색상이 맞지 않는 건가요, 아니면 모양이 맞지 않는 건가요?
더욱 골치 아픈 것은, 뒤에 오는 레벨들에서 새로운 규칙이 등장하여 이전에 터득한 경험을 모두 무시하게 되는 것입니다.
AI라고 하지 마세요, 인간 플레이어도 막히는 경우가 있습니다.
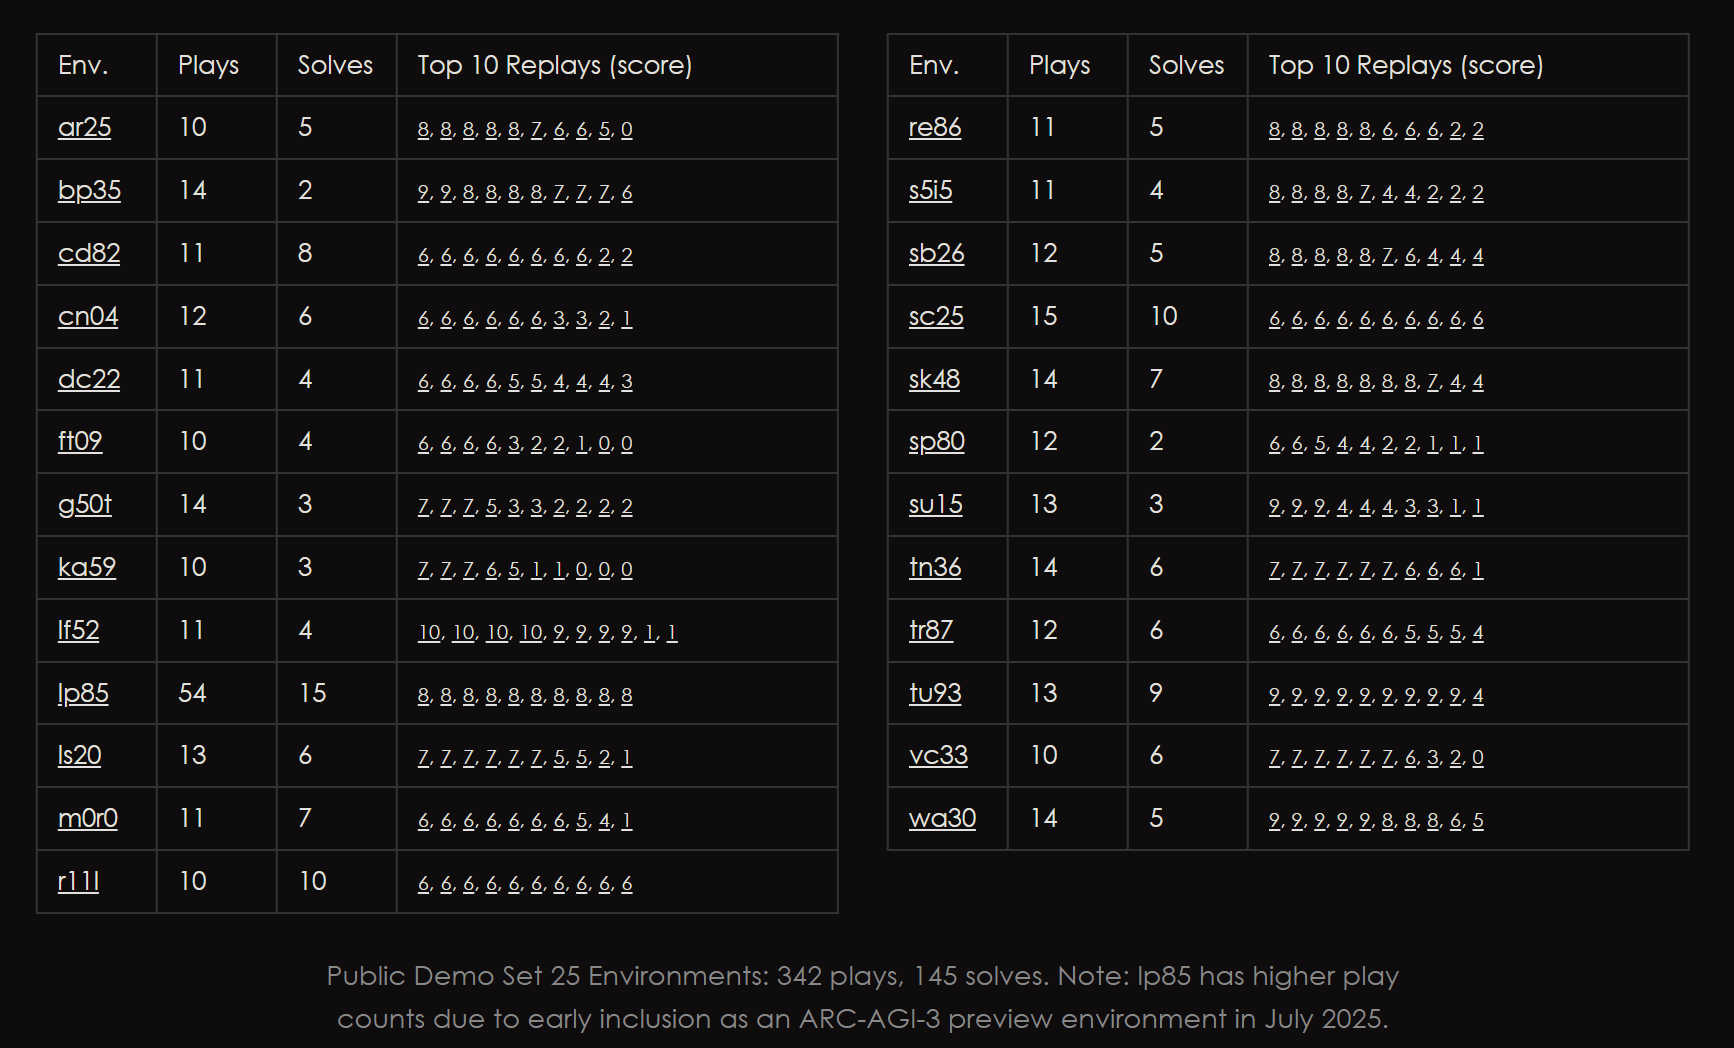
ARC Prize의 테스트 데이터에 따르면, 편모충의 움직임과 색상 변화를 조절해야 하는 퍼즐 게임 r11l에서는 10명의 참가자가 모두 클리어했지만, 기호 해독 능력을 시험하는 퍼즐 게임 tr87에서는 12명이 도전했으나 단 6명만이 성공했습니다.
화웨이 AI 이전에 이미 각 연구팀들이 상당히 치열한 경쟁을 벌이고 있었습니다:
프린스턴 대학교가 출시한 Continual Harness는 단 3개의 게임만 클리어하여 20.5점을 얻었습니다.
엔비디아 연구원들이 참여한 DreamTeam은 조금 더 나았으며, 6개의 레벨을 클리어하여 38.1점을 얻었습니다.
더 위쪽으로는 독립 연구자 데이비드 코우티스가 개발한 OPINE-World와 엔비디아 팀의 NOOA가 각각 78.4점과 85.1점을 받았습니다.
가장 뛰어난 것은 독립 개발자 세르게이 로디오노프의 baseline1으로, 25개의 게임을 모두 플레이했으며 99점을 얻어 만점에 단 1점만 남았습니다.
하지만 화웨이 팀은 이번에 직접 마지막 1점도 만회했습니다.
Memento 3는 100점의 성적으로 25개의 게임과 183개의 레벨을 모두 클리어했으며, 총 조작 횟수는 7518회에 달했습니다. 이는 baseline1의 8347회보다 829회 적은 수치입니다.
통과하는 것뿐만 아니라, 더 적은 단계로 통과했습니다.
어떻게 해낸 거야??
대형 모델을 훈련할 필요 없이, AI는 스스로 전략을 작성함으로써 “몬스터를 물리치고 업그레이드”를 실현한다.
논문을 살펴보니, Memento 3의 핵심 방법은 Code as Model(코드 즉 모델)라고 합니다.
듣기에는 다소 추상적이지만, 실제로는 AI가 게임을 플레이하는 과정에서 자신에게 두 가지 것을 준비하도록 하는 것입니다.
지속적으로 업데이트되는 게임 가이드와 게임 실행을 시뮬레이션할 수 있는 코드 세트.
- 규칙서: 게임에서 AI가 발견한 규칙들을 기록한 Markdown 문서로, 어떤 조작이 어떤 효과를 유발하는지, 어떻게 클리어할 수 있는지, 그리고 아직 이해되지 않은 규칙들이 무엇인지 등이 포함됩니다.
- 실행 가능한 세계 모델(Executable World Model): AI는 자신이 정리한 규칙을 직접 실행 가능한 Python 코드로 작성하여, 간소화된 게임 시뮬레이터를 만들어내는 것과 같습니다.
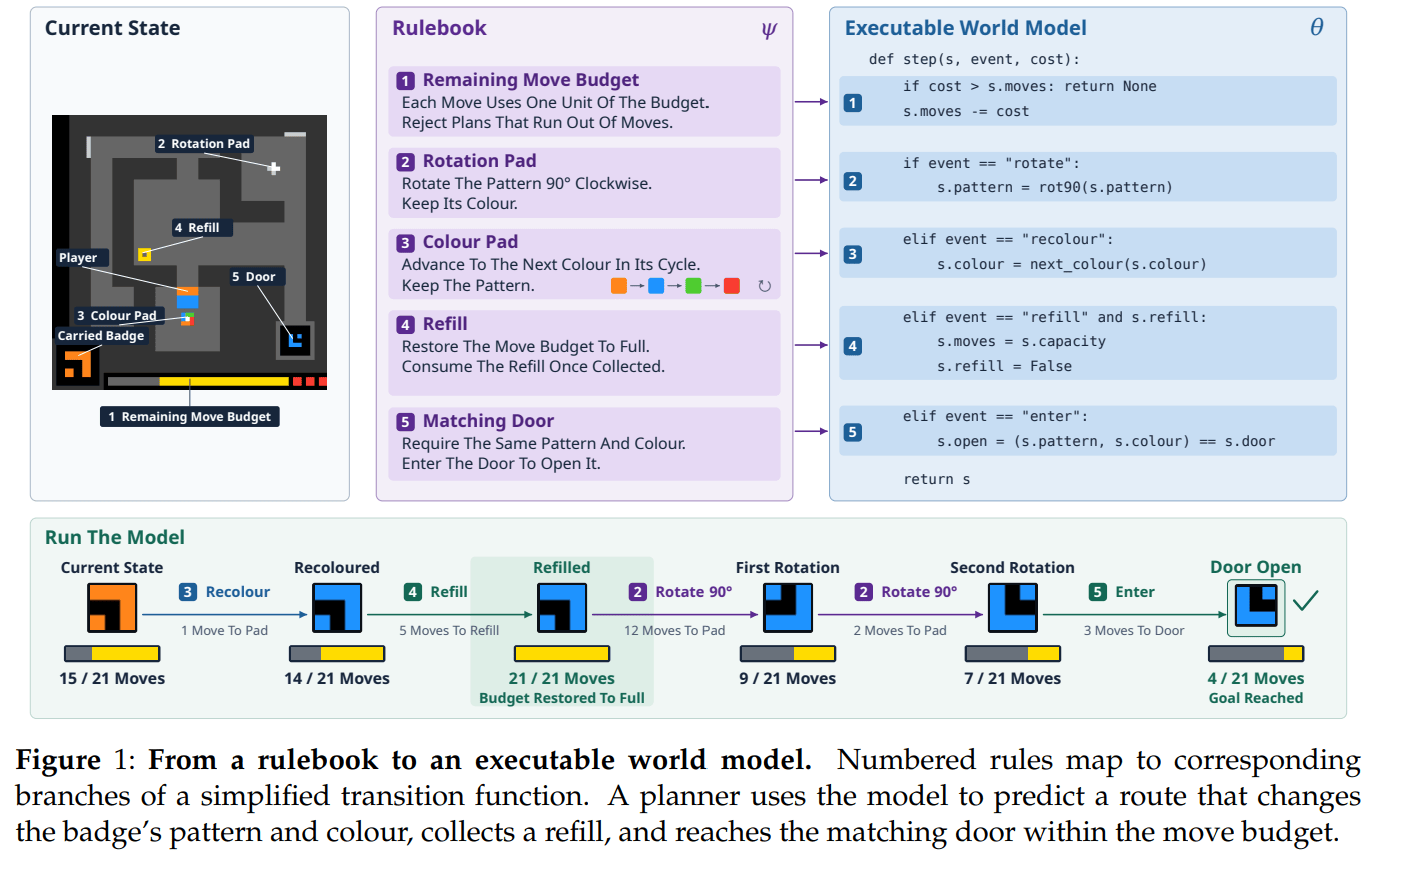
이 두 가지를 갖추면 AI는 자신이 만든 시뮬레이터에서 다양한 경로를 시뮬레이션한 뒤 다음 단계로 어떻게 나아갈지 결정할 수 있다.
하지만 문제가 생깁니다. 만약 처음부터 게임 규칙이 잘못된다면 어떻게 할까요?
서두르지 마세요, Memento 3은 스스로 가이드를 작성할 뿐만 아니라, 잘못된 것을 발견하면 그걸 바로 수정해서 다시 시작할 수도 있습니다.
논문에는 한 가지 예시가 제시되어 있습니다.
AI는 수수께끼 게임에서 특별한 바닥을 만나게 되는데, 처음에는 그 위를 밟으면 캐릭터가 가진 패턴이 들어갈 방향에 따라 반전될 것이라고 생각했습니다.
결국 실제로 시도해보니, 패턴은 뒤집히는 것이 아니라 시계 방향으로 90도 회전하는 것으로, 들어오는 방향과는 상관없습니다.
그래서 AI는 규칙 매뉴얼을 수정했고, 해당하는 Python 코드도 함께 업데이트되었습니다.
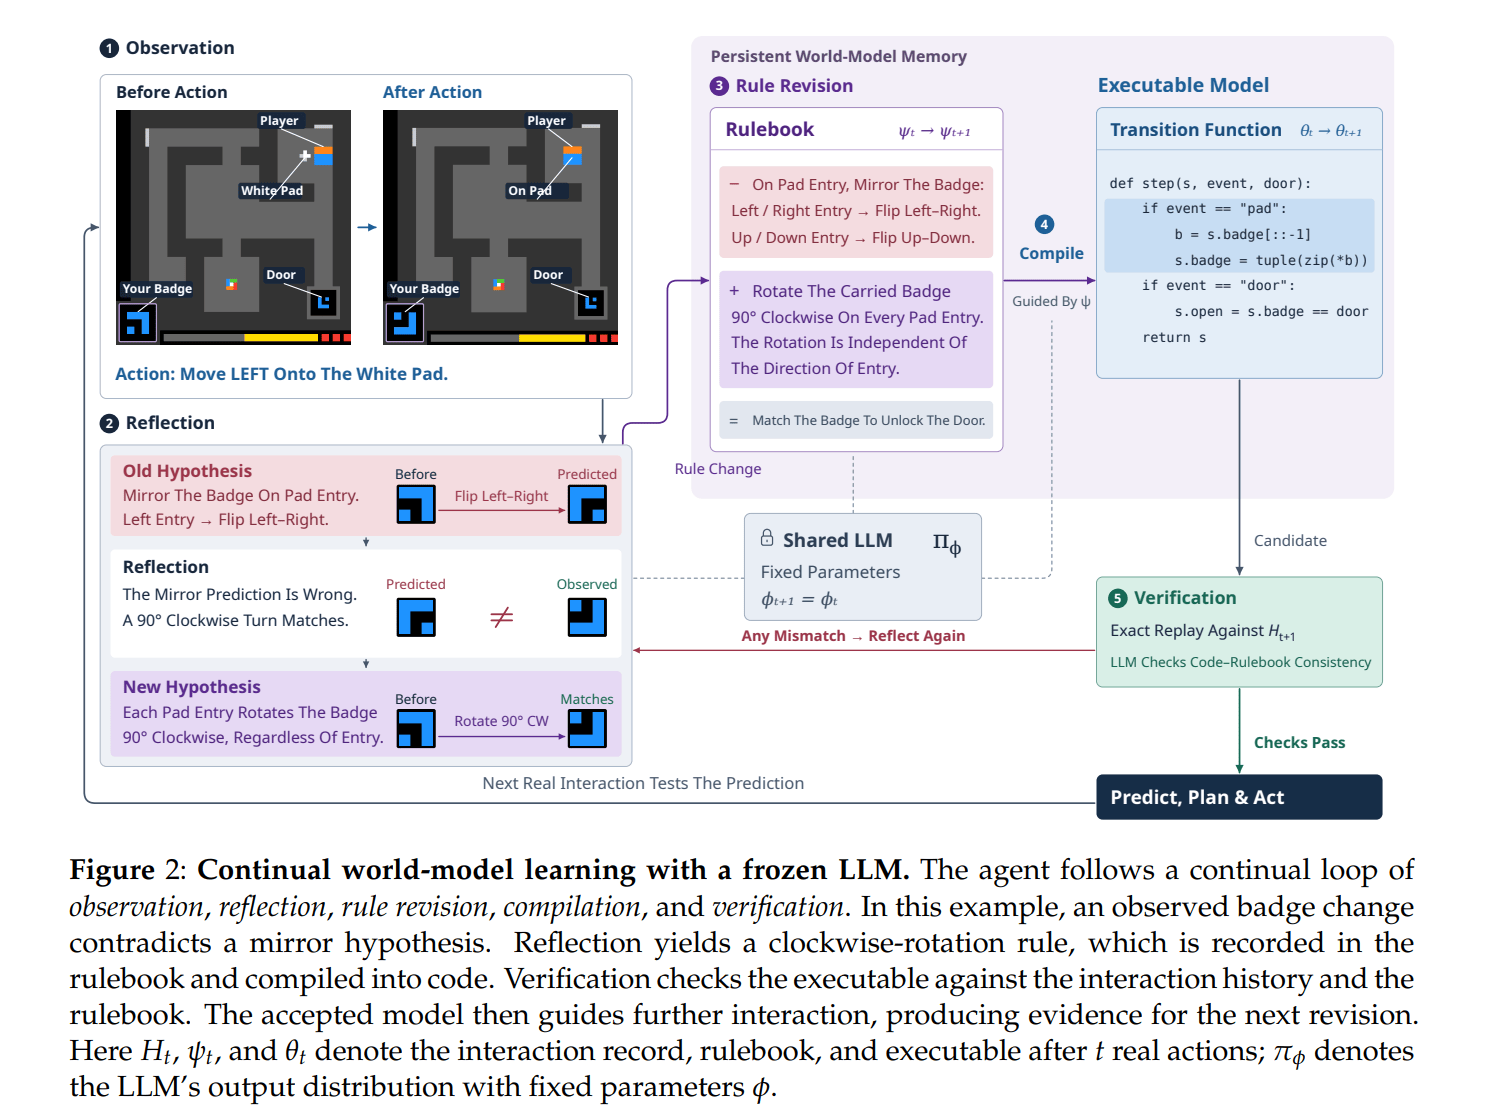
하지만 수정한 후에는 다시 검토해야 합니다.
시스템은 이전의 작업을 다시 시뮬레이션하여 64×64 크기의 게임 화면을 한 칸 한 칸 비교함으로써 코드가 실제 결과를 정확하게 재현할 수 있는지 확인합니다.
맞지 않으면 계속 수정하세요.
그렇게 해서 AI는 탐색하면서 오류를 수정했고, 규칙은 점점 더 정확해졌다.
그리고 앞서 배운 경험도 이후의 레벨에서도 활용할 수 있습니다.
예를 들어 기호 해독 게임 tr87의 경우, AI는 처음에는 기호의 방향이 의미에 영향을 미치는지 구분하지 못했지만, 나중에는 서로 다른 방향의 기호가 같은 문자를 나타낼 수 있다는 것을 발견했습니다.
새로운 레벨이 등장함에 따라, 커서 위치에 대한 이전의 이해가 다시 뒤집히게 되었다.
전체 게임 동안 동일한 규칙 매뉴얼이 11개 버전으로 업데이트되었습니다.
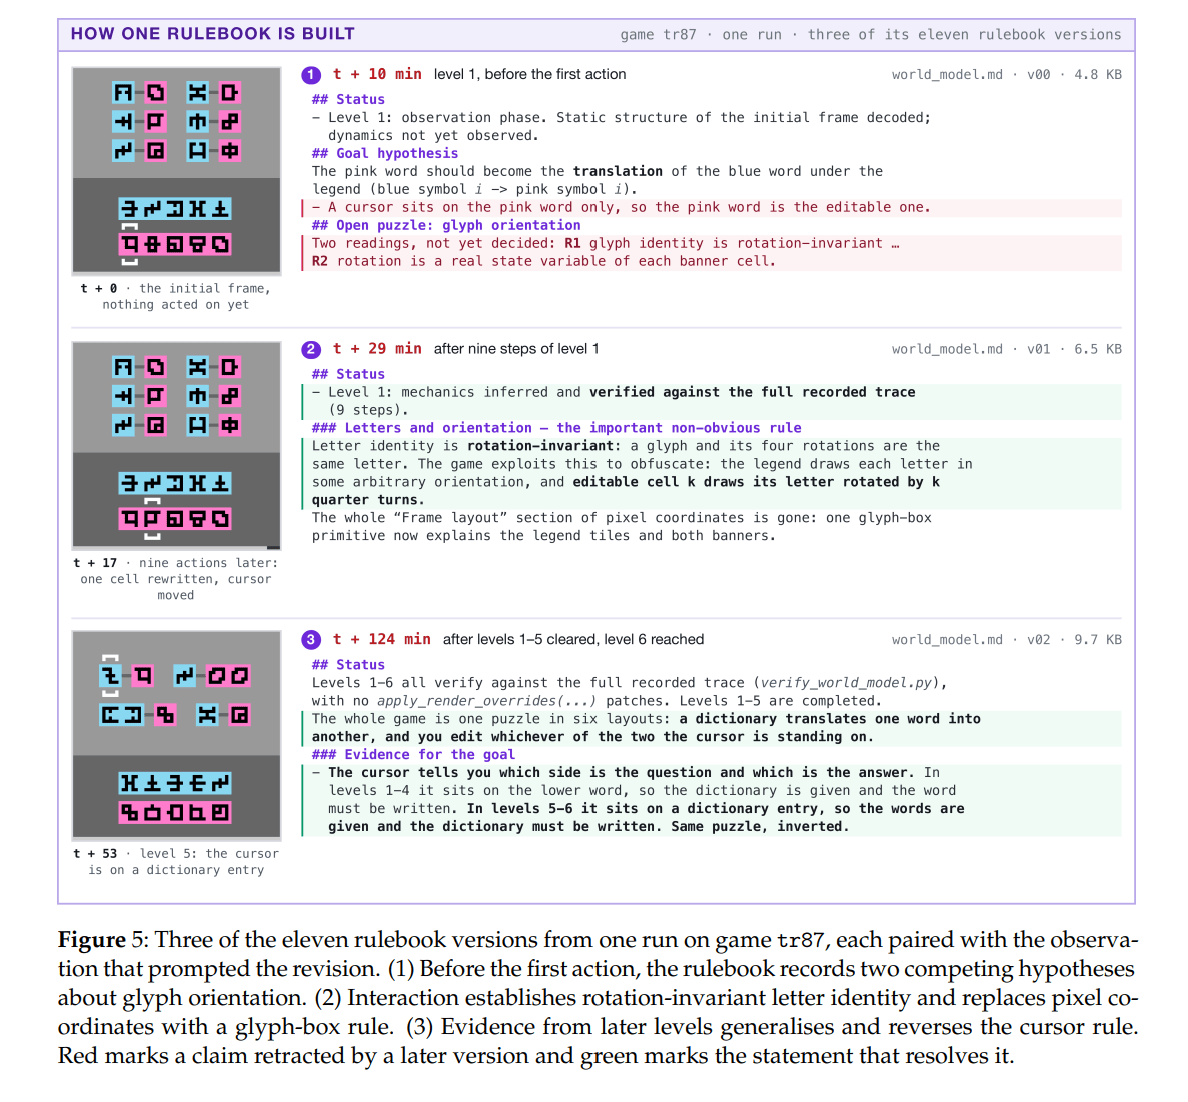
복습을 편리하게 하기 위해, 연구팀은 심지어 Git 버전 관리도 도입했습니다.
모든 규칙과 코드를 수정할 때 기록이 남으므로, 어디를 잘못 수정했는지 발견하면 과거 버전을 확인할 수 있고, 필요한 경우 직접 복원할 수도 있다.
훌륭하네요, 게임을 하면서 코드 저장소도 관리하고 있어요.
이것도 바로 연구팀이 말하는 재귀적 자기개선(RSI)입니다.
대형 모델 매개변수는 변경하지 않아도 되며, AI는 지식을 쌓고 규칙과 코드를 수정함으로써 점점 더 숙련된 상태가 됩니다.
게다가, 이 방법은 실제로 데이터를 바탕으로 하고 있습니다.
연구팀은 세 가지 게임에서 대조 실험을 진행했습니다:
규칙 매뉴얼을 유지할 때는 AI가 총 617번의 작업을 사용했으며, 규칙 매뉴얼을 제외하고 코드 세계 모델만 유지하려면 677번의 작업이 필요했습니다.
이 가이드북을 갖게 되면 조작 횟수가 약 9% 줄고, 스마트체의 실행 횟수도 약 18% 감소합니다.
하지만 연구팀은 이에 만족하지 않았습니다.
세계 모델 하나가 AI가 길을 잃는 것을 줄일 수 있다면, 두 개를 함께 사용하는 건 어떨까?
그래서 그들은 AI가 두 가지 세계 모델을 동시에 관리하도록 했으며, 게임 조작 기록을 공유하되 각각 다른 규칙 가정을 적용하도록 했다.
결과적으로 게임 wa30에서 단일 월드 모델은 클리어하려면 899번의 조작이 필요했지만, 이중 월드 모델로 바꾸면 597번으로 직접 줄어들었다.
작동 횟수가 약 34% 감소했습니다.
물론, 이 향상은 현재 wa30에서만 확인되었으며, 다른 게임으로 직접 확산되는 것은 아직 아닙니다.
하지만 적어도 이 실험들에서 Memento 3은 한 가지를 증명했습니다:
대형 모델을 다시 훈련할 필요 없이, AI는 자신이 세계를 이해하는 방식을 계속 수정함으로써 점점 더 강해질 수 있다.
게임이 21:0으로 끝나면, AI는 더 이상 대규모 모델을 호출할 필요가 없다
그 방법은 수수께끼 게임을 하기 위한 것만인가요?
연구팀은 추가로 난이도를 높이기로 결정했고, Memento 3을 직접 아타리 포징(Atari Pong)이라는 고전 가상 스포츠 게임에 도전하게 했다.
이전의 수수께끼 게임과는 달리, 이번에는 공이 계속 움직이고 반사됩니다. AI는 게임 규칙을 파악하는 것뿐만 아니라 실시간으로 공의 움직임 궤적을 판단하고 라켓을 조절하여 공을 받아야 합니다.
이번 실험 결과로, 정말 새로운 것들이 발견되었어요.
처음에는 AI도 공의 반발 규칙을 모르고, 플레이를 하면서 직접 찾아가야 했습니다.
그는 처음에 라켓을 네 개의 구역으로 나눌 수 있다고 생각했으며, 작은 공이 각각 다른 위치에서 타면 해당 방향으로 날아가게 될 거라고 했습니다.
결과가 움직이면서, 갑자기 수평으로 반사된 적이 있었다.
어? 이건 이전에 정리한 규칙과 맞지 않아요.
그래서 AI는 충돌 위치를 다시 분석하고 반사 공식을 수정했으며, 새로운 궤적 편차도 발생하자 계속 조정을 진행하여 실제 상황에 더 적합한 운동 법칙을 점차적으로 도출해냈습니다.
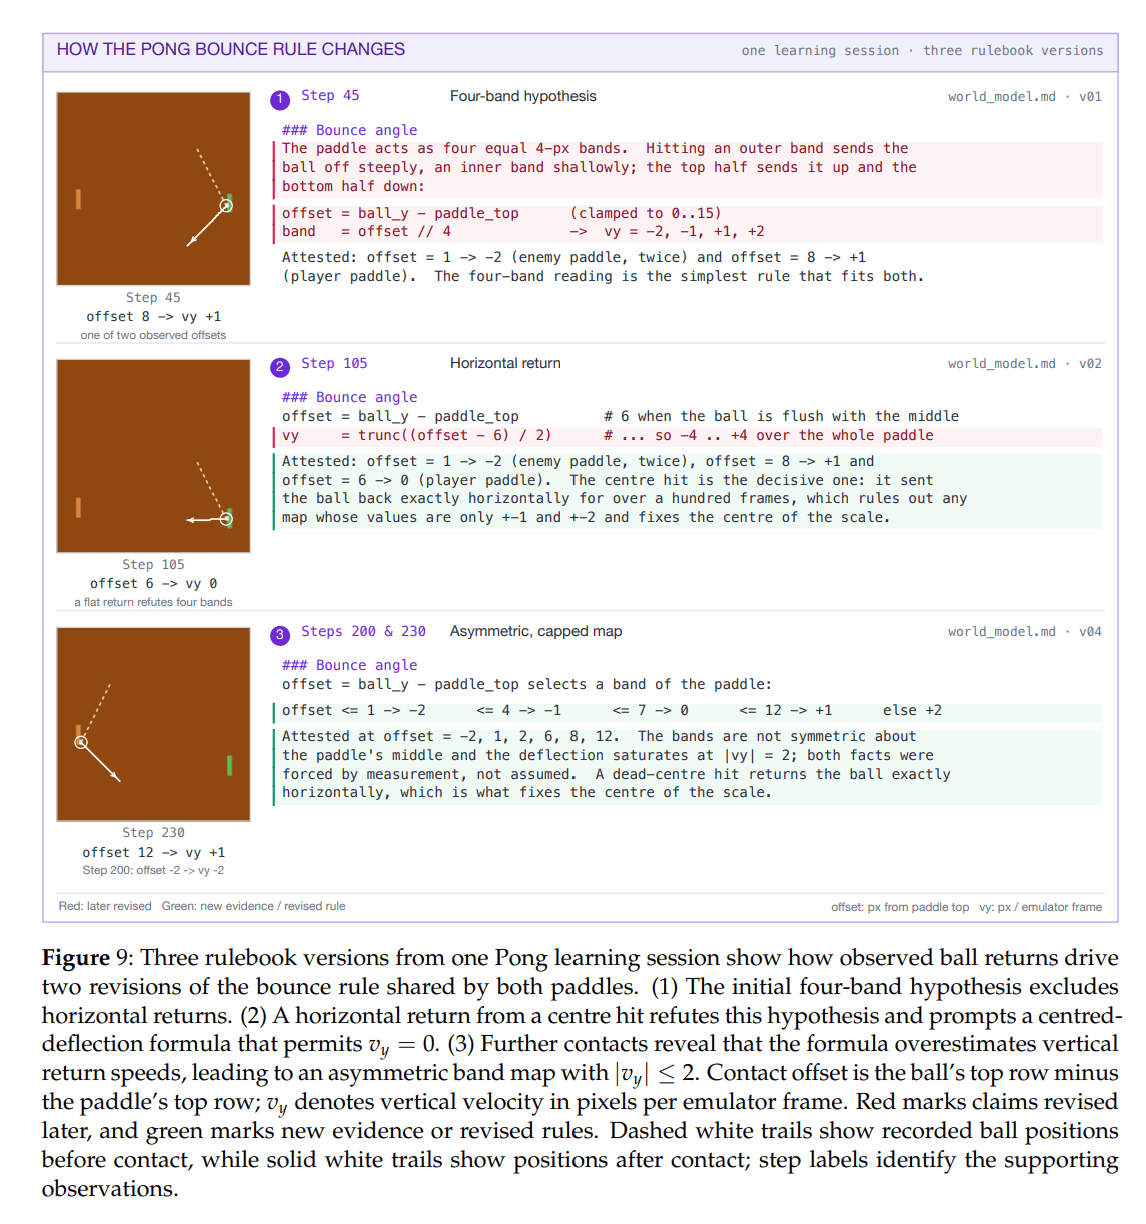
통제 전략이 성숙해지면, 연구팀은 그 프로그램을 독립적으로 사용하도록 했다.
Claude Opus 5를 더 이상 호출하지 않으며, 규칙도 더 이상 업데이트하지 않습니다.
결과적으로, 세 가지 다른 시작 방식 모두에서 21:0으로 승리했습니다.
세상에, 앞에서는 어떻게 공을 받아야 하는지도 모르고 있었는데, 뒤에서는 상대를 완전히 막아버렸네??
그리고 주의하세요, 이 시점에서는 대형 모델이 직접 참여할 필요가 없습니다.
그것은 초기 단계에서 규칙을 탐색하고 플레이 방식을 정리하는 역할만을 담당하며, 전략을 익힌 후에는 바로 코드에 의해 실행된다.
비교를 위해, 세계 모델을 사용하지 않고 대형 모델이 현재 보이는 이미지를 기반으로 다음 조작을 결정하도록 하는 경우, 최종 점수는 -19에 불과하며, 무작위로 누르는 -20.7과 큰 차이가 없습니다.
이러한 비교에서 차이가 드러난다.
대형 모델이 매 단계마다 다시 생각하는 것을 허용하기보다는, 먼저 어떻게 플레이하는지 배우게 하고 나서 플레이 방식을 프로그램에 맡기는 것이 낫다.
또한 효율성도 꽤 대단합니다.
논문 데이터에 따르면, Memento 3은 9500프레임 게임 화면만을 사용하여 이런 제어 전략을 배웠습니다.
반면에 일부 전통적인 강화 학습 방법은 수십만 또는 수억 개의 프레임 훈련 데이터가 필요합니다.
물론, 이는 Memento 3에 비용이 없다는 것을 의미하지 않습니다.
결국, 그 뒤에는 Extra-High 추론 강도를 활성화하는 Claude Opus 5가 사용되며, 탐색, 코드 생성 및 검증 과정에서는 많은 Token과 연산력이 필요합니다.
또한 현재 실험은 규칙이 비교적 명확한 게임 환경을 대상으로 하고 있습니다. 더 복잡하고 변동성이 큰 현실 세계로 바뀌면 이 방법이 여전히 효과가 있을지 아직 검증이 필요합니다.
하지만 이 연구는 주목할 만한 방향을 제시하고 있습니다:
재규격 자기 개선(RSI)은 모델의 기본적인 가중치를 변경할 필요가 없습니다. 검증 가능하고 실행 가능하며 되돌릴 수 있는 외부 세계 모델을 구축함으로써, 매개변수를 고정한 일반화된 대규모 모델도 낯선 분야에서 자기 반복과 빠른 진화를 할 수 있습니다.
논문 주소: