
요청을 라우팅하거나, 에이전트 행동을 선택하거나, 정책 결과를 할당하는 애플리케이션은 자유 형식의 텍스트 대신 고정된 선택지 집합에 대한 점수가 필요한 경우가 많습니다. 이러한 의사결정 모델을 배포할 때 llama.cpp on Amazon SageMaker AI CPU 또는 GPU 인프라에서 양자화된 모델을 제공하기 위한 관리형 경로를 제공합니다.
이 게시물은 생성형 AI 추론을 위한 특화된 AWS Deep Learning Containers(DLC) 시리즈를 이어가는 글입니다. 이전 게시물에서는 WhisperX, vLLM-Omni – 1부, 그리고 vLLM-Omni – 파트 2.
이 글에서는 먼저 다음을 사용합니다. llama.cpp용 AWS DLC SageMaker AI를 통해 OpenAI 호환 채팅 완성을 제공하기 위해서입니다 InvokeEndpoint. 이어서 동일한 런타임을 다음으로 확장합니다: SemIf, 이전 명칭은 OpenJev이며, 정답 토큰을 디코딩하지 않고 선언된 선택지에 대한 확률을 반환합니다. 이와 함께 제공되는 코드 샘플 CPU 및 GPU 배포 옵션이 포함됩니다.
솔루션 개요
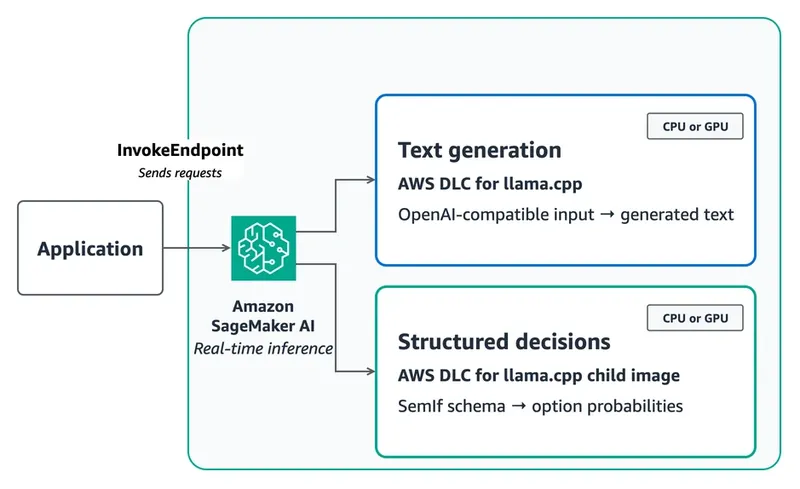
그림 1은 동일한 패키지된 모델에서 나오는 두 가지 배포 경로를 보여줍니다. 텍스트 생성 경로는 llama.cpp용 AWS DLC를 사용하며 OpenAI 호환 API를 통해 생성된 응답을 반환합니다. 구조화된 의사결정 경로는 기본 서버를 SemIf 어댑터로 교체하는 자식 이미지를 빌드하고, 선언된 선택지에 대한 확률을 반환합니다.
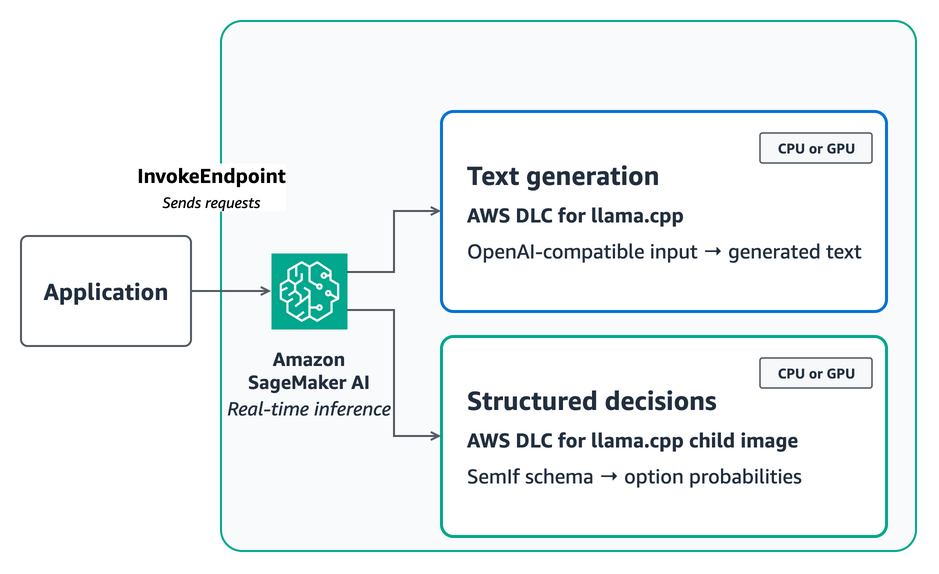
Figure 1: 워크로드의 API 및 지연 시간 요구 사항에 따라 CPU 또는 GPU에서 llama.cpp용 AWS DLC 또는 SemIf 자식 이미지를 실행합니다
표준 경로의 경우, 모델을 다음과 같이 패키징합니다 model.tar.gz 안에 Amazon Simple Storage Service (Amazon S3) 그리고 게시된 DLC 이미지를 직접 참조합니다. 컨테이너는 첫 번째 .gguf 아래의 파일을 찾은 뒤, /opt/ml/model을(를) POST /invocations (으)로 매핑하며, 위치는 llama-server 입니다. /v1/chat/completions, 그리고 통과하며 SM_LLAMA_CPP_* 환경 변수를 llama.cpp 인수로 변환합니다.
그 llama-server HTTP API는 SemIf가 사용하는 최종 위치 로짓과 상태 연산을 노출하지 않습니다. 따라서 구조화된 의사결정 경로는 다음을 사용합니다 AWS CodeBuild child 이미지를 빌드하여 저장하려면 Amazon Elastic Container Registry (Amazon ECR). 자식 이미지는 DLC의 컴파일된 CPU 또는 CUDA 라이브러리를 유지하면서 진입점을 SageMaker 호환 어댑터로 교체합니다.
입력 및 출력 스키마 이해하기
llama.cpp용 AWS DLC는 OpenAI Chat Completions 스키마를 허용합니다. messages 배열과 role 그리고 content, 그리고 다음과 같은 생성 컨트롤이 추가되었습니다: max_tokens 그리고 stream:
{
  "messages": [
    {
      "role": "user",
      "content": "A customer cannot receive a password reset email. Reply with the best support queue."
    }
  ],
  "max_tokens": 64,
  "stream": false
}
이 응답은 OpenAI 호환 형식을 사용합니다 choices 배열. 생성된 텍스트를 다음에서 읽습니다 choices[0].message.content.
SemIf는 채팅 메시지 대신 제약된 의사결정 스키마를 사용합니다. 요청에는 호출자가 정의한 ID, 비정형 상태, 질문, 그리고 허용된 옵션들의 순서 있는 목록이 포함됩니다:
{
  "decision": {
    "id": "support-route",
    "state": "The customer cannot receive a password reset email.",
    "question": "Which queue should handle this request?",
    "options": [
      {"id": "account_access", "description": "Account access support."},
      {"id": "billing", "description": "Billing support."}
    ]
  }
}
응답은 다음을 반환합니다 option_ids, probabilities, 그리고 raw option_logits 동일한 순서로, 프롬프트, 타이밍 및 고정된 모델 메타데이터와 함께 제공됩니다. 안정적인 옵션 ID가 있으면 애플리케이션은 생성된 산문을 파싱하지 않고도 임계값, 폴백 및 정책 검사를 적용할 수 있습니다.
SemIf는 비정형 상태에서 애플리케이션이 정의한 결과에 점수를 매기는 더 넓은 부류의 의사결정 모델에 속합니다. 다른 구현으로는 Jev, TypeSafe의 의사결정 모델 및 /v1/systemone API; Kev, TypeSafe API 호환성을 위해 설계된 모델 서버; 그리고 Strands Decider 2B, 보정된 출력을 갖춘 에이전트 워크플로우 전용 모델이 있습니다.
올바른 의사결정 워크플로우 선택하기
애플리케이션이 요청 시점에 허용되는 선택지를 정의하고 모델이 비정형 컨텍스트를 해석하도록 해야 할 때 이 패턴을 사용하십시오. 예로는 케이스를 큐로 라우팅하거나, 알려진 집합에서 하나의 값을 추출하거나, 인시던트 우선순위를 지정하거나, 정책 결과를 확인하거나, 에이전트 행동을 선택하는 것이 있습니다. 권한 부여와 결정론적 비즈니스 규칙은 모델 외부에 두고, 모델 확률을 운영상의 신뢰도로 취급하기 전에 검증하십시오.
을(를) 통한 OpenAI 호환 채팅 완성이 필요할 때는 표준 SageMaker AI 텍스트 생성 경로를 사용하십시오. InvokeEndpointSageMaker AI 이미지는 POST /invocations 을(를) llama-server /v1/chat/completions 엔드포인트에 매핑합니다. SemIf의 직접적인 logits 및 상태 접근 같이 이 인터페이스가 제공하지 않는 동작이 애플리케이션에 필요한 경우에만 자식 이미지를 빌드하십시오.
정답 토큰 생성을 제거해도 모델 추론이 제거되는 것은 아닙니다. SemIf가 최종 logits을 읽기 전에 모델은 여전히 전체 상태, 질문, 선택지 설명을 처리합니다. 프롬프트를 간결하게 유지하고, 프로덕션 사용 전에 애플리케이션의 레이블이 지정된 결정들로 선택한 모델을 평가하십시오.
지연 시간 및 품질 목표에 맞게 튜닝
다음 벤치마크는 텍스트 생성 엔드포인트가 아닌 SemIf 확장에 적용됩니다. 모델 크기, 양자화, 프롬프트 길이, 런타임, CPU 스레드 수가 각 결정에 영향을 줍니다. 이러한 트레이드오프를 정량화하기 위해, 우리는 동일한 231개의 공개 JevBench 작업을 하나의 CPU 엔드포인트와 하나의 GPU 엔드포인트에 순차적으로 전송했습니다.
| 구성 | AWS DLC for llama.cpp | 유효 응답 | 정확도 | 클라이언트 p50 | 클라이언트 p95 |
Qwen3.5-4B Q4_K_M, ml.c6i.8xlarge, 32 스레드 |
llama-cpp:server-sagemaker-cpu-v1 | 231/231 | 179/231 (77.5%) | 1.715초 | 19.291초 |
Qwen3.5-4B Q4_K_M, ml.g6e.xlarge, 풀 GPU 오프로드 |
llama-cpp:server-sagemaker-cuda-v1 | 231/231 | 180/231 (77.9%) | 0.352초 | 0.599초 |
CPU 구성과 비교하여 GPU 엔드포인트는 p50에서 4.9배, p95에서 32.2배 빨랐습니다. 이 샘플은 SageMaker AI 인스턴스 풀 기능을 사용하여 호환되는 GPU 인스턴스 유형을 우선순위 순으로 나열하므로, 첫 번째 선호 항목을 사용할 수 없을 때 SageMaker가 대안을 선택할 수 있습니다. 풀은 g6e, g6, g5을(를) 먼저, 그 다음 g4dn을(를) 순서대로 지정했습니다. SageMaker는 ml.g6e.xlarge을(를) 선택했으며, 시작 로그에서 llama.cpp가 34개 모델 레이어 전체를 NVIDIA L40S로 오프로드했음이 확인되었습니다. CPU 및 GPU 이미지는 서로 다른 llama.cpp 빌드를 사용했으며 6개의 어려운 작업에서 서로 다른 예측을 생성했습니다. 단일 정답 정확도 차이는 GPU 오프로드가 모델 품질을 향상시킨다는 증거가 아니라 런타임 변동으로 취급하십시오.
더 작은 모델은 중앙값 지연 시간을 줄였지만, 2B 및 0.8B 후보는 각각 66.7%와 58.4%의 정확도를 달성했습니다. 따라서 이 샘플은 품질 우선 기본값으로 4B Q4_K_M 모델을 유지합니다. 이러한 측정값에는 네트워크 지연이 포함되며 서비스 보장이 아닙니다.
전체 모델 및 인프라 구성을 사용자 자신의 결정에 대해 벤치마크하십시오. 지연 시간에 민감하지 않고 수 초의 응답 시간을 허용할 수 있는 백그라운드, 오프라인 또는 낮은 처리량 워크로드에는 CPU를 사용하십시오. 대화형 결정, 긴 프롬프트 또는 엄격한 꼬리 지연 목표가 있는 워크로드에는 GPU를 사용하십시오. 상태와 선택지 설명을 간결하게 유지하고, 동일한 상태를 공유하는 결정을 하나의 요청으로 그룹화하며, 동시성을 위해 엔드포인트 인스턴스를 확장하십시오. 공유 상태 점수 매기기는 공통 프롬프트 접두어를 재사용하며, 어댑터는 재시도 가능한 HTTP 503 상태를 유지하는 llama.cpp 컨텍스트 주변에 무제한 큐를 두는 대신 응답을 처리합니다.
전제 조건
필요한 것:
- 배포 AWS 리전에 AWS 계정과 S3 버킷이 필요합니다.
- Python 3.10 이상, Git, 그리고 AWS Command Line Interface(AWS CLI).
- 선택 사항인 SemIf 확장을 위한 용도별 CodeBuild 서비스 역할입니다.
- 하나의 AWS Identity and Access Management (IAM) SageMaker AI가 맡을 수 있는 역할입니다.
- SageMaker AI, Amazon ECR, Amazon S3, CodeBuild, IAM pass-role 작업, 그리고 Amazon CloudWatch Logs.
- 호환되는 x86 CPU 또는 NVIDIA GPU SageMaker 실시간 엔드포인트에 대한 할당량.
텍스트 생성 예제는 CPU DLC와 고정된 CPU 인스턴스를 사용합니다. SemIf 확장은 레이턴시에 민감하지 않은 워크로드에 대해 CPU를 기본값으로 유지하며, 순서가 지정된 인스턴스 풀과 함께 선택적 CUDA 이미지를 제공합니다. Review SageMaker AI 요금 엔드포인트를 생성하기 전에.
의사결정 모델을 배포하고 SemIf로 확장하기
다음 절차에 따라 표준 텍스트 생성 엔드포인트를 배포한 다음, CPU 또는 GPU에서 구조화된 결정을 위한 선택적 SemIf 확장 기능을 빌드합니다.
- 코드 샘플을 복제하고 의존성을 설치합니다.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git cd sagemaker-genai-hosting-examples/03-features/semif-decision-model python3 -m venv .venv . .venv/bin/activate python3 -m pip install -r deploy/requirements.txt - 계정에 맞는 배포 값을 설정합니다.
export AWS_REGION="<your-region>" export ARTIFACT_BUCKET=amzn-s3-demo-semif-artifacts export CODEBUILD_ROLE_ARN=arn:aws:iam::111122223333:role/semif-codebuild-role export SAGEMAKER_ROLE_ARN=arn:aws:iam::111122223333:role/semif-sagemaker-role export STANDARD_ENDPOINT_NAME=llamacpp-gguf export SEMIF_ENDPOINT_NAME=semif-decision-workflows - 고정된(pinned) GGUF 모델과 토크나이저를 CodeBuild로 패키징합니다.
python deploy/prepare_model_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN" \
  --model-s3-uri "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz"
반환된 빌드 ID가
SUCCEEDED상태에 도달할 때까지 기다립니다. 빌드는 소스 개정 버전과 체크섬을model-manifest.json에 기록하며, GGUF 체크섬이 검증된 값과 다르면 중단됩니다. - llama.cpp용 AWS DLC로 GGUF 모델을 배포합니다.
다이제스트로 고정된
server-sagemaker-cpu-v1이미지를 AWS DLC for llama.cpp 문서에서 확인한 다음, SageMaker AI 모델, 엔드포인트 구성, 엔드포인트를 생성합니다:export STANDARD_IMAGE_URI="<published-llama-cpp-cpu-image>@sha256:<digest>" python deploy/deploy_standard_endpoint.py \ --region "$AWS_REGION" \ --image-uri "$STANDARD_IMAGE_URI" \ --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \ --role-arn "$SAGEMAKER_ROLE_ARN" \ --instance-type ml.c6i.2xlarge \ --name "$STANDARD_ENDPOINT_NAME"해당하는 EC2 이미지가 아닌
server-sagemaker-cpu-v1또는server-sagemaker-cuda-v1해당 EC2 이미지가 아니라 이 이미지를 사용하십시오. SageMaker AI 이미지는 2를 구현합니다./ping및/invocations컨테이너 계약을 구현하고 호출 페이로드를 채팅 완성(chat completions)으로 매핑합니다.이 실습에서는 Amazon S3의 SageMaker AI 모델 아티팩트를 통해 GGUF 모델을 제공합니다. 대안으로, 엔드포인트에 네트워크 이그레스가 있는 경우
SM_LLAMA_CPP_HF_REPO과SM_LLAMA_CPP_HF_FILE를 구성하여 Hugging Face에서 GGUF 파일을 다운로드할 수 있습니다.이 경로에서는 Dockerfile이나 ECR 리포지토리가 필요하지 않습니다. 엔드포인트가
InService상태에 들어갈 때까지 기다린 다음, OpenAI 호환 채팅 요청을 보내십시오:python deploy/invoke_standard_endpoint.py \ --region "$AWS_REGION" \ --endpoint-name "$STANDARD_ENDPOINT_NAME" - 선택 사항인 SemIf 자식 이미지를 빌드하고 변경 불가능한 다이제스트를 확인합니다.
CPU의 경우:
python deploy/prepare_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN"
GPU의 경우 대신 CUDA 자식 이미지를 빌드합니다:
python deploy/prepare_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN" \
  --dockerfile Dockerfile.gpu \
  --image-tag "gpu-$(date +%Y%m%d%H%M%S)"
빌드가 성공하면 변경 불가능한 이미지 URI를 구성합니다:
ECR_REPOSITORY_URI=$(aws ecr describe-repositories \
  --region "$AWS_REGION" \
  --repository-names semif-llamacpp-dlc \
  --query 'repositories[0].repositoryUri' \
  --output text)
IMAGE_DIGEST=$(aws ecr describe-images \
  --region "$AWS_REGION" \
  --repository-name semif-llamacpp-dlc \
  --query 'sort_by(imageDetails,&imagePushedAt)[-1].imageDigest' \
  --output text)
export IMAGE_URI="${ECR_REPOSITORY_URI}@${IMAGE_DIGEST}"
배포 스크립트는 가변적인 이미지 태그를 거부합니다.
- SemIf 엔드포인트를 배포합니다.
CPU 구성은 고정된 인스턴스 유형을 사용합니다:
python deploy/deploy_endpoint.py \
  --region "$AWS_REGION" \
  --image-uri "$IMAGE_URI" \
  --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \
  --role-arn "$SAGEMAKER_ROLE_ARN" \
  --instance-type ml.c6i.8xlarge \
  --threads 32 \
  --name "$SEMIF_ENDPOINT_NAME"
반환된 엔드포인트 이름이
InService상태에 들어갈 때까지 기다립니다. 이 경로는n_gpu_layers=0으로 설정합니다. 어댑터는 하나의 상태 유지 llama.cpp 컨텍스트를 중심으로 스코어링을 직렬화하므로, 하나의 컨테이너 내부에서 병렬 스코어링을 가정하기보다는 워크로드를 측정한 후 엔드포인트 인스턴스로 스케일 아웃하십시오.GPU 이미지의 경우 순서가 지정된 인스턴스 풀을 제공하고 전체 모델 오프로드를 요청하십시오:
python deploy/deploy_endpoint.py \
  --region "$AWS_REGION" \
  --image-uri "$IMAGE_URI" \
  --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \
  --role-arn "$SAGEMAKER_ROLE_ARN" \
  --instance-pool ml.g6e.xlarge \
  --instance-pool ml.g6.2xlarge \
  --instance-pool ml.g5.2xlarge \
  --instance-pool ml.g4dn.2xlarge \
  --gpu-layers=-1 \
  --provision-timeout 1200 \
  --name "$SEMIF_ENDPOINT_NAME"
인스턴스 풀은 순서가 지정된 배치 폴백(fallback)이지 추론 로드 밸런싱이 아닙니다. SageMaker는 변형(variant)에 대해 사용 가능한 유형 하나를 선택합니다. SageMaker AI가 풀을 처리하는 동안 엔드포인트 생성이 더 오래 걸릴 수 있습니다. 시작 로그에서 선택된 GPU와 모든 모델 레이어가 오프로드되었음을 확인하는 메시지를 확인하십시오.
- 예제 결정으로 SemIf 엔드포인트를 호출합니다.
요청은 허용된 각 옵션에 대한 안정적인 ID를 선언합니다:
{
  "decision": {
    "id": "support-route",
    "state": "Customer asks to reset a forgotten password and says the reset email never arrived.",
    "question": "Which queue should handle this request?",
    "options": [
      {"id": "account_access", "description": "Account access and authentication support."},
      {"id": "billing", "description": "Billing and payment support."},
      {"id": "sales", "description": "Sales and product evaluation."}
    ]
  }
}
python deploy/invoke_endpoint.py \ --region "$AWS_REGION" \ --endpoint-name "$SEMIF_ENDPOINT_NAME"응답은 옵션 순서를 유지하며 조건부 확률, 원시 로짓(logits), 토큰 및 프롬프트 메타데이터, 고정된 모델 식별 정보를 포함합니다:
{
  "result": {
    "id": "support-route",
    "option_ids": ["account_access", "billing", "sales"],
    "probabilities": [0.99996, 0.00003, 0.00001],
    "option_logits": [28.47, 17.92, 17.04],
    "prompt_sha256": "016267542103ab91422c425d2234ec7e1b9aef77f9d3e481b96db2de7cca470a",
    "readout": "quantized last-position logits restricted to declared answer slots; no generated tokens"
  }
}
애플리케이션 수준의 임계값과 폴백을 적용하십시오. 모델 결정을 권한 부여의 대체 수단으로 사용하지 마십시오.
정리
SageMaker AI 엔드포인트, 엔드포인트 구성 및 모델을 삭제합니다:
python deploy/cleanup_endpoint.py \
  --region "$AWS_REGION" \
  --name "$STANDARD_ENDPOINT_NAME"

python deploy/cleanup_endpoint.py \
  --region "$AWS_REGION" \
  --name "$SEMIF_ENDPOINT_NAME"
스크립트는 명시적으로 이름이 지정된 SageMaker AI 리소스만 삭제합니다. CodeBuild 프로젝트, ECR 리포지토리, Amazon S3의 모델 및 소스 객체, 로그, 특정 용도의 IAM 역할은 더 이상 필요하지 않을 때 삭제하십시오.
결론
llama.cpp용 AWS DLC는 CPU 및 GPU 인스턴스 전반에서 SageMaker AI에서 결정 모델을 제공하기 위한 관리형 기반을 제공합니다. SageMaker AI 모델 아티팩트 또는 구성된 Hugging Face 리포지토리에서 GGUF 모델을 로드한 다음, 사용자 지정 컨테이너 없이도 다음을 통해 OpenAI 호환 채팅 완성(completions)을 제공할 수 있습니다: InvokeEndpoint 애플리케이션에 직접적인 로짓과 모델 상태 작업이 필요한 경우, DLC를 SemIf 어댑터로 확장할 수 있습니다. 지연 시간에 민감하지 않은 워크로드에는 CPU를 선택하고, 프롬프트 프리필(prefill)과 꼬리 지연 시간이 애플리케이션 경험에 영향을 미치는 경우에는 GPU를 선택하십시오.
다음을 검토하십시오: 코드 샘플, AWS DLC for llama.cpp 문서및 SageMaker AI 사용자 지정 추론 컨테이너 계약 을 참조하여 워크로드에 맞게 배포를 조정하십시오.