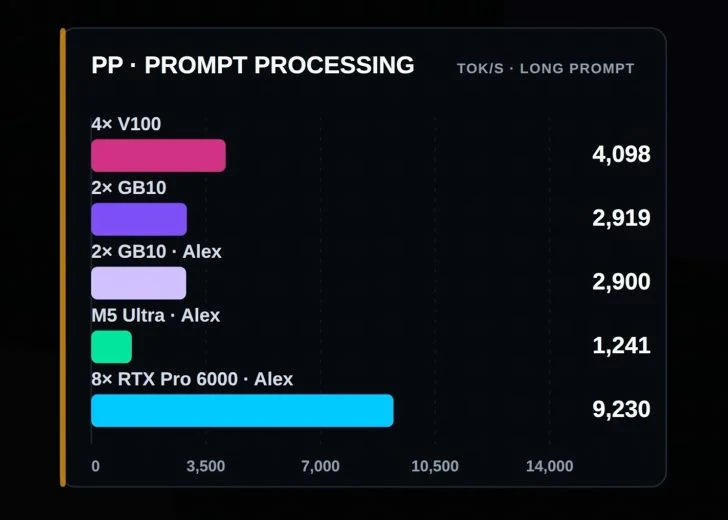
IT之家 10월 13일 소식에 따르면, YouTube 채널 Jun Yamog은 어제(10월 12일) Tesla V100 4대를 NVLink 카드 위에 설치하여 테스트한 영상을 게시했습니다. Qwen3.8-Flash-Next 기준에서 긴 프롬프트 처리 속도는 M5 Ultra보다 230%, 2대의 DGX Spark보다 40% 더 빠릅니다.
IT之家에서 공개된 자료에 따르면, Tesla V100은 인텔이 2017년에 출시한 데이터센터 GPU로, Volta 아키텍처를 기반으로 하며 AI 학습 및 추론에 널리 사용됩니다. 32GB 버전에는 HBM2 메모리가 장착되어 있으며, 900GB/s의 메모리 대역폭을 통해 대규모 모델 파라미터와 데이터의 빠른 읽기가 가능합니다.
NVLink는 NVIDIA의 GPU 고속 상호 연결 기술로, 여러 GPU 간에 데이터를 직접 전송하는 데 사용됩니다. PCIe 통신보다 NVLink를 사용하면 상호 연결의 병목 현상을 줄일 수 있으며, 다중 GPU 서버와 AI 계산 클러스터에서 자주 활용됩니다.
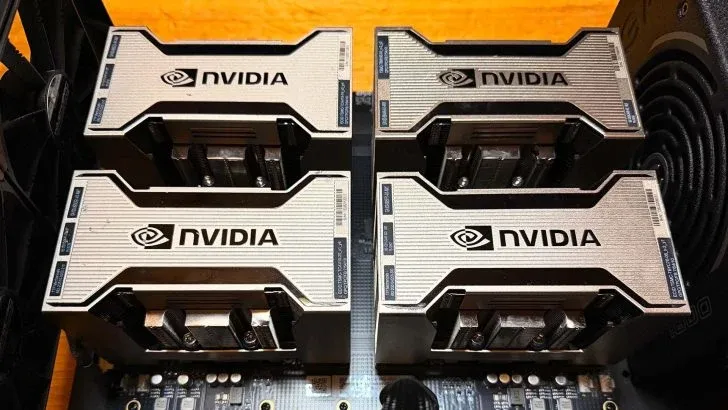
이 NVLink 카드에는 300GB/s의 대역폭이 제공되며, 6개의 NVLink 2.0 연결이 장착되어 있습니다. 4개의 독립형 GPU를 수용하기 위해 테스터는 NVIDIA A100 쿨러를 개조하여 각 V100에 약 300W의 전력 소모를 발생시키게 하고, PCIe x8 인터페이스를 통해 카드와 연결했습니다.
이 방송인은 4비트 양화된 Qwen3.8-Flash-Next 모델을 사용하여 테스트했으며, 비교 대상으로는 128GB LPDDR5X 통합 메모리를 갖춘 DGX Spark 2대와 M5 Ultra 칩을 탑재한 Mac Studio 장비가 포함됩니다.
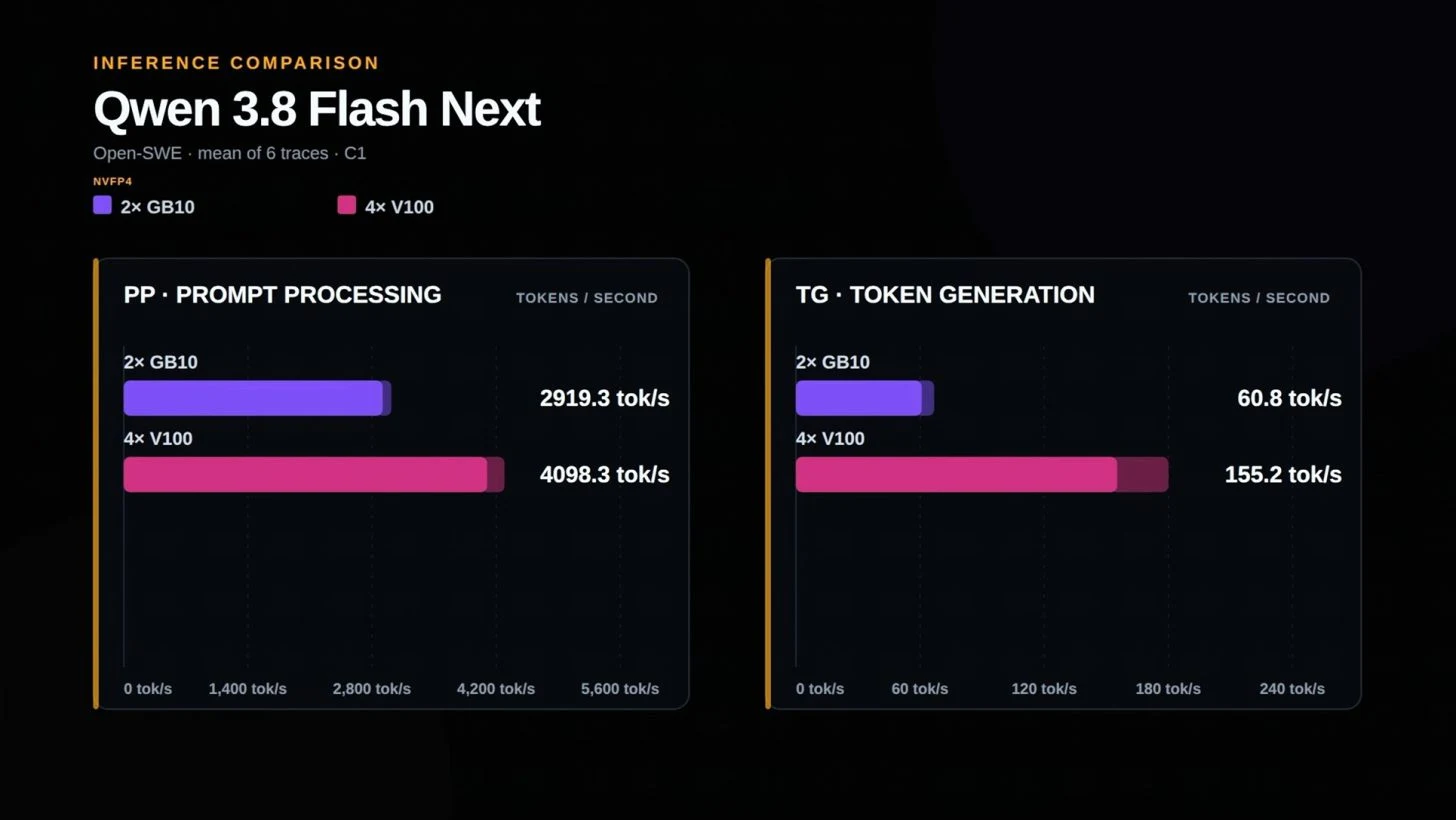
긴 프롬프트 처리 테스트에서, 4개의 V100은 DGX Spark 클러스터보다 40%, M5 Ultra보다 230% 더 빠릅니다. 테스터들은 Apple Silicon과의 큰 차이가 부분적으로 소프트웨어 최적화가 부족하기 때문일 수 있다고 지적했습니다.
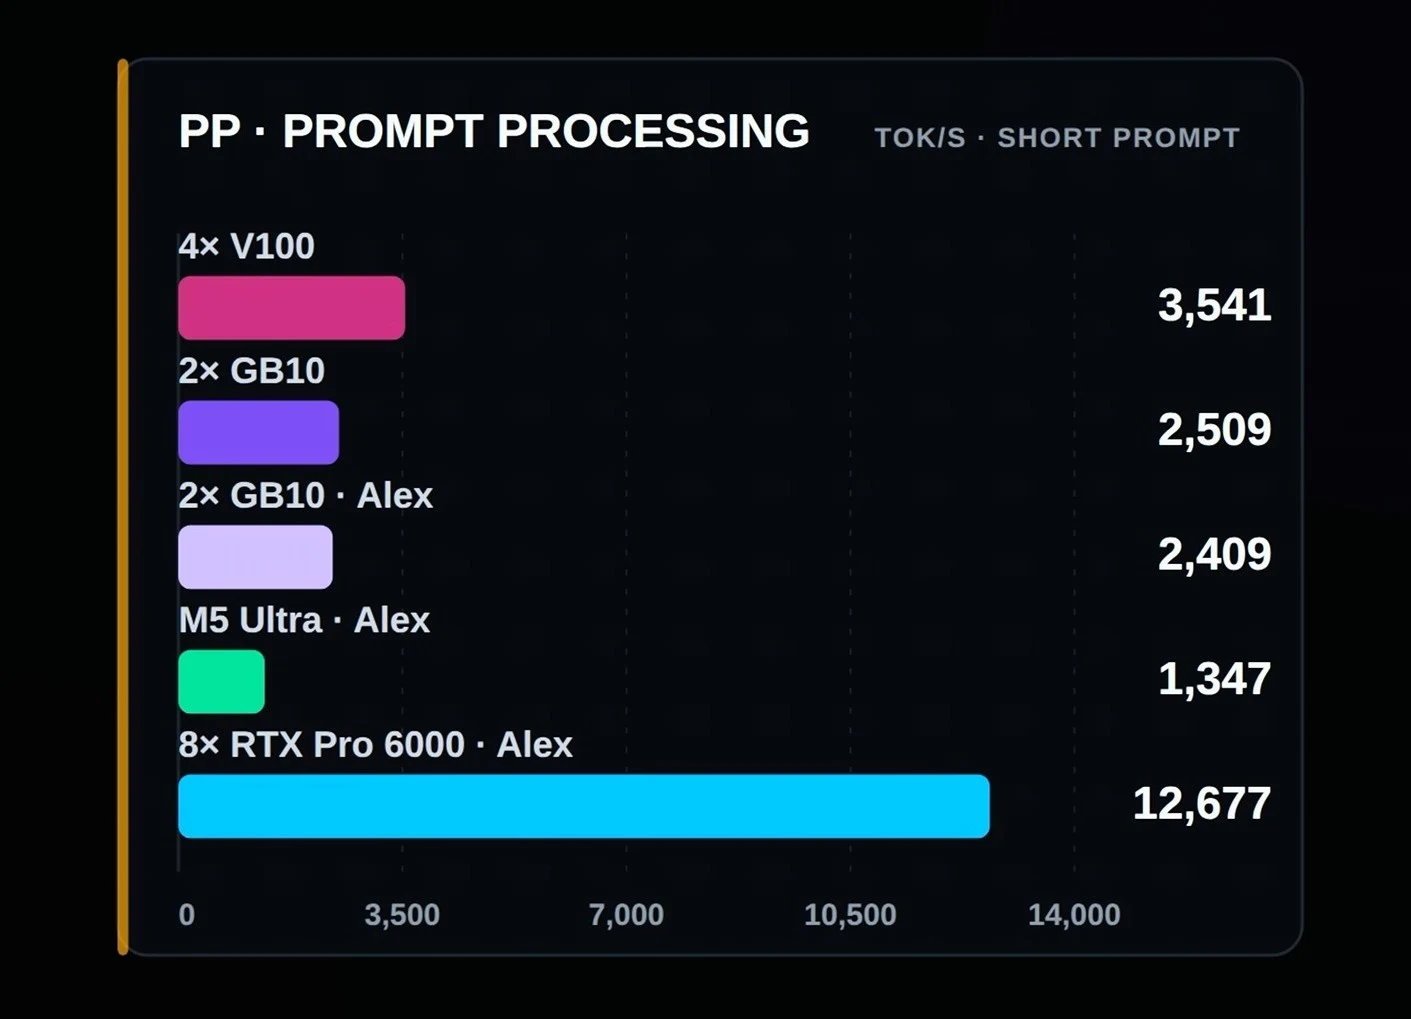
단기 피드백 처리 테스트에서 V100 클러스터는 DGX Spark보다 40% 더 빠른 속도를 보였으며, M5 Ultra보다 163% 더 빠릅니다. 이 결과는 구형 데이터 센터 GPU가 특정 추론 부하에서 여전히 높은 처리 능력을 갖고 있음을 보여줍니다.
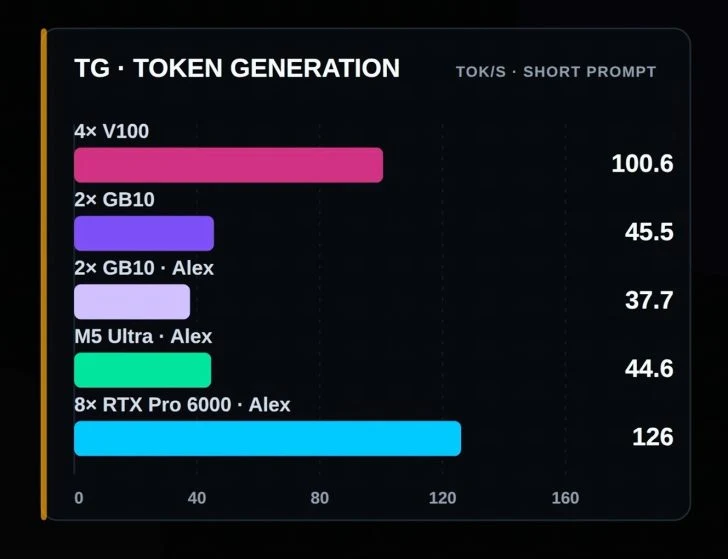
단기 툴팁 토큰 생성 테스트에서 4개의 V100은 100.6 토큰/초를 기록했으며, 2대의 DGX Spark보다 121% 빠릅니다; M5 Ultra의 성능은 44.5 토큰/초입니다.