
핵심 요약
- 장기 실행 에이전트를 구축하려면 지속적인 컨텍스트 관리가 필요한데, 이러한 결정을 프론티어 LLM으로 내리는 것은 느리고 비용이 많이 듭니다. ScaleDown의 제약 디코딩 모델(CDM)은 이를 더 빠르고 저렴하게 만들어 줍니다.
langchain-scaledown을 사용하면 에이전트에서 ScaleDown 모델을 쉽게 사용할 수 있으며, 요약, 도구 결과 압축, 추출을 위한 미들웨어가 함께 제공됩니다.- ScaleDown은 이제 LangSmith LLM Gateway에서 지원되므로, 호출이 추적되고 귀하의 지출 및 속도 제한에 반영됩니다.
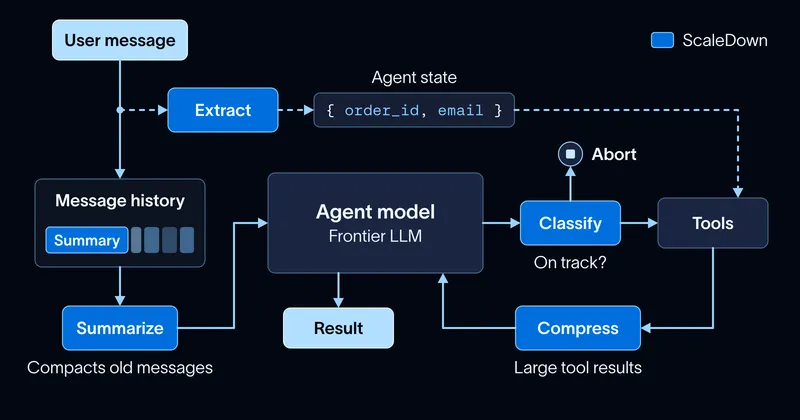
장기 실행 에이전트 구축은 궁극적으로 컨텍스트 관리의 기술로 귀결됩니다. 즉, 어떤 정보를 컨텍스트 창에 넣을지, 언제 넣을지 결정하는 것입니다. 이는 오래된 기록을 요약하고, 큰 도구 결과를 압축하며, 긴 입력에서 올바른 데이터를 추출하는 것을 의미합니다. 이러한 각 단계는 하나의 결정입니다. 지금까지 우리는 이를 LLM으로 처리해 왔지만, 장기 실행 에이전트에 필요한 처리량에서는 느리고 비용이 많이 들었습니다.
이러한 결정을 더 빠르고 저렴하게 만들기 위해, 이제 우리는 langchain-scaledown 통합과 LangSmith LLM Gateway 지원 을 통해 ScaleDown의 제약 디코딩 모델(CDM)을 제공합니다. 범용 LLM이 한 번에 한 토큰씩 임의의 문자열을 작성하는 반면, CDM은 하나의 작업을 위해 훈련되어 해당 작업이 허용하는 답변만 반환합니다. 예를 들어 목록에 있는 레이블이나 입력의 구간 같은 것입니다. 덕분에 훨씬 더 작고, 빠르고, 저렴할 수 있습니다. ScaleDown에 따르면 이러한 좁은 작업에서 자사 모델은 프론티어 모델보다 200배 빠르고 467배 저렴합니다.
이 통합은 LangChain 과 Deep Agents 를 위한 세 가지 미들웨어와 함께 제공됩니다. 하나는 오래된 기록을 요약하고, 하나는 큰 도구 결과를 압축하며, 하나는 대화에서 구조화된 데이터를 추출합니다. 이 글에서는 ScaleDown의 모델이 무엇인지, 그리고 이를 사용하여 에이전트의 컨텍스트를 scale down 하는 방법을 다룹니다.
ScaleDown은 어떤 모델을 제공하나요?
ScaleDown에는 네 가지 모델이 있으며, 각각 단일 작업을 위해 훈련되어 범용 LLM보다 훨씬 더 효율적일 수 있습니다:
- Summarize 는 긴 텍스트의 짧은 요약을 작성합니다.
- Compress 는 컨텍스트 블록을 질문과 관련된 부분으로 줄입니다.
- Extract 는 텍스트에서 설명된 필드를 추출하며, 각 필드에는 신뢰도 점수와 원본 내 위치가 함께 제공됩니다.
- Classify 정의한 레이블을 기준으로 텍스트를 채점하고 각 레이블에 대한 확률을 반환합니다. 분류가 이루어진 이유를 자연어 설명으로 반환할지 여부도 결정할 수 있습니다.
모든 모델은 최대 1M 토큰 입력 토큰 기준이므로, 전체 계약서, 긴 정책 페이지, 또는 1시간 분량의 에이전트 기록도 청크 분할 없이 한 번의 호출로 처리할 수 있습니다. 또한 이 모델들은 멀티모달: Extract, Summarize 및 Classify는 비정형 텍스트 외에 이미지와 스캔한 PDF를 직접 입력으로 받을 수 있으므로, 스크린샷이나 스캔한 송장도 입력으로 사용할 수 있습니다.
On ScaleDown의 자체 벤치마크에서, GPT-5.5, GPT-5.4 Mini, GPT-5.4 Nano의 평균과 비교하여 공개 데이터셋에서 측정한 결과, Summarize는 41배 저렴하고 2.7배 빠르며, Compress는 138배 저렴하고 1.8배 빠르면서도 두 경우 모두 정확도 점수가 더 높습니다.
결정 모델을 사용해 본 적이 있다면, 예를 들어 Jev와 같은 모델을 사용해 봤다면 ScaleDown Classify가 익숙하게 느껴질 것입니다. 둘 다 확률과 함께 타입화된 답변을 반환합니다. Jev는 질문당 상태당 최대 32K 토큰의 텍스트만 입력으로 받습니다. Classify는 이미지를 포함해 최대 1M 토큰까지 받으며, 각 결정에 한 문장의 이유를 추가 합니다. 에이전트가 레이블을 기반으로 티켓을 라우팅하거나 실행을 중단할 때, 그 이유가 이유를 알려주므로 에이전트를 더 쉽게 디버깅할 수 있습니다.
요약하기 메시지 기록
장시간 실행되는 에이전트는 기록이 결국 컨텍스트 창을 초과하게 되므로 요약이 필요합니다. 한 시간 동안 작업해 온 코딩 에이전트의 기록에는 수십 개의 파일 읽기와 도구 출력이 담겨 있으며, 대부분은 더 이상 그대로 필요하지 않습니다. 기록이 가득 찰 때마다 다른 프론티어 모델 호출로 이를 요약하면 비용과 지연 시간이 매번 추가됩니다.
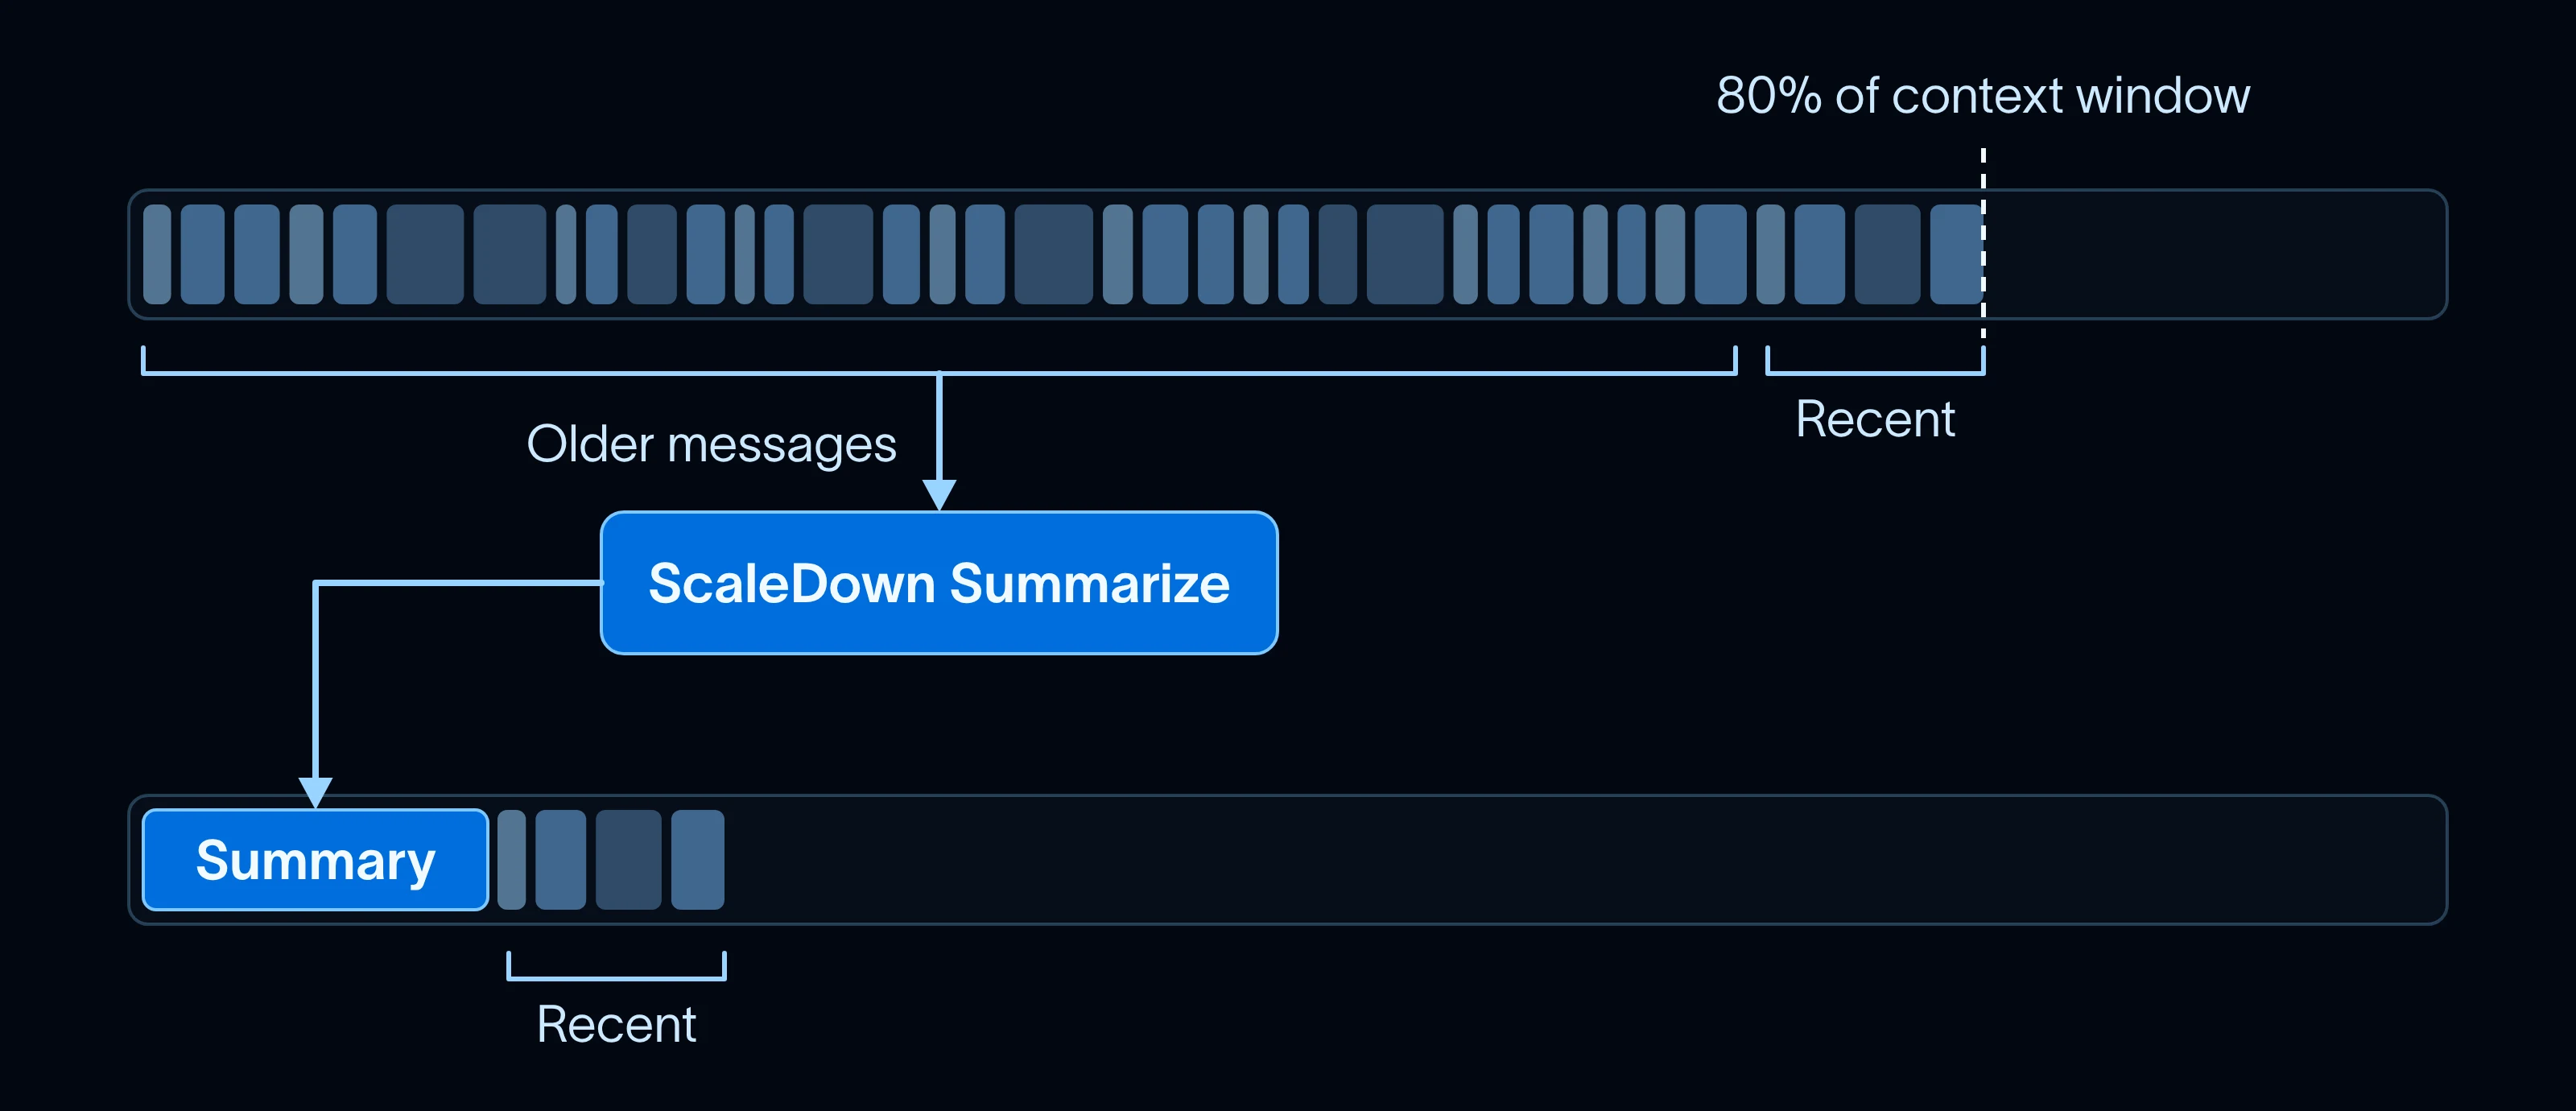
ScaledownSummarizationMiddleware는 Deep Agents의 내장 요약 미들웨어를 대체합니다. 동일한 trigger 과 keep 옵션을 받아 언제 요약할지와 최근 메시지 중 무엇을 유지할지 결정하며, 요약 작성은 ScaleDown이 수행합니다:
from deepagents import create_deep_agent
from langchain_scaledown import ScaledownSummarizationMiddleware

agent = create_deep_agent(
    model="openai:gpt-6-sol",
    tools=[run_tests],
    middleware=[
        ScaledownSummarizationMiddleware(
            "openai:gpt-6-sol",  # the agent’s model, used for its context window
            trigger=("fraction", 0.8),
            keep=("fraction", 0.1),
        ),
    ],
)
에이전트는 계획 수립과 코드 작성을 위해 자체 모델을 유지합니다. 요약만 ScaleDown으로 이동하며, ScaleDown은 기본적으로 LangChain의 요약 프롬프트와 동일한 섹션(intent, summary, artifacts, next steps)을 반환합니다. ScaleDown 호출이 실패하면 미들웨어는 히스토리를 그대로 두고 에이전트는 계속 실행됩니다. 동일한 미들웨어는 LangChain의 create_agent.
압축 도구 결과
장시간 실행되는 에이전트는 많은 도구를 호출하며, 모든 큰 결과는 실행이 끝날 때까지 컨텍스트에 남습니다. 에이전트가 한 단락만 필요로 하는 경우에도 가져온 웹 페이지는 수만 자에 이를 수 있습니다. 이후의 모든 단계는 그 토큰 비용을 다시 지불하고, 컨텍스트 가 채워질수록 에이전트는 작업에 집중하는 능력이 떨어집니다.
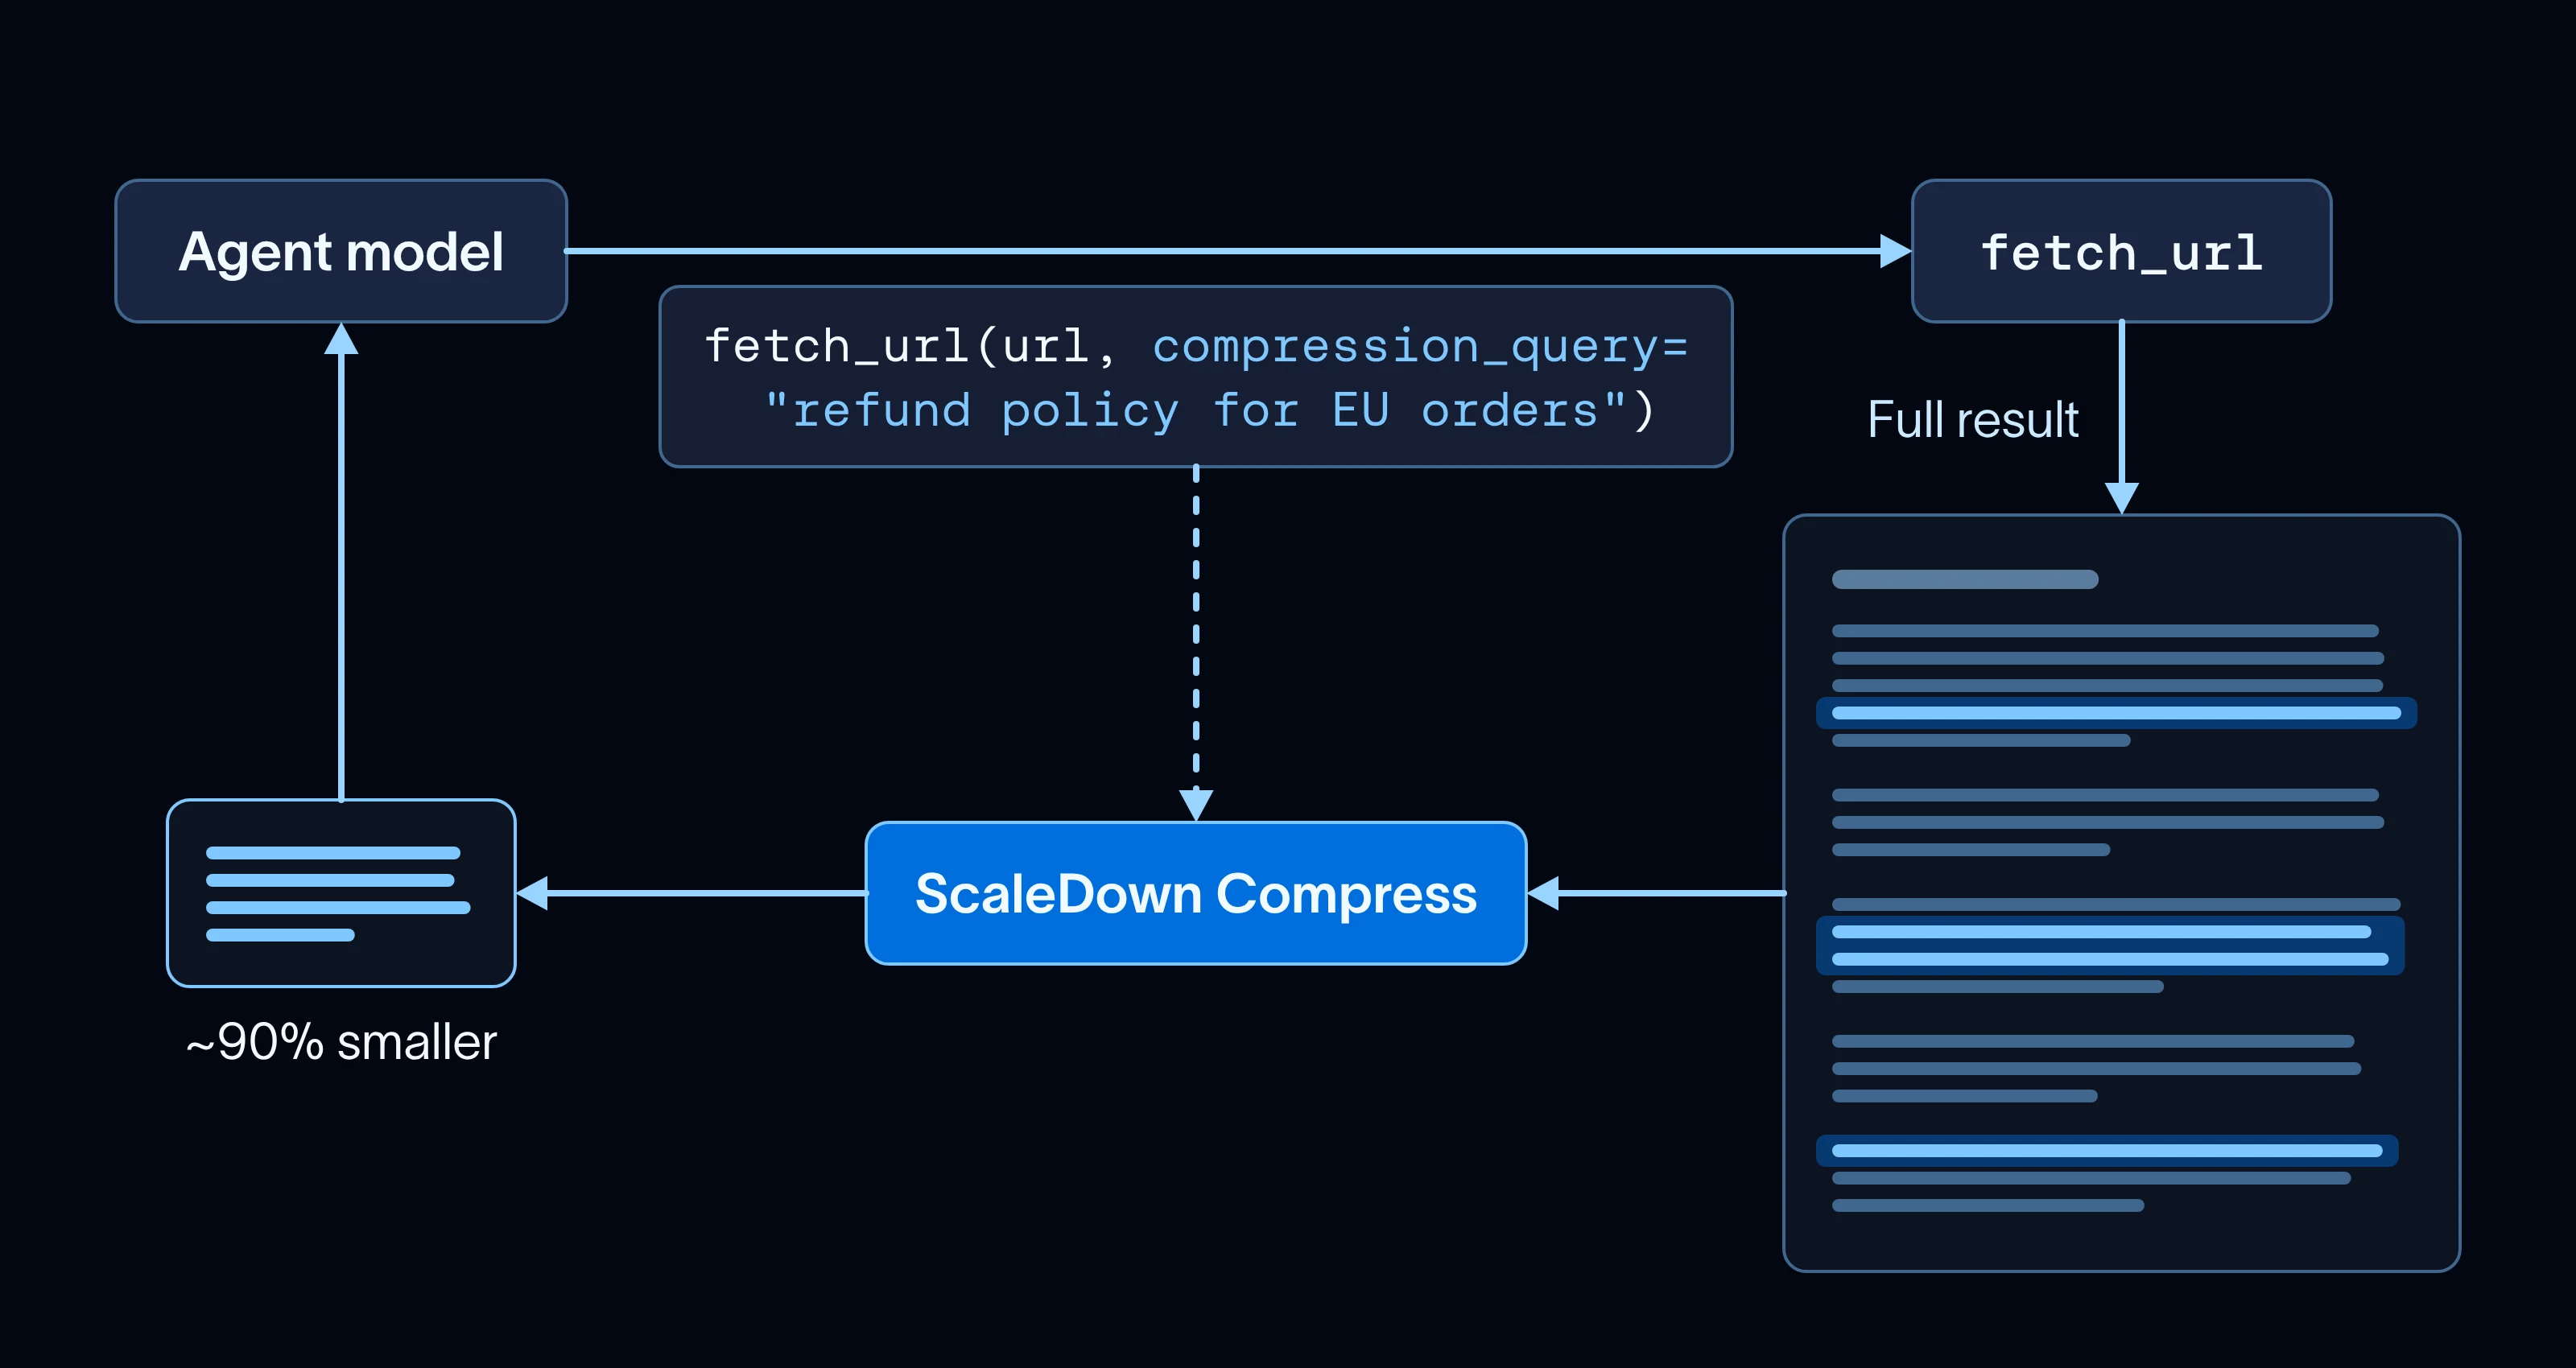
ScaledownToolCompressionMiddleware 는 도구에 선택적 compression_query 매개변수를 추가합니다. 모델이 결과의 일부만 필요로 할 때 도구 호출 시 compression_query 를 채웁니다. 예를 들어 "refund policy for EU orders"와 같습니다. 미들웨어는 도구가 실행되기 전에 이를 제거한 뒤, 모델이 보기 전에 ScaleDown이 출력을 관련 부분으로 압축합니다:
from deepagents import create_deep_agent
from langchain_scaledown import ScaledownToolCompressionMiddleware

agent = create_deep_agent(
    model="openai:gpt-6-luna",
    tools=[search_docs, fetch_url],
    middleware=[ScaledownToolCompressionMiddleware(tools=["fetch_url"])],
)
도구 자체는 변경되지 않으므로, MCP 도구를 포함한 모든 도구에서 작동합니다. 이 트레이스에서 ScaleDown은 모델이 보기 전에 긴 문서 페이지를 거의 90% 줄였습니다. 압축된 결과는 다음과 같은 노트로 시작하므로, 모델은 전체 페이지가 필요할 때 compression_query 없이 도구를 다시 호출할 수 있습니다:
[Compressed by ScaleDown for "refund policy for EU orders":
 18,402 -> 3,110 chars.
 Call this tool again without `compression_query` for the full output.]
구조화된 데이터 추출
에이전트는 읽은 내용에서 ID, 날짜, 다음 도구 호출에 필요한 필드 같은 특정 값을 끊임없이 추출합니다. 이 추출은 에이전트 루프 내부에 있으므로 매 턴에 지연을 추가하지 않을 만큼 빨라야 하고, 도구가 값을 그대로 사용할 수 있을 만큼 정확해야 합니다.
예를 들어, 지원 에이전트가 티켓을 생성하기 전에 주문 번호, 오류 메시지, 고객의 이메일이 필요합니다. 메인 모델이 이를 도구 인수로 채울 수 있지만, 오류 코드를 다르게 표현하거나 이메일 주소를 정확히 복사하지 않고 잘못 입력할 수 있습니다.
ScaledownExtractionMiddleware 는 이 단계를 ScaleDown에 넘깁니다. 각 필드를 일반 언어로 설명하면 Extract가 텍스트에서 값을 복사합니다. 필드는 레이블 집합일 수도 있으며, 이 경우 ScaleDown이 Classify로 답하므로 티켓을 이슈 유형별로 라우팅할 수 있습니다. 실행의 첫 모델 호출 전에 미들웨어는 사용자의 메시지를 Extract에 보내고 필드를 에이전트 상태의 scaledown_extraction아래에 저장하며, 도구가 이를 읽을 수 있습니다:
from deepagents import create_deep_agent
from langchain.tools import ToolRuntime, tool
from langchain_scaledown import ScaledownExtractionMiddleware

ticket = ScaledownExtractionMiddleware(
    entities={
        "order_id": "Order number the customer mentions",
        "error_message": "Exact error message or code the customer saw",
        "customer_email": "Customer's email address",
        "issue_type": {
            "labels": [
                {"name": "billing", "rubric": "Is this about a charge, refund, or payment?"},
                {"name": "technical", "rubric": "Is this about a bug or something not working?"},
                {"name": "account", "rubric": "Is this about login, password, or account settings?"},
            ]
        },
    },
    context_chars=0,  # skip evidence snippets to keep state small
)


@tool
def file_ticket(runtime: ToolRuntime) -> str:
    """File a support ticket with the details gathered so far."""
    fields = runtime.state.get("scaledown_extraction", {}).get("fields", {})
    return crm.create_ticket(**fields)  # your ticketing system


agent = create_deep_agent(model="openai:gpt-6-sol", tools=[file_ticket], middleware=[ticket])
Extract는 사용자의 메시지만 읽고 에이전트의 답변은 절대 읽지 않으므로, 모든 값은 고객이 실제로 말한 것입니다. With a checkpointer, 추출은 매 턴마다 다시 실행되므로 고객이 세부 정보를 추가함에 따라 레코드가 채워집니다. 예를 들어 "주문 A-1042이(가) ERR_PAYMENT_DECLINED 오류로 실패했습니다. 저는 이미 다른 카드로 시도해 보았습니다."라는 입력이 들어오면 필드는 다음과 같이 반환됩니다:
{
    "order_id": "A-1042",
    "error_message": "ERR_PAYMENT_DECLINED",
    "customer_email": None,  # not mentioned yet
    "issue_type": "billing",
}
분류(Classifying) 드리프트(drift)
에이전트는 작업이 완료되었는지, 마지막 도구 호출이 성공했는지와 같은 현재 상태를 기반으로 다음 단계를 결정합니다. 이 상태 분류는 매 턴마다 발생하므로 저렴하고 빠르게 이루어져야 합니다.
장기 실행 에이전트에서 감지할 가치가 있는 상태 중 하나는 드리프트(drift)입니다. 즉, 동일한 실패하는 도구 호출을 반복하거나 비생산적인 순환에 갇히는 것입니다. 이를 위한 사전 구축된 미들웨어는 없지만, 자체 custom middleware에서 ScaleDown 모델을 호출할 수 있습니다. 다음은 모델 호출 후마다 실행되어 대화 기록을 ScaleDown Classify에 보내고, 흐름이 벗어났을 때 실행을 중단하는 서킷 브레이커입니다:
import os

import requests
from deepagents import create_deep_agent
from langchain.agents.middleware import after_model
from langchain_core.messages import AIMessage, get_buffer_string

LABELS = [
    {"name": "progressing", "rubric": "Is the agent making new progress on the user's task?"},
    {"name": "looping", "rubric": "Is the agent repeating the same steps without new results?"},
    {"name": "drifting", "rubric": "Is the agent working on something the user did not ask for?"},
]


@after_model(can_jump_to=["end"])
def circuit_breaker(state, runtime):
    result = requests.post(
        "https://api.scaledown.xyz/classify",
        headers={"x-api-key": os.environ["SCALEDOWN_API_KEY"]},
        json={"text": get_buffer_string(state["messages"]), "labels": LABELS},
    ).json()

    label = result["top_label"]
    if label != "progressing" and result["scores"][label] > 0.8:
        return {"jump_to": "end", "messages": [AIMessage(f"Stopped: {result['reasoning']}")]}
    return None


agent = create_deep_agent(model="openai:gpt-6-sol", tools=[run_tests], middleware=[circuit_breaker])
Classify는 각 레이블에 대한 확률을 반환하므로, 브레이커가 작동하기 전에 얼마나 높은 확신이 필요한지 직접 선택할 수 있습니다. 한 줄짜리 이유(reason)가 최종 메시지에 표시되므로 실행이 중단된 이유를 확인할 수 있습니다. 더 부드러운 버전은 첫 작동 시점에 실행을 끝내지 않습니다. 대신 이유를 대화에 추가하여 방향을 바꾸도록 유도하고, 에이전트가 다시 드리프트할 때만 중단합니다.
이 네 개의 섹션은 ScaleDown의 모델이 활용될 수 있는 몇 가지 사례를 보여주며, 이 목록이 전부는 아닙니다. 긴 도구 결과에 대해 extract / summarize를 실행하거나, 런타임 모델 라우팅을 위한 classification을 사용하는 것처럼 이들을 조합하여 사용할 수 있습니다. 다양한 유형의 데이터에서 CDMs 모델을 활용하는 다른 방법을 보려면 ScaleDown Cookbooks 을 확인해 보세요.
LangSmith LLM 게이트웨이의 ScaleDown
그 LangSmith LLM Gateway 하나의 LangSmith API 키로 여러 제공업체의 모델을 호출할 수 있게 해주고, 모든 호출을 추적하며, 여러분의 지출하다 그리고 속도 제한. ScaleDown은 이제 그중 하나입니다 직접 모델 접근 제공자, 즉 그 /scaledown 경로.
관리자가 귀하의 ScaleDown 키를 워크스페이스의 제공자 비밀 ~로서 SCALEDOWN_API_KEY 한 번. 그런 다음 가리킵니다 langchain-scaledown 게이트웨이에서 LangSmith 키로 인증하세요:
export SCALEDOWN_BASE_URL="https://gateway.smith.langchain.com/scaledown"
export SCALEDOWN_API_KEY="$LANGSMITH_API_KEY"
각 ScaleDown 호출은 그 다음에 다음과 같이 표시됩니다. LangSmith trace 그리고 다른 모델 호출과 동일한 한도에 포함됩니다.
ScaleDown을 사용하지 말아야 할 때
코드 작성, 답변 초안 작성, 계획 수립과 같은 개방형 생성에는 범용 LLM을 유지하세요. 이는 저희의 Jev 게시물에서 제시한 "기본적으로 저렴하게, 예외적으로 프론티어 사용" 접근 방식을 따릅니다. 어려운 부분에는 대형 범용 LLM을 사용하고, 그 주변의 대량 처리 단계에는 특화 모델을 사용하세요.
ScaleDown은 모든 턴에서 실행될 만큼 빠르고 저렴하므로, 에이전트가 메인 루프를 늦추거나 프론티어 가격을 지불하지 않고도 컨텍스트 관리가 의존하는 구조화된 결정을 내릴 수 있습니다. 장기 실행 에이전트에서는 이러한 결정이 거의 모든 턴에서 발생하므로 절감 효과가 빠르게 누적됩니다.
시작하기
통합 설치 그리고 ScaleDown API 키 설정:
uv pip install -U langchain-scaledown
export SCALEDOWN_API_KEY="..."
새 ScaleDown 계정은 무료 50M 토큰을 받습니다. 이 ScaleDown 통합 문서 에서 각 미들웨어의 구성 옵션을 다룹니다. 사용해 보시고 langchain-scaledown 생각을 LangChain 포럼, X또는 GitHub에서 알려주세요.