

해커를 막기 위해 설계된 AI 보호 장치가 이제 방어자들을 차단하고 있으며, 오리온-1은 그 공백을 메우는 것을 목표로 한다
 Jonathan Kemper
의 LinkedIn 프로필을 보기
Oct 14, 2026
 Nano Banana Pro는 THE DECODER에 의해 제시됨
주요 내용
- 아트메스 시큐리티는 자체적으로 기업 네트워크의 사이버 공격을 조사하고 대응하는 AI 모델인 오리온-1을 출시했습니다.
- 네트워크, 엔드포인트, 클라우드 서비스에서 분산된 로그 데이터를 연결하여 공격을 단일 행위자로 추적하고 대응 조치를 시작합니다.
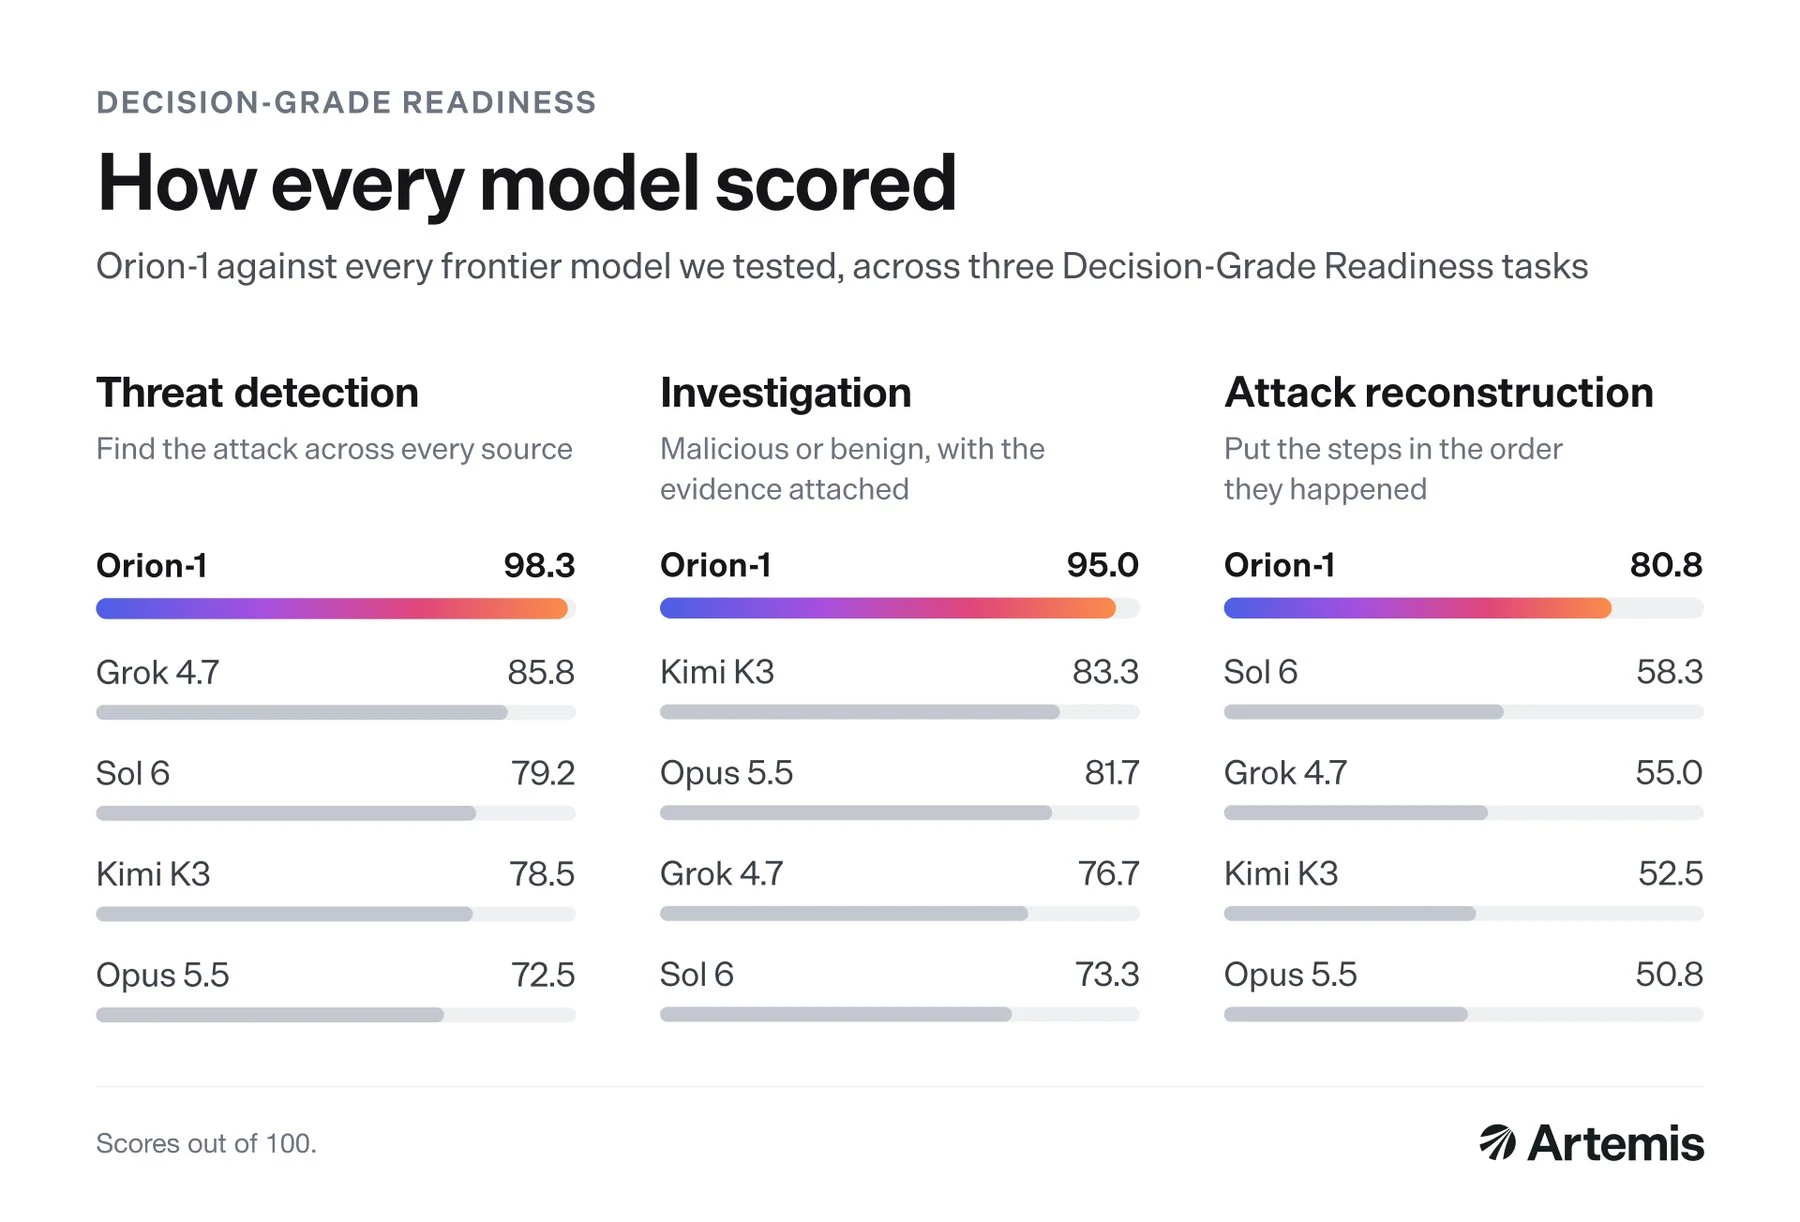
- 회사 자체 기준에 따르면, Orion-1은 Claude Opus 5.5 및 GPT-6 Sol과 같은 일반용 모델보다 우수하며, 공격 재구성 부분에서의 차이는 80.8점 대 58.3점으로 가장 큽니다.
일반용 AI 모델은 보안 팀에게 점점 더 큰 문제가 되고 있습니다. 왜냐하면 같은 기술이 공격자에게도 도움이 되기 때문입니다. 아르테미스 시큐리티는 특별히 설계된 모델을 통해 이러한 격차를 해소하고자 합니다.
US 스타트업 Artemis Security는 Orion-1를 출시했습니다. 이 모델은 기업 네트워크에 대한 공격을 스스로 조사하고 대응하도록 설계되었으며, 회사 자체의 벤치마크에서 Claude Opus 5.5와 GPT-6 Sol를 능가했습니다. Orion-1은 인증 서비스, 클라우드 설정, 기업 엔드포인트, SaaS 애플리케이션 및 네트워크 장비에서 나오는 로그 데이터를 처리하고, 기업 계정 로그인, 새로운 클라우드 권한, 새로 생성된 이메일 인박스 규칙과 같은 개별 신호를 연결하여 단일 공격자와 연관시킵니다. 일단 발생한 상황의 전모가 파악되면, 모델은 신뢰도 점수를 부여하고 판단을 내린 뒤 대응 방안을 제안하거나 실행합니다.
Artemis에 따르면, 일반용 모델은 수십억 개의 이벤트를 처리할 때 추적을 잃거나, 무해하지만 이상한 활동을 공격으로 오인합니다. Artemis는 Orion-1을 자체 보안 작전에서 얻은 작업들에 맞게 미세 조정했는데, 여기에는 로그 데이터에서 의심스러운 패턴을 찾아내고, 알려진 공격 기법을 탐색하며, 새로운 탐지 규칙을 만드고, 실시간 공격을 차단하는 것이 포함됩니다. 회사에 따르면 훈련 과정에서 고객 데이터는 사용되지 않았습니다. Artemis는 Orion-1을 “Frontier Foundation Model”이라고 부르지만, 이 미세 조정에 대해서는 블로그 글에서만 설명하며, 회사가 다른 제공업체의 기존 모델을 기반으로 구축했는지 여부는 명확하지 않습니다.
아르테미스는 보안 결정에 대한 신뢰를 측정하기 위한 자체 벤치마크를 만들었습니다.
아르테미스는 비교를 위해 "Decision-Grade Readiness"(DGR)라는 벤치마크를 개발했습니다. 기존의 보안 테스트 모델 대부분은 공격 기술에 기반하거나 해킹 퍼즐을 풀도록 요구하지만, DGR는 모든 모델에게 동일한 초기 경고, 동일한 환경 데이터, 그리고 보안 팀이 가질 수 있는 동일한 도구를 제공하고, 이후 공격이 진행 중인지 여부를 결정하도록 요청합니다. 수천 개의 작업 모두 명확한 결과를 가집니다. 일부 작업은 전혀 공격이 없거나, 악의적으로 보이도록 설계된 무해한 데이터를 포함합니다. 모델들은 그 판단과 제시된 증거에 따라 점수가 매겨집니다.
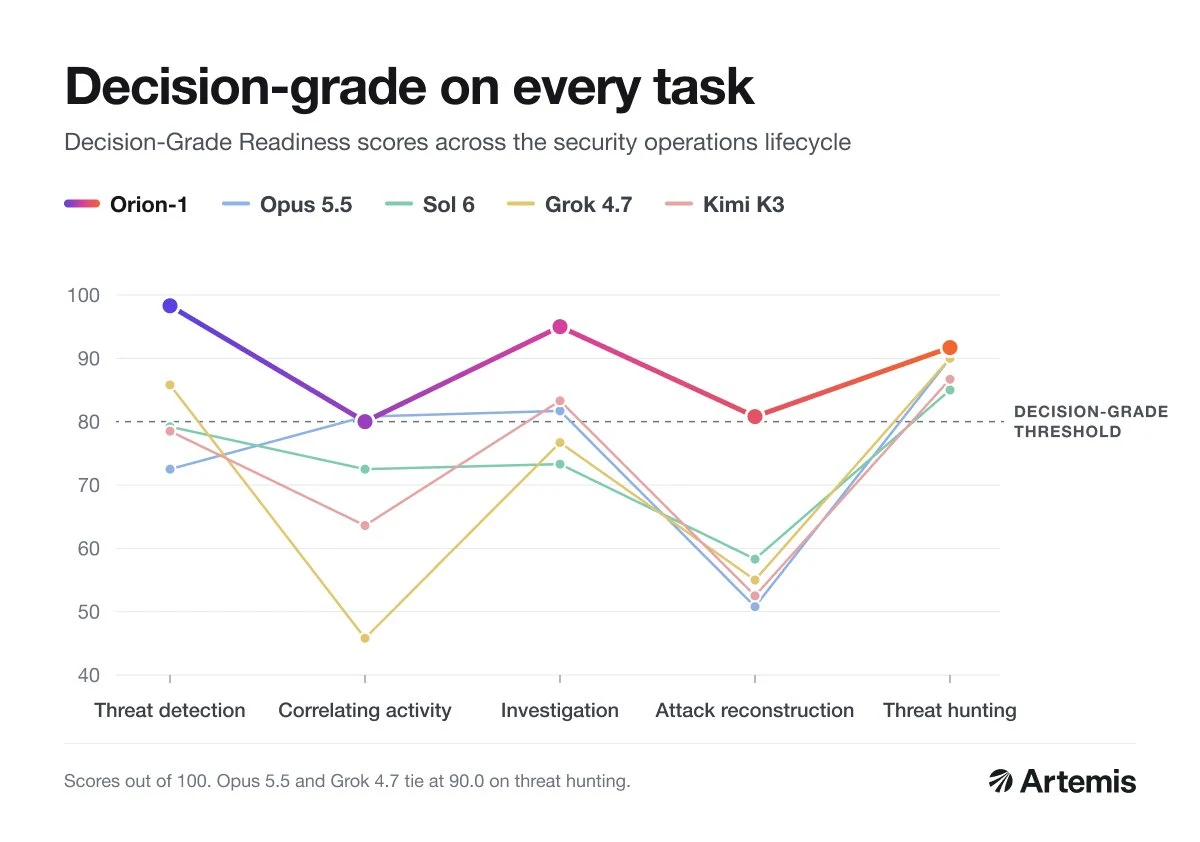
아르테미스는 다섯 가지 작업에서 결과를 보고했으며, Grok 4.7와 Kimi K3를 Opus 5.5 및 GPT-6 Sol과 함께 테스트했습니다. 가장 큰 격차는 공격 재구성 부분에서 나타나는데, Orion-1은 다음으로 좋은 모델의 58.3에 비해 80.8점을 기록했습니다.
Orion-1은 아르테미스 플랫폼에서 일부 고객을 대상으로 프라이빗 미리보기 형태로 제공되고 있으며, 고객들은 각 행동 유형에 대해 모델이 스스로 결정할 수 있는 범위를 설정합니다. 고 영향력 있는 행동은 기본적으로 인간의 승인이 필요합니다. 아르테미스는 회사 설립 약 6개월 후인 4월에 비공개되었으며, 시드 및 시리즈 A 라운드에서 7천만 달러를 확보했습니다.
공격자들을 위한 가이드라인은 방어자들도 막고 있음
광범위한 프론티어 모델들은 보안 팀들이 작업하기 어려워지고 있는데, 이는 제공자들이 사이버 기능을 더욱 엄격하게 제한하기 때문입니다. OpenAI는 자사의 Astra 모델이 최고 수준의 사이버 보안 위험 등급에 도달할 수 있는 첫 번째 모델이라고 생각합니다. 이런 상황에서는 모델이 스스로 사이버 공격을 개발하고 실행할 수 있습니다. Claude Opus 5.5는 대부분의 사이버 보안 작업을 더 오래된 Opus 4.8으로 라우팅하며, July에 Hugging Face가 상업적 프론티어 모델을 사용하여 자체 인프라에 대한 완전 자율적인 AI 공격을 분석하려고 했을 때, 그들의 보안 장벽이 공격 데이터의 분석을 완전히 차단했습니다. 결국 팀은 자체 서버에서 실행되는 개방형 모델 GLM 5.2로 전환했습니다.
방어를 위해, 제공업체들은 제한된 접근 권한이 있는 특수 모델을 배포하고 있습니다. OpenAI는 덜 제한적인 형태만을 제공합니다. GPT-5.5-Cyber 검증된 방어자들에게는 그렇지만, Anthropic은 가장 강력한 모델로 유사한 접근법을 취하며 Claude Mythos 5를 실행합니다. 클로드 보안 스캐너 및 파트너 보안 제품. 둘 다 신화 5 그리고 OpenAI의 가장 강력한 모델이죠. GPT-6 Astra는 Orion-1 비교에서 누락되었으며, Opus 5.5 기준 결과는 대체로 더 오래된 Opus 4.8의 결과와 유사할 수 있습니다.
과장 없는 AI 뉴스 – 인간이 선별한 내용
THE DECODER에 가입하여 광고 없는 읽기, 주간 AI 뉴스레터, 매년 6회 발행되는 독점적인 "AI Radar" 전선 보고서, 전체 아카이브 접근 권한, 그리고 우리의 댓글 섹션에 접속하세요.
출처: Artemis Security