
IDC 리서치 에 따르면 문서 관련 문제로 인해 조직은 정보 근로자 1인당 연간 19,732달러의 비용이 발생하고 생산성이 21.3퍼센트 감소합니다. 수백 곳의 공급업체로부터 송장을 받는 조직은 발행자마다 레이아웃이 다르고 사전 통지 없이 변경되는 레이아웃에 자주 직면합니다. 이러한 규모에서는 템플릿 기반 시스템에 지속적인 유지 관리가 필요합니다. 직원들은 문서 관련 작업에 최대 30퍼센트의 시간을 소비할 수 있으며, 수동 데이터 입력 오류율은 1–4퍼센트에 이릅니다. 기존의 지능형 문서 처리(IDP) 솔루션은 이러한 부담을 일부 해소하지만, 각 문서 형식마다 방대한 사전 구성이 필요하고 공급업체마다 레이아웃이 다르면 작동이 중단됩니다.
이 게시물에서는 최소한의 사람 개입으로 비즈니스 문서를 분류, 추출, 검증 및 학습하는 에이전틱 IDP 시스템을 Amazon Bedrock AgentCore 를 사용하여 구축하는 방법을 배웁니다. Amazon Bedrock AgentCore는 모든 프레임워크와 모델을 사용하여 대규모로 에이전트를 구축, 연결 및 최적화할 수 있는 플랫폼입니다. 에이전트는 공급업체 송장, 구매 주문서, 보험 청구서, 대출 신청서 등 새로운 문서 형식을 자동으로 처리합니다. 이 게시물을 마치면 다음을 수행할 수 있습니다:
- 대개 20분 이내에 멀티 에이전트 IDP 시스템을 배포합니다.
- 수동 템플릿 구성 없이 새로운 문서 유형을 처리합니다.
- 에이전트가 각 새 문서 형식에 대해 스스로 학습하고 학습한 내용을 재사용하도록 하여, 이후 해당 유형의 문서는 재학습 없이 바로 추출 단계로 진행됩니다.
규칙 기반 문서 처리의 과제
많은 IDP 파이프라인은 모든 문서 형식에 대해 템플릿, 추출 규칙, 검증 로직을 사전에 정의하도록 요구합니다. 새 공급업체가 다른 레이아웃의 구매 주문서를 보내면 파이프라인이 중단됩니다. 이로 인해 세 가지 핵심 과제가 발생합니다:
- 템플릿 경직성: 각 새 문서 형식마다 수동 구성이 필요하며, 사소한 레이아웃 변경만으로도 추출 실패가 발생할 수 있습니다.
- 학습 부재: 시스템이 이전 수정 사항의 지식을 보존하지 않기 때문에 동일한 추출 오류가 유사한 문서에서 반복됩니다.
- 확장 부담: 새 공급업체나 문서 변형이 추가될 때마다 유지 관리 노력이 배로 늘어나며, 수백 곳의 소스에서 문서를 처리하는 조직은 지속적인 운영 비용에 직면합니다.
에이전틱 접근 방식은 이러한 과제를 해결합니다. 정적 템플릿 대신 AI 에이전트가 각 문서를 분석하고, 추출 지침을 생성하고, 결과를 검증하고, 수정 사항으로부터 자동으로 학습합니다. 시간이 지남에 따라 시스템은 문서 형식에 대한 지식 베이스를 구축하여 유사한 문서를 최소한의 추가 구성으로 처리합니다.
솔루션 개요
이 솔루션에서는 여덟 개의 전문 에이전트가 Amazon Bedrock AgentCore에서 실행되는 두 개의 그래프 기반 워크플로우 전반에서 협업합니다.
다음 다이어그램은 AI 에이전트 구축을 위한 오픈 소스 SDK인 Strands Agents를 사용하여 구축된 멀티 에이전트 워크플로우 그래프를 보여줍니다.
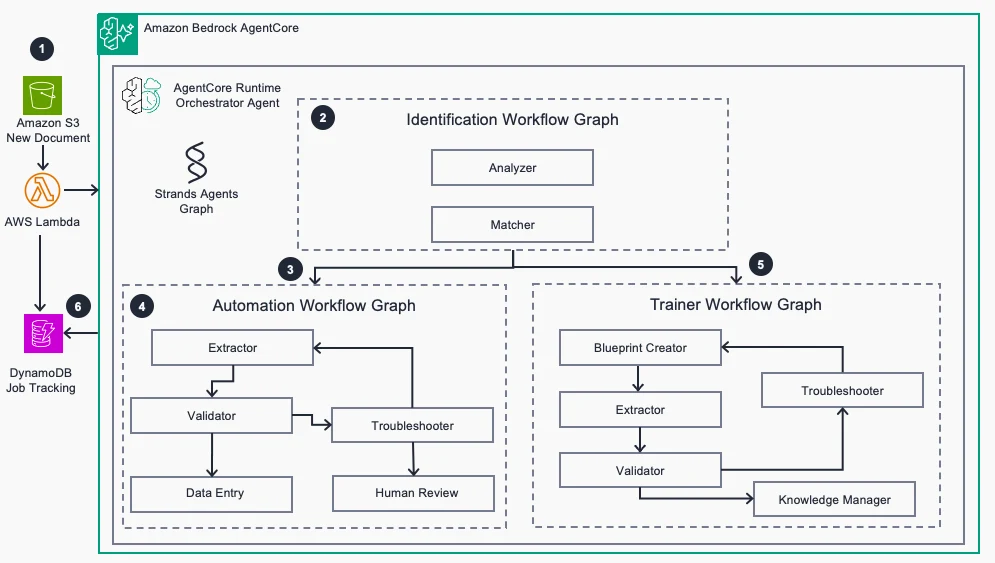
그림 1: 멀티 에이전트 오케스트레이션 워크플로우 그래프
- 식별 워크플로우: Analyzer 에이전트는 Amazon Textract 를 사용하여 텍스트를 추출하고 문서 유형과 발신자를 식별합니다. Matcher 에이전트는 벡터 유사성을 사용하여 유사한 문서를 검색합니다. Amazon S3 Vectors, Amazon Simple Storage Service(Amazon S3)의 기능입니다.
- 학습 워크플로 (새로운 문서 유형): 일치하는 항목이 없으면 Instructions 에이전트가 추출 프롬프트를 생성하고, Extractor 에이전트가 구조화된 데이터를 추출하며, Validator 에이전트가 Amazon Aurora DSQL의 스키마 및 비즈니스 규칙에 대해 결과를 검증합니다. 검증에 실패하면 Instructions Fixer 에이전트가 프롬프트를 개선하고 재시도합니다. 성공하면 Save Instructions 에이전트가 재사용을 위해 지침을 저장합니다.
- 자동화 워크플로 (알려진 문서 유형): 일치하는 항목이 있으면 Extractor 에이전트가 기존 지침을 사용합니다. 검증에 실패하면 Troubleshooter 에이전트가 지침을 수정하지 않고 추출된 데이터를 직접 수정합니다.
작동 방식
다음 다이어그램은 이 솔루션의 인프라 아키텍처를 보여줍니다.
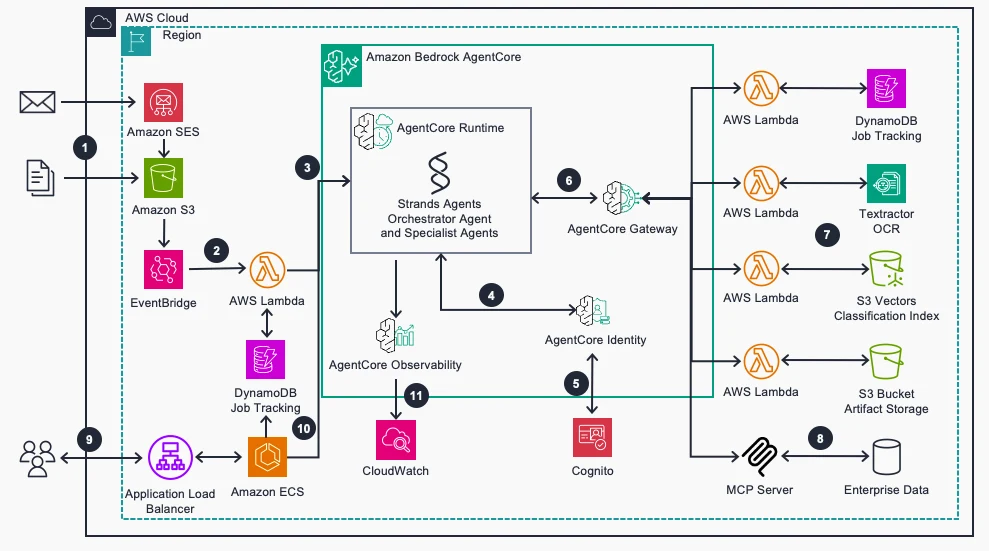
그림 2: AWS에서의 Agentic IDP 인프라 아키텍처
- 비즈니스 문서는 Amazon Simple Email Service (Amazon SES)를 통해 또는 Amazon S3에 직접 업로드되어 도착합니다.
- Amazon EventBridge 가 AWS Lambda 함수를 트리거하고, 이 함수는 Amazon DynamoDB 에 추적 작업을 생성하고 Amazon Bedrock AgentCore의 기능인 AgentCore runtime을 호출합니다.
- AgentCore runtime은 Strands Agents를 통해 문서 처리를 오케스트레이션합니다.
- 에이전트는 Amazon Bedrock AgentCore의 기능인 AgentCore Identity가 관리하는 머신 간(machine-to-machine) 자격 증명을 통해 AWS 리소스에 안전하게 액세스하며, Amazon Cognito.
- AgentCore Gateway(Amazon Bedrock AgentCore의 기능)의 Model Context Protocol(MCP) 인터페이스를 통해 Lambda 함수가 에이전트 호환 도구로 변환됩니다.
- 에이전트는 Amazon Textract를 사용해 텍스트를 추출하고, S3 Vectors의 벡터 임베딩으로 문서를 분류하며, Aurora DSQL에서 비즈니스 규칙에 따라 데이터를 검증합니다.
- 에이전트는 MCP 서버를 통해 기업 데이터에 접근하여 추출된 콘텐츠를 비즈니스 규칙에 따라 검증합니다.
- 채팅 기능이 포함된 대시보드를 통해 상태를 모니터링하고 문제를 해결합니다. 이 대시보드는 다음에서 호스팅됩니다. Amazon Elastic Container Service (Amazon ECS).
- Amazon Bedrock AgentCore의 기능인 AgentCore Observability를 통해 에이전트 성능에 대한 가시성을 확보할 수 있으며, Amazon CloudWatch 텔레메트리.
솔루션 배포
다음 단계를 따라 솔루션 인프라와 웹 UI를 AWS 계정에 배포하세요.
전제 조건
translated
- 한 AWS 계정.
- 접근 Amazon Bedrock Amazon Nova 및 Anthropic(Claude) 모델이 활성화된 상태입니다. AWS 리전별 모델 가용성에 대한 자세한 내용은 다음을 참조하세요. Amazon Bedrock의 AWS 리전별 지원 모델.
- Amazon Bedrock AgentCore(Runtime, Gateway, Identity), S3 Vectors, Amazon Aurora DSQL에 대한 접근을 한 곳에서 제공하며 지원되는 리전.
- AWS Cloud Development Kit (AWS CDK) v2가 설치되어 있어야 합니다.
- Docker 설치되어 실행 중이어야 합니다(컨테이너 이미지 빌드 및 배포에 필요).
- Python 3.11+ 및 Node.js 18+.
- S3 버킷, Lambda 함수, DynamoDB 테이블, Cognito 사용자 풀, Amazon Elastic Container Registry(Amazon ECR) 리포지토리, Amazon ECS 서비스를 생성할 수 있는 AWS Identity and Access Management (IAM) 권한이 있어야 S3 버킷, Lambda 함수, DynamoDB 테이블, Cognito 사용자 풀, Amazon Elastic Container Registry(Amazon ECR) 리포지토리 및 Amazon ECS 서비스를 생성할 수 있습니다.
- 다음 리포지토리를 복제합니다 리포지토리 그리고 환경을 설정합니다:
git clone https://github.com/aws-samples/agenticidp-guidance.git cd agenticidp-guidance uv venv source .venv/bin/activate uv pip install -r requirements.txt cd ui/orchestrator npm install cd ../.. - 스택을 배포합니다:
uv run deploy.py --admin-email your-email@example.com
이 명령은 여섯 개의 AWS CloudFormation 스택을 배포합니다: Core(S3, Cognito, DynamoDB), Gateway(Lambda 도구, AgentCore Gateway), Aurora(Amazon Aurora DSQL), Agent(AgentCore 런타임, 컨테이너), UI Orchestrator(API 엔드포인트), Modern UI( Amazon CloudFront의 React 앱). 배포에는 약 15–20분이 소요됩니다.
- CloudFormation 콘솔에서 각 스택이 다음과 같이 표시되는지 확인하여 배포를 검증합니다.
CREATE_COMPLETECloudFormation 콘솔에서.
파일 처리 및 결과 검토
배포가 완료되면 CloudFront URL, 사용자 이름, 임시 비밀번호가 포함된 이메일을 받게 됩니다.
문서 처리하기
- 웹 UI에 로그인한 후 다음을 선택합니다. Process Document.
- 다음에서 샘플 구매 주문서를 업로드합니다.
infrastructure/sample_data/purchase_orders/training/. - 문서는 에이전트 워크플로에 들어갑니다:
- Analyzer 에이전트가 텍스트를 추출하고 발신자와 문서 유형을 식별합니다.
- Matcher 에이전트가 벡터 스토어에서 유사한 문서를 검색합니다.
- 새로운 문서 유형인 경우, 훈련 워크플로가 추출 지침을 생성하고, 데이터를 추출하고, 검증한 후, 향후 사용을 위해 지침을 저장합니다.
- 이미 알려진 문서 유형인 경우, 자동화 워크플로가 기존 지침을 사용하여 데이터를 추출하고 검증합니다.
- 다음 탭에서 결과를 검토합니다. Review Jobs and Instructions 탭에서 추출된 데이터, 검증 결과, 생성된 지침을 확인합니다.
예시: 새로운 문서 유형(트레이닝 워크플로)
새로운 소매업체인 Two Wheel Store의 첫 번째 발주서를 업로드한다고 가정해 보겠습니다. Matcher 에이전트는 벡터 스토어를 검색하지만 유사한 문서를 찾지 못하고, 해당 작업을 트레이닝 워크플로로 라우팅합니다.
Analyzer 에이전트는 Amazon Textract를 사용하여 원본 문서 텍스트를 추출합니다:
# PURCHASE ORDER
FROM: Two Wheel Store
Order #: PO-2026-0102-2584
Date: 2026-01-02

## Items Ordered
AC-021  Advanced Computer     Qty: 1   $75.61
        Colors: cr4321        @ $75.61
...
SB-004  Folding Classic       Qty: 8   $9634.32
        Colors: cb8901 I Sizes: S     @ $1204.29

TOTAL: $14931.54
Instructions 에이전트는 스키마에서 추출 프롬프트를 생성하고, Extractor 에이전트는 구조화된 JSON을 생성합니다:
{
  "po_number": "PO-2026-0102-2584",
  "retailer_name": "Two Wheel Store",
  "order_date": "2026-01-02T00:00:00Z",
  "line_items": [
    { "sku": "AC-021", "product_name": "Advanced Computer", "quantity": 1, "unit_price": 75.61, "line_total": 75.61 },
    { "sku": "SB-004", "product_name": "Folding Classic",   "quantity": 8, "unit_price": 1204.29, "line_total": 9634.32 }
  ],
  "order_total": 14931.54
}
Validator 에이전트는 결과를 스키마와 대조하여 검사하고 실패합니다:
validation_status: INVALID
error: 'SB-004' does not match '^AB-[A-Z]{2}-\d{3}$'
공급업체의 SKU 형식(SB-004)이 Acme Bikes의 내부 형식(AB-SB-004)과 일치하지 않습니다. Instructions Fixer 에이전트는 이 불일치를 진단하고 추출 프롬프트에 명시적인 SKU 변환 규칙을 추가합니다: 공급업체 SKU에 접두사 AB-를 붙입니다. 두 번째 시도에서 7개의 품목이 성공적으로 검증을 통과하고, Save Instructions 에이전트는 개선된 프롬프트를 벡터 스토어에 저장합니다. 이 첫 실행의 엔드투엔드 소요 시간: 3분 49초.
예시: 기존에 알려진 문서 유형(자동화 워크플로)
Two Wheel Store의 두 번째 발주서가 도착하면, Matcher 에이전트는 첫 실행 시 저장된 지침을 3.946의 신뢰도 점수(임계값: 3.7)로 찾아내고 해당 작업을 자동화 워크플로로 라우팅합니다:
- Extractor 에이전트는 저장된 지침을 직접 적용하므로, 오케스트레이터는 프롬프트 생성을 건너뜁니다. 트레이닝 중 학습된 SKU 변환 규칙이 자동으로 적용됩니다(
EL-002→AB-EL-002,HB-071→AB-HB-071,PD-002→AB-PD-002). - 3개의 품목이 첫 번째 시도에서 검증을 통과하며 주문 총액은 $5,979.19입니다.
- 엔드투엔드 처리는 1분 30초 내에 완료되며, 첫 실행 시의 3분 49초에서 단축된 시간입니다.
대화형 채팅 사용
대시보드에는 문제 해결을 위한 채팅 인터페이스가 포함되어 있습니다:
- 라고 물으면
what tools do you have사용 가능한 에이전트 기능을 확인할 수 있습니다. - 라고 물으면
list instructions저장된 추출 지침을 볼 수 있습니다. - 라고 물으면
what is the status of job XXXX처리 진행 상황을 확인할 수 있습니다. - 라고 물으면
what went wrong with job XXXX, how can we update the instructions?실패 원인을 진단할 수 있습니다.
시간이 지남에 따라 정확도가 향상되는 방식 이해
이 시스템은 두 가지 피드백 루프를 통해 시간이 지남에 따라 개선됩니다:
- 트레이닝 루프: 검증 실패 후 Instructions Fixer 에이전트가 추출 프롬프트를 개선하면, 개선된 지침이 저장되어 유사한 문서에 재사용됩니다.
- 처리 루프: Troubleshooter 에이전트가 추출 오류를 수정할 때, 문서 형식 변동의 패턴을 파악하는 데 도움이 되는 상세한 분석을 제공합니다.
모델 변경 시, AgentCore Evaluations는 Amazon Bedrock AgentCore의 기능으로, 추출 품질이 허용 가능한 수준을 유지하는지 확인합니다. 이 솔루션은 이미 AgentCore Observability를 사용하고 있으므로 필요한 계측 기능을 갖추고 있습니다.
예상 비용
솔루션이 서버리스 및 온디맨드 리소스에서 실행되고 유휴 비용이 없으므로 사용한 만큼만 비용을 지불합니다. US East (N. Virginia) 리전에서 매월 10개의 학습 문서와 1,000개의 처리된 문서를 다루는 워크로드의 경우, 예상 비용은 월 약 $58입니다. Amazon Bedrock을 통한 파운데이션 모델(FM) 추론이 전체 비용의 약 85%를 차지하며, 문서당 약 $0.055입니다. 실제 비용은 각 에이전트에 할당된 모델에 크게 좌우됩니다. 모델 선택은 agents/orchestratorgraph/utils/config.py에서 중앙화되어 있으므로, 간단한 작업에는 저비용 모델을 사용하고 필요한 곳에는 더 강력한 모델을 사용할 수 있습니다. 자세한 요금은 Amazon Bedrock pricing 페이지를 참조하십시오.
사용 사례에 맞게 솔루션 사용자 지정
합성 자전거 회사 데이터세트, 사전 구축된 JSON 스키마, 그리고 모의 ERP 데이터베이스의 제품 및 공급업체 레코드와 추출된 데이터를 대조하는 검증 Lambda 함수를 갖춘 구매 주문서 처리 사용 사례가 제공됩니다. 자체 문서를 처리하려면 포함된 스키마와 검증 로직을 자신의 것으로 교체해야 합니다.
문서 스키마 정의
각 문서 유형에 대해 추출하려는 필드를 정의하는 JSON 스키마를 생성합니다. agents/orchestratorgraph/doc_schema/purchase_order_schema.json 의 샘플 구매 주문서 스키마가 참고 자료로 제공됩니다. 스키마에는 필드 이름, 데이터 유형, 그리고 각 필드가 문서에 명시적인지 아니면 문맥에서 추론되는지를 지정해야 합니다.
검증 프로세스 구축
포함된 검증기는 Aurora DSQL의 합성 공급업체 및 제품 테이블과 구매 주문서 데이터를 대조합니다. 프로덕션 구현에는 비즈니스 규칙에 맞게 조정된 검증 프로세스가 필요합니다. 예:
- 송장 검증기는 공급업체 ID를 미지급 계정 시스템과 대조하고 품목 합계가 송장 총액과 일치하는지 확인할 수 있습니다.
- 계약 검증기는 문서에 필수 조항이 포함되어 있는지, 그리고 날짜와 당사자 이름이 기록과 일치하는지 확인할 수 있습니다.
- 클레임 검증기(validator)는 정책 번호, 보장 한도, 청구인 정보를 정책 관리 시스템과 대조하여 확인할 수 있습니다.
새 검증기를 추가하려면, 추출된 JSON을 받아 상세한 오류 메시지와 함께 통과/실패 결과를 반환하는 Lambda 함수를 생성한 다음, AgentCore Gateway에 도구로 등록하십시오. 구현 패턴은 gateway/tools/po_validator_tool/ 을 참조하십시오.
에이전트 프롬프트 업데이트
의 에이전트 프롬프트는 agents/orchestratorgraph/prompts/ 발주서 용어를 참조합니다. 이러한 프롬프트를 사용자의 문서 유형 및 추출 요구 사항에 맞게 업데이트하십시오. Orchestrator 에이전트, Validator 에이전트, Instructions 에이전트에는 각각 문서 유형별 언어가 포함되어 있으므로 이를 조정해야 합니다.
모범 사례
agentic IDP 시스템을 학습시키고 운영할 때 다음 권장 사항을 염두에 두십시오.
- 대표적인 샘플로 시작: 형식 변형이 있는 엣지 케이스를 포함하여 학습 중에 유형별로 5–10개의 문서를 업로드하여 신뢰할 수 있는 추출 지침을 구축하십시오.
- 비즈니스 규칙 검증 사용: 추출 오류를 조기에 포착하기 위해 검증기를 Aurora DSQL의 참조 데이터(공급업체 목록, 제품 카탈로그)에 연결하십시오.
- 에이전트 성능 모니터링: AgentCore Observability와 CloudWatch를 사용하여 실행 경로를 추적하고, 병목 지점을 식별하고, 시간에 따른 추출 정확도를 측정하십시오.
- 문서 유형을 점진적으로 추가: 각 새 문서 유형에 대한 JSON 스키마와 해당 검증 Lambda 함수를 생성하십시오. 나머지는 에이전트가 처리합니다.
- 프로덕션을 위한 가드레일 추가: 에이전트 출력에 콘텐츠 필터링과 그라운딩 검사를 적용하기 위해 Amazon Bedrock Guardrails를 적용하십시오. 보험 청구나 대출 신청과 같은 민감한 문서 유형을 처리할 때 특히 중요합니다.
- LLM을 위한 OWASP Top 10 검토: 대규모 언어 모델(LLM)을 사용하는 애플리케이션을 구축할 때의 보안 고려 사항은 LLM 및 생성형 AI 앱을 위한 OWASP Top 10 을 참조하십시오.
정리
중요: 정리를 실행하기 전에 보관하려는 데이터를 내보내십시오. 이 destroy.py 스크립트는 처리된 문서(S3), 작업 기록(DynamoDB), 검증 데이터(Aurora DSQL), 학습된 추출 지침(벡터 스토어)을 영구적으로 삭제합니다.
지속적인 요금이 부과되지 않도록 배포된 리소스를 제거하십시오:
uv run destroy.py콘솔에서 AgenticIDP-Core-Dev, AgenticIDP-Gateway-Dev, AgenticIDP-Aurora-Dev, AgenticIDP-Agent-Dev, AgenticIDP-UIOrchestr-Dev, AgenticIDP-ModernUI-Dev 여섯 개의 CloudFormation 스택이 삭제되었는지 확인하십시오.
결론
이 게시물에서는 Amazon Bedrock AgentCore를 사용하여 전문 AI 에이전트들이 협업하여 비즈니스 문서를 분류, 추출, 검증하고 학습하는 자가 개선(self-improving) 문서 처리 시스템을 구축하는 방법을 배웠습니다. 이 agentic 접근 방식은 새로운 문서 형식에 자동으로 적응하고 피드백 루프를 통해 시간이 지남에 따라 정확도를 향상시키며, 수동 템플릿 구성을 자율 학습으로 대체합니다.
다음 단계:
- 다음을 배포합니다 샘플 솔루션 그리고 포함된 구매 주문 샘플로 테스트해 보십시오.
- JSON 스키마와 검증 규칙을 생성하여 자체 문서 유형을 추가할 수 있습니다.
- ERP, CRM 또는 콘텐츠 관리 도구와 같은 다운스트림 시스템과 추출된 데이터를 통합하는 방법을 살펴보십시오.
이 게시물에서 사용된 서비스 및 패턴에 대해 자세히 알아보려면 다음 리소스를 참조하십시오:
- 이 솔루션에서 사용된 에이전트 프레임워크를 심도 있게 살펴보려면 Strands Agents SDK: 에이전트 아키텍처와 관측 가능성에 대한 기술 심층 분석.
- AgentCore Gateway가 API를 에이전트 호환 도구로 변환하는 방법을 이해하려면 Amazon Bedrock AgentCore Gateway 소개: 엔터프라이즈 AI 에이전트 도구 개발의 변화.
- Model Context Protocol의 배경과 AWS 서비스와의 통합 방식에 대해 알아보려면 Unlocking the power of Model Context Protocol (MCP) on AWS.
- 에이전트가 세션 간에 컨텍스트를 유지하는 방법을 알아보려면 Amazon Bedrock AgentCore Memory: Building context-aware agents.
- Amazon Bedrock AgentCore 기능에 대한 자세한 내용은 Amazon Bedrock AgentCore documentation.
문서 처리 솔루션 구축에 대한 전문가의 지침이 필요하시면, AWS Professional Services 및 AWS Partners 에서 도움을 받을 수 있습니다.