
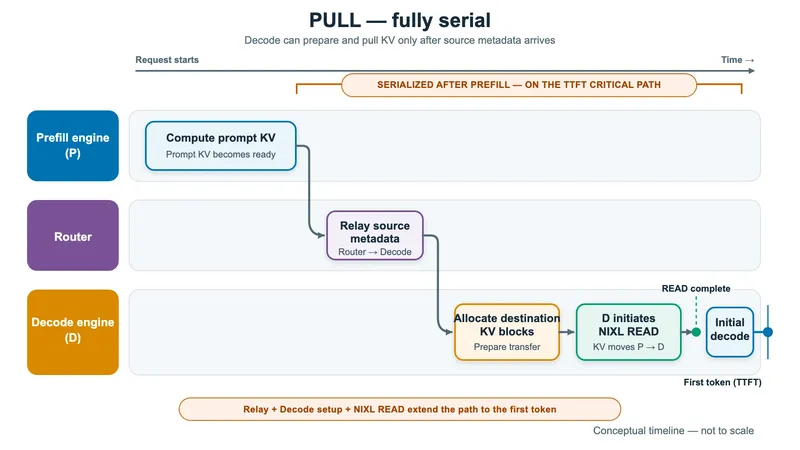
vLLM 은(는) 대규모 언어 모델(LLM)을 위한 오픈 소스 추론 및 서빙 엔진입니다. LLM 추론에는 두 가지 뚜렷한 단계가 있습니다: 입력 프롬프트를 처리하고 키-값(KV) 캐시를 구축하는 프리필과, 해당 캐시를 사용해 한 번에 한 토큰씩 출력을 생성하는 디코드입니다. 이 단계들은 서로 다른 연산, 메모리, 확장 특성을 가집니다. 프리필-디코드(P-D) 분리(disaggregation) 는 이 두 단계를 별도의 엔진 인스턴스에서 실행하여 각 단계가 독립적으로 확장되고 최적화될 수 있게 합니다. 이는 부하 상태에서 자원 활용도, 처리량, 지연 시간을 개선할 수 있습니다. 그러나 토큰 생성을 시작하기 전에 프리필 인스턴스에서 디코드 인스턴스로 KV 캐시를 전송해야 하므로, 효율적인 KV 전송이 첫 토큰까지의 시간(time-to-first-token, TTFT)에 매우 중요합니다.
vLLM이 이 전송을 수행하는 방법 중 하나는 NVIDIA Inference Xfer Library (NIXL) 커넥터를 사용하는 것으로, 이는 AWS Elastic Fabric Adapter(AWS EFA(AWS에서 서버 간에 사용되는 저지연 RDMA 네트워크))와 같은 RDMA 지원 상호연결을 통해 KV 블록을 이동시킵니다. 지원 인스턴스 유형에서 AWS EFA는 GPUDirect RDMA와 Neuron Direct RDMA를 지원하여, NIXL이 호스트 메모리를 거치지 않고 GPU 또는 Trainium 장치 메모리 간에 KV 블록을 직접 전송할 수 있게 합니다. NIXL 커넥터의 기본 모드는 풀 기반(pull-based)입니다: 프리필 인스턴스가 프롬프트 KV 캐시 연산을 마치면, 라우터가 프리필 블록 ID를 포함한 소스 메타데이터를 디코드 인스턴스로 전달합니다. 그런 다음 디코드 인스턴스가 대상 블록을 할당하고, NIXL 전송을 준비하며, NIXL READ를 시작하여 프리필 인스턴스에서 KV 블록을 가져옵니다. 이러한 조정 및 설정 단계는 프리필 이후와 디코드 시작 전에 순차적으로 발생하기 때문에, 다음 타임라인에서 보듯이 TTFT 임계 경로를 연장합니다.
이 게시물에서는 프리필 이후의 전송 조정 및 설정을 임계 경로에서 벗어나게 하는 푸시 기반 NIXL 커넥터를 소개합니다. vLLM으로 분리된 프리필/디코드 추론을 실행하는 고객의 경우, 이를 통해 TTFT와 TPOT을 줄여 애플리케이션 응답성을 개선할 수 있으며, 특히 높은 요청률에서 그렇습니다.
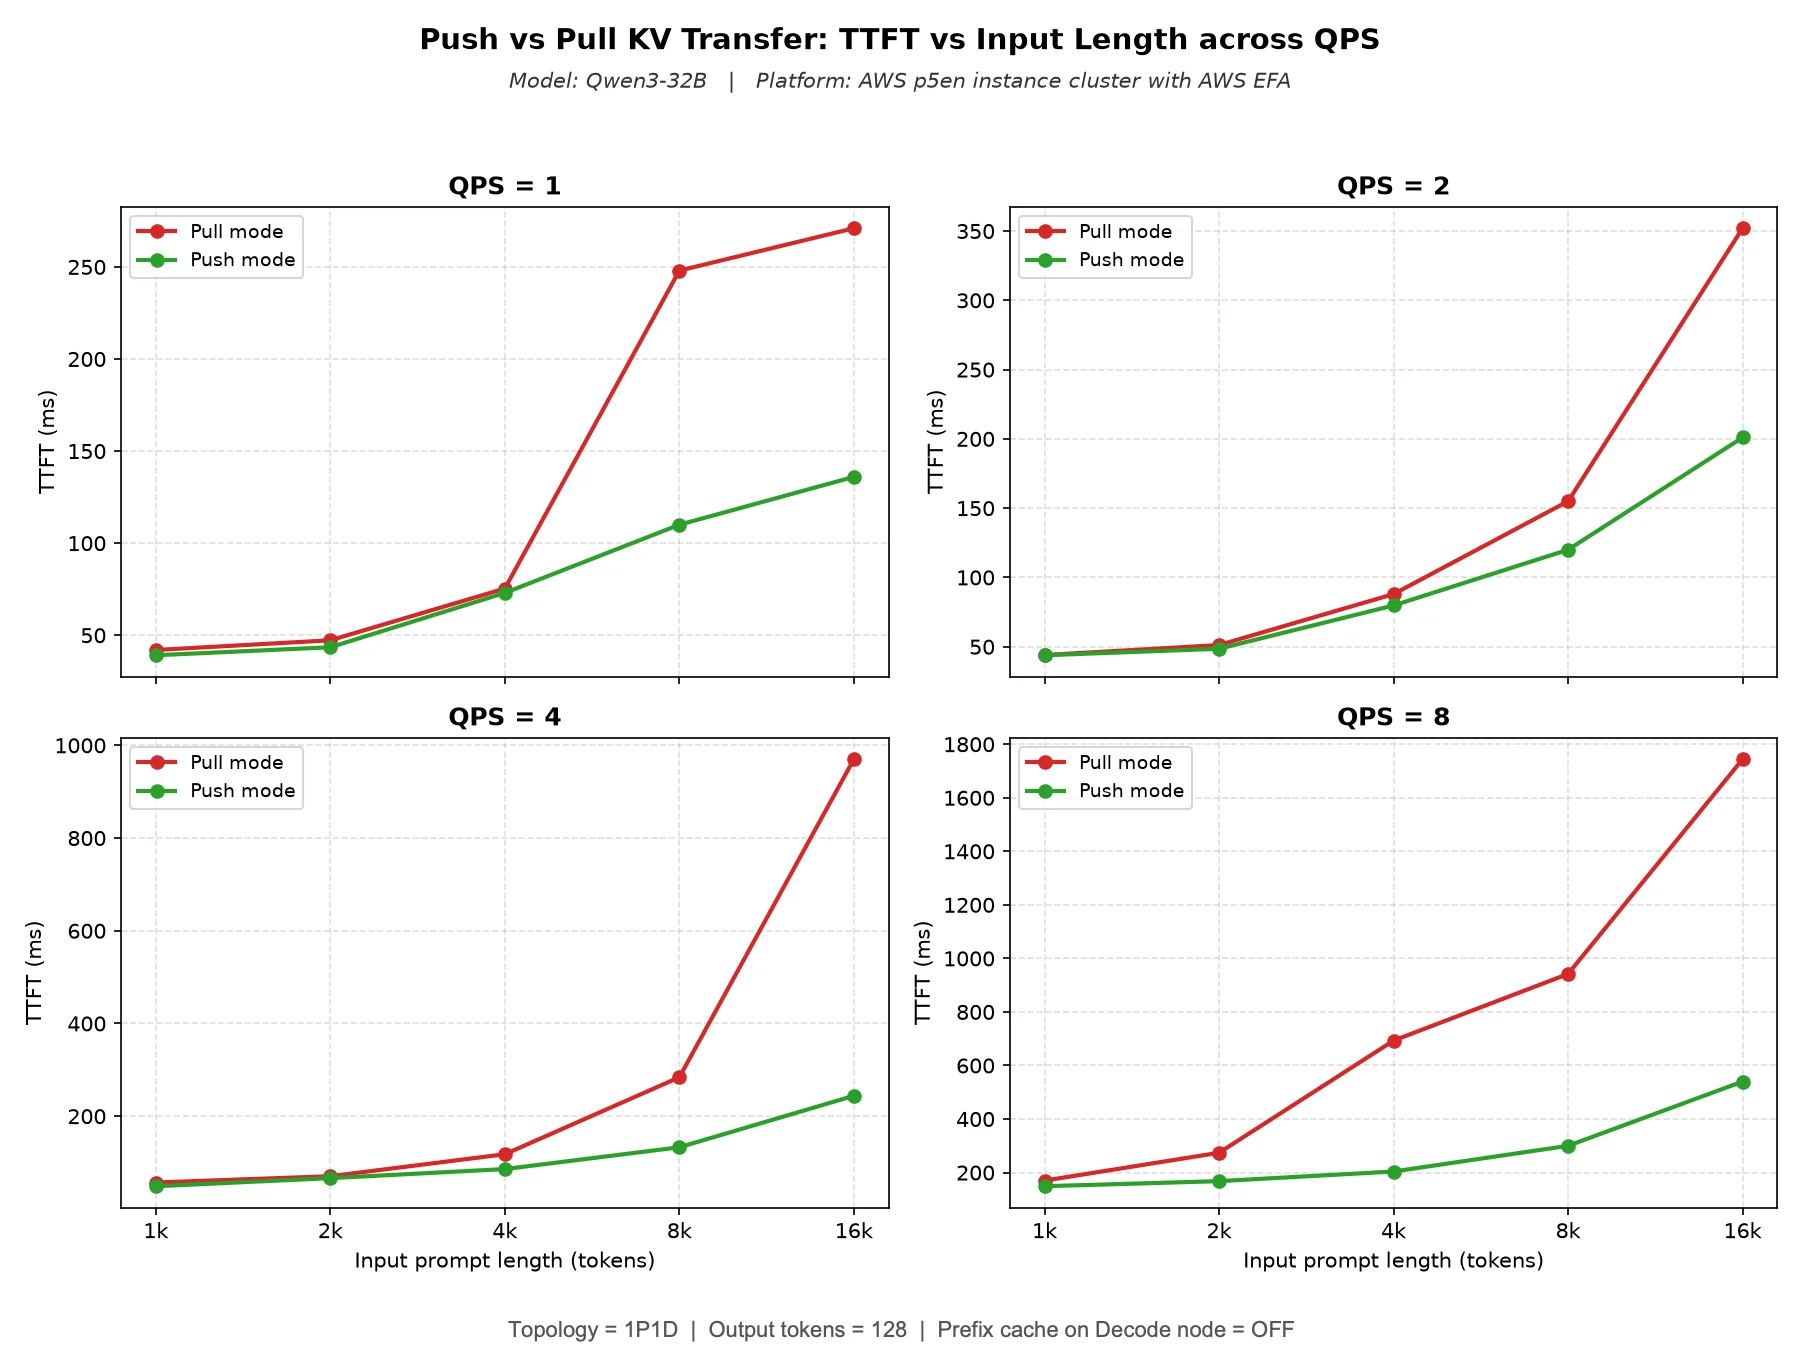
EFA로 연결된 Amazon EC2 P5en 인스턴스를 사용한 1P1D 배포에서의 벤치마크에서, 푸시 모드는 풀 모드에 비해 Qwen3-32B 모델에 대해 최대 3배 더 나은 TTFT와 최대 30% 더 나은 토큰당 출력 시간(TPOT)을 제공했습니다( 성능 데이터 Qwen3-32B 모델의 섹션) 참조; 결과는 워크로드와 구성에 따라 달라집니다.
우리는 EFA로 연결된 AWS Trainium 인스턴스 클러스터에서 이 기능을 구축하고 검증한 후, 가속기에 구애받지 않는 기능으로 vLLM에 기여했습니다. 여기의 결과는 EFA를 갖춘 AWS p5en(GPU) 클러스터에서 얻은 것으로, 이러한 개선이 GPU로도 이어짐을 보여줍니다. 이 게시물에서는 푸시 기반 아키텍처, 전송 흐름, 스레딩 모델, 성능 결과, 그리고 벤치마크 재현 방법을 설명합니다.
푸시 기반 KV 전송
아키텍처 개요
푸시 기반 전송은 두 가지 이유로 TTFT와 디코드 처리량을 개선합니다:
- 생산자와 소비자 작업을 겹쳐 실행함으로써 풀 모델의 직렬화를 제거합니다. 디코드 인스턴스는 생산자가 아직 KV를 연산하는 동안 대상 블록을 미리 등록합니다. 그런 다음 전송은 소비자 측 식별자 검색 왕복을 기다리지 않고, 생산자의 블록이 준비되는 즉시 시작되어, 그 왕복을 첫 토큰까지의 경로에서 제거합니다.
- 전송 설정 시간을 디코드 인스턴스에서 벗어나게 합니다. 그 설정 — NIXL 디스크립터 준비 및 전송 제출 — 는 프리필 측과 백그라운드 스레드에서 실행되므로, 디코드 인스턴스는 지연에 민감한 토큰 생성 단계 동안 그 주기를 소비하지 않습니다.
그 결과 디코드 인스턴스에서 TTFT가 낮아지고 출력 토큰 처리량이 높아집니다.
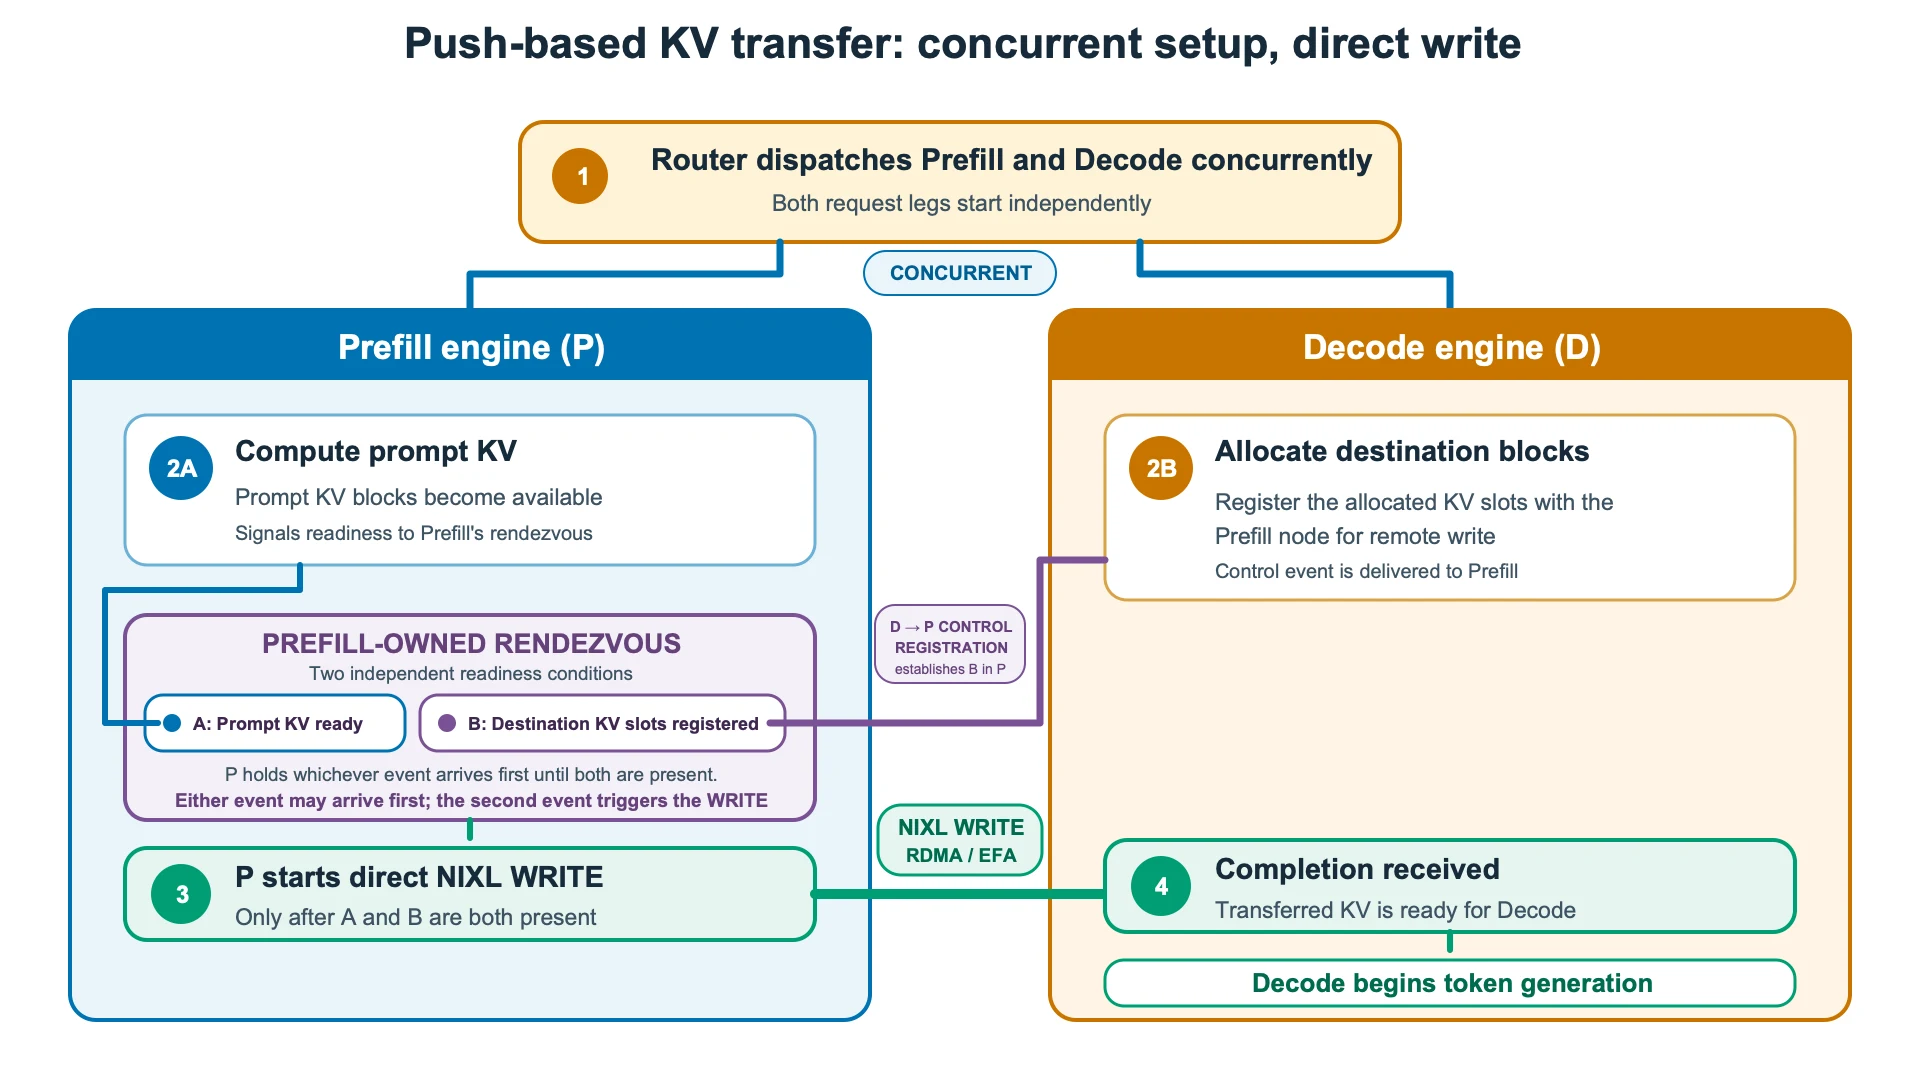
푸시 커넥터는 세 가지 주체를 조율합니다: 대상 블록을 미리 등록하는 디코드 인스턴스, 각 요청을 매칭하고 전송을 발생시키는 프리필 인스턴스, 그리고 KV 쓰기를 엔진의 포워드 패스 루프 밖으로 옮기는 전용 백그라운드 스레드입니다. 다음 다이어그램은 이 구성 요소들이 어떻게 맞물리는지 보여줍니다.
구현 세부 사항
이 프로토콜은 세 가지 논리적 단계로 이루어집니다.
1. 등록(디코드 측). remote prefilling이 필요한 요청을 위해 decode 인스턴스가 로컬 블록을 할당할 때, prefill 인스턴스가 KV를 어디에 기록해야 하는지를 설명하는 등록 정보를 준비합니다. 여기에는 자신의 식별 정보와 방금 예약한 블록 위치가 포함됩니다. 동일한 엔진 스텝 내에서 워커는 이 등록 정보를 NIXL 알림 형태로 prefill 인스턴스에 전송합니다. 등록이 할당 시점에 이루어지기 때문에 커넥터는 prefill 인스턴스가 prefill을 완료하기 전에 대상 블록을 알 수 있습니다.
2. Rendezvous (프리필 측). 디코더의 등록과 프로듀서에서의 프리필 완료는 어느 쪽이든 먼저 도착할 수 있으며, 커넥터는 두 경우 모두를 처리합니다. 등록이 먼저 도착하면 프로듀서는 자신의 프리필이 끝날 때까지 이를 보유합니다. 프리필이 먼저 끝나면 프로듀서는 등록이 도착할 때까지 해당 요청의 블록들을 보유합니다. 두 번째로 발생하는 이벤트가 전송을 트리거합니다. 커넥터는 식별자로 요청을 짝지으며, 이 매칭은 재발행된 요청을 고려하여 선점되거나 재시도된 요청을 올바르게 연관시킵니다.
3. 전송(프리필 측). 요청이 매칭되면 프로듀서는 디코드 인스턴스에 연결을 설정하고(아직 존재하지 않는 경우) NIXL WRITE를 발행하여 KV 블록을 디코더의 등록된 메모리로 각 대상 텐서 병렬 랭크별로 직접 복사합니다. 프로듀서와 컨슈머는 서로 다른 내부 블록 레이아웃을 사용할 수 있습니다. 각 측은 전송 시점에 블록 위치를 자신의 물리적 레이아웃에 매핑하므로, 양쪽에서 서로 다른 블록 크기를 사용할 수 있습니다. 각 WRITE에는 완료 알림이 포함되어 있으며, NIXL이 데이터가 도착하면 디코드 인스턴스에 이를 전달합니다. 디코더는 이러한 알림(자신에게 쓰기를 수행하는 프로듀서 랭크당 하나씩)을 계수하고, 예상된 모든 알림이 도착한 후에야 KV를 수신된 것으로 처리하며, 그 시점에 요청은 디코드 단계로 진행됩니다.
스레딩 모델
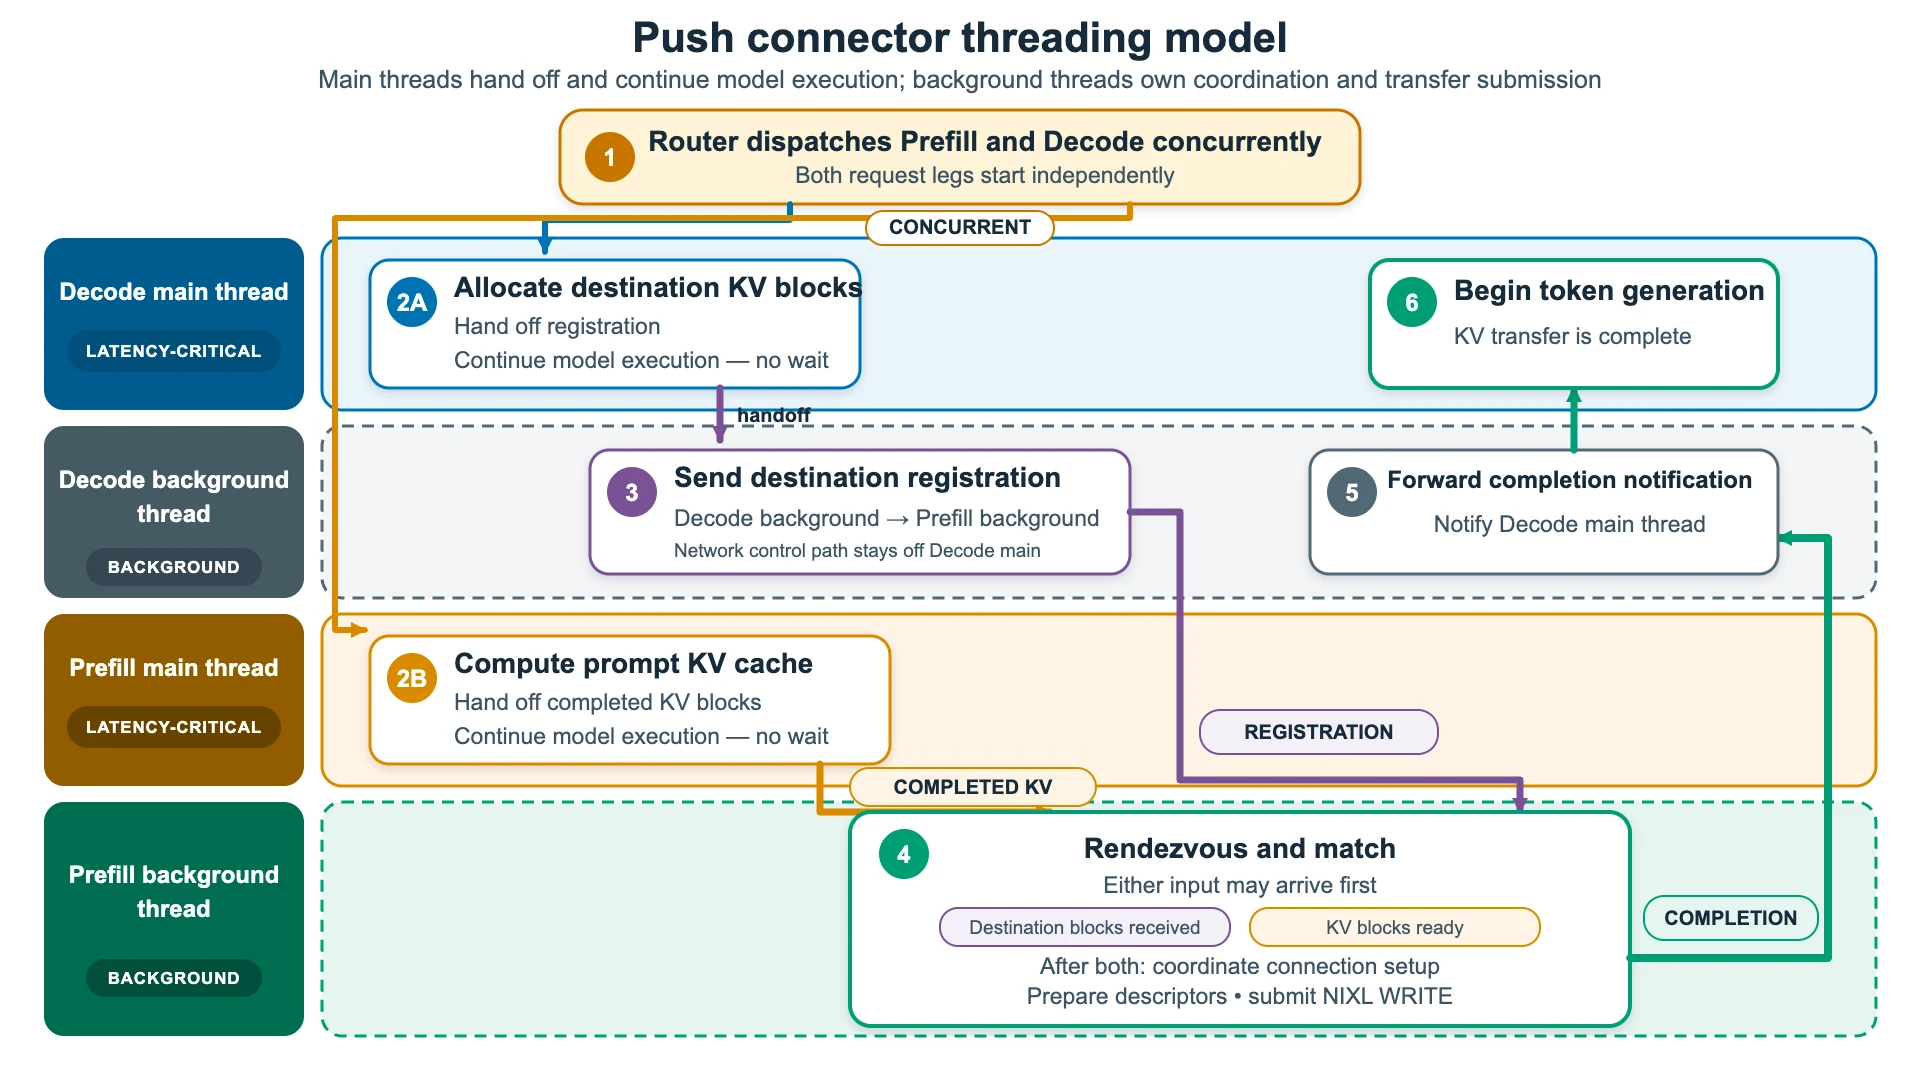
push 커넥터는 각 프리필 워커에서 전용 백그라운드 전송 스레드를 사용하여 모델 실행과 KV 전송 준비를 분리합니다. 요청이 시작되면 디코드 메인 루프는 대상 KV 블록을 할당하고 프리필 인스턴스에 등록하는 반면, 프리필 메인 루프는 프롬프트 KV 캐시를 계산합니다. 대상 등록과 프롬프트 KV가 모두 준비되면 프리필 메인 루프는 KV 블록을 백그라운드 스레드에 넘기고 신속히 모델 실행으로 복귀합니다.
백그라운드 스레드는 NIXL 연결을 설정하거나 재사용하고, 요청의 KV 블록 ID를 메모리 디스크립터로 매핑하며, 연속된 블록을 더 큰 전송 영역으로 병합한 후, NIXL WRITE를 디코드 인스턴스에 제출합니다. NIXL이 전송을 완료하면 디코드 인스턴스에 완료 알림을 보내고, 이어서 해당 인스턴스가 토큰 생성을 시작합니다. 디스크립터 준비와 전송 제출을 지연에 민감한 메인 루프 외부에서 처리함으로써, 이러한 요청별 작업이 모델 실행을 지연시키지 않도록 합니다. 다음 다이어그램은 단일 요청에 대해 메인 루프와 백그라운드 스레드 간의 이러한 처리 인계 과정을 보여줍니다.
타이밍 비교: 풀(Pull) 대 푸시(Push)
다음 다이어그램은 앞 섹션에서 설명한 풀(pull) 및 푸시(push) 전송 흐름을 요약하고 TTFT에 미치는 영향을 강조합니다. 두 모드 모두 동일한 NIXL 및 EFA/RDMA 데이터 경로를 사용하지만, 풀 방식은 프리필(prefill) 이후에 메타데이터 릴레이와 디코드 측 설정을 수행하는 반면, 푸시 방식은 디코드 측 설정을 프리필과 겹쳐 수행합니다. 그 결과 푸시 방식은 프리필 이후의 주요 경로에서 이러한 작업을 제거하여 디코딩을 더 일찍 시작할 수 있게 합니다.
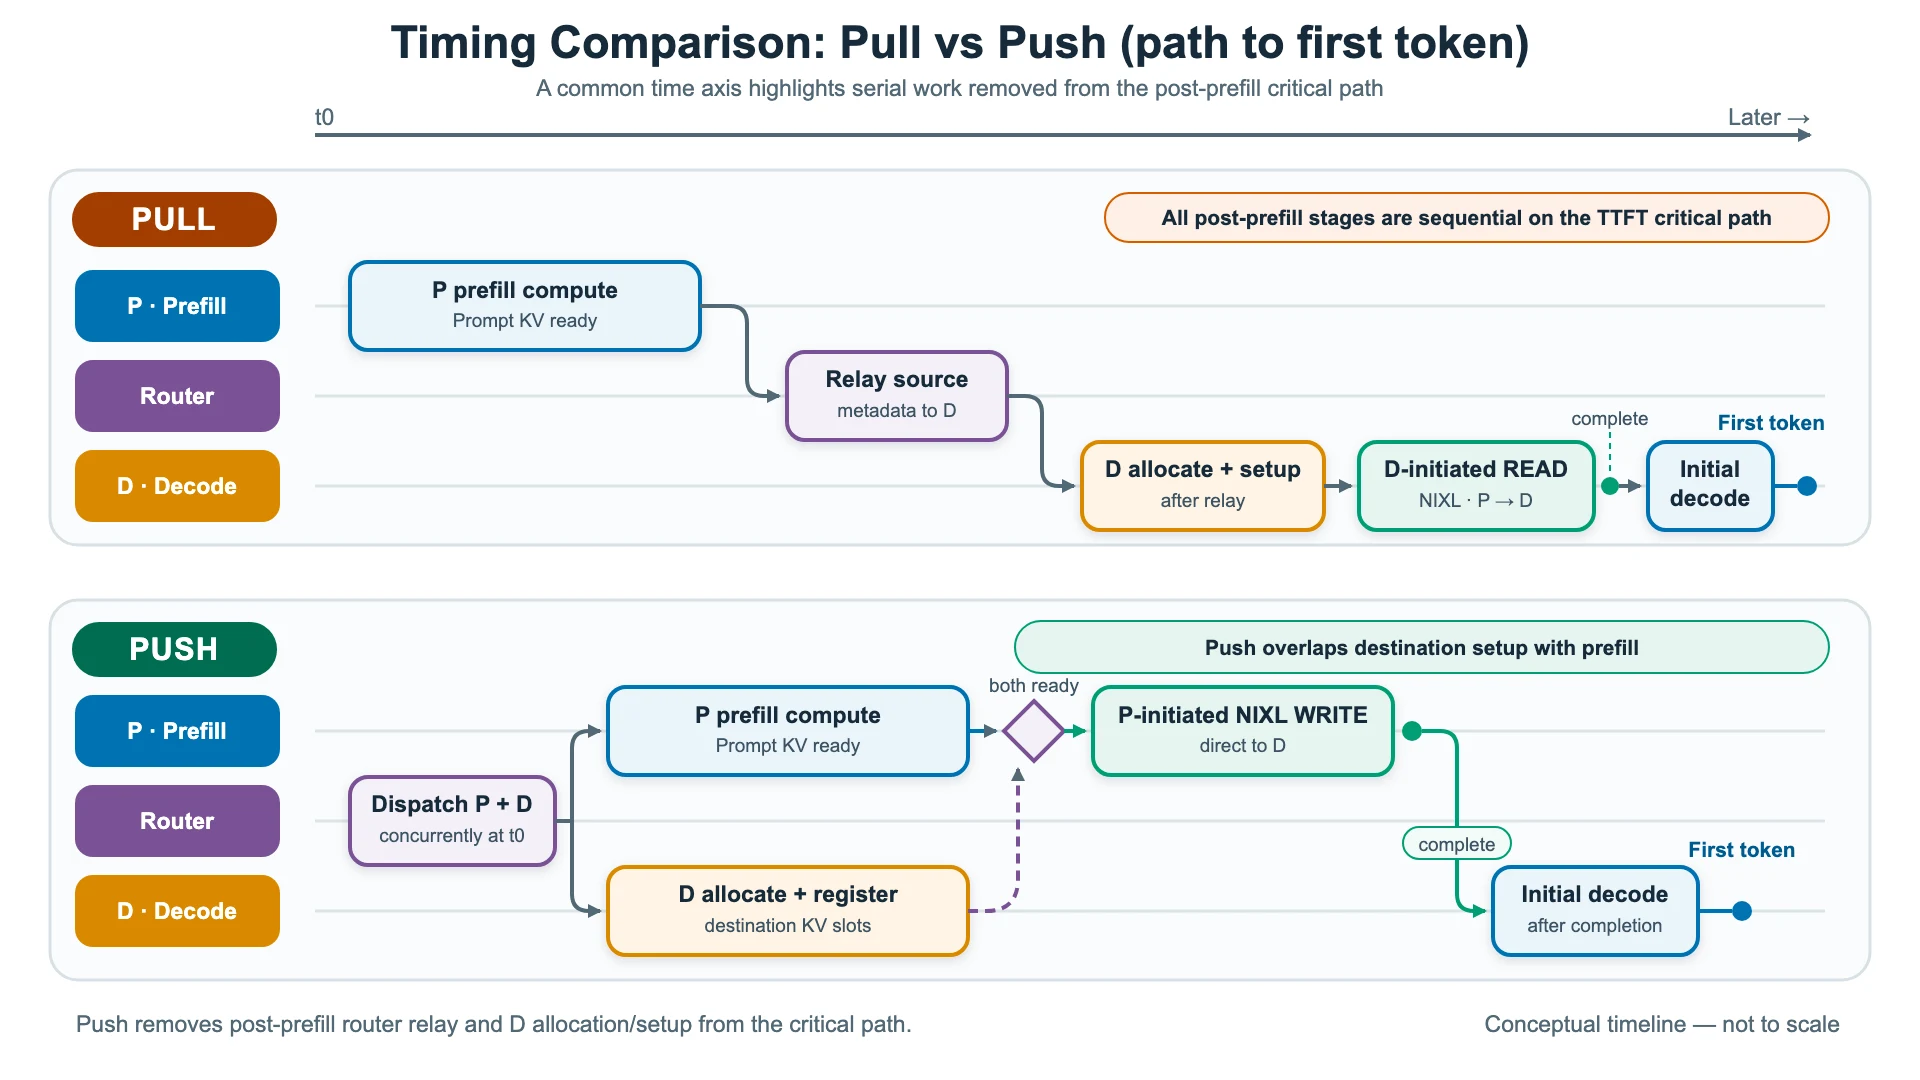
두 가지 모드는 라우팅 트레이드오프와도 관련이 있습니다. Pull 모드는 프리필이 완료된 후 라우터가 디코드 인스턴스를 선택할 수 있도록 하여, 부하 인식 라우팅 및 서비스 품질 관리 측면에서 더 큰 유연성을 제공합니다. Push 모드는 대상 측 설정이 프리필과 겹쳐 수행될 수 있도록 디코드 인스턴스를 더 일찍 선택합니다. 그 대가로, 비슷한 부하 조건에서 프리필 인스턴스는 프롬프트 KV와 대상 등록이 모두 준비되는 즉시 전송이 시작되기 때문에 KV 블록을 더 빨리 해제할 수 있습니다.
성능 데이터
평가를 위해 Amazon EC2 P5en 인스턴스를 EFA로 연결한 1P1D 배포 환경에서 Qwen3-32B 모델을 사용했습니다. P→D 전송 성능을 분리하기 위해 벤치마크가 다음과 같이 prefix caching을 비활성화하도록 구성했습니다. --no-enable-prefix-caching이 구성은 디코드 노드가 모든 요청에 대해 프리필 노드에서 전체 KV 캐시를 검색하도록 만듭니다. 그렇지 않으면 겹치는 프롬프트가 디코드 노드의 로컬 캐시를 재사용하여 전송을 우회할 수 있고, 이는 오해를 불러일 일하는 비교 결과를 낳을 것입니다.
다음 차트는 푸시(push) 및 풀(pull) KV 전송에 대한 TTFT를 비교합니다. 입력 길이 1k–16k와 요청 속도 1–8 QPS를 스윕했습니다. 낮은 부하와 짧은 프롬프트에서는 두 모드가 거의 동일하게 수행됩니다. QPS와 입력 길이가 증가하면 풀 모드는 급격히 저하되어 8 QPS 및 16k에서 약 1,744 ms에 도달합니다. 푸시 모드는 약 540 ms로 훨씬 낮게 유지되며, 이는 약 3배 감소에 해당합니다. 이 격차가 벌어지는 이유는 풀 모드가 NIXL 디스크립터를 디코드 워커에 인라인으로, 엔진 루프 내에서 동기적으로 게시하기 때문에 해당 작업이 토큰 생성을 정체시키기 때문입니다. 푸시 모드는 이를 백그라운드 스레드로 옮겨 주요 경로에서 벗어나게 합니다.
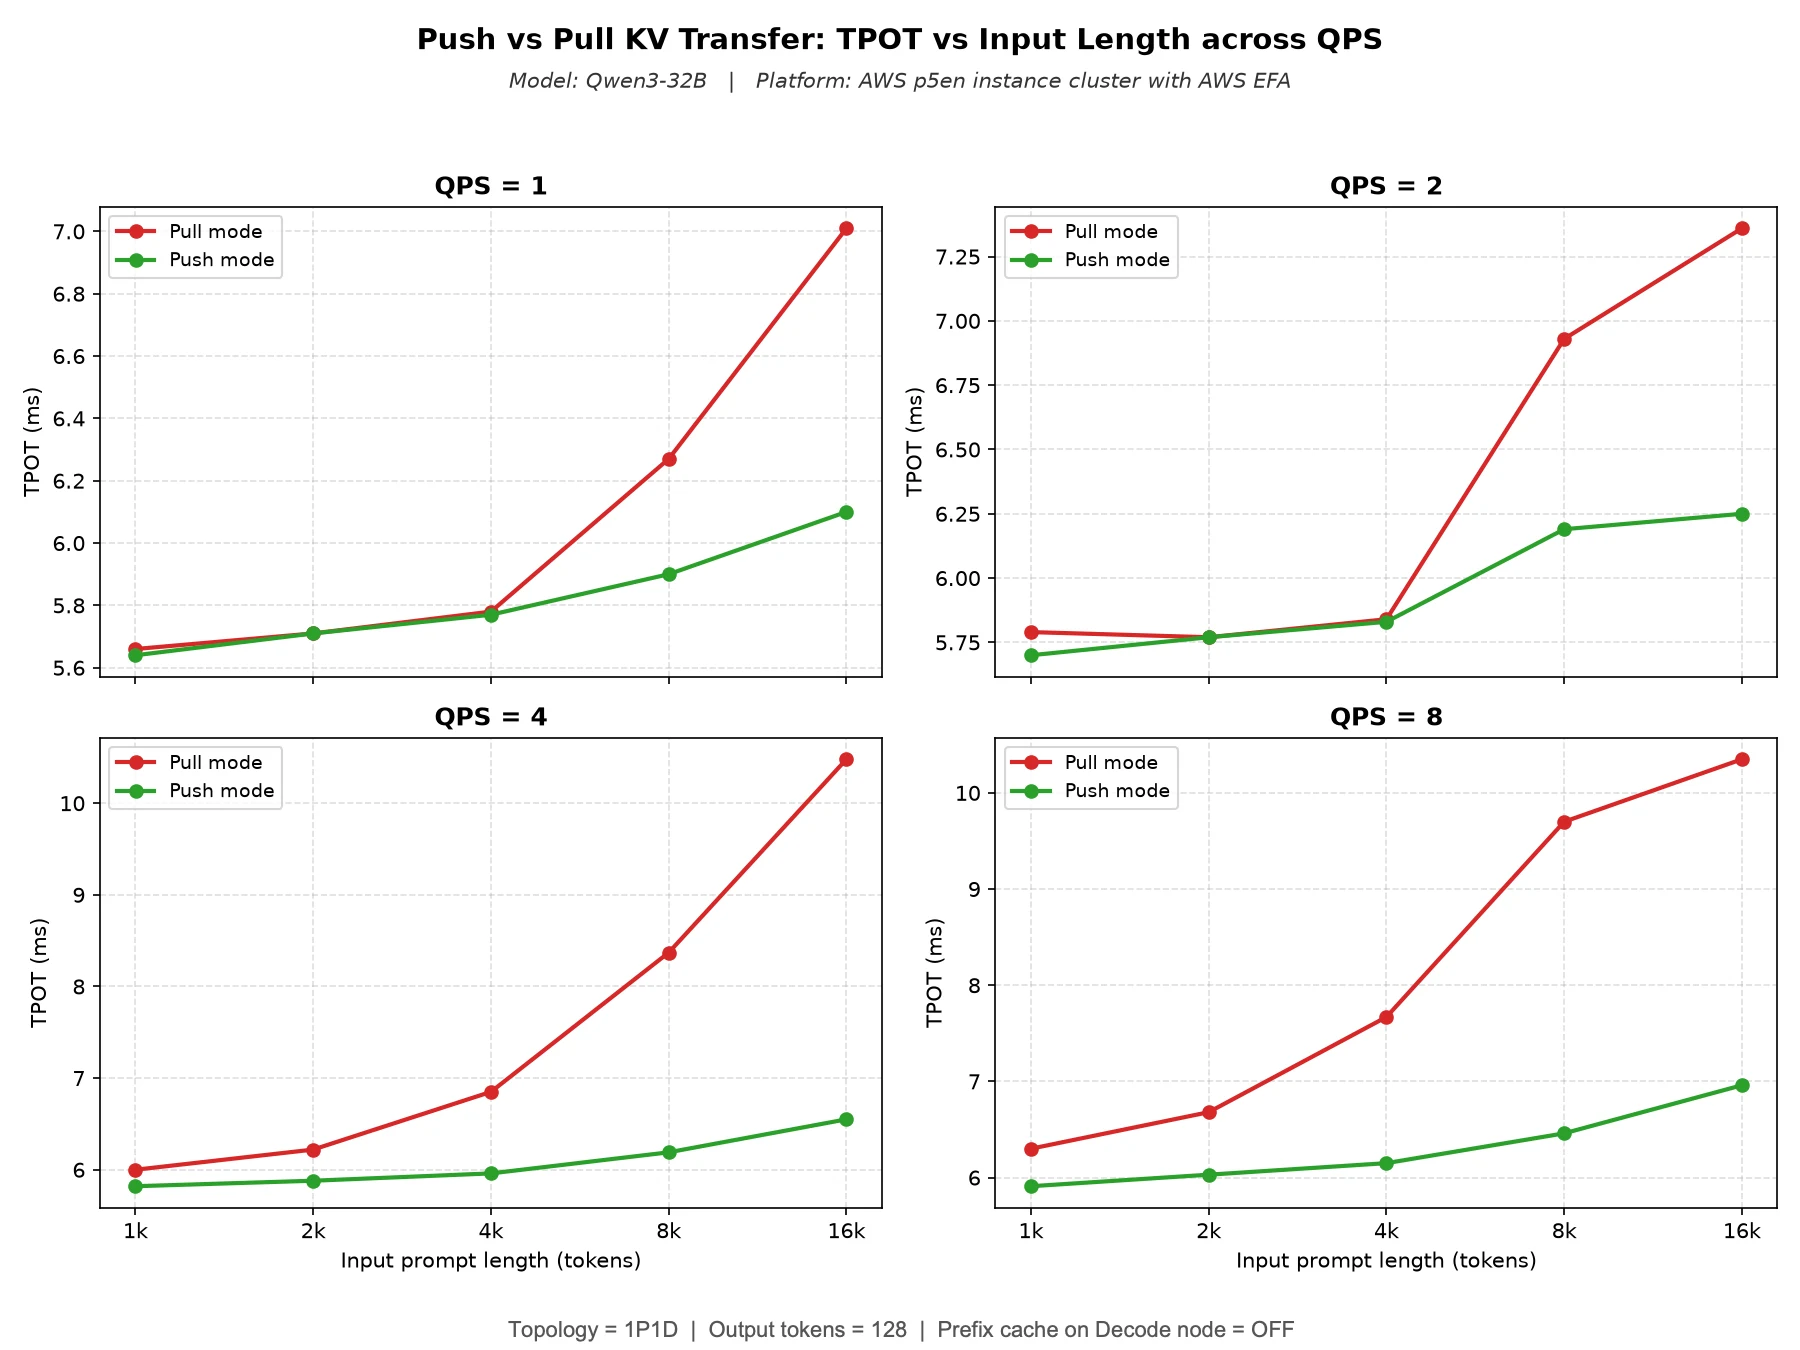
이 차트는 동일한 조건에서의 TPOT를 보여줍니다. 패턴은 TTFT와 같은 양상을 보입니다. 부하가 낮을 때는 push와 pull이 5.6–5.8 ms 정도로 근접합니다. 부하와 입력 길이가 증가하면 pull은 4–8 QPS 및 16k에서 약 10.4 ms까지 상승하는 반면, push는 약 7 ms 근처를 유지합니다. 그 이유는 push가 디스크립터 준비와 전송 제출을 디코드 워커로부터 오프로드하기 때문입니다. 토큰 생성이 결코 부족해지지 않으므로, 높은 동시성과 긴 컨텍스트에서도 토큰당 지연 시간은 일정하게 유지됩니다.
벤치마크 실행 방법
EFA로 연결된 Amazon EC2 P5en 인스턴스를 사용하여 1개의 프리필 노드와 1개의 디코드 노드로 구성된 1P1D 벤치마크 구성을 재현하려면 결과 재현 가이드의 자세한 지침을 참조하십시오. 이 가이드는 환경 설정, vLLM 프리필 및 디코드 서버 시작, 벤치마크 실행, 결과 수집 방법을 다룹니다. 이 기능은 다른 지원되는 구성에서도 실행할 수 있지만, 성능 결과는 하드웨어, 모델, 워크로드 및 네트워크 구성에 따라 달라집니다.
결론
이 게시물에서는 push 기반 KV 커넥터가 프리필 연산을 디코드 측 블록 할당 및 등록과 겹치게 하여, 프리필 이후 라우터 왕복과 디코드 측 전송 설정을 주요 경로에서 제거하는 방법을 보여주었습니다. 이를 통해 TTFT와 TPOT, 특히 높은 요청 비율에서의 TPOT가 감소합니다. EFA로 연결된 Amazon EC2 P5en 인스턴스를 사용하는 1P1D 배포에서 Qwen3-32B 벤치마크를 수행한 결과, push 모드는 pull 모드에 비해 TTFT가 최대 3배, TPOT가 30% 향상되었습니다. 결과는 워크로드와 구성에 따라 달라집니다. push 모드를 사용하려면 프리필 서버와 디코드 서버 모두에서 NixlPushConnector 대신 NixlConnector.
을(를) 사용하도록 구성하십시오. 디코드 노드를 조기에 선택하는 것이 허용되고 더 낮은 TTFT가 우선순위인 경우 push 기반 커넥터를 선택하십시오. 양방향 KV 전송이 필요하거나 로드 인식 라우팅을 위해 디코드 인스턴스 선택을 프리필 이후로 미루는 워크로드에는 pull 기반 커넥터가 여전히 더 적합합니다. vLLM은 push 기반 및 pull 기반 KV 커넥터를 모두 지원하므로 사용자는 자신의 배포에 가장 적합한 방식을 선택할 수 있습니다.
향후 개선 과제로, 우리는 백그라운드 NIXL 스레딩 모델을 pull 모드 커넥터에 도입하여 NIXL 설정을 주요 경로에서 분리함으로써 pull 모드 워크로드도 동일한 최적화의 이점을 누릴 수 있도록 하는 방안을 연구하고 있습니다. 이를 탐색하기 위해 풀 리퀘스트(#45211)를 열었습니다.
관련 리소스
감사의 글
이 기능의 유지 보수에 도움을 준 vLLM 커뮤니티에 감사드립니다.
부록: 결과 재현
토폴로지는 EFA가 활성화된 두 개의 p5en GPU 노드(프리필은 :8100에서, 디코드는 :8200에서)와, 프록시 및 벤치마크 클라이언트를 실행하는 세 번째 소규모 노드로 구성됩니다. 이 게시물에는 세 개의 스크립트가 포함되어 있습니다: serve_pd.sh 은 어느 모드에서든 어느 쪽이든 시작하고, run_sweep.sh 은 스윕을 수행하며, cleanup.sh 은 모든 것을 정리합니다. plot_push_vs_pull.py 은 위의 두 그림을 결과 JSON으로부터 다시 그립니다.
테스트 환경
두 GPU 노드는 동일하게 구성되었습니다:
| 인스턴스 유형 | p5en.48xlarge (8x NVIDIA H200), 하나는 프리필용, 하나는 디코드용 |
| 리전 / 가용 영역 | ap-south-1 (뭄바이), ap-south-1b (AZ ID aps1-az3), 동일 AZ 내 두 노드 |
| 배치 | 클러스터 배치 그룹 없음; 두 인스턴스 모두 지정된 On-Demand Capacity Reservation, 기본 테넌시로 시작됨 |
| AMI | Ubuntu 24.04 x86_64용 퍼블릭 AWS ParallelCluster 3.14.2 이미지, aws-parallelcluster-3.14.2-ubuntu-2404-lts-hvm-x86_64-202602121713 (ami-0133f195033a4baae in ap-south-1; AMI ID는 리전별로 다름). 이 이미지에는 kernel 6.14.0-1018-aws, NVIDIA 드라이버 570, CUDA 12.8이 포함되어 있으므로, 드라이버, CUDA 툴킷, EFA 설치 프로그램을 아래 버전으로 업그레이드하십시오. |
| OS / 커널 | Ubuntu 24.04.4 LTS, 6.14.0-1018-aws |
| NVIDIA 드라이버 / CUDA | 드라이버 580.126.16 (CUDA 13.0 드라이버 API); CUDA 툴킷 13.0 |
| EFA 인터페이스 | 인스턴스당 16개, 네트워크 카드당 하나씩 (카드 0-15, 모든 인터페이스 유형 efa), 각 200 Gb/s로 총 3.2 Tb/s. 8개의 인터페이스가 각 NUMA 노드에 위치하며, 각 GPU는 그중 2개와 PCIe 스위치를 공유합니다. |
| EFA 소프트웨어 | EFA 설치 프로그램 1.50.0, EFA 커널 모듈 3.3.0g, libfabric 2.6.0amzn1.0, rdma-core 64.0amzn0 |
NIXL에 의한 EFA 디바이스 선택. LIBFABRIC 백엔드는 16개의 EFA 장치를 모두 레일로 열며, efa provider. 이후 각 GPU의 KV 캐시를 해당 GPU의 PCIe 스위치를 공유하는 2개의 레일에만 등록하여 모든 전송이 PCIe 로컬로 유지됩니다. NIXL 또는 libfabric 디바이스 재정의는 설정되지 않았으며, 이것이 기본 선택입니다. 자신의 노드에서 이를 확인하려면 다음과 같이 서버를 실행하십시오. NIXL_LOG_LEVEL=DEBUG 그리고 등록 라인을 확인하십시오:
grep -E "Created rail [0-9]+ \(device=|mapped to rail" server.log1. 노드 프로비저닝
두 GPU 노드에 EFA 사용자 공간 스택을 설치하고 프로바이더가 존재하는지 확인합니다. 우리는 installer를 사용했습니다 1.50.0:
curl -O https://efa-installer.amazonaws.com/aws-efa-installer-1.50.0.tar.gz
tar -xf aws-efa-installer-1.50.0.tar.gz && cd aws-efa-installer
sudo ./efa_installer.sh -y
fi_info --version         # libfabric 2.6.0amzn1.0
fi_info -p efa            # verify the EFA provider is present
두 GPU 노드는 다음에서 서로 통신할 수 있어야 합니다. 8100/8200 그리고 NIXL 사이드 채널에서는(5600).
2. vLLM과 NIXL 설치
양쪽 GPU 노드에서:
python3.12 -m venv ~/vllm_env && source ~/vllm_env/bin/activate
pip install --upgrade pip
pip install vllm==0.29.0      # any build that includes the NIXL push connector
pip install nixl==1.4.1       # NIXL with the libfabric/EFA backend
프록시 노드에서 (GPU 런타임이 필요하지 않음):
pip install vllm aiohttp fastapi uvicorn pandas datasets3. 모델 다운로드
export HF_HOME=/shared/huggingface     # a large shared volume
hf download Qwen/Qwen3-32B
4. P/D 쌍 실행
실행 serve_pd.sh GPU 노드당 한 번씩. 두 모드 간의 유일한 차이점은 kv_connector: NixlConnector 풀(pull)을 위한, NixlPushConnector "for push. 포트, 엔진 ID, 역할, 랭크는 동일하게 유지됩니다." — 문맥상 앞 문장의 일부이므로: 푸시를 위한 것입니다. 포트, 엔진 ID, 역할, 랭크는 동일하게 유지됩니다.
# on the prefill node
PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> ROLE=prefill MODE=pull ./serve_pd.sh
# on the decode node
PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> ROLE=decode  MODE=pull ./serve_pd.sh
프리필(prefill) 쪽에서는 다음과 같이 확장됩니다:
vllm serve Qwen/Qwen3-32B --served-model-name Qwen --dtype bfloat16 \
  --tensor-parallel-size 8 --max-model-len 32768 --max-num-seqs 8 --port 8100 \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_buffer_device":"cuda",
    "kv_role":"kv_producer","engine_id":"prefill-engine-001","kv_rank":0,
    "kv_parallel_size":2,"kv_connector_extra_config":{"backends":["LIBFABRIC"]}}'
디코드 서버는 다음을 추가합니다 --no-enable-prefix-caching이는 모든 요청이 사전 채우기 단계에서 전체 KV를 가져오도록 강제하는데, 이는 바로 우리가 측정하려는 바입니다. 캐싱이 켜져 있으면 겹치는 프롬프트들이 디코드 노드의 로컬 캐시를 적중하여 P->D 전송을 건너뛰게 되어, 오해를 일으키는 수치가 나올 수 있습니다. 두 가지 모두 기다리십시오 /health 벤치마크를 수행하기 전에 엔드포인트가 200을 반환하도록 하십시오.
5. 스윕 실행
벤치마크 스크립트는 다음 위치에 있습니다 #57567; 모드와 일치하는 프록시를 선택합니다(disagg_proxy_demo.py 풀(pull)의 경우, disagg_proxy_pushconnector_demo.py 푸시용)으로 사용하며 이를 다음으로 구동합니다: vllm bench serve.
git clone https://github.com/vllm-project/vllm.git ~/vllm && cd ~/vllm
git fetch origin pull/57567/head:pd-bench && git checkout pd-bench
export VLLM_SRC=~/vllm

VLLM_SRC=~/vllm PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> \
  MODE=pull ./run_sweep.sh
그런 다음 두 서버를 모두 중지하고, 4단계를 다음과 함께 다시 실행하세요 MODE=push 각 노드에서 스윕을 다시 실행합니다( MODE=push. 푸시 모드는 추가로 프리필 인스턴스의 NIXL 좌표(PREFILL_ENGINE_ID, PREFILL_KV_HOST, PREFILL_SIDE_CHANNEL_PORT, PREFILL_TP_SIZE, PREFILL_PP_SIZE") 그래야 프록시가 디코드 노드에 어디에 등록할지 알려줄 수 있습니다; run_sweep.sh 위에서 사용한 기본값으로 이를 채웁니다. Keep QPS_LIST, INPUT_LENS, 그리고 OUTPUT_LENS 두 실행 간에 동일해야 하며, 다음이 PREFILL_TP_SIZE 프리필 서버의 실제 텐서 병렬 크기와 일치하는지 확인하십시오.
results/ 가 성립하고 <mode>_qps<q>_in<in>_out<out>_iter<i>.json (및 .log)인 경우, 실행별 TTFT, ITL, 처리량, 엔드투엔드 지연 시간이 함께 제공됩니다. 그림을 다시 그리려면:
python plot_push_vs_pull.py --results-dir ./results --metric ttft
python plot_push_vs_pull.py --results-dir ./results --metric tpot
문제 해결
- 첫 번째 요청 직후 서버가 크래시함 — 모드가 커넥터와 일치하지 않습니다. Pull은
NixlConnector이 필요하고; push는NixlPushConnector이 필요하며, P와 D 양쪽 모두에서 그렇습니다. Backend 404: model ... does not exist—SERVED_MODEL_NAME가 서버들의--served-model-name(Qwen).- 프록시 준비 상태 시간 초과 — 선택한 모드에 대한 프록시가
$VLLM_SRC/examples/disaggregated/disaggregated_serving/아래에 존재하는지, 그리고 P와 D 양쪽 모두가/health200을 반환하는지 확인하십시오. - NIXL 핸드셰이크 또는 전송 오류 — EFA(
fi_info -p efa)를 확인하고, 사이드 채널 포트(5600)가 P와 D 사이에서 열려 있는지 확인하며,PREFILL_TP_SIZE가 프리필 서버의 텐서 병렬 크기와 일치하는지 확인하십시오.
정리
./cleanup.sh proxy      # on the proxy / benchmark driver node
./cleanup.sh server     # on each GPU node
그런 다음 AWS EC2 사용 설명서에 따라 인스턴스를 종료하십시오.