
결정 모델들은 지식 및 추론 과제에서 보정(calibration)이 잘 되어 있지 않습니다. 선택된 답변의 거의 모든 확률 수준에서 정확도가 모든 결정 모델에 대해 해당 확률보다 낮게 떨어집니다. 이 격차는 AA-Omniscience-Decision과 HLE-MultiChoice에서 가장 크며, 대부분의 모델은 WildGuardTest(분류)와 When2Call(도구 호출)에서 비교적 잘 보정되어 있습니다
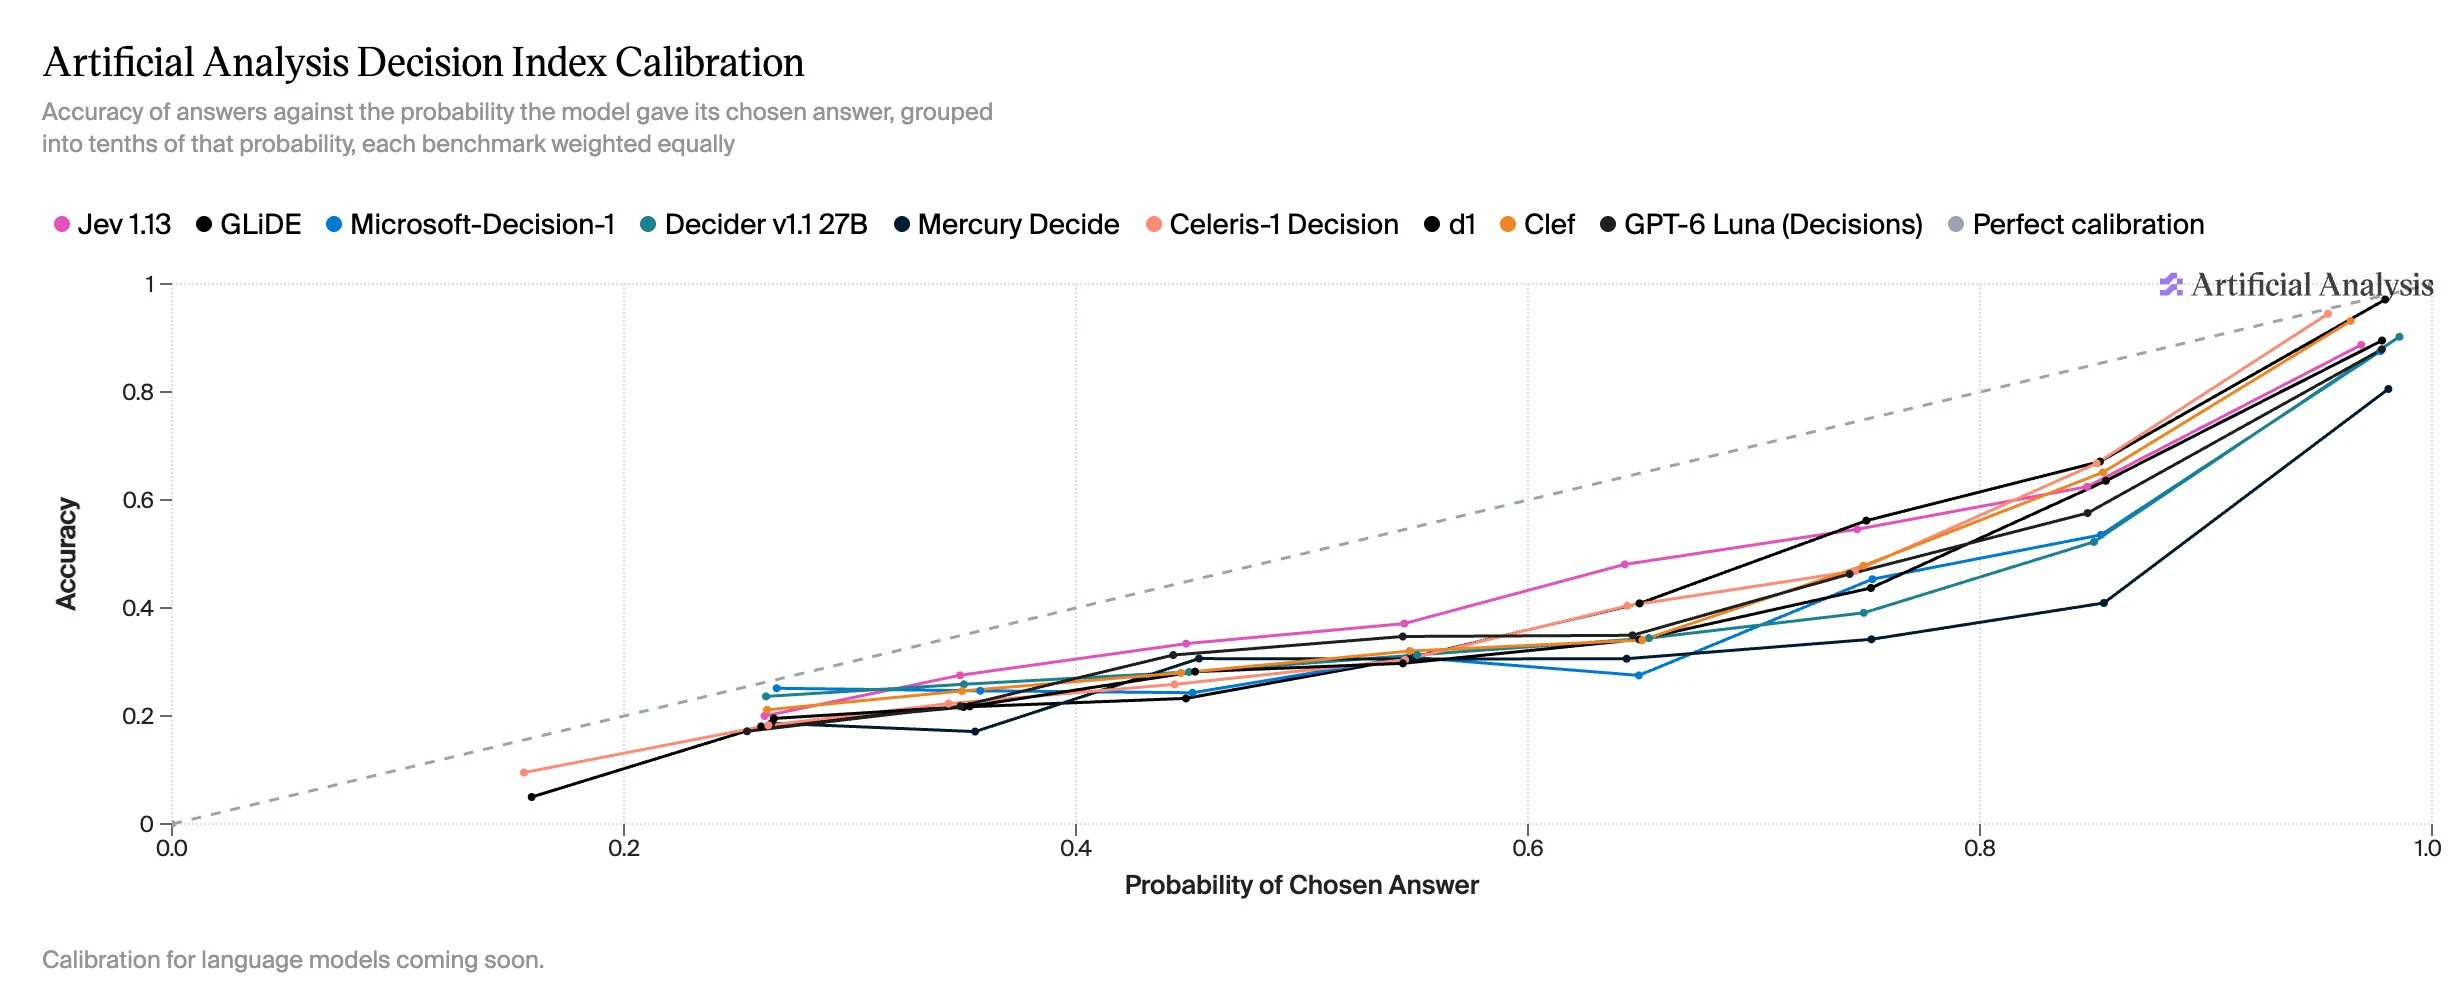
결정 모델들은 지식 및 추론 과제에서 보정(calibration)이 잘 되어 있지 않습니다. 선택된 답변의 거의 모든 확률 수준에서 정확도가 모든 결정 모델에 대해 해당 확률보다 낮게 떨어집니다. 이 격차는 AA-Omniscience-Decision과 HLE-MultiChoice에서 가장 크며, 대부분의 모델은 WildGuardTest(분류)와 When2Call(도구 호출)에서 비교적 잘 보정되어 있습니다
원문 발행 및 권리는 출처에 있습니다.
기계 번역 · 원문을 참고하세요