
Jay에서 발행된 와공비사의 양자위 | 공식 계정 QbitAI
아니, A\너가 다시 돌아왔어?
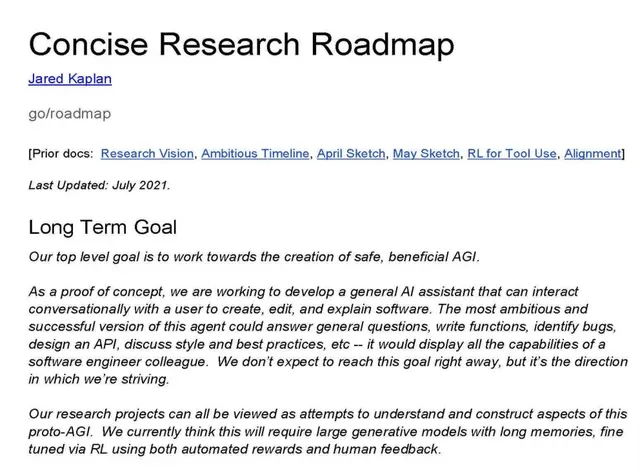
최근 저작권 소송과 관련하여, Anthropic의 2021년 7월 내부 연구 로드맵이 우연히 공개되었습니다.
매우 짧아서 PDF 본문은 두세 페이지에 불과합니다.
하지만 당시 '최고 기밀'이라고 표시된 그 문서를 처음부터 끝까지 읽고 나니 나는 기력이 바닥났다.
오늘의 클로드 코드, 도구 사용, AI 자기평가, 테스트 시간 컴퓨팅, 심지어 십억조 개의 파라미터와 매우 긴 컨텍스트까지……
5년 전, 이 회사는 OpenAI에서 독립한 지 몇 달 되어서 전체 인원이 10여 명에 불과했을 때, 이미 명확하게 기록된 내용이 있었습니다.
5년 전의 로드맵
많은 사람들은 대형 모델이 채팅 로봇에서 코드 작성 및 운영 체제의 에이전트로 발전한 것이, 지난 2년간 기술이 성숙해지면서 누구나 자연스럽게 이룬 결과라고 생각합니다.
틀렸습니다.
2021년 이 로드맵의 맨 처음에, Anthropic은 자사의 궁극적 목표(Safe, beneficial AGI)에 대해 매우 명확한 프로토타입을 제시했습니다.
자연어로 인간과 상호작용할 수 있으며, 소프트웨어를 생성, 편집 및 설명할 수 있는 일반적인 AI 도우미를 만드는 것.
일반적인 AI 도우미란 무엇인가요?
일반적인 질문에 답할 수 있고, 함수를 작성하며, 버그를 찾고, API를 설계하고, 코드 스타일과 모범 사례에 대해 논의할 수 있다.
가장 심한 것은 그 다음 문장입니다:
그것은 소프트웨어 엔지니어 동료의 모든 능력을 보여주어야 합니다.
아니요, 제 생각에는 이게 바로 Claude Code일 뿐이에요??
당시 GPT-3가 막 인기를 얻기 시작했고, 사람들은 AI가 문구 시를 쓸 수 있다는 사실에 놀라고 있을 때, Anthropic은 간단한 코드 자동 완성 로직을 넘어서 완전한 소프트웨어 엔지니어링 에이전트를 목표로 삼았다.
뿐만 아니라, 구체적인 실행 방안에 대해 내부에서 매우 흥미로운 논쟁이 벌어졌습니다.
연구원 앤디 존스는 주석에서 핵심적인 의견을 제시했습니다: 우리는 과연 실제로 유용한 프로그래밍 도우미를 만들기 전에, 도구 호출의 가능성을 증명하는 것이 먼저인가요?
그때 팀은 두 가지 선택지에 직면했다:
실용적인 경로: 코드 저장소 검색(Repo Search)을 구축하여 AI가 프로젝트의 유형 정의를 찾을 수 있도록 하세요.
GPT-3 논문의 제1저자인 Tom Brown도 이 논의에 참여했으며, 코드 Repo Browsing으로 시작하는 것을 권장했다.
연구 방향: printf 디버깅 및 편집기 사용을 통해 모델이 도구를 활용할 수 있음을 증명한다.
마지막으로 CEO 다리오가 결정했습니다:
단기적으로는 도구 호출의 가능성을 검증하고, 장기적으로는 매우 유용한 프로그래밍 도우미로 발전할 것입니다.
지금 Claude Code의 발전 과정을 돌아보면, 마치 다리오가 예전에 말했던 그 말을 따라 하나씩 진행된 것과 같습니다.
자기평가, 십억억 파라미터와 초장기 기억
코딩 에이전트 외에도, 이 로드맵에는 기반 기술에 대한 예측도 포함되어 있습니다.
예를 들어 예비 훈련 부분에서, 2021년에 그들은 1T(1조 개의 파라미터) 이상의 거대 모델을 훈련하기로 명확히 기록했으며, 매우 긴 컨텍스트도 지원하는 방식이나, 방대한 기억과 경험을 저장할 수 있는 다른 메커니즘도 탐구했습니다.
그 175B이 거대한 존재가었던 시절에, 그들은 십억억 파라미터와 초장기 기억을 기본적인 인프라로 여겼다.
더욱 놀라운 것은 인간의 피드백과 정렬 부분입니다.
문서에는 명확하게 적혀 있습니다:
모델 자기평가.
2021년에 그들은 모델이 자신의 행동과 출력 품질을 평가하는 방법, 그리고 모델의 판단을 피드백 신호로 활용하는 방법을 연구하고 있었습니다. 이것이 바로 오늘날 AI 피드백 및 추론 모델의 자기 교정의 핵심 아이디어입니다.
더 흥미로운 점은, 문서에 나중에 대형 모델 연구에서 매우 중요한 개념이 등장했다는 것입니다:
테스트 시간 계산(테스트 시 계산)。
물론, 당시 이 연구는 정렬 및 판별기 연구의 맥락에서 다뤄졌으며, 나중에 o1식 추론 계산 확장까지는 상당한 거리가 있었습니다.
하지만 적어도 2021년에 이미 Anthropic의 연구 관점은 모델 훈련 외의 계산 투입까지 포함되었다는 것을 보여줍니다.
우리가 말하자면, Neo Lab에는 분명 뭔가가 있어요. 그래서 Ilya가 기절하는 것도 이해할 수 있죠.
현재의 최첨단 실험실에서 매일 무엇이 일어나고 있는지 모르겠다.
내부 땀 흘리는 순간
물론이죠, A\이니까 보안 문제에 대해 이야기하지 않을 수 없습니다.
하지만 보니까 이 사람들은 안전에 대해 논의하는 것을 정말 좋아하는 것 같아요. 꽤 긴 부분을 할애했더군요.
안전을 최우선으로 하는 회사로서, Anthropic은 2021년에 오늘날 에이전트가 바삐 움직이는 상황에서 발생하는 악몽을 예견했습니다.
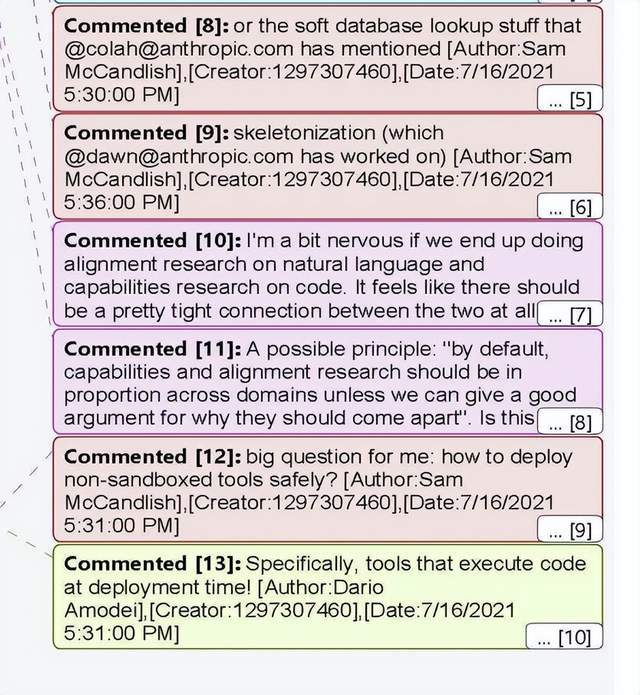
공동 창업자 Sam McCandlish는 주석에서 한 가지 심오한 질문을 제시했습니다:
샌드박스 분리이 없는 도구를 안전하게 배포하는 방법은 무엇인가?
다리오가 바로 댓글을 남겨서 보충했다:
구체적으로는 배포 시 코드를 실행하는 도구입니다!
(추가: 원문에는 실제로 감탄문이 있어요. 당신의 다리오는 바로 이렇게 열정적이죠)
훌륭해요.
AI가 실제로 호스트 환경에서 코드를 실행하고 Shell을 호출하며 파일을 수정할 수 있게 되면, 통제를 잃거나 Prompt에 의해 공격받으면 어떤 결과가 발생할지 상상하기 어렵다.
오늘 온라인에서 논의되고 있는 에이전트 권한 획득, 환경 탈출, 데이터 오염 문제는, 2021년에 이미 샌드박스 경계에 대해 논의되었던 내용입니다.
아마도 처음부터 그 길을 선택했던 것 같습니다.
그런데, Amanda도 이 보고서에 등장했어요. 얼마 전에 유명해진 A사 내부 철학자죠.
그녀는 매우 진지하게 지적했습니다:
자연어에서의 정렬 연구를 진행하면서 모델 능력을 코드 위에서만 향상시키는 것은 걱정스럽습니다. 이 두 가지 연구는 항상 밀접하게 연결되어야 합니다.
만약 우리가 역량 향상 분야에서 정렬 연구를 하지 않는다면, 정렬 테스트의 유효성을 제한하게 됩니다. 이는 연쇄적인 결과를 초래할 수 있으며, 예를 들어 초기 단계에서 통합이 이루어지지 않아 정렬 연구가 독립된 섬이 되는 경우가 있습니다.
심지어 회사 원칙을 제정하자는 직접적인 제안까지 했다:
각 분야의 능력 연구와 조정 연구는 비례적으로 동시에 진행되어야 합니다. 단, 왜 분리해야 하는지에 대한 충분한 이유를 제시할 수 없는 경우는 예외입니다.
한 가지 더
아, A가 왜 OpenAI를 그렇게 압도하는지 말이야, 알고 보니 선제적 우위였어.
Anthropic은 이 5년 동안 청산을 고수하며, 고품질 코드 신호와 강화 학습, 기업 워크플로우를 강화해왔습니다.
그리고 OpenAI는 여러 방면에서 활동하며, 문서 생성 이미지, Sora 동영상, 음성 도우미, 검색 서비스 등 다양한 작업을 진행했고, 이로 인해 전력이 분산되었다.
하지만 모두가 두 기술 방향의 차이를 되돌아보고 있는 동안, OpenAI 측에서는 할리우드 영화보다도 더 터무니없는 충격적인 소문이 밝혀졌다.
여러분, OpenAI에 내부 스파이가 있어요!!!
미국 연방 검사의 고소장에 따르면, 35세의 OpenAI 전 제품 팀 엔지니어 압둘라만 알포잔은 공식적으로 해고되었으며 연방 형사 혐의를 받고 있습니다.
이 친구는 무엇을 했나?
그는 OpenAI 샌프란시스코 본사의 고위 관리자 전용 핵심 회의실에서, 고급 암호화 및 데이터 전송 기능이 있는 도청 장비를 화장지로 감싸서 TV의 뒤쪽 USB 포트에 조용히 꽂았다.
이 회의실은 Sam Altman 등 고위 임원들이 비밀리에 회의를 진행하는 곳이며, 평소에는 슈퍼 인텔리전스 연구 개발의 기밀과 공개되지 않은 제품 계획, 정부와의 협력 브리핑에 대해 이야기합니다.
결국 이렇게 쉽게 해킹당했다.
세상은 정말 형편없는 곳이야...