
요약: TL;DR
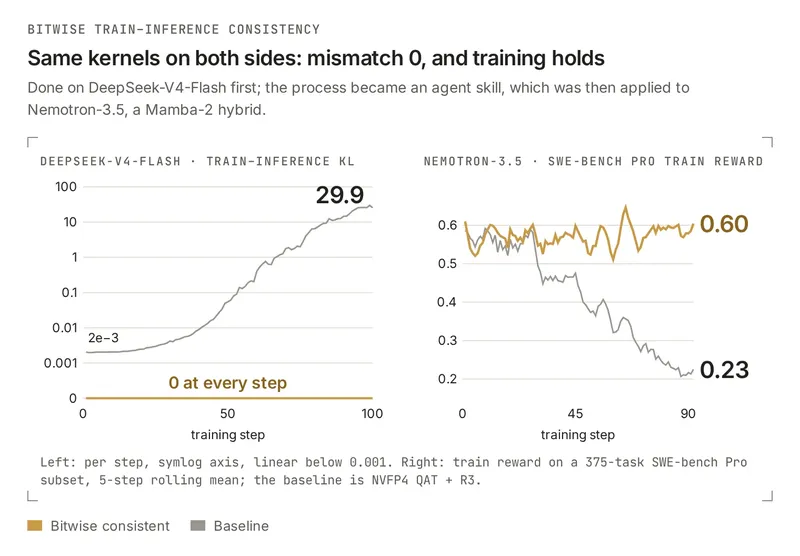
- 문제: 고성능 RL에서 추론 측 최적화는 수치를 변경하므로, 학습은 실제 샘플링을 수행한 정책이 아닌 다른 정책을 최적화하게 됩니다. DeepSeek-V4-Flash에서 고성능 베이스라인의 학습-추론 KL은 2e-3에서 29.9로 상승했으며 보상은 다시 하락했습니다.
- 접근 방식: 훈련 forward가 vLLM의 추론 커널을 직접 호출하고, 이 고성능 커널들을 수정하여 rollout과 훈련이 샘플링된 모든 토큰에 대해 비트 단위로 동일한 logprob을 산출하도록 합니다(diff = 0).
- 결과: DeepSeek-V4-Flash의 100회 이상 훈련 스텝 동안, 매 스텝에서 diff는 0이며 baseline rollout 처리량의 91.3%를 유지합니다. 이를 Nemotron(Mamba 하이브리드 + NVFP4)에 적용한 결과, 일관성 있는 실행의 SWE-bench Pro 점수는 유지되는 반면 baseline은 0.56에서 0.22로 하락합니다.
- 오픈 소스: 이 과정은 에이전트 스킬로 패키징되어 레시피 및 코드와 함께 공개되어, 새로운 모델에서 이를 수행하는 비용을 낮춥니다.
- 진행 중: DeepSeek-V4.1은 diff 0에 도달했으며, 성능 작업이 마무리 중이며 별도의 포스트로 공개될 예정입니다.
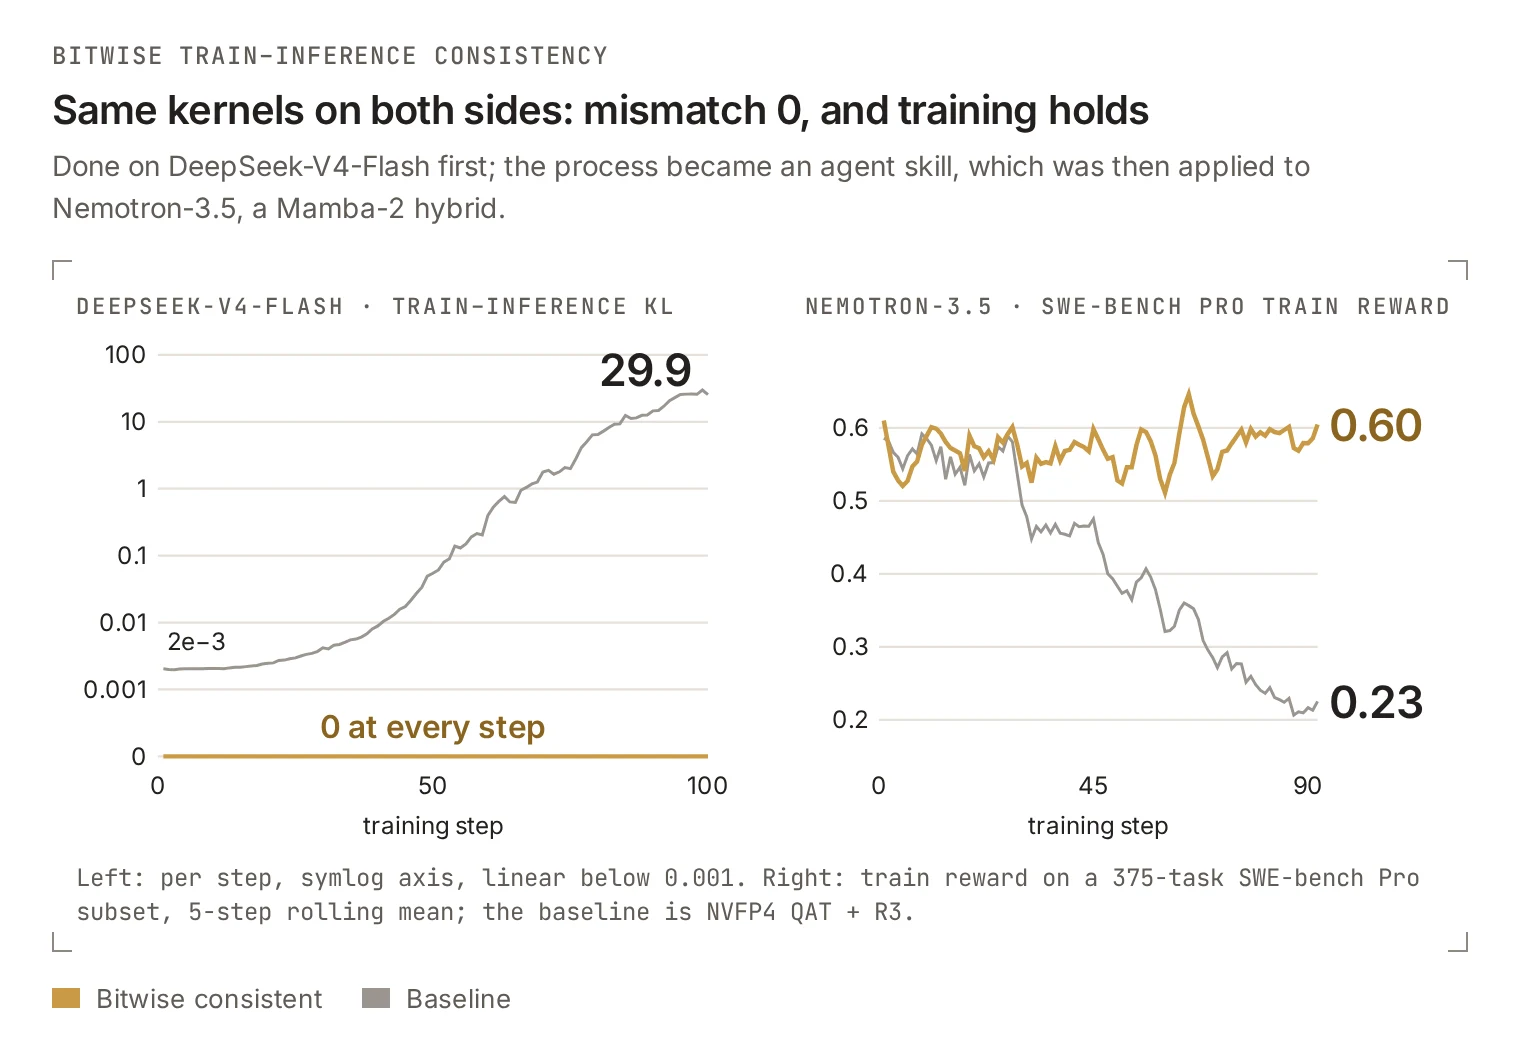
DeepSeek-V4-Flash가 먼저 diff 0에 도달했고, 이 과정이 에이전트 스킬로 만들어져 Nemotron-3.5(Mamba-2 하이브리드)에 적용되었습니다. 왼쪽: DeepSeek-V4-Flash의 train-inference KL; baseline은 2e-3에서 29.9로 상승하고 일관성 있는 실행은 매 스텝에서 0을 유지합니다. 오른쪽: SWE-bench Pro에서의 Nemotron-3.5 train 점수(5스텝 이동 평균); 일관성 있는 실행은 약 0.6을 유지하는 반면 baseline은 0.23으로 하락합니다.
Rollout이 RL 훈련 시간의 대부분을 차지하므로, 훈련 시스템은 저정밀 연산, 저정밀 KV 캐시, 그리고 통신 및 커널 최적화를 도입합니다. 이는 추론 측 수치 계산을 변화시킵니다. 추론 엔진이 응답을 생성하고, 훈련 엔진이 그 확률을 재계산하여 모델을 업데이트합니다. 동일한 가중치를 갖고도 두 측이 같은 토큰에 서로 다른 확률을 부여하게 되어, 훈련은 샘플링된 정책이 아닌 다른 정책을 최적화하게 됩니다. 이 격차는 업데이트에 따라 커질 수 있으며 훈련을 불안정하게 만듭니다. 우리의 DeepSeek-V4-Flash-Base 실험(TIS와 같은 알고리즘적 보정 없음)에서, 고성능 baseline의 train-inference KL은 2e-3에서 29.9로 상승했고 보상은 하락했습니다.
불안정한 훈련은 더 많은 크래시, 롤백 및 재실행, 더 적은 유효 훈련 비율, 그리고 동일한 결과에 도달하기 위한 더 많은 총 시간을 의미합니다. 우리의 목표는 유효한 RL 훈련을 더 빨리 마치는 것입니다: 크래시와 재실행을 줄여, 더 적은 엔드투엔드 시간으로 결과에 도달하는 것입니다.
우리의 접근 방식: 고성능 수치 경로에서 훈련과 추론이 샘플링된 모든 토큰에 대해 비트 단위로 동일한 logprob을 산출하는 것(diff = 0; 섹션 2에서 정확히 정의합니다)으로, 이것이 진정한 on-policy RL입니다. 우리는 훈련 forward가 vLLM의 추론 커널을 직접 호출하고, 이 고성능 커널들을 수정하여 결과가 배치 구성, prefill 또는 decode 단계, 혹은 병렬 배치에 따라 변하지 않도록 함으로써 이를 달성합니다(섹션 3과 4). 그 후 에이전트 스킬이 새로운 모델에서 이를 수행하는 비용을 낮추고 과정의 전이 가능성을 높입니다: 이 스킬은 에이전트에게 두 측이 갈라지는 첫 번째 연산자를 찾고, 이를 최소 재현 사례로 축소하고, 수정하고, 회귀 테스트를 다시 실행하는 방법을 알려줍니다. DeepSeek-V4-Flash에서 우리는 고성능 baseline rollout 처리량의 91.3%에서 diff 0에 도달했으며, NVFP4를 사용하는 Mamba 하이브리드인 Nemotron에도 이 방법을 적용했습니다.
이 포스트는 수치 일관성, 훈련 곡선 및 rollout 처리량을 측정합니다. 엔드투엔드 이득은 더 적은 크래시와 재실행에서 오며, 이는 장기 실행에서만 드러나므로 해당 wall-clock 비교는 추후로 남겨둡니다. 또한 어느 쪽 baseline도 철저히 튜닝되거나 탐색되지 않았습니다: 각각은 단일 구성으로, R3를 사용하되 TIS나 MIS와 같은 알고리즘적 보정 없이 실행되었습니다. 여기서 보이는 baseline 붕괴는 오직 이 레시피만을 반영합니다; 튜닝을 거치면 baseline이 이렇게 쉽게 붕괴하지 않을 수 있습니다.
1. 기존 접근 방식: 세 가지를 어떻게 절충하는가
유효한 RL 훈련을 더 빨리 마치려면 세 가지 속성을 동시에 만족해야 합니다:
- A, 고성능: 빠른 rollout과 훈련, 저정밀 연산, 저정밀 KV 캐시 및 통신 최적화를 모두 사용 가능;
- B, 고일관성: 훈련과 추론이 동일한 가중치에 대해 동일한 정책을 계산;
- C, 저비용 및 범용성: 새로운 모델, 정밀도 또는 하드웨어에서 A와 B를 달성하는 데 허용 가능한 개발 시간이 소요.
이 두 가지는 좀처럼 함께 유지되지 않습니다. B를 버리면 자유롭게 최적화할 수 있지만 불안정한 학습의 위험을 감수해야 합니다. A를 버리면 일관된 커널을 사용할 수 있지만 추론이 훨씬 느려집니다(아래 표의 수치 참조). A와 B를 모두 유지하려면 모델별로, 연산자별로 하나하나 정렬해야 하므로 C는 실패합니다.
학습-추론 불일치는 새로운 문제가 아니며, 기존 접근 방식들은 A, B, C를 서로 다르게 절충합니다:
| 접근 방식 | 유지하는 것 | 포기하거나 치르는 대가 |
|---|---|---|
| 알고리즘적 보정: TIS, MIS, FlashREINFORCE, Score Centering | A와 C: 추론 엔진은 그대로 두며, 모델에 구애받지 않고, 도입 비용이 저렴함 | B: 수치적 차이는 그대로 남아 있으며, 학습 갱신에 미치는 영향만 제한할 뿐입니다. 비용: 편향, 폐기되는 샘플, 그리고 저정밀도가 격차를 넓힐수록 보정이 더 어려워짐 |
| R3 (replay rollout expert routing) | A와 MoE 라우팅에 대한 B | 라우팅 뒤집기만 제거하며, 다른 수치적 차이는 그대로 남음 |
| QAT (학습 순전파가 배포 시 양자화를 시뮬레이션) | A: 롤아웃은 낮은 정밀도를 안전하게 사용할 수 있으므로, 양자화로 인한 차이 부분을 줄입니다(B 개선) | 학습은 양자화를 시뮬레이션해야 하며, backward는 straight-through estimator(STE: backward에서 양자화를 항등함수로 취급)를 사용합니다. 가중치만 시뮬레이션하면 활성화, KV, 커널, reduction에서 발생하는 차이가 남습니다 |
| 엄격한 수치 정합 (Thinking Machines, slime, IsoExec, 이 글) | B | A 또는 C: 범용 batch-invariant 커널은 A 비용이 듭니다(Thinking Machines 워크로드: 26 s에서 55 s, 개선된 attention 커널로 42 s); 고성능 경로에서 정합을 맞추면 A를 유지하고 C 비용이 듭니다(slime, IsoExec, 이 글: 모델별, 연산자별 정합 및 검증) |
알고리즘적 보정은 여러 메커니즘을 포괄합니다:
- TIS (Truncated Importance Sampling, Yao et al.): 학습/롤아웃 확률 비율로 그래디언트에 가중치를 부여하고 상한에서 절단하여, 약간의 편향을 감수하고 분산을 제한합니다;
- MIS (Masked Importance Sampling, When Speed Kills Stability): 절단 없음; 시퀀스 수준 확률 비율이 임계값을 초과하는 시퀀스 전체를 제외합니다;
- FlashREINFORCE (Hu, Zhang et al.): 비동기 에이전트 RL을 위한 방법; 궤적 수준 드리프트 필터링(시퀀스 신뢰 영역)을 통해 너무 많이 벗어난 궤적을 제거합니다;
- Score Centering (Marek & Ryabinin): 각 업데이트마다 누적되는 학습-추론 드리프트를 가산 보정 항으로 상쇄합니다; 중요도 샘플링과 함께 사용할 수 있습니다.
이러한 방법들은 불일치의 영향을 줄일 뿐 제거하지는 못합니다: 불일치는 온폴리시 학습을 오프폴리시 학습으로 만들고(Yao et al.), 불일치가 크고 여러 원인에서 비롯되면 토큰 수준 중요도 샘플링은 편향되고 학습이 붕괴되기 더 쉽습니다(Li & Liu); P1-VL에서는 절단 중요도 샘플링이 붕괴를 지연시킬 뿐이었습니다. R3(Rollout Routing Replay, Ma et al.)는 롤아웃 전문가 라우팅을 기록하여 학습에서 이를 재생함으로써 라우팅 전환 부분만 제거합니다.
마지막 행에서, Thinking Machines Lab은 batch-invariant 커널로 진정한 온폴리시 RL을 달성합니다(Defeating Nondeterminism in LLM Inference) 추론 시점 비용 부분에서 표에 나타난 차이의 상당 부분은 아직 최적화가 잘 되지 않은 FlexAttention 통합에서 비롯된 것입니다; vLLM과 TorchTitan 은 학습에서 vLLM의 forward 커널을 재사용하며, bitwise 일관성을 갖는 실행이 더 적은 스텝으로 더 높은 보상에 도달했습니다; slime 은 GLM-5 아키텍처(DeepSeek-V3.2와 동일한 MLA + DSA 구조)에서 logprob을 정렬합니다; 그리고 IsoExec 는 Alexander Jiang과 SkyRL 팀이 선형 어텐션(6절)을 다룹니다.
이 접근법들의 대부분은 서로 결합됩니다: 어떤 것들은 한 weight 버전에서 엔진 간의 수치적 차이를, 다른 것들은 weight 버전 간의 정책 차이를 다룹니다. 비동기 학습에서 오래된(stale) weight로 인한 off-policy는 여전히 TIS, MIS 또는 Score Centering으로 처리되지만, 그 weight들에 대해서는 엔진들을 수치적으로 정렬할 수 있으며, bitwise 일관성을 갖는 실행이 이러한 보정을 측정하기 위한 기준선이 됩니다. QAT 역시 엄격한 정렬에 속합니다: 저정밀 롤아웃과 학습은 학습 forward가 동일한 양자화를 적용할 때만 bitwise 일치하며, 우리의 backward는 STE를 사용합니다.
우리는 A를 유지하는 마지막 행 경로를 택하며, A에 대한 기준은 다음과 같습니다: 동등하게 최적화된 고성능 기준선 대비 최소 70%의 롤아웃 처리량 (롤아웃은 RL 학습에서 가장 시간이 많이 걸리는 부분입니다; 학습 측 오버헤드는 별도로 측정되지 않았습니다, 3.2 참조). C가 이 경로의 약점이며, 5절에서 Agent + skill이 이를 어떻게 보완하는지 다룹니다.
2. 학습-추론 일관성이 요구하는 것
이 글에서 diff란, 동일한 weight 버전과 토큰 접두사(prefix)로 각 업데이트 이전에, 롤아웃의 각 유효 토큰(response mask 내부의 샘플링된 토큰)에 대한 logprob과 학습 측에서 재계산한 old-logprob 사이의 차이를 말합니다. 통과 기준은 토큰별 차이 |p_rollout − p_train|의 최댓값, 평균, 표준편차, 그리고 k3 KL이 모두 정확히 0이어야 한다는 것입니다. 이는 임계값이 아니라 정확한 동일성이며, 각 업데이트 이전에 검사됩니다; 미니배치 업데이트는 어차피 정책을 변경하므로 이 정의에서는 제외됩니다. 이 기준은 우리가 통과시킨 과제들(수학 추론, 다중 턴 도구 호출)과 병렬 레이아웃, 측면별로 다른 레이아웃을 포함하여 성립합니다.
"학습과 추론이 동일한 것을 계산한다"는 명제는 공유 수치 계약(Shared numerical contract)과 함께 네 가지 차원으로 나뉩니다:
train-inference consistency ⇐ kernel determinism + batch independence + phase consistency + cross-GPU consistency + same numerical contract on both sides
커널 결정론성(단일 GPU). 동일한 입력에 대해 동일한 커널은 항상 동일한 출력을 냅니다. GPU는 기본적으로 이를 보장하지 않습니다. 한 예가 split-K 행렬 곱셈입니다: 부동소수점 덧셈은 결합법칙이 성립하지 않으므로, 다른 누적 순서는 다른 결과를 낳습니다.
배치 독립성. 요청의 결과는 같은 배치에 속한 다른 요청에 의존해서는 안 됩니다. 추론 시 엔진은 처리량을 위해 배치를 동적으로 병합하고 분할합니다. 학습 시에는 마이크로 배치 크기, 패킹, 그리고 전문가별 MoE 토큰 수 역시 경로를 바꿉니다. (배치 크기에 따른 커널 선택, 동적 분할 수 등) 다양한 최적화 기법 때문에 특정 요청은 같은 배치 내 다른 요청들에 의존하게 됩니다.
위상 일관성. 토큰은 프리필(여러 토큰을 한 번에 처리)과 디코드(한 번에 하나씩 처리)에서 동일한 결과를 얻어야 합니다. 추론 엔진은 각 단계에 가장 빠른 커널을 제공하는데, 공유 경로를 강제하는 것이 일관된 버전의 성능 저하의 주요 원인이자 최적화의 초점입니다.
GPU 간 일관성. 교차 GPU 리덕션(AllReduce, reduce-scatter, 그리고 MoE all-to-all 이후 전문가 출력 병합) 또한 두 가지 수준에서 고정되어야 합니다.
- 다음과 함께 동일한 병렬 구성 양쪽 모두에서 통신 결과는 타이밍과 스케줄링에 따라 달라져서는 안 됩니다(통신 라이브러리의 알고리즘, reduction 청킹 및 정밀도, 그리고 expert 병합 순서를 고정합니다).
- 함께 다양한 병렬 레이아웃 (예: 서로 다른 TP/EP 정도)의 경우, 병렬화 정도가 변해도 결과가 동일하게 유지되어야 하며, 이는 고정된 reduction tree를 필요로 하고 더 많은 비용이 듭니다. DeepSeek-V4 방식은 대신 cross-GPU reduction을 비교 대상 경로(4.5) 밖으로 이동시킵니다.
각 차원은 두 근본 원인 중 하나를 방어합니다: 서로 다른 연산 순서(병렬 누적 또는 리덕션 순서가 스케줄링을 따름) 또는 서로 다른 계산 경로(두 측, 또는 서로 다른 배치 형태가 서로 다른 커널이나 분기를 실행). diff가 0에 도달했다는 것은 먼저 정적 차이를 제거한 다음, 동적 경로 선택이 부하(load)를 무시하도록 고정했음을 의미합니다.
이 네 가지 차원 외에도 diff = 0에 도달하려면 몇 가지가 더 필요합니다:
- 양쪽 모두에서 동일한 수치 계약: 동일한 양자화와 라운딩, 동일한 누적 정밀도, 동일한 커널 연산. 두 엔진은 네 가지 차원을 모두 충족하면서도 서로 다르게 계산하면 결과가 달라질 수 있습니다.
- 동일한 이산적 선택: Top-K와 MoE 라우팅은 상위 단계의 1-ulp 차이(부동소수점 수의 마지막 자리에서의 1단위)를 서로 다른 토큰 집합이나 전문가 조합으로 확대시킬 수 있습니다. 상위 단계가 일치하면, 동점 처리, 출력 순서, 병합 규칙도 일치해야 합니다.
- 스텝당 1회 업데이트 (스텝 배치 = 미니배치): 스텝당 여러 번의 미니배치 업데이트가 있으면 두 번째 업데이트부터 학습 가중치가 샘플링 가중치와 달라지는데, 이는 diff = 0이 커버하지 못하므로 학습이 엄밀히 온폴리시(on-policy)가 아니게 됩니다 (스텝당 4회 업데이트를 사용하는 수학 과제에서 각 업데이트 후 약 7%의 토큰이 전문가 조합을 바꿨습니다).
- 올바른 역전파와 복원: 네 가지 차원은 일관된 포워드만 제공합니다. 역전파는 여전히 올바라야 하고, 체크포인트 복원 후 첫 스텝도 여전히 일관적이어야 합니다.
섹션 4의 주요 연산자들은 각각 이 요구 사항 중 하나를 충족합니다: dense GEMM은 배치 독립성을 위해 커널 선택을 고정하고(4.1), FP8 KV 캐시는 페이즈 일관성을 위해 프리필(prefill)과 디코드(decode) 읽기를 통일하며(4.2), Top-K는 이산적 선택이 일치하도록 동점 처리와 순서를 고정하고(4.3), 전문가 GEMM은 두 레이아웃에 걸쳐 하나의 수치 계약을 유지하며(4.4), 그리고 크로스-GPU 리덕션은 크로스-GPU 일관성을 위해 비교 경로에서 벗어나게 합니다(4.5).
diff = 0은 양쪽이 같은 것을 계산한다는 의미이지, 그것이 학습에 적합하다는 의미가 아닙니다: 스텝당 여러 번의 업데이트가 있을 때 diff = 0은 유지되지만 업데이트 사이에 라우팅이 드리프트됩니다. diff = 0은 우리의 엔지니어링 목표일 뿐이며, 학습 품질을 위한 충분 조건이 아니므로 별도의 수용 검증이 필요합니다.
3. 레퍼런스 레시피: DeepSeek-V4-Flash
DeepSeek-V4-Flash는 저정밀 연산, 희소 어텐션, 멀티노드 전문가 병렬화를 결합하여 도전적인 구성입니다. FP8 베이스에서 우리는 GB200에서 두 개의 100스텝 실행을 학습했습니다: 최적화된 고성능 베이스라인과 diff = 0을 만족하는 일관 버전입니다.
과제: 초과 길이 페널티가 있는 보상(음수가 될 수 있음)을 갖춘 DAPO 형식 데이터와 GRPO를 사용한 수학 추론입니다. 각 실행은 8대의 머신(32 GPU), 스텝당 128개 프롬프트 × 8개 응답, 그리고 스텝당 1회 업데이트(스텝 배치 = 미니배치)를 사용합니다. 어느 실행도 TIS, MIS 또는 유사한 보정을 사용하지 않아 엔진 차이를 직접 드러냅니다.
병렬화: DP 데이터, EP 전문가, CP 컨텍스트(시퀀스 분할), TP 텐서. 일관 버전의 롤아웃은 각각 DP8/EP8, TP=1인 4개의 vLLM 엔진을 실행하고; 학습은 EP32, CP4, TP=1을 사용합니다. 양쪽은 서로 다른 병렬 레이아웃을 사용합니다 (4.5).
관련 구조: MLA (KV를 캐싱 전에 압축하는 multi-head latent attention); DSA (DeepSeek sparse attention: 경량 인덱서가 과거 위치에 점수를 매기고, Top-K는 최대 2048개를 유지하며, MLA는 해당 위치들만 어텐션함); CSA compressor (과거 KV를 더 적은 수의 행으로 압축함); mHC (잔차 스트림 간 혼합, 혼합 행렬은 Sinkhorn 반복으로 정규화됨); 그리고 43개의 MoE 레이어. SM100은 Blackwell이고(여기서 사용된 것이 GB200임); SM90은 Hopper입니다.
3.1 핵심 결정: 추론 커널이 값(value)을 정의하고, 학습은 backward만 추가한다
두 엔진은 동일한 코드를 실행하면 가장 쉽게 일치할 수 있습니다. 문제는 어느 쪽이 맞춰 따라가느냐입니다. 롤아웃이 RL 시간을 지배하며 모든 연산자가 처리량에 맞춰 튜닝되어 있으므로, 학습을 기준으로 삼는다면 그러한 최적화를 포기하게 됩니다. 따라서, 추론 커널이 수치 기준이 됩니다. 학습 forward는 동일한 vLLM 커널을 호출하여 값을 얻고, 학습은 backward만 추가합니다. 추론 역시 일반적인 배치 불변(batch-invariant) 커널로 전환하지 않습니다. 고성능 배포 커널을 유지하면서 섹션 2의 요구 사항을 충족하도록 수정합니다. 섹션 4의 모든 연산자가 이러한 트레이드오프를 따릅니다.
이 결정의 어려움은 추론 커널(inference kernel)에는 backward가 없고 FP8 양자화는 미분 가능하지 않다는 점입니다. 따라서 forward와 backward는 별도로 처리되며 forward 값은 항상 vLLM 커널에서 가져옵니다. 각 모듈은 커널을 커스텀으로 감싸서 autograd.Function 역전파는 BF16 마스터 가중치에 대해 미분하며, FP8 양자화는 항등 함수로 취급됩니다(직통 추정기, straight-through estimator, STE). 역전파는 대부분 기존 커널을 재사용합니다: 선형 레이어와 전문가 GEMM에는 Transformer Engine BF16 GEMM, 희소 어텐션에는 cuDNN frontend DSA backward, all-to-all에는 DeepEP의 backward를 사용합니다. mHC, RMSNorm, SwiGLU와 같은 소규모 연산자만 손으로 작성된 FP32 도함수를 갖습니다. 일부 융합 커널은 이 방식으로 미분할 수 없는 출력을 가집니다(어텐션 q/k, 압축 KV, 라우팅 가중치, 최종 logprob); 이 경우에는 해당 커널의 값을 유지한 채 그래디언트를 얻기 위해서만 동일한 계산을 PyTorch로 다시 실행합니다: visible + (graph - graph.detach()). 각 backward는 master 가중치가 forward 이후 변경되지 않았는지 먼저 확인하므로, 재계산이나 비동기 업데이트가 가중치 버전을 섞을 수 없습니다.
모든 비용은 학습에 들어가며, 두 가지 종류가 있습니다. 엔지니어링 및 검증: gradient는 surrogate이며 quantized 연산자의 정확한 미분이 아니므로, bitwise로 동일한 forward는 gradient에 대해 아무것도 증명하지 않으며, 해당 skill은 backward를 독립적인 참조(Section 5)를 기준으로 검증합니다. backward는 deterministic할 필요 없이 정확하기만 하면 됩니다. 각 layout 진입 지점(예: 4.4의 masked / contiguous) 역시 자체적인 검증이 필요합니다. 성능 및 메모리: 학습 시 앞으로 진행하는 과정에서 역전파를 위해 추론 커널의 입력과 출력을 저장해야 합니다; 바로 이 메모리 압박 때문에 이 레시피는 순전파를 두 번 실행하는 전체 재계산을 활성화합니다.
3.2 결과와 비용 부담자
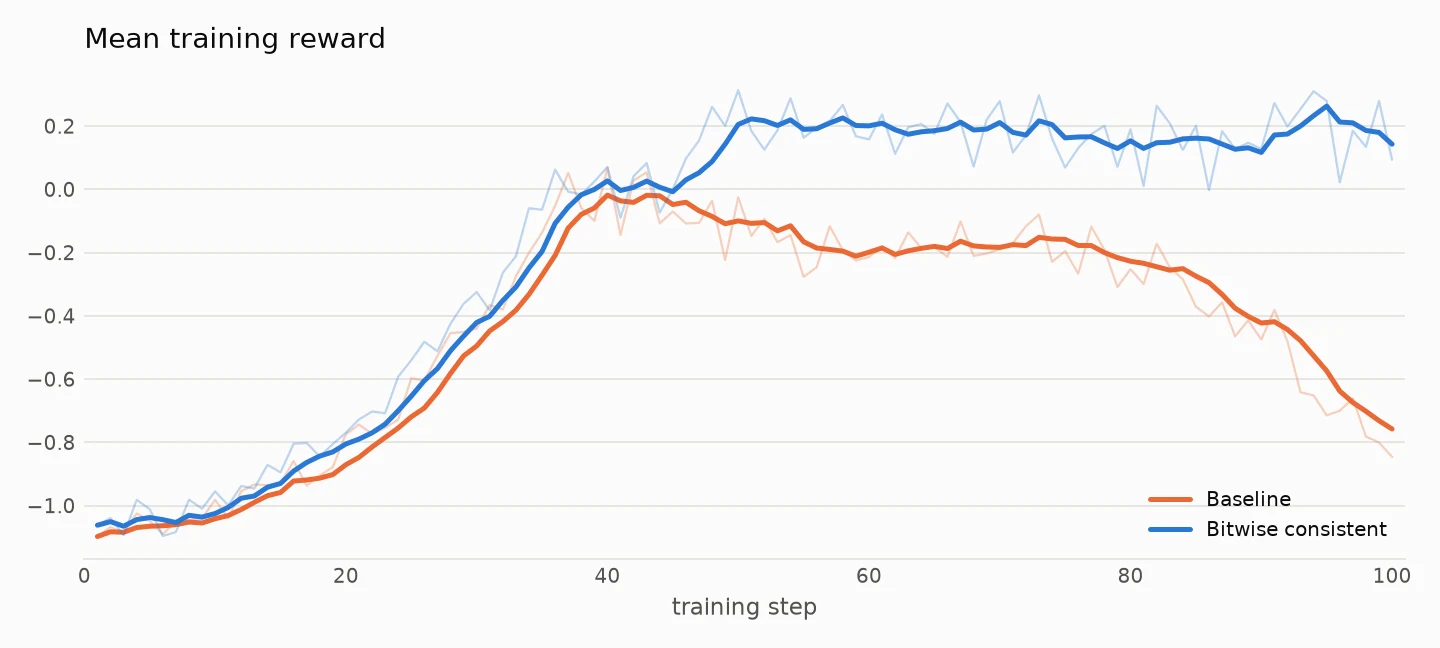
단계별 학습 보상입니다. 주황색: 기준선; 파란색: 일관된 버전. 굵은 선: 현재 및 이전 4개 단계의 이동 평균; 가는 선: 원래 값.
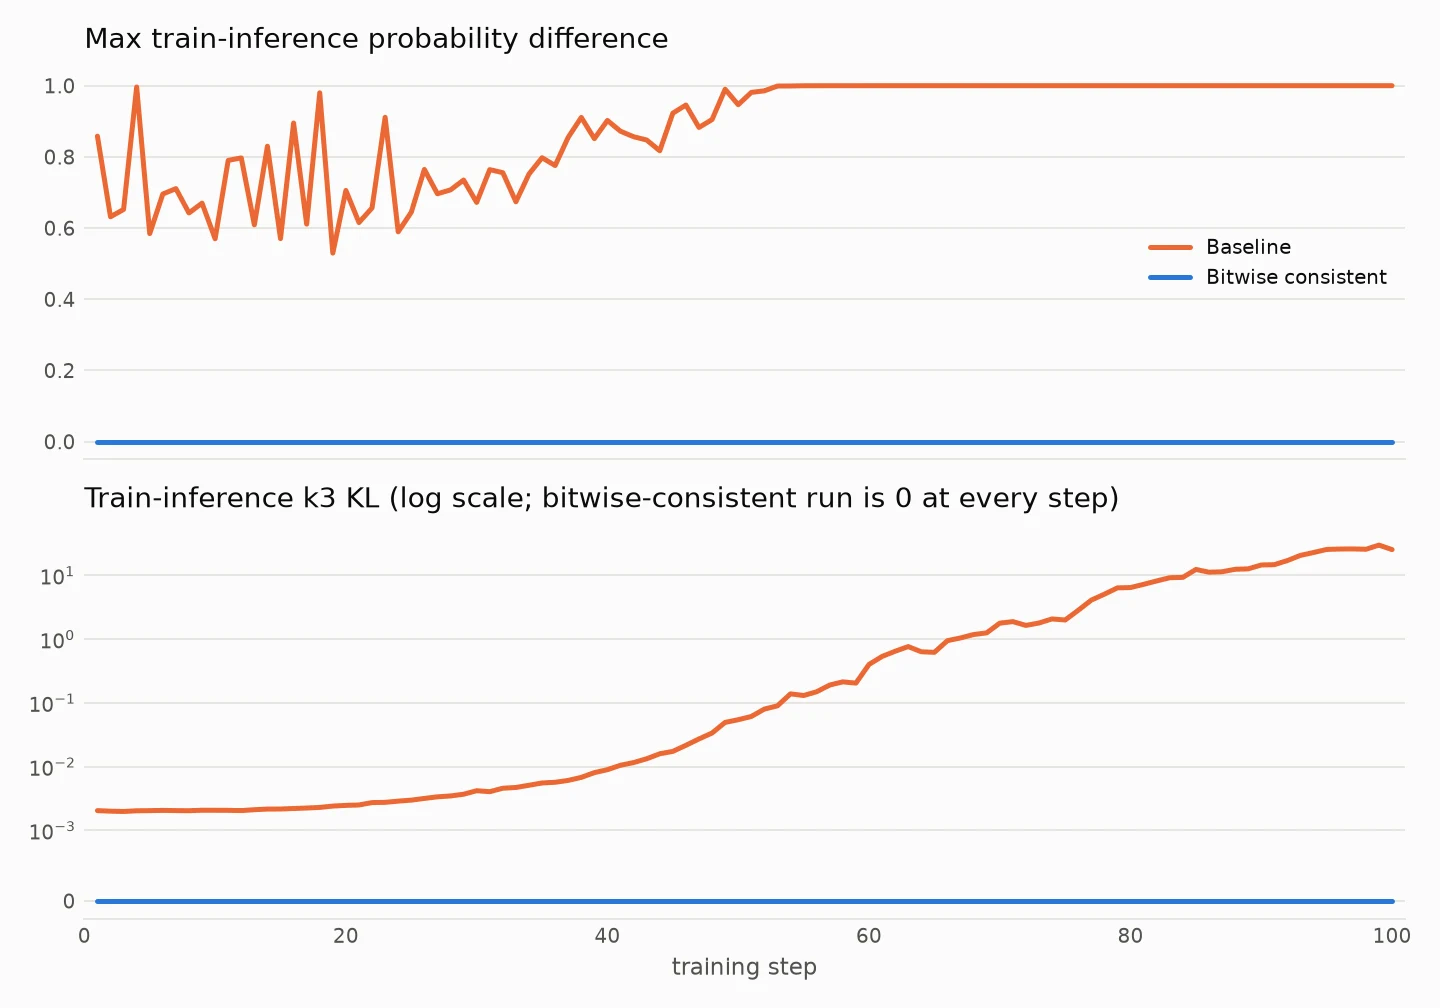
위: 단계별 최대 학습-추론 확률 차이; 아래: 학습-추론 KL (k3 추정량 r − 1 − log r, 전체에서 사용; 대칭 로그 눈금, 0 근처에서는 선형). 최대 차이는 라우팅 한 번 뒤집히거나 Top-K 교환이 일어나면 반응하므로 기준선 1단계부터 상당한 크기를 보입니다; KL은 전체적인 수준을 보여줍니다. 주황색: 기준선; 파란색: 일관된 버전. 일관된 버전의 두 지표는 모든 단계에서 0입니다.
100단계에 걸쳐 일관된 버전의 롤아웃은 평균 24.22 token/ms로 베이스라인(26.53)의 91.3%를 기록합니다:
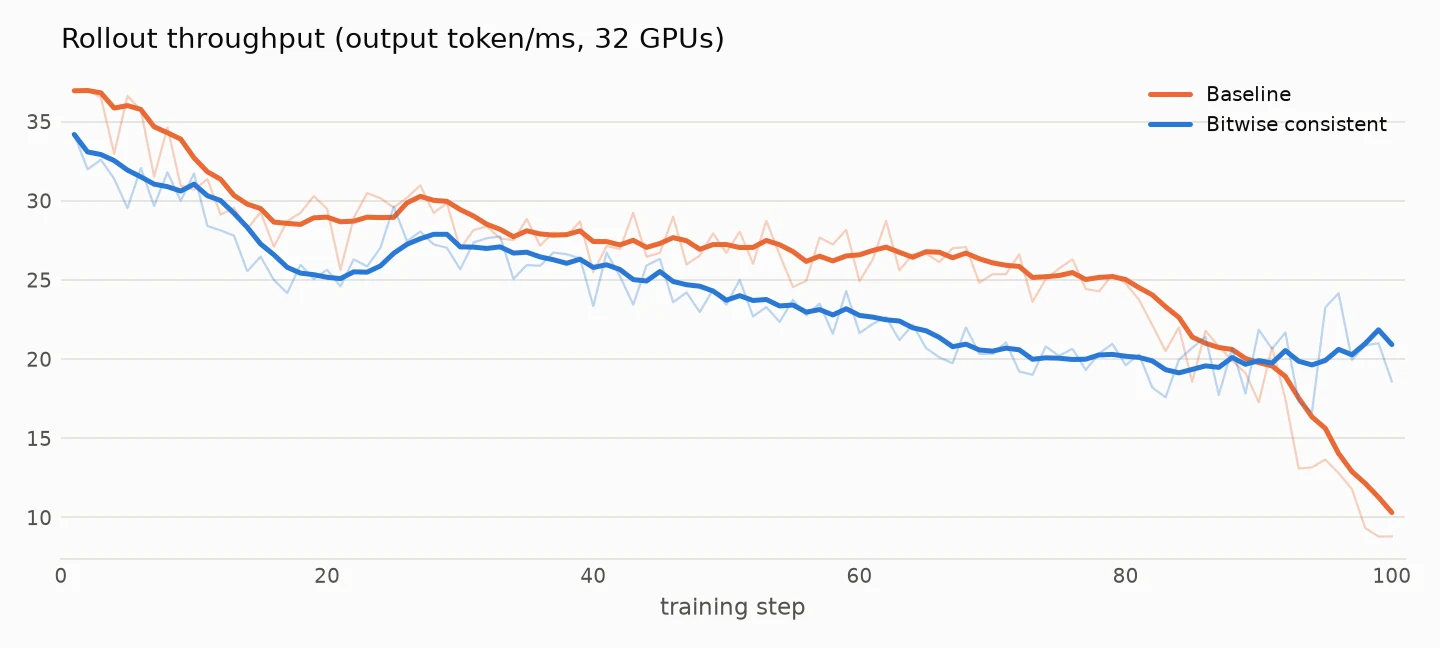
단계별 롤아웃 처리량(출력 token/ms, 32개 GPU 합산). 주황색: 베이스라인; 파란색: 일관된 버전. 굵은 선: 현재 및 이전 4단계의 이동 평균; 가는 선: 원시 값.
기본 train-inference KL이 증가하고(2e-3에서 29.9로) 그 보상은 되돌아가는 반면, 일관된 버전은 diff 0을 유지하며 보상도 유지됩니다. 또 다른 잠재적 이점은 forward 횟수가 하나 줄어든다는 점입니다. 우리는 diff를 측정하기 위해서만 매 단계 old-logprob을 재계산하는데, accept 후에는 학습 시 rollout logprob을 대신 사용할 수 있습니다.
배포 현황, 이번 실행에서 측정된 결과: 평균 처리량은 기준선의 91.3%로(약 9% 낮음), 섹션 1의 70% 하한선을 넘습니다. 90단계 이후 기준선의 처리량이 떨어지는데, 이로 인해 비율이 부풀려집니다; 동일한 단계 구간에서 기준선의 평균 응답 길이는 약 3,000 토큰에서 약 1,600 토큰으로 줄어듭니다. 처음 89단계만 보면 88.6%입니다. 두 실행의 응답 길이는 학습 내내 서로 다르므로, 이 비율은 엔진뿐 아니라 서로 다른 작업 부하도 반영합니다.
이 격차는 아직 연산자에 귀속되지 않습니다. Section 4에서는 MoE LL 통신 및 백엔드, 어텐션 gather 및 dequantization, 요청별 launch를 지적합니다.
훈련 측면, 별도로 측정되지 않음: 섹션 4에 따르면 오버헤드는 매 forward마다 FP8 가중치를 재양자화하는 것, 요청별 직렬 어텐션 및 Top-K, 라우팅 메타데이터 dispatch 한 번 추가, 그리고 전체 재계산(3.1)으로 forward를 두 번 실행하는 것이다.
32개 GB200 GPU에서 진행된 별도의 verl 레시피 PR 프리뷰는 약 10%의 엔드투엔드 오버헤드를 보고합니다: 롤아웃은 거의 대등했고, 격차는 대부분 학습 단계에 있습니다. 다음은 학습 측면의 최적화입니다.
4. 사업자별: DeepSeek-V4 레시피의 기술적 선택
각 하위 절에서는 무엇을 유지하고, 무엇을 포기하며, 속도를 어떻게 회복하는지, 그리고 어떤 비용이 남는지를 다룹니다. 각 측이 연산자별로 어떤 커널을 사용하는지, 그리고 backward가 어떻게 작성되었는지는 다음에 있습니다. 스킬.
운영자별 마스터 테이블
비용은 대부분 MoE 통신과 백엔드(4.4, 4.5)에 있으며, 그다음이 어텐션 gather와 디퀀타이제이션(4.2, 4.3)이다; dense는 저렴하다.
| 모듈 | 유지됨 | 포기함 | 비용 |
|---|---|---|---|
| Dense GEMM (4.1) | 배포: W8A8 및 DeepGEMM; 출력당 하나의 누적 순서 | FlashInfer 분기(M<32), 소규모 배치 게이트 커널, 퓨즈드 mHC 커널 | rollout: 더 빠른 소규모 배치 커널 없음; 학습: 매 forward마다 가중치 재양자화 |
| FP8 KV 캐시 (4.2) | FP8 저장소 | FP8을 직접 읽는 디코드 커널 | rollout: 디코드 시 추가 gather 및 역양자화; 학습: 하나의 전용 캐시 |
| Top-K (4.3) | DSA 희소 어텐션 | 기본 Top-K 동률 처리(tie-breaking) 및 출력 순서 | 측면당 정렬 한 번 추가, 퓨전으로 회수; 요청당 prefill 런치 여러 번; 학습: 어텐션과 Top-K가 요청별로 직렬 실행 |
| 전문가 GEMM (4.4) | FP8 그룹 GEMM; 라우팅이 구조적으로 일치, R3 불필요 | FlashInfer TRT-LLM MoE | 롤아웃: 주요 처리량 병목; 학습: 정렬 패딩 |
| GPU 간 리덕션 (4.5) | 학습과 롤아웃의 서로 다른 병렬 레이아웃 | TP>1 | 롤아웃: LL 통신이 연산과 겹칠 수 없음; 학습: 라우팅 메타데이터 디스패치 한 번 추가 |
| CUDA Graph (4.6) | 그래프 | 성능 전용 단축 분기 | 상한값으로 예약된 워크스페이스 |
| 기타 (embedding, RMSNorm, o_proj, lm_head + logprob) | 기존 커널, 고정 리덕션 순서 | — | 작음 |
4.1 Dense GEMM: FP8 유지, 모든 M에 대해 하나의 누적 순서
유지함. DeepSeek-V4-Flash-Base는 block-FP8로 제공되며, 배포 경로는 DeepGEMM을 사용하는 W8A8입니다. 일관 버전은 양쪽에서 이를 사용합니다: 각 학습 forward는 배포 규칙에 따라 BF16 마스터 가중치를 block FP8로 양자화하고 추론 GEMM을 호출합니다. BF16 롤아웃은 연산과 대역폭 비용이 들며; MXFP8 같은 별도의 학습 측 방식은 배포된 수치에 근접할 뿐인데, 이것이 섹션 1의 QAT 행의 한계입니다.
포기함. 추론 엔진은 형태에 따라 커널을 선택합니다: FP8 선형 레이어는 M<32일 때 FlashInfer를, 그 외에는 DeepGEMM을 사용합니다; 라우터 게이트는 16토큰 이하에서 소량 배치 커널로 전환합니다; mHC 분할 수는 토큰 수에 따라 증가합니다. 부동소수점 덧셈은 결합 법칙이 성립하지 않으므로, 각 경우 요청의 결과가 이웃 요청에 의존하게 됩니다. 일관 버전은 이러한 분기를 제거합니다: FP8 선형 레이어는 항상 배치 불변(batch-invariant) 모드의 DeepGEMM을 사용하고, 라우터 게이트는 모든 배치 크기에서 FP32 출력 GEMM 하나를 사용하며, 소형 BF16 행렬 곱은 고정 합산 순서의 Triton 커널을 사용하고, mHC 분할은 1로 고정됩니다. FlashInfer 대신 DeepGEMM으로 통일하는 이유는 DeepGEMM이 배치 불변 모드를 제공하고, 이미 배포 커널이며, 학습 M이 크기 때문입니다.
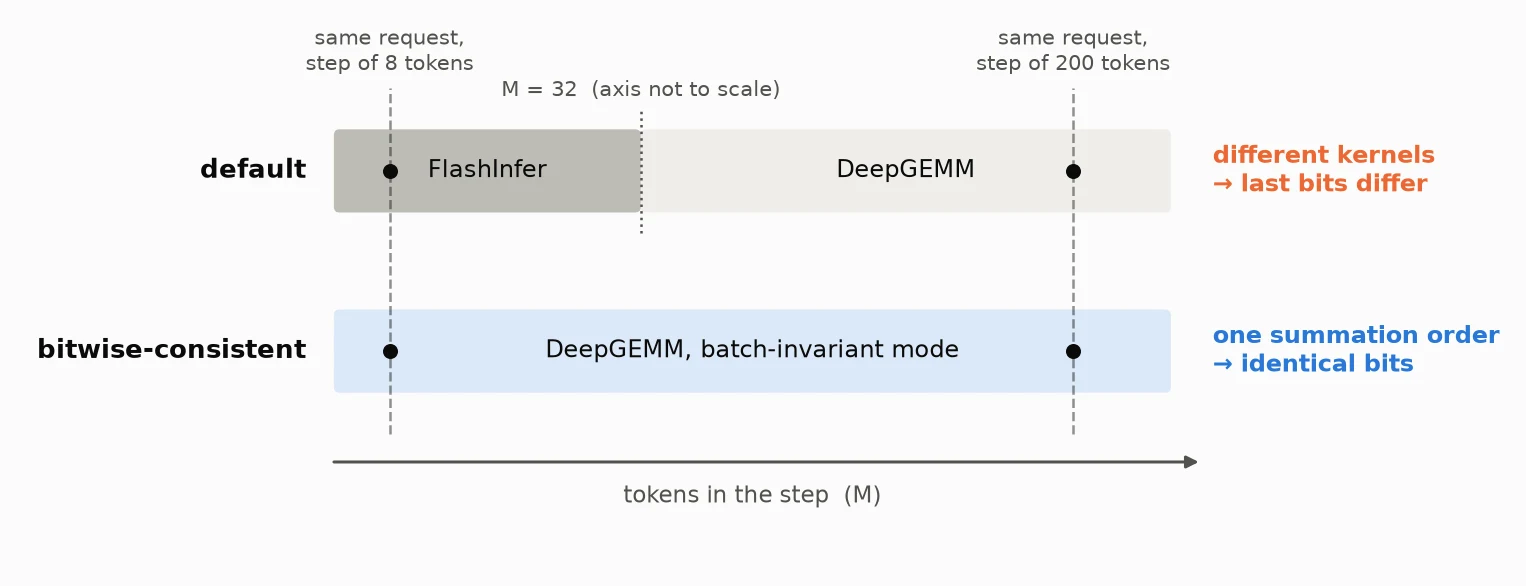
가로축: 스텝당 토큰 수 (개략도). 기본 경로는 32에서 커널을 전환하므로, 8토큰 스텝과 200토큰 스텝에서의 동일한 요청은 FlashInfer와 DeepGEMM을 거치며 마지막 비트가 달라집니다. 배치 불변 모드는 하나의 합산 순서를 가집니다.
비용. 롤아웃은 더 빠른 소량 배치 커널과 mHC 퓨전 하나를 잃지만, Tensor Core는 계속 사용됩니다. 학습은 재연산을 포함하여 매 forward마다 가중치를 재양자화합니다; FP8 가중치를 캐싱하면 상주 복사본 하나 추가 비용으로 그 시간을 절약할 수 있습니다.
4.2 FP8 KV 캐시: FP8 저장 유지, 읽기 경로 통일
유지함. KV 캐시는 FP8로 저장되며, BF16의 약 57%로 동시성을 직접 결정합니다. 두 실행은 쓰기 경로를 공유합니다.
포기함. 기본 디코드는 FP8을 직접 읽고 배치별로 작업을 분할하는 FlashMLA 커널을 사용합니다; prefill은 BF16으로 역양자화하고 희소 어텐션을 실행합니다. 두 단계는 서로 다른 알고리즘을 실행하며, 디코드의 분할은 배치에 의존합니다. 일관 버전은 디코드를 prefill 경로로 우회시킵니다: 선택된 KV를 역양자화하여 BF16 워크스페이스로 모은 다음, 동일한 flash_mla_sparse_fwd. 워크스페이스는 요청별로 존재하며 모델 한도에 의해서만 크기가 결정됩니다. 이 디코드 커널은 명시적으로 선택해야 하며, 일관성 스위치만으로는 변경되지 않습니다.
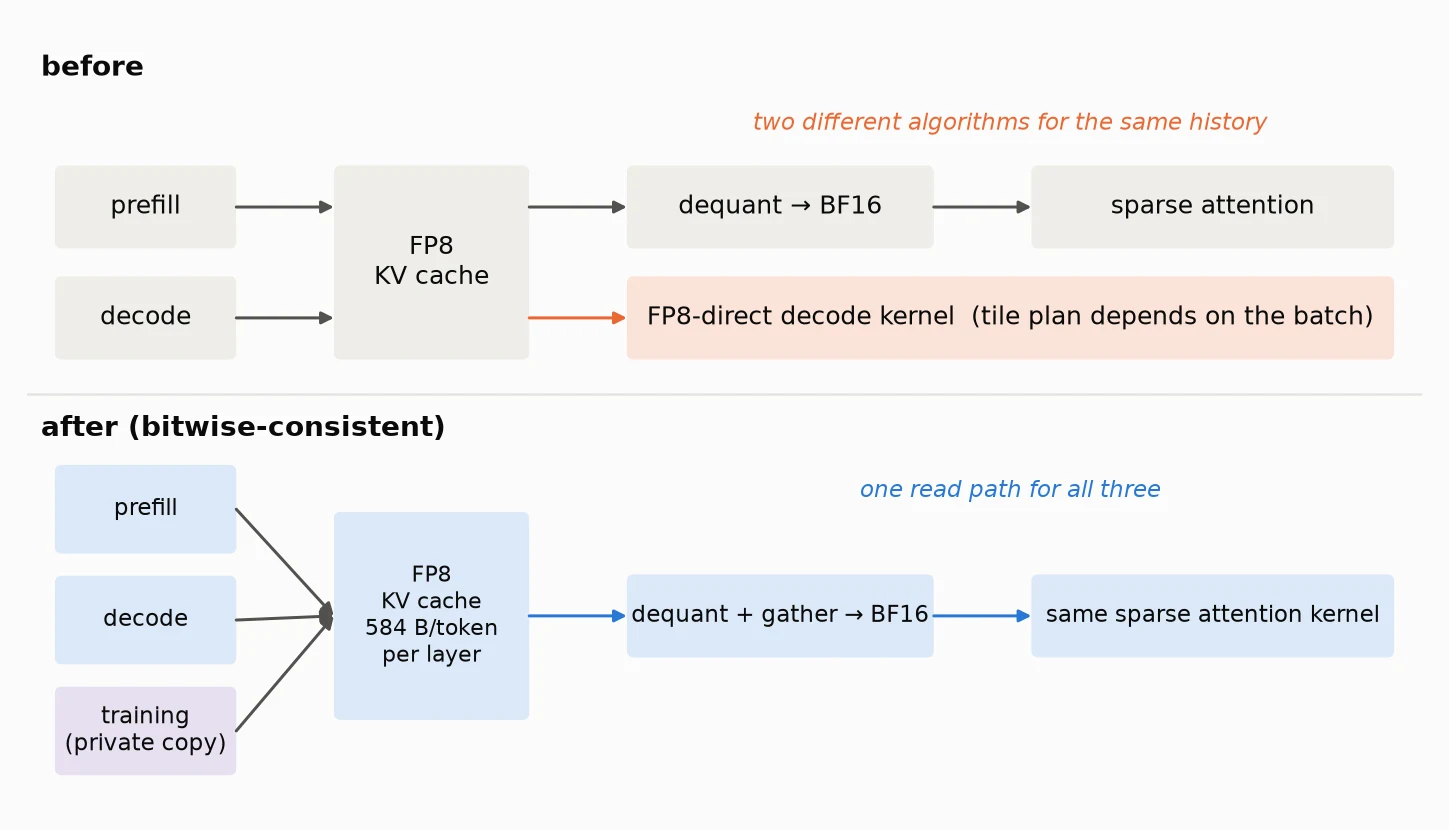
위: 이전에는 프리필과 디코드가 두 가지 알고리즘으로 동일한 FP8 히스토리를 읽었으며, 디코드의 파티션은 배치에 따라 달라졌습니다. 아래: 프리필, 디코드, 학습(전용 캐시 복사본 사용)이 하나의 읽기 경로를 공유합니다.
학습에는 실제 캐시가 없지만, K는 동일한 FP8 왕복을 거쳐야 합니다: 동일한 퓨전 커널이 이를 전용 FP8 캐시에 기록하고, 동일한 역양자화가 이를 다시 읽어옵니다.
비용. 디코드는 gather와 역양자화를 추가하고, 학습은 캐시를 추가합니다. 이것이 단계 일관성의 대가이며, 저장 정밀도는 그대로 유지됩니다. 현재 각 요청은 단계당 토큰을 하나 생성합니다. multi-token prediction(MTP)과 speculative decoding은 다루지 않습니다.
4.3 희소 어텐션의 Top-K: 동점 처리와 순서 수정
문제. DSA 인덱서는 모든 history 위치에 점수를 매기고, Top-K는 어텐션을 위해 최대 2048개를 선택합니다. 이 이산적 선택은 상위 스트림의 one-ulp 차이를 서로 다른 컨텍스트로 바꿔버립니다. 점수 계산이 먼저 정렬됩니다: 인덱서는 동일한 DeepGEMM 커널을 사용하며, prefill은 연속된 KV를 읽고 decode는 paged KV를 읽지만 두 읽기는 비트 단위로 동일합니다.
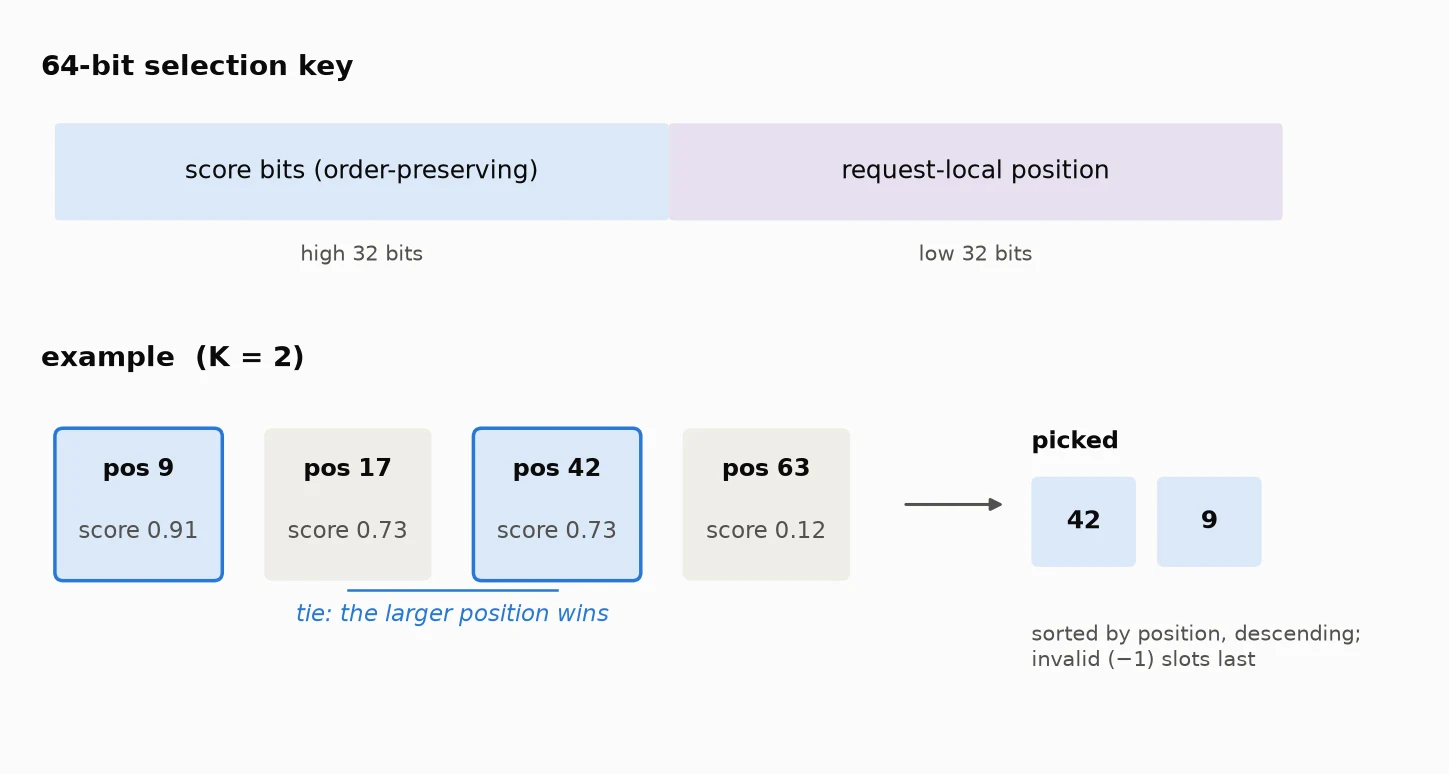
위: 64비트 selection key의 레이아웃. 아래: K = 2인 예시로, 위치 17과 42가 동률이고 key의 position 비트가 42를 선택합니다. 선택된 위치들은 이후 위치 내림차순으로 정렬되며, 유효하지 않은 항목은 마지막에 둡니다.
선택과 순서 고정. 기본 Top-K는 스레드 스케줄링에 따라 동률을 깹니다. 일관된 버전은 점수와 요청 내 위치를 고유한 key로 결합하여, 동률 시 더 큰 위치가 이기도록 합니다. 전역 배치 위치가 아닌 요청 내 위치를 사용합니다. 그렇지 않으면 배치 내에서 요청을 이동하면 동률 결과가 달라집니다. 동일한 집합만으로는 충분하지 않습니다. 인덱스 순서가 어텐션의 누적 순서를 결정하므로, 선택된 인덱스는 위치 내림차순으로 정렬되고 유효하지 않은 항목은 마지막에 둡니다.
R3 스타일의 대안은 rollout의 인덱스를 기록했다가 학습에서 재생(replay)하는 것이지만, 이는 토큰당 레이어당 최대 2048개의 인덱스입니다. 긴 응답의 경우 시퀀스당 GB 규모가 됩니다.
학습 측면. 학습 forward는 동일한 점수 계산과 Top-K로 동일한 위치를 선택하지만, 인덱서는 주로 단순함을 위해 학습되지 않습니다. 이는 기존 관행과 일치합니다: DeepSeek-V3.2 는 DSA 학습 시 인덱서의 입력을 detach하여 RL 손실이 인덱서에 도달하지 않게 하고, GLM-5 는 RL에서 기본적으로 인덱서를 freeze합니다.
비용과 회복. 각 측면은 정렬을 한 번 더 수행합니다. 결정론적 Top-K는 호출당 약 5.9 µs가 걸리며, 이를 인덱스 정렬과 융합하면 일관된 버전의 추론 벤치마크 처리량이 6.7% 향상됩니다 (구성은 4.4 참조). 남은 비용은 prefill에서 요청별로 여러 번의 launch입니다.
4.4 Expert GEMM: 두 레이아웃, 동일한 행 결과
유지. 라우팅된 expert들의 FP8 grouped GEMM이 MoE 레이어를 지배하며, 두 측면이 서로 다른 레이아웃으로 이를 입력합니다. Rollout은 DeepEP low-latency (LL) 모드를 사용하고(이유: 4.5), 이는 청크별 고정 capacity를 갖는 expert별 청킹된 masked 레이아웃을 제공합니다. 학습은 DeepEP normal 모드로 많은 토큰을 처리하며, 이는 expert별로 패킹된 연속 레이아웃을 제공합니다.
백엔드 선택. 양쪽 일관된 측면은 batch-invariant 모드의 DeepGEMM을 사용합니다. 오픈 소스이고, batch-invariant 모드를 갖추고 있으며, 고성능 배포 커널이기 때문입니다. 베이스라인의 FlashInfer TRT-LLM MoE는 사전 컴파일된 cubin으로 배포되어 수정할 수 없고 batch-invariant 여부도 검증할 수 없습니다. cutlass는 block-FP8이 없고, triton은 batch invariance를 선언하지 않는 배치 구현에 빠집니다. 단일 expert GEMM의 소요 시간은 양쪽이 거의 같으며, 베이스라인이 더 빠른 이유는 TRT-LLM MoE가 multi-stream 파이프라인에서 통신과 연산을 겹치기 때문입니다.
두 레이아웃에서 동일한 행 결과. 세 가지 조건이 성립해야 합니다:
- Expert들이 동일한 FP8 입력을 받는다. LL은 dispatch 시에 quantize하고 normal 모드는 그 이후에 quantize하며, 원래는 반올림 방식이 달랐습니다. 우리는 양쪽을 elementwise round-to-nearest로 통일했습니다.
- 각 행의 결과가 레이아웃에 독립적이다. Quantization은 토큰별이고 batch-invariant DeepGEMM은 각 행을 고정된 방식으로 누적하므로, 한 행의 결과는 이웃에 의존하지 않습니다. 비트 단위 router + MoE 테스트가 이를 확인합니다.
- 활성화는 한 번 반올림된다. 두 GEMM 사이의 SiLU(gate) × up은 FP32로 계산되고 곱만 BF16으로 반올림된 뒤 FP8으로 quantize됩니다. 곱셈 전에 SiLU를 BF16으로 반올림하면 one ulp만큼 달라질 수 있으며, 이를 FP8 quantization이 코드 플립으로 증폭시킵니다.
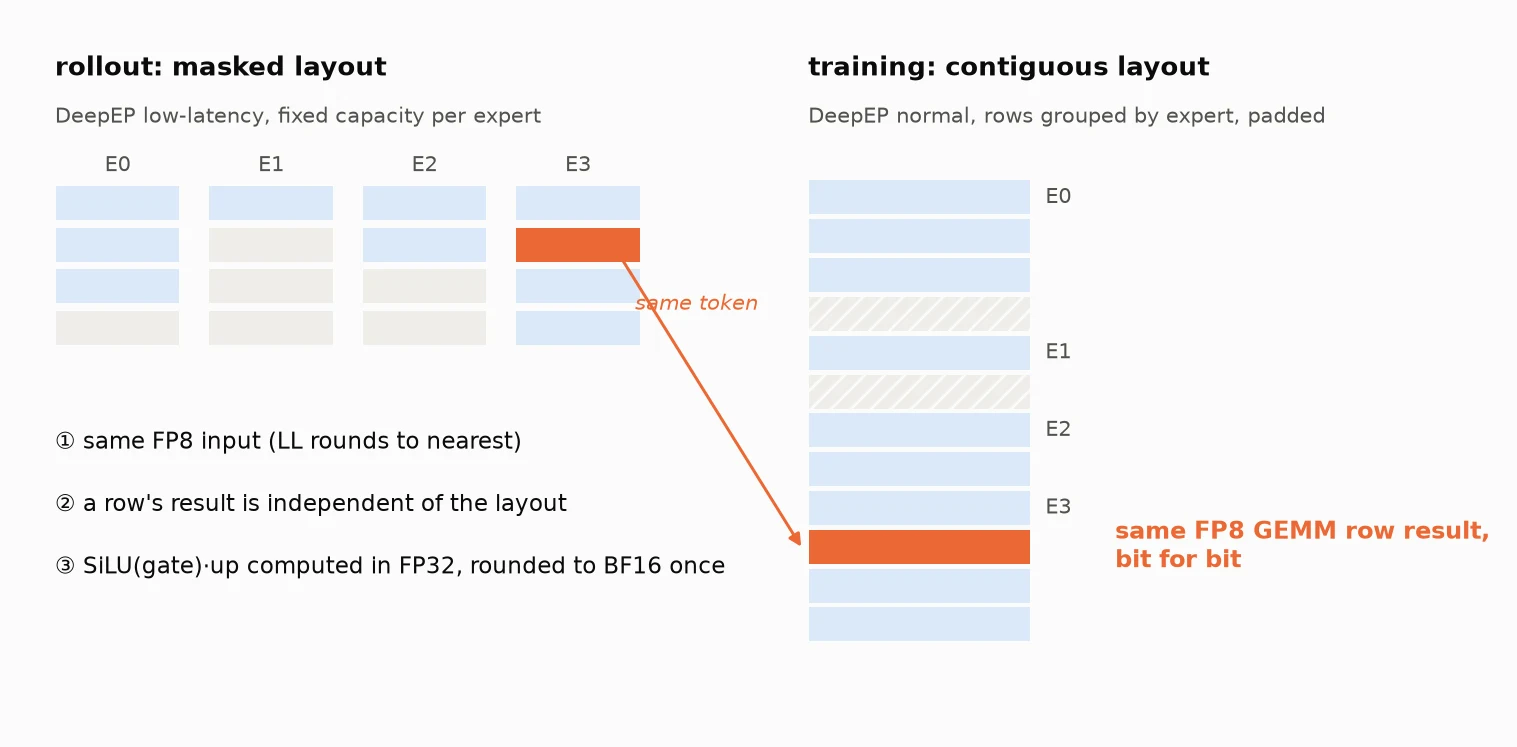
동일한 토큰(주황색)이 rollout의 masked 레이아웃과 학습의 contiguous 레이아웃에서 서로 다른 위치에 있지만, 세 가지 조건이 그 expert GEMM 결과를 비트 단위로 동일하게 만듭니다. 회색: 빈 슬롯; 빗금: 정렬 패딩.
R3 불필요. Router의 점수 계산 GEMM은 모든 배치 크기에서 비트 단위로 동일한 입력에 대해 단일 FP32 출력 커널을 사용하므로, 재계산된 라우팅이 rollout과 일치합니다. 이는 스텝당 1 update를 가정합니다 (Section 2).
비용. 롤아웃은 TRT-LLM MoE를 포기하지만, GEMM이 격차의 대부분은 아닙니다. 추론 벤치마크(GB200, DP8/EP8, 동시성 256, 요청당 입력 150 / 출력 3000)에서 일관 버전은 기준선보다 33% 느리게 시작했으며, 그중 약 83%는 겹칠 수 없는 LL 통신(4.5)에서 비롯되었습니다. 학습은 역전파를 위해 중간값을 저장하고 각 전문가의 행을 패딩합니다. 아래의 추론 벤치마크 수치는 서로 다른 최적화 단계에서 나온 것이므로 같은 문장 안에서만 비교해야 합니다.
성능을 비교하기 전에 기준선이 어떤 커널을 실행하는지도 확인하십시오. vLLM은 공유 라이브러리가 존재하면 일관성 스위치와 무관하게 배치 불변(batch-invariant) SiLU·mul·양자화 커널을 활성화하므로, 해당 라이브러리를 포함하는 이미지는 기준선에서도 이 커널을 실행합니다.
4.5 GPU 간 reduction: 비교 경로 밖
문제. 롤아웃은 낮은 지연 시간을 원하므로 DP8/EP8을 사용하고, 학습은 긴 시퀀스 활성값을 수용해야 하므로 EP32와 CP4를 사용합니다. 2절에서 언급했듯이, 서로 다른 레이아웃은 병렬화 차수에 불변인 결과가 필요하며, 이는 보통 고정되고 비용이 많이 드는 reduction 트리를 통해 이루어집니다.
선택. 이 레시피는 GPU 간 reduction을 비교 대상인 수치 경로에서 제외하고, 나머지 통신은 값을 변경하지 않고 데이터를 이동합니다:
- TP=1. 선형 레이어에는 all-reduce가 없습니다. vLLM의 all-reduce는 메시지 크기에 따라 알고리즘을 선택하므로 TP를 사용하면 그 의존성이 다시 생기고, 이 레시피는 시작 시 TP>1을 거부합니다.
- EP 병합은 로컬에서 이루어집니다. all-to-all은 데이터를 이동만 합니다. 전문가 출력은 토큰을 소유한 랭크로 반환되며, top-k 슬롯 순서대로 FP32로 누적되는데, 이는 EP=8 vs 32 또는 어느 랭크가 먼저 응답하는지와 무관합니다.
- CP는 reduction을 수행하지 않습니다. 인접 랭크들은 경계 hidden state만 교환하며, 압축된 KV는 CP 그룹 내에서 all-gather 됩니다: 합산이 아닌 연결입니다.
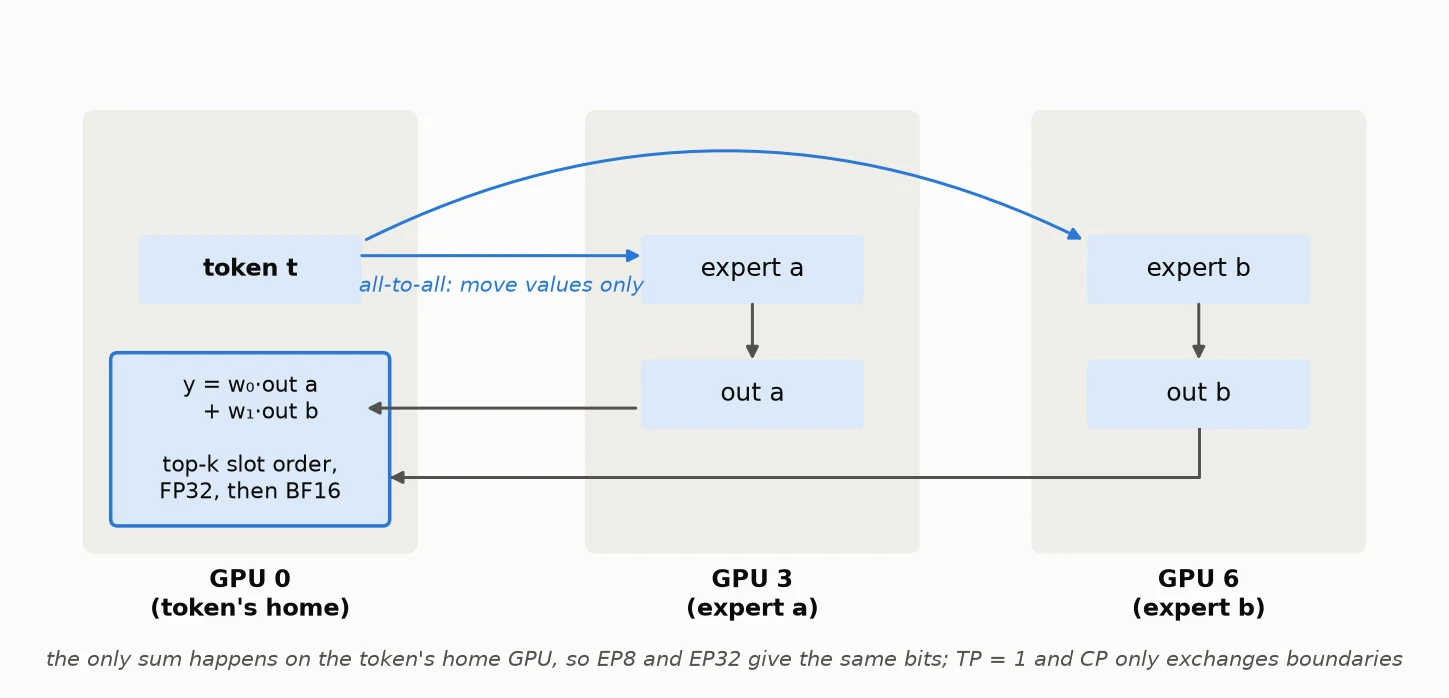
한 토큰의 경로: all-to-all은 데이터를 이동만 하고, 유일한 합산은 토큰을 소유한 GPU에서 top-k 슬롯 순서대로 FP32로 발생하므로, EP8과 EP32는 동일한 결과를 줍니다.
데이터 이동을 결정론적으로 만들기. 롤아웃에서는 각 랭크가 호출당 최대 고정 개수의 토큰을 전송하고 모든 랭크가 동기화된 방식으로 세그먼트화하므로, 통신 형태가 고정됩니다. 이를 구현하는 것은 LL뿐이며, DeepEP normal 모드는 DP>1일 때 CUDA Graph를 비활성화하므로 롤아웃은 LL을 사용해야 합니다. 학습 시에는 normal 모드에 고정된 도착 순서가 없으므로, 라우팅 메타데이터를 한 번 더 디스패치하고 비트 단위 해시로 각 전문가 출력을 해당 토큰과 슬롯에 매칭합니다.
비용과 복구. LL 모드는 스텝당 43 레이어 × 2 = 86회의 직렬 all-to-all을 실행하며, 이는 연산과 겹칠 수 없습니다. 우리가 시도한 교차 레이어 겹침 방식들은 입력이 준비되기 전에 연산을 수행하여 배치 독립성을 깨뜨렸습니다. 두 마이크로 배치를 인터리빙하는 방식(DBO)은 39% 더 느렸습니다: 각 레이어의 전문가 가중치를 두 번 읽게 되는데, 가중치 읽기가 이미 HBM 대역폭의 84%를 사용하고 있기 때문입니다.
결국 우리는 추론 벤치마크에서 통신 격차를 해소했습니다. 먼저 두 실행이 동일한 전송 계층을 사용하는지 확인하십시오: 한 스크립트가 consistent 버전의 DeepEP을 Ethernet RDMA(RoCE)로 고정한 반면 베이스라인은 훨씬 빠른 MNNVL을 사용하여 이틀을 낭비했습니다. 전송 계층을 일치시키고 공유 전문가를 보조 스트림에 두었을 때, consistent 버전은 베이스라인보다 3.2% 빨랐습니다(16834 vs 16313 tok/s).
TP>1과 디코드 컨텍스트 병렬화는 GPU 간 reduction을 비교 대상 경로에 다시 도입하게 되며, 아직 지원되지 않습니다.
4.6 CUDA Graph: 그래프를 유지하고 일관성과 공존시키기
그래프를 유지하는 이유. 디코드는 요청당 한 토큰으로 레이어당 스텝당 수십 개의 작은 커널을 실행하므로, 커널 실행 오버헤드가 지배적이 될 것입니다; 성능 목표를 달성하기 위해 우리는 CUDA Graph를 유지합니다. 그래프는 세 곳에서 비트 단위 일관성과 충돌합니다.
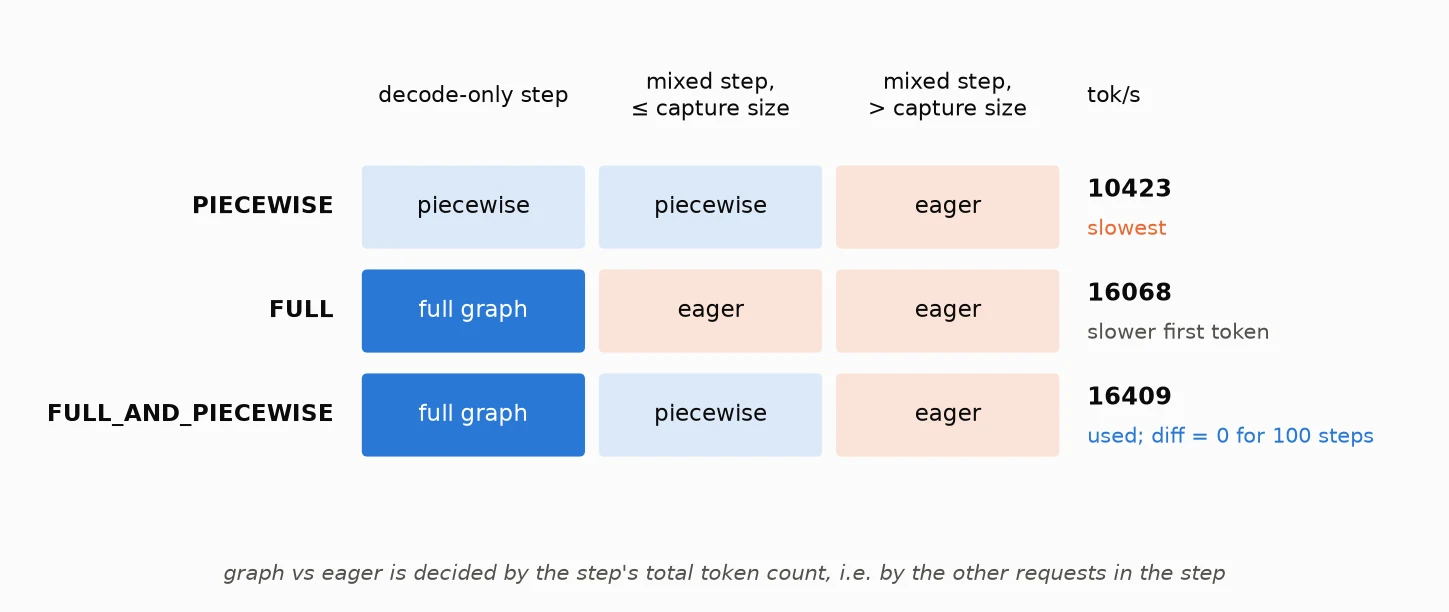
세 종류의 스텝에 대해 각 모드가 취하는 경로, 오른쪽에 추론 벤치마크 처리량 표시. 요청은 배치에 따라 그래프와 이가(eager) 모드 사이를 전환하므로, 두 경로는 비트 단위로 동일해야 합니다.
충돌 1: 그래프 또는 이가(eager). 스텝의 총 토큰 수가 최대 캡처 크기에 맞으면 그래프로, 그렇지 않으면 이가 모드로 실행되는데, 이는 해당 스텝의 다른 토큰에 좌우되므로 두 경로는 비트 단위로 동일해야 합니다. 그것이 우리의 첫 번째 불일치였습니다: 인덱서의 짧은 컨텍스트 숏컷이 캡처 시 더미 입력의 길이를 기반으로 그래프에 박제되어 있었습니다. 검사를 정적 상한에만 의존하도록 만들어 해결했습니다.
모드도 중요합니다. PIECEWISE는 attention을 캡처하지 않고, DeepSeek-V4에서 FULL은 순수 디코드 스텝만 캡처합니다. 추론 벤치마크에서 FULL_AND_PIECEWISE는 16409 tok/s, FULL은 16068, PIECEWISE는 10423을 기록합니다; FULL은 프리필과 섞인 모든 스텝을 이가 모드로 실행하여 첫 토큰까지의 시간이 764 ms에서 1792 ms로 증가합니다. 우리는 FULL_AND_PIECEWISE를 사용합니다: 순수 디코드 스텝에는 전체 그래프, 혼합 스텝에는 부분 캡처; 100스텝 실행 전체에서 diff는 0으로 유지됩니다.
충돌 2: 그래프 내에서 호스트 동기화 또는 배치 의존적 형태 금지. 이것은 일관성과 부합하며, 많은 설계가 양쪽에 모두 적용됩니다: MoE 스케줄링 힌트는 전문가별 토큰 수를 호스트로 읽어오는 대신 정적 capacity를 사용하고(4.4); LL은 통신 형태를 고정하고(4.5); 워크스페이스는 모델 한계에 의해서만 크기가 정해지며, 캡처 전에 할당된 후 잠깁니다; 성능 전용 숏컷 분기는 캡처 시점에 비활성화됩니다.
충돌 3: 그래프는 주소를 캡처하지만 가중치는 매 스텝 변경됨. 롤아웃은 새 가중치를 원래 저장소에 복사하고 가중치에서 파생된 파라미터를 제자리에서 재계산해야 하며, 그래프가 오래된 주소에 남게 되는 새 메모리를 할당해서는 안 됩니다. 첫 스텝에서의 일치만으로는 부족하므로, 스킬은 업데이트, 내보내기 및 다시 불러오기 후에 다시 비교합니다.
비용. 상한으로 예약된 워크스페이스는 약간의 메모리를 소모합니다. 기타 속도 복구 항목들(불필요한 디버그 패딩 제거, 롤아웃의 콜드 스타트 제거, 더 빠른 KV 캐시 영재로화)은 양쪽 실행에 모두 적용됩니다; 베이스라인도 이를 적용받아야 하며, 그렇지 않으면 성능 손실 수치는 무의미합니다.
5. Agent + skill로 엔지니어링 비용 낮추기
A와 B는 공존할 수 있지만, 섹션 4의 마스터 테이블과 그 안의 핵심 선택들은 전문가의 판단을 필요로 합니다: 어떤 백엔드가 배치 불변인지, 이산적 선택에 정렬된 동점 처리와 순서가 필요하다는 점, 서로 다른 통신 모드 간에 양자화와 병합 순서를 어떻게 정렬하는지, 그리고 통신 격차는 우선 전송 계층 차이를 배제해야 한다는 점. 새로운 모델, 정밀도 또는 하드웨어는 처음부터 다시 시작해야 함을 의미하므로, C는 성립하지 않습니다.
DeepSeek-V4-Flash 이후, 우리는 이 작업의 대부분이 각각 측정 가능한 목표를 가진 두 범주로 나뉜다는 것을 알게 되었습니다:
- diff를 0으로 만들기. 가중치와 입력을 고정하고, 양쪽이 갈라지는 첫 번째 연산자를 찾아, 최소한의 재실행 가능한 재현 사례로 줄인 후, 수정하고, 실제 학습에서 검증합니다. 출력은 직접 비교됩니다.
- diff를 0으로 유지하면서 성능 최적화하기. 핫스팟을 프로파일링하고, A/B 단일 연산자 비교를 수행하며, 변경이 있을 때마다 일관성을 재검증하십시오. 결과를 바꾸는 속도 개선이나 마이크로 벤치마크에서만 나타나고 실제 배포에서는 나타나지 않는 속도 개선은 인정되지 않으며, 격차를 줄이기 위해 베이스라인을 느리게 만드는 것도 허용되지 않습니다.
코드를 읽고, 호출 체인을 추적하고, 차이 지점을 찾아내고, 재현 코드를 작성하고, 커널을 수정하고 회귀 테스트를 다시 실행하는 것은 장시간 진행되는 작업으로 에이전트에 적합하며, 성공 여부는 일관성 비교와 성능 측정으로 판단됩니다.
우리는 이것을 train-inference-consistency 스킬로 패키징했습니다: 이 스킬은 에이전트에게 무엇을 어떤 순서로 해야 하는지, 그리고 각 단계가 통과하기 위해 무엇에 도달해야 하는지 알려주므로, 이 프로세스를 다른 모델에도 적용할 수 있습니다.
이 스킬에는 명시적인 통과 조건이 있는 11개의 게이트(C0–C10)가 있습니다. 콜드 스타트를 가속화하기 위해, 우리는 먼저 전체 모델에서 몇 개의 레이어를 잘라 소형 모델을 만들어 대부분의 문제를 그곳에서 해결한 뒤, 전체 모델로 이동합니다. 다섯 단계:
- 목표와 베이스라인을 설정합니다(C0–C1). 모델의 모듈을 정밀도 및 병렬화와 함께 나열합니다. 일반적인 비일관성(non-consistent) 버전(베이스라인)을 사람 검토를 위한 정상적인 고성능으로 튜닝합니다. 이것이 "일관성 버전이 얼마나 느린가"의 분모가 됩니다.
- 소형 모델에서 추론의 자기일관성을 확보합니다(C2–C4). 소형 모델(보통 전체 모델에서 선택한 4–6개 레이어)은 모든 연산자 클래스를 포함하고, 인접 레이어 간 상호작용을 유지하며, 레이어별 크기와 양자화가 일치해야 대부분의 국소적 수치 문제를 재현할 수 있습니다. 전체 깊이, 긴 컨텍스트, 다중 GPU 배치, 메모리 압박은 여전히 전체 모델에서 검증되어야 합니다. 먼저 추론 엔진이 내부적으로 일관되도록 만듭니다: 하나의 요청이 단독 실행과 배치 실행에서 동일한 결과를 내고, 전체 입력 처리가 토큰 단위 처리와 일치합니다. 동시에 일관성 버전을 느리게 만들 수 있는 구조적 문제를 찾습니다.
- 훈련을 연결합니다(C5–C7). 훈련은 추론과 동일한 연산자를 호출하고, 추론이 생성한 데이터를 재계산하며, 토큰 단위로 비교합니다. 불일치가 있으면 첫 번째로 갈라지는 레이어를 찾기 위해 레이어별로 비교합니다. 그런 다음 backward를 추가하고, 테스트 대상 코드와 독립적인 참조 구현(reference implementation)과 기울기(gradient)를 대조합니다: forward가 일관되다고 해서 기울기가 올바르다는 보장은 없습니다.
- RL을 실행한 뒤 전체 모델로 전환합니다(C8–C9). 소형 모델에서 실제 훈련 프레임워크로 두 번의 연속 업데이트를 실행하며, 각 업데이트 전후에 동일한 가중치 버전으로 비교합니다. 사람 검토 후 전체 모델로 전환하여 단계적으로 확장하고, 체크포인트 복원 직후의 첫 단계 검증도 포함합니다.
- 성능을 회복합니다(C10). 가장 비용이 큰 연산자부터 하나씩 최적화하면서 매번 일관성을 재검증하고, 마지막으로 배포 이미지에서 베이스라인과 쌍대 비교(paired comparison)를 실행합니다.
두 가지 설계가 가장 중요합니다. 첫째, 두 개의 에이전트가 베이스라인과 일관성을 병렬로 진행합니다: 하나는 베이스라인을 빠르게 만들고, 다른 하나는 일관성 버전을 구축합니다. 튜닝된 베이스라인은 사람 검토를 위해 동결되므로, 에이전트가 격차를 줄이기 위해 베이스라인을 느리게 만들 수 없습니다. 둘째, 우리가 겪은 함정들이 프로세스에 기록되어 있습니다: 실행 중인 프로그램이 읽고 있는 소스와 일치해야 하고, 체크포인트는 저장만이 아니라 복원 후 첫 단계 검증이 필요하며, 모든 성능 결론에는 공정한 베이스라인과 추적 가능한 원본 데이터가 필요하고, 통신 병목을 비교하기 전에 양쪽 실행이 동일한 전송 방식을 사용하는지 확인해야 합니다(4.5에서 얻은 교훈).
이 스킬은 문제 위치 파악과 회귀 검사 비용을 낮춥니다(여기서는 절감액이 아직 정량화되지 않았습니다). 그러나 사람의 판단을 대체하지는 않습니다: 베이스라인, 정밀도 트레이드오프, 레시피는 여전히 사람이 검토합니다. 한 사례가 단계당 여러 번의 업데이트로 인한 라우팅 드리프트(routing drift)입니다: 에이전트가 증상으로부터 소규모 재현 환경을 만들고 판별 실험을 수행하며 가설을 배제했고, 사람이 단계당 1회 업데이트로 전환하기로 결정했습니다.
6. 전이(Transfer): Nemotron, Mamba 하이브리드 아키텍처 + NVFP4
이어서 구조적으로 매우 다른 모델에서 이 참조 레시피와 스킬을 테스트했습니다.
Nemotron-3.5-Lightning-30B-A3B (NVFP4) 는 GB200에서 구동되는 Mamba-2 / attention / MoE 하이브리드입니다(NVFP4 W4A16 라우티드 전문가, FP8 Mamba 프로젝션, attention용 FP8 KV 캐시). 베이스라인은 NVFP4 QAT 훈련(양자화 규칙과 내보내기는 NVIDIA ModelOpt 사용) + R3 라우트 리플레이를 사용하고, 일관성 버전은 라우트 리플레이 없이 vLLM의 forward를 공유합니다. 두 실행 모두 BF16 마스터 가중치와 단계당 1회 업데이트를 사용합니다.
순환 구조에는 선례가 있습니다. vLLM 커뮤니티에서 Alexander Jiang과 SkyRL 팀은 Qwen3.5-35B-A3B의 Gated DeltaNet(GDN)을 위해 IsoExec Qwen3.5-35B-A3B의 Gated DeltaNet(GDN)의 경우: 순환 형태는 유지하되 청크 병렬로 계산하여 훈련, prefill, 디코드가 하나의 반올림 순서를 공유하며, 그 unified model 은 훈련과 추론에 하나의 모델 정의와 하나의 정렬된 커널 집합을 제공합니다. IsoExec의 "제로 불일치"는 그 실행 계약(execution contract) 내에서 성립하며, 종단 간으로는 여전히 아주 작은 비영(nonzero) logprob 차이(평균 절대 차이 약 1e-7)를 보고합니다. 이는 이 글의 "비트 단위 동일(bitwise identical)"과 다릅니다. Mamba-2도 같은 종류의 선형 순환입니다. 우리는 디코드가 자체 단일 스텝 순환 대신 prefill의 청크 산술을 정확히 재현하도록 만들고, 훈련이 unified model에서와 같이 추론과 동일한 연산자를 임포트하도록 했습니다. 이 정렬을 에이전트 + 스킬이 수행했습니다.
vLLM에서는 배치 구성에 의존할 수 있는 모든 연산자에 배치 불변(batch-invariant) 구현이 제공되며, 훈련(경량 Megatron-LM 포크)이 이를 임포트합니다:
| 연산자(Operator) | 일관된 버전 |
|---|---|
| Mamba-2 SSD 스캔 | 디코드는 프리필의 청크 연산을 정확히 재현, 고정 autotune 구성, fp32 상태 |
| 어텐션(Attention) | 고정 split-KV를 사용하는 FlashAttention, split 횟수는 배치와 무관 |
| 라우티드 전문가 (NVFP4 W4A16: 4비트 가중치, 16비트 활성화) | CuTe-DSL 그룹 GEMM, 단일 tactic, split-K 없음, 슬롯 순서대로 fp32 병합 |
| MoE 올투올(all-to-all) | 일방향 통신, 고정 병합 순서 |
| 라우터 GEMM | 배치 불변 persistent matmul, fp32 출력 |
| 정규화 / FP8 양자화 | 통합된 배치 불변 커널; 값을 변경하는 퓨전 금지 |
결과: SWE-bench Pro 학습
우리는 SWE-bench Pro에 대해 원격 샌드박스에서 에이전틱 RL을 수행합니다: 스텝당 32개 태스크 × 8개 궤적, 궤적당 평균 약 57K 토큰, GRPO, 실행당 8 GB200 노드. 학습 세트는 베이스 모델의 4회 샘플링 시도가 전부 정답도 전부 오답도 아니었고 gold patch가 우리 샌드박스에서 통과한 375개 SWE-bench Pro 태스크이므로, 아래 점수는 이 부분집합에 대한 학습 보상입니다. 두 실행 모두 동일한 이미지와 레시피를 사용하며, TIS나 MIS 같은 보정은 적용하지 않았습니다. 스텝당 1회 업데이트에서 업데이트 전 rollout logprobs와 학습 측 재계산 간의 KL이 해당 스텝의 train-inference KL입니다.
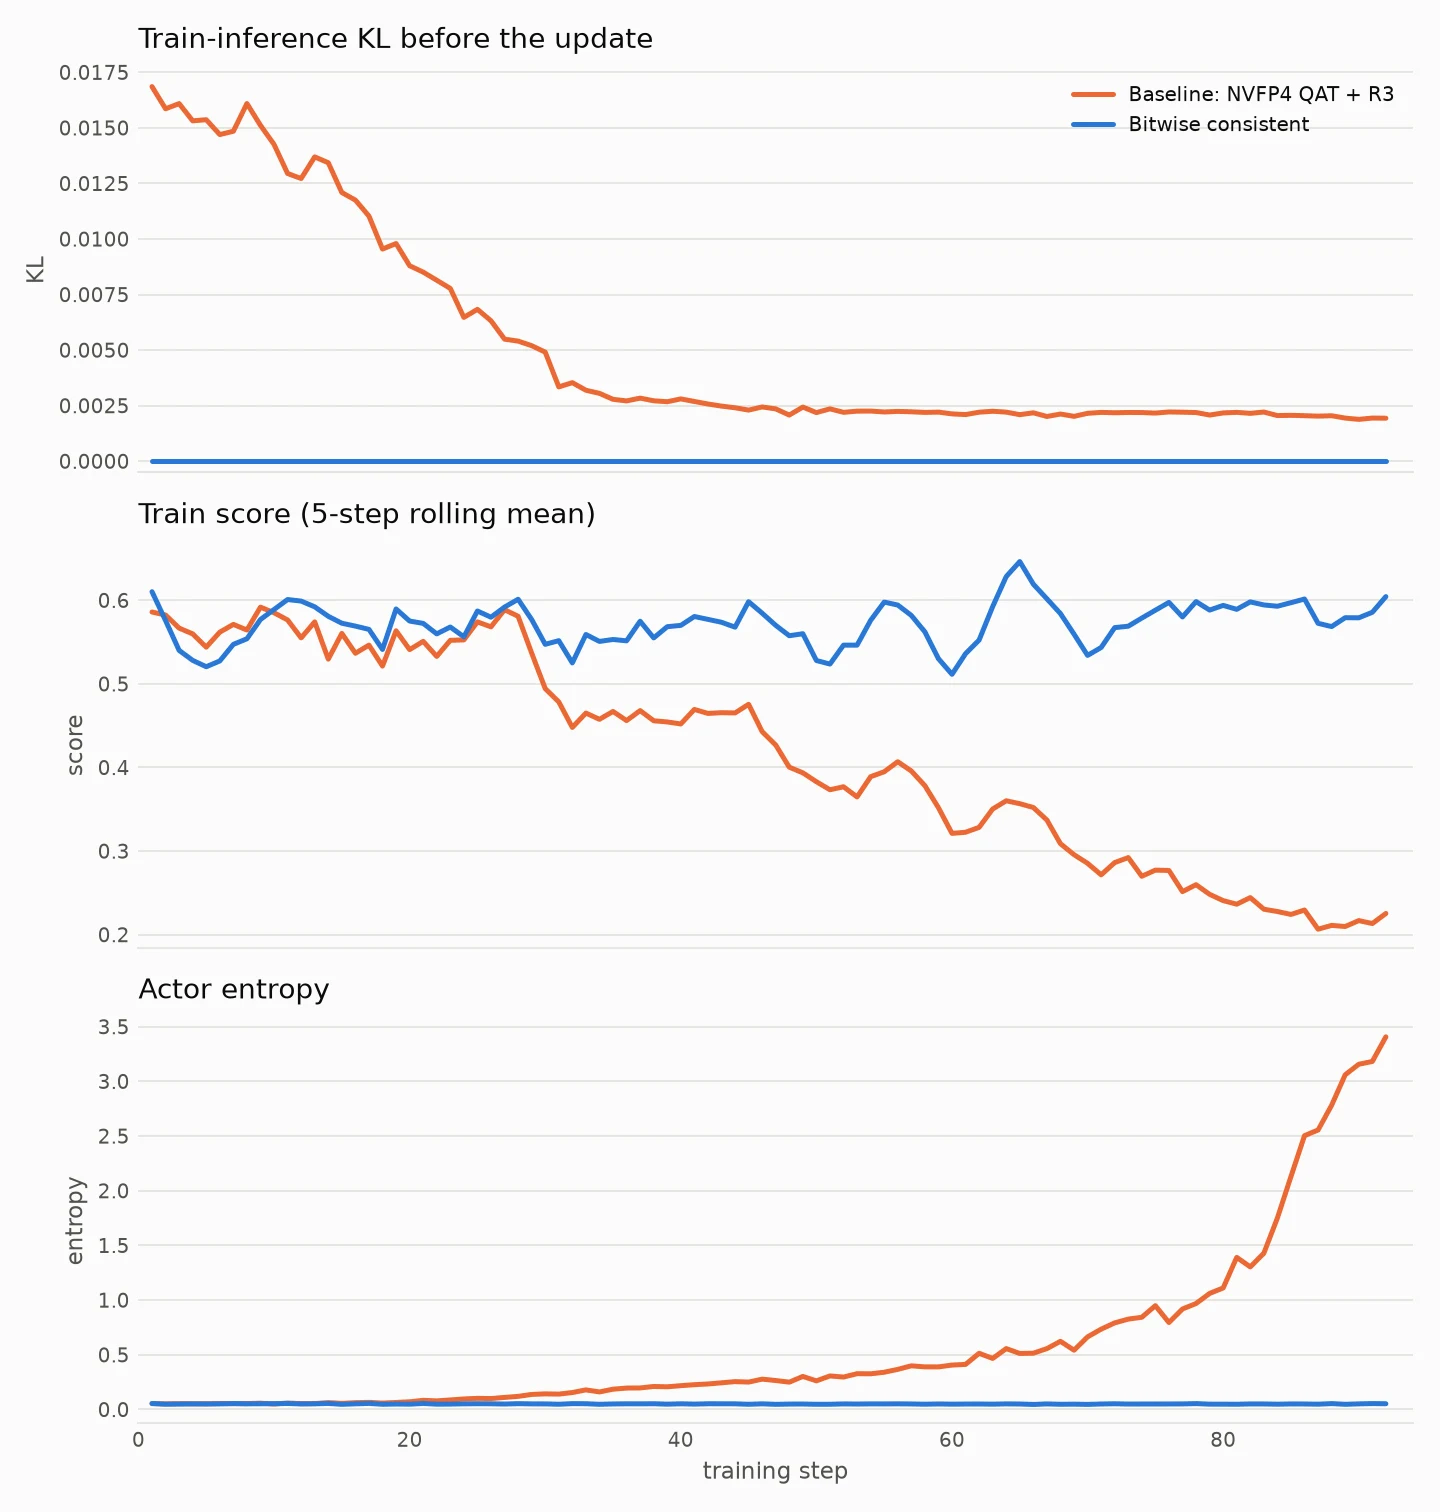
위: 스텝별 train-inference KL; 중간: 학습 점수(현재 및 이전 4개 스텝의 이동 평균); 아래: actor 엔트로피. 주황색: 베이스라인; 파란색: consistent version. consistent version의 스텝 10에서는 샌드박스에서 돌아온 궤적이 몇 개뿐이었으므로 해당 점수는 제외했습니다.
- Consistent version: train-inference KL은 매 스텝 정확히 0이고, 엔트로피는 약 0.05로 유지되며, 점수는 하락 없이 0.56(첫 10 스텝)에서 0.59(마지막 10 스텝)로 향상됩니다.
- Baseline: train-inference KL은 ~0.015에서 ~0.002로 하락하지만, 엔트로피는 0.05에서 2.6으로 상승하고 점수는 0.56에서 0.22로 하락합니다(첫 10 스텝 vs. 마지막 10 스텝).
- rollout speed: 두 실행이 모두 정상인 첫 30 스텝 동안, consistent version의 rollout 처리량은 베이스라인의 87.5%로 겨우 12.5% 느립니다.
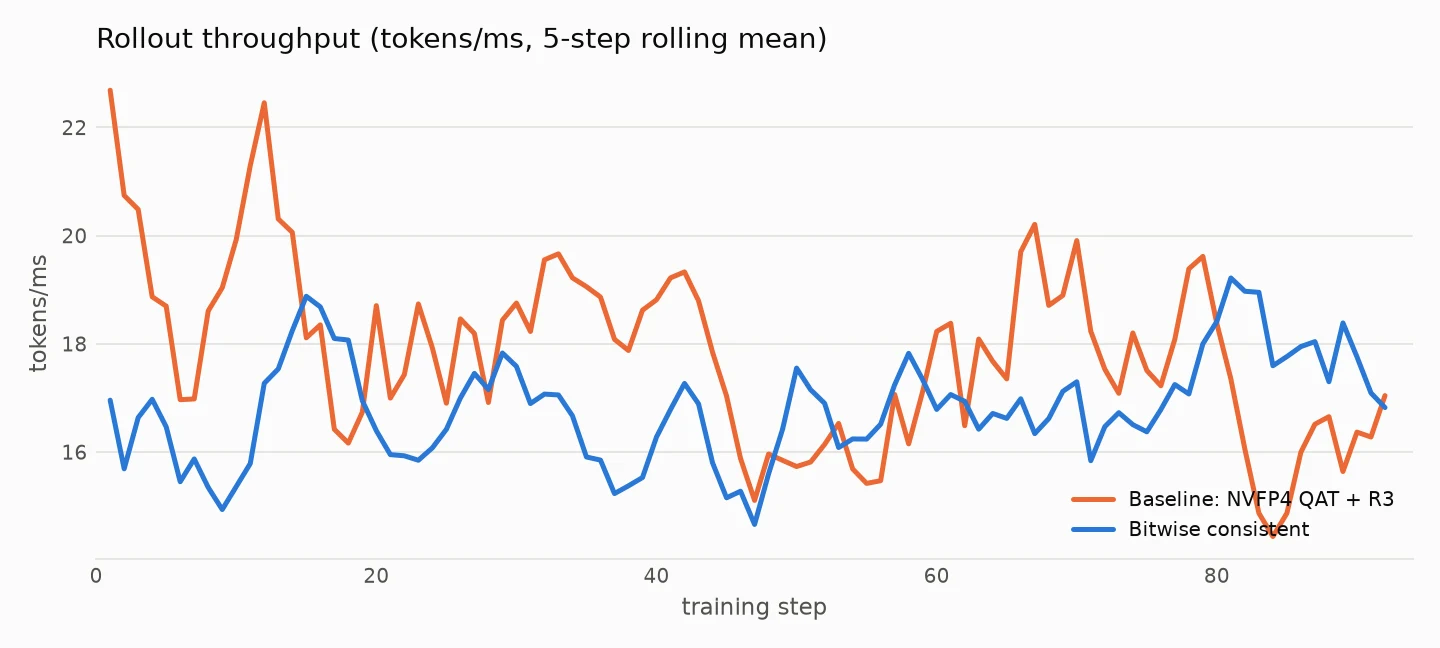
스텝별 rollout 처리량(token/ms, 현재 및 이전 4개 스텝의 이동 평균). 주황색: 베이스라인; 파란색: consistent version.
7. 오픈소스
우리는 이것을 오픈소스로 공개하여, 다른 사람들이 연구자가 오퍼레이터를 하나하나 검사하는 것에 덜 의존하면서도, 자신의 모델에서 이 스킬과 바로 쓸 수 있는 코드, 에이전트를 활용해 train-inference 일관성을 달성할 수 있도록 합니다. 공개 내용:
- train-inference-consistency 스킬: 전체 워크플로(C0–C10), 10개 가이드, logprob 비교 및 gradient 교차 검증 같은 핵심 실천 방법;
- DeepSeek-V4: Megatron과 vLLM에서 0 diff에 도달하는 진정한 on-policy RL 레시피, verl-project/verl#7688;
- Nemotron-3.5-Lightning-30B-A3B (BF16 마스터 웨이트, 학습 forward와 웨이트 싱크 시 배포용 NVFP4로 양자화):
- 학습과 bitwise 일치하는 vLLM 추론: aoshen02/vllm#85;
- vLLM과 정렬된 학습 actor: aoshen02/Megatron-LM#7;
- verl 변경 2건: aoshen02/verl#11;
- train-inference 일관성 레시피 및 통합 이미지 Dockerfile: aoshen02/verl#12.
여러분의 모델에서 이 스킬을 사용하면서 생긴 이슈, PR 및 피드백을 환영합니다.
다음: DeepSeek-V4.1에 대한 train-inference 일관성은 0 diff에 도달했으며, 성능 최적화가 진행 중이고 별도의 게시물로 다룰 예정입니다.
감사의 말
다음 분들께 감사드립니다(기관명 가나다순/알파벳순):