
생각
요약
Timestral은 Mistral의 첫 번째 시계열 파운데이션 모델 계열로, 단 209M 파라미터만으로 최첨단 확률적 다변량 예측을 제공하며, 과거 및 미래 공변량을 지원하는 동시에 주요 벤치마크에서 더 큰 모델들을 능가합니다. 5M부터 209M 파라미터까지 4가지 크기로 제공되어 정확도와 효율성의 균형을 이루며, CPU에서 효율적으로 실행되고 다양한 도메인에서 제로샷 예측에 탁월합니다. 이 모델은 합성 데이터 사전 학습, 공변량 인식 어텐션, 긴 컨텍스트 학습을 결합했으며, Mistral Forge를 통한 도메인 적응용 파인튜닝 옵션도 제공합니다.
오늘 저희는 첫 번째 시계열 파운데이션 모델 계열인 Timestral을 출시합니다. 단 209M 파라미터를 가진 저희의 가장 큰 모델은 이 분야의 3대 공개 벤치마크인 GIFT-Eval, TIME, fev-bench 전부에서 1위를 차지했으며, 모델 파라미터가 2/3에 불과한 상태로 이전 최고 성능(state of the art)을 능가했습니다.
Timestral은 확률적 다변량 예측을 제공하며 과거 전용 공변량과 알려진 미래 공변량을 지원합니다. 저희 모델 계열은 예측 정확도 대비 모델 크기의 파레토 경계에 위치하여, 각 크기에서 선도적인 성능을 제공합니다. 결과는 GIFT-Eval 및 TIME 리더보드에 제출되었습니다.
시계열 파운데이션 모델 (TSFM)
시계열은 센서 텔레메트리부터 관측 가능성 메트릭까지, 엔터프라이즈에서 가장 흔한 데이터 유형 중 하나입니다. 이를 기반으로 구축된 예측은 용량 계획, 에너지, 공급망, 리스크 및 유지보수의 의사결정을 좌우합니다.
산업 플랜트는 생산 일정에 맞춰 공정 센서를 예측하고, 설비 고장 전에 장비 이상 징후를 포착하며, 수천 개 자산에 걸쳐 용량과 예비 부품을 계획합니다. 금융팀은 수천 개 계좌에 걸쳐 포지션, 헤징, 자금 관리에 활용하기 위해 자금 흐름, 거래량, 변동성을 예측합니다.
ARIMA 및 선형 회귀와 같은 고전적 모델은 시계열 예측을 위한 잘 확립된 도구로 남아 있습니다. 이러한 모델은 보통 단일 시계열에 피팅되며 해당 시계열의 이력에서만 학습합니다.
PatchTST와 같은 딥러닝 모델은 많은 관련 시계열에 걸쳐 비선형 패턴을 학습할 수 있는 능력을 추가하지만, 여전히 각 데이터셋마다 처음부터 학습되는 것이 일반적이므로, 학습한 내용이 새로운 도메인으로 이어지지 않습니다.
시계열 파운데이션 모델은 사전 학습 방식을 시계열에 도입합니다. 대규모이고 다양한 코퍼스로 학습된 저희 모델은 시계열 간에 전이되는 패턴을 학습하여, 한 번도 본 적 없는 데이터에 대해 제로샷으로 예측하며, 데이터가 부족한 도메인에서도 가능합니다.
벤치마크 결과
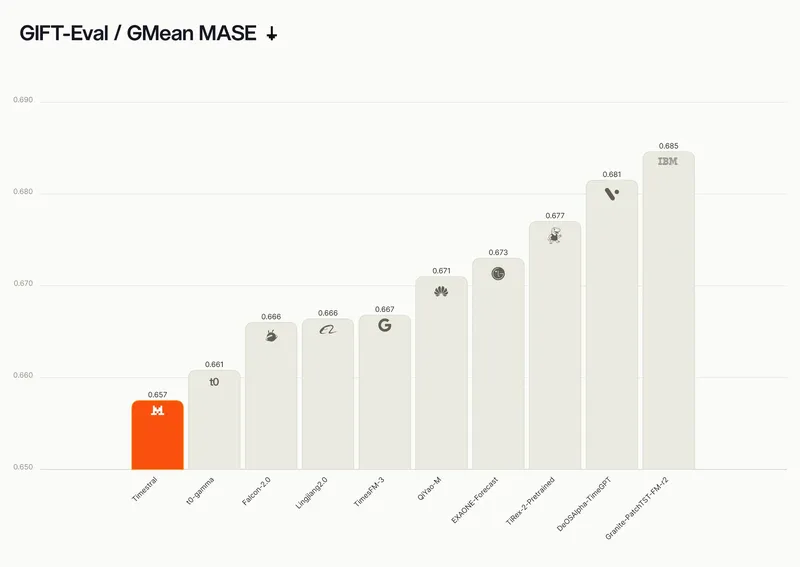
저희는 세 가지 주요 공개 예측 벤치마크인 GIFT-Eval, TIME, fev-bench에서 Timestral을 평가했습니다. 사전 학습된 제로샷 모델 중에서 다섯 가지 지표 전부에서 1위를 기록했습니다. 이러한 결과는 앙상블 없이 단일 체크포인트에서 나온 것입니다.
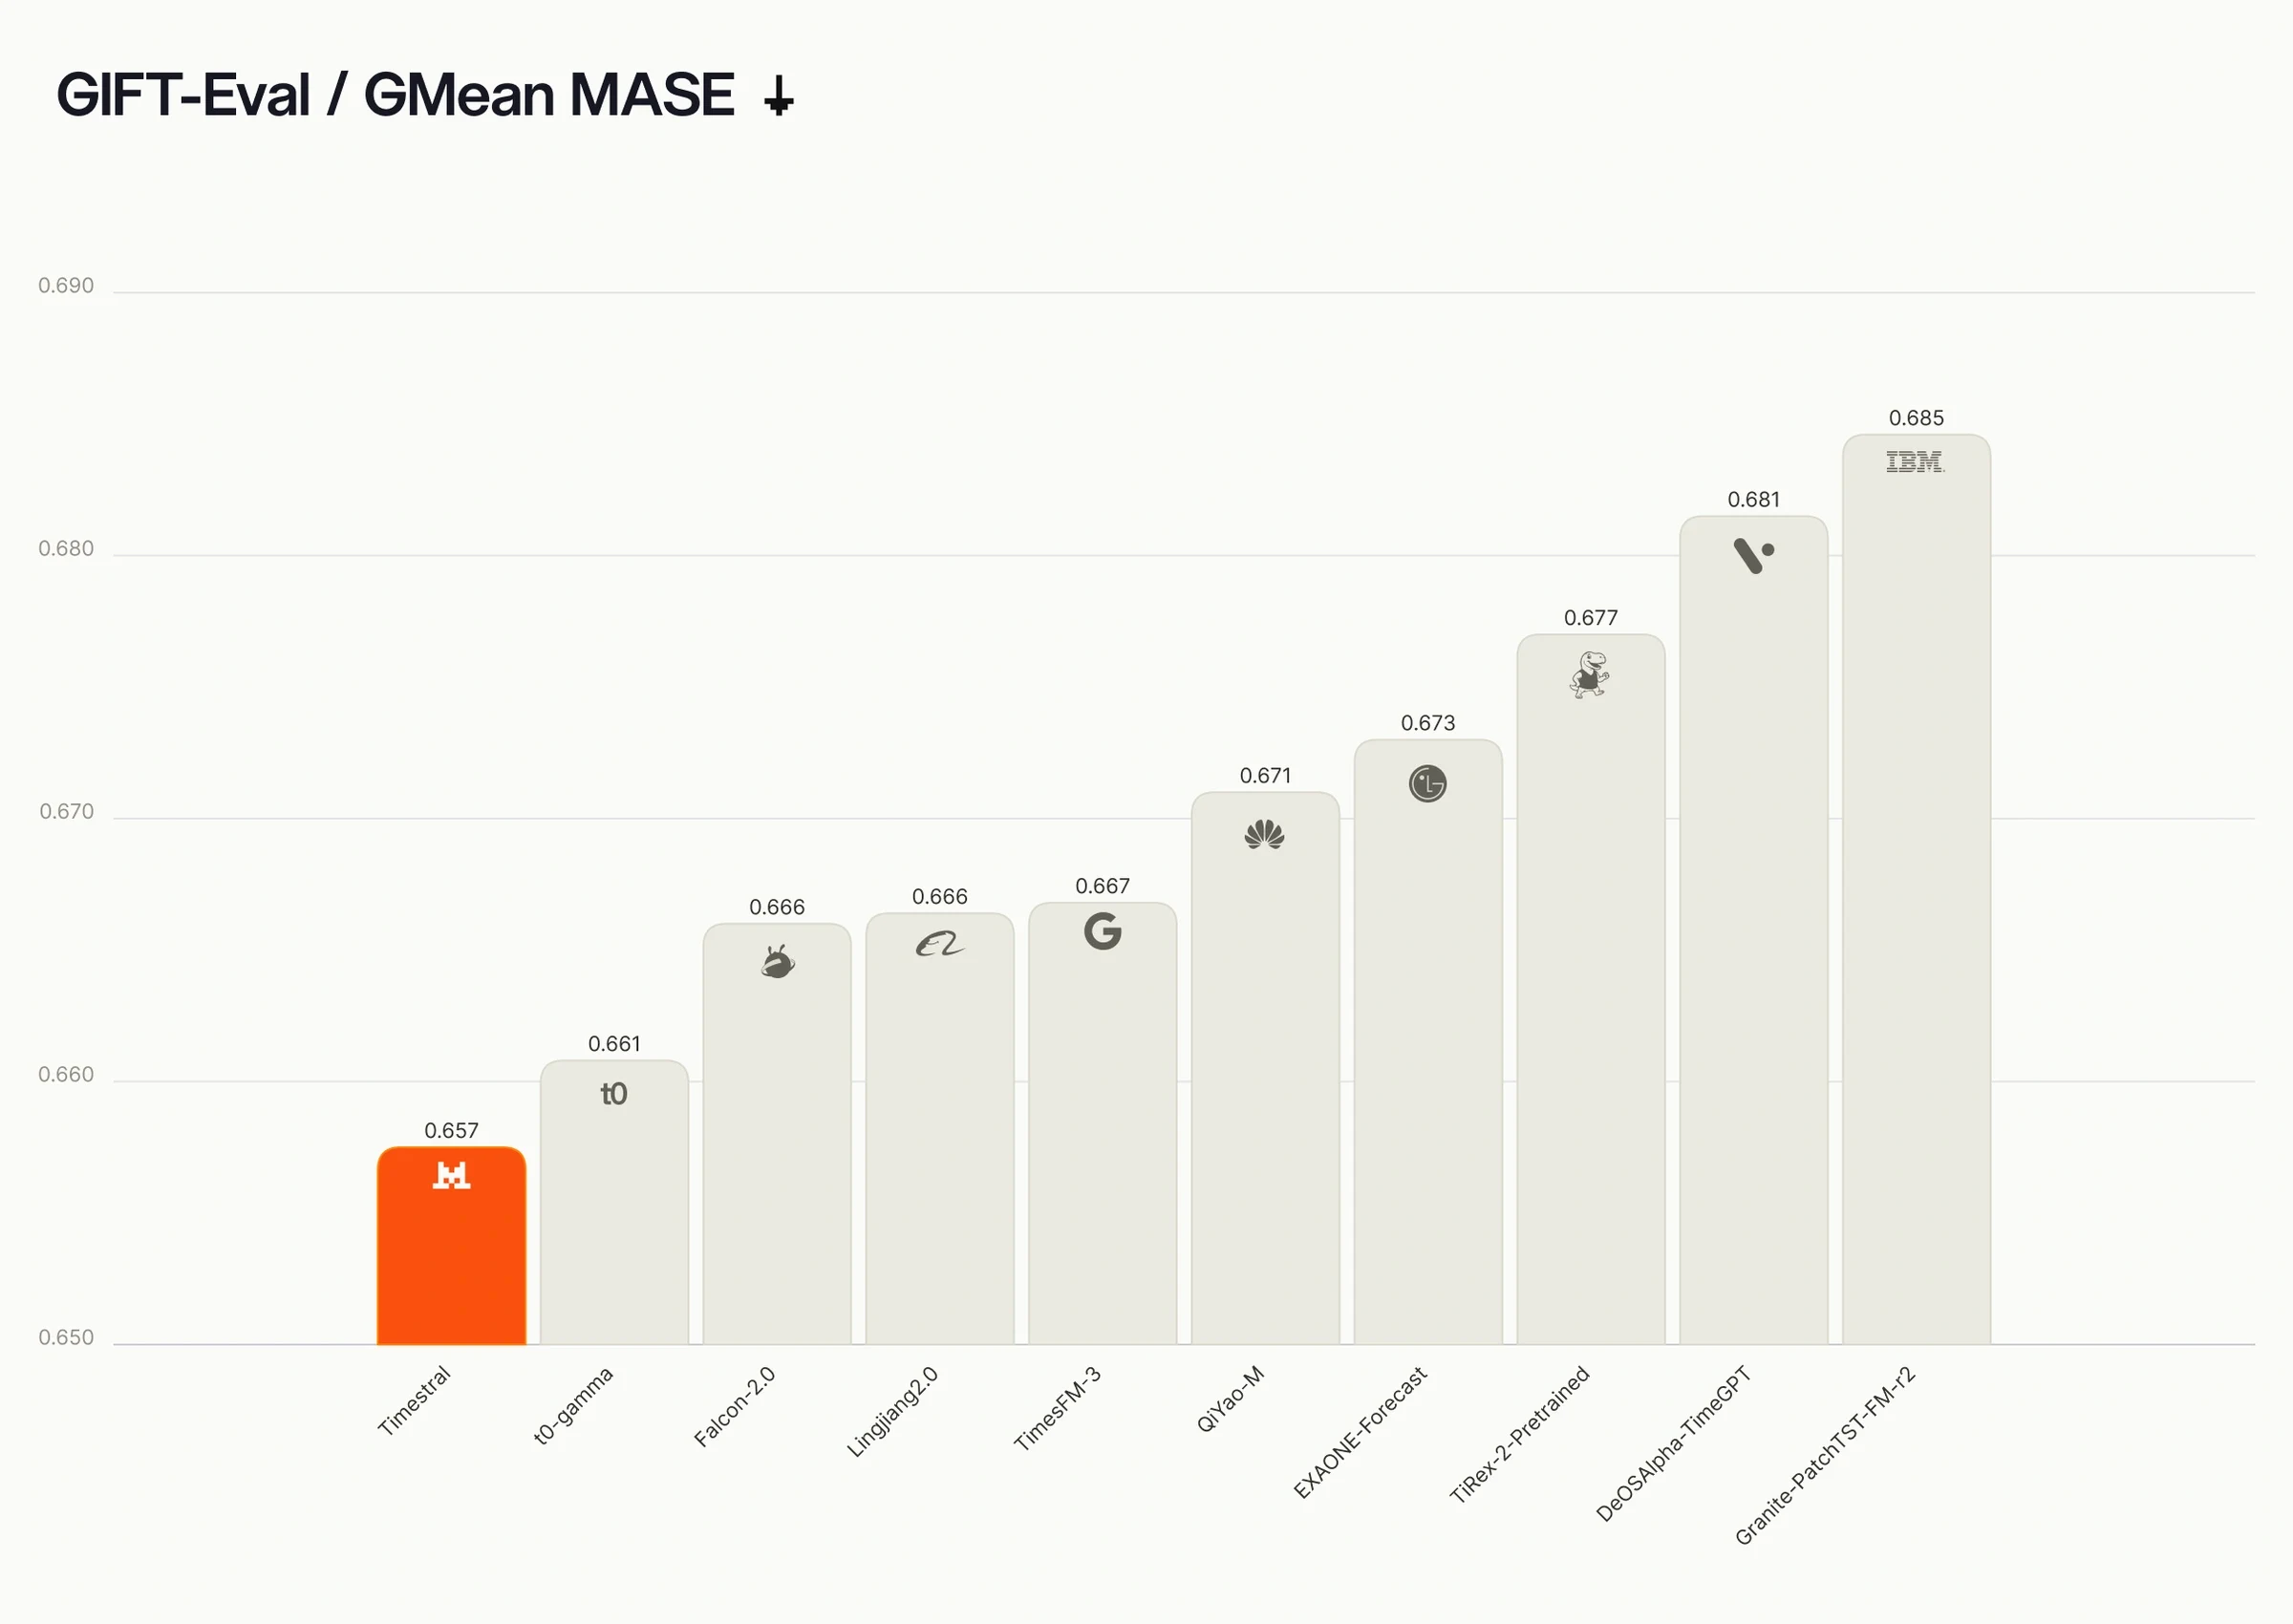
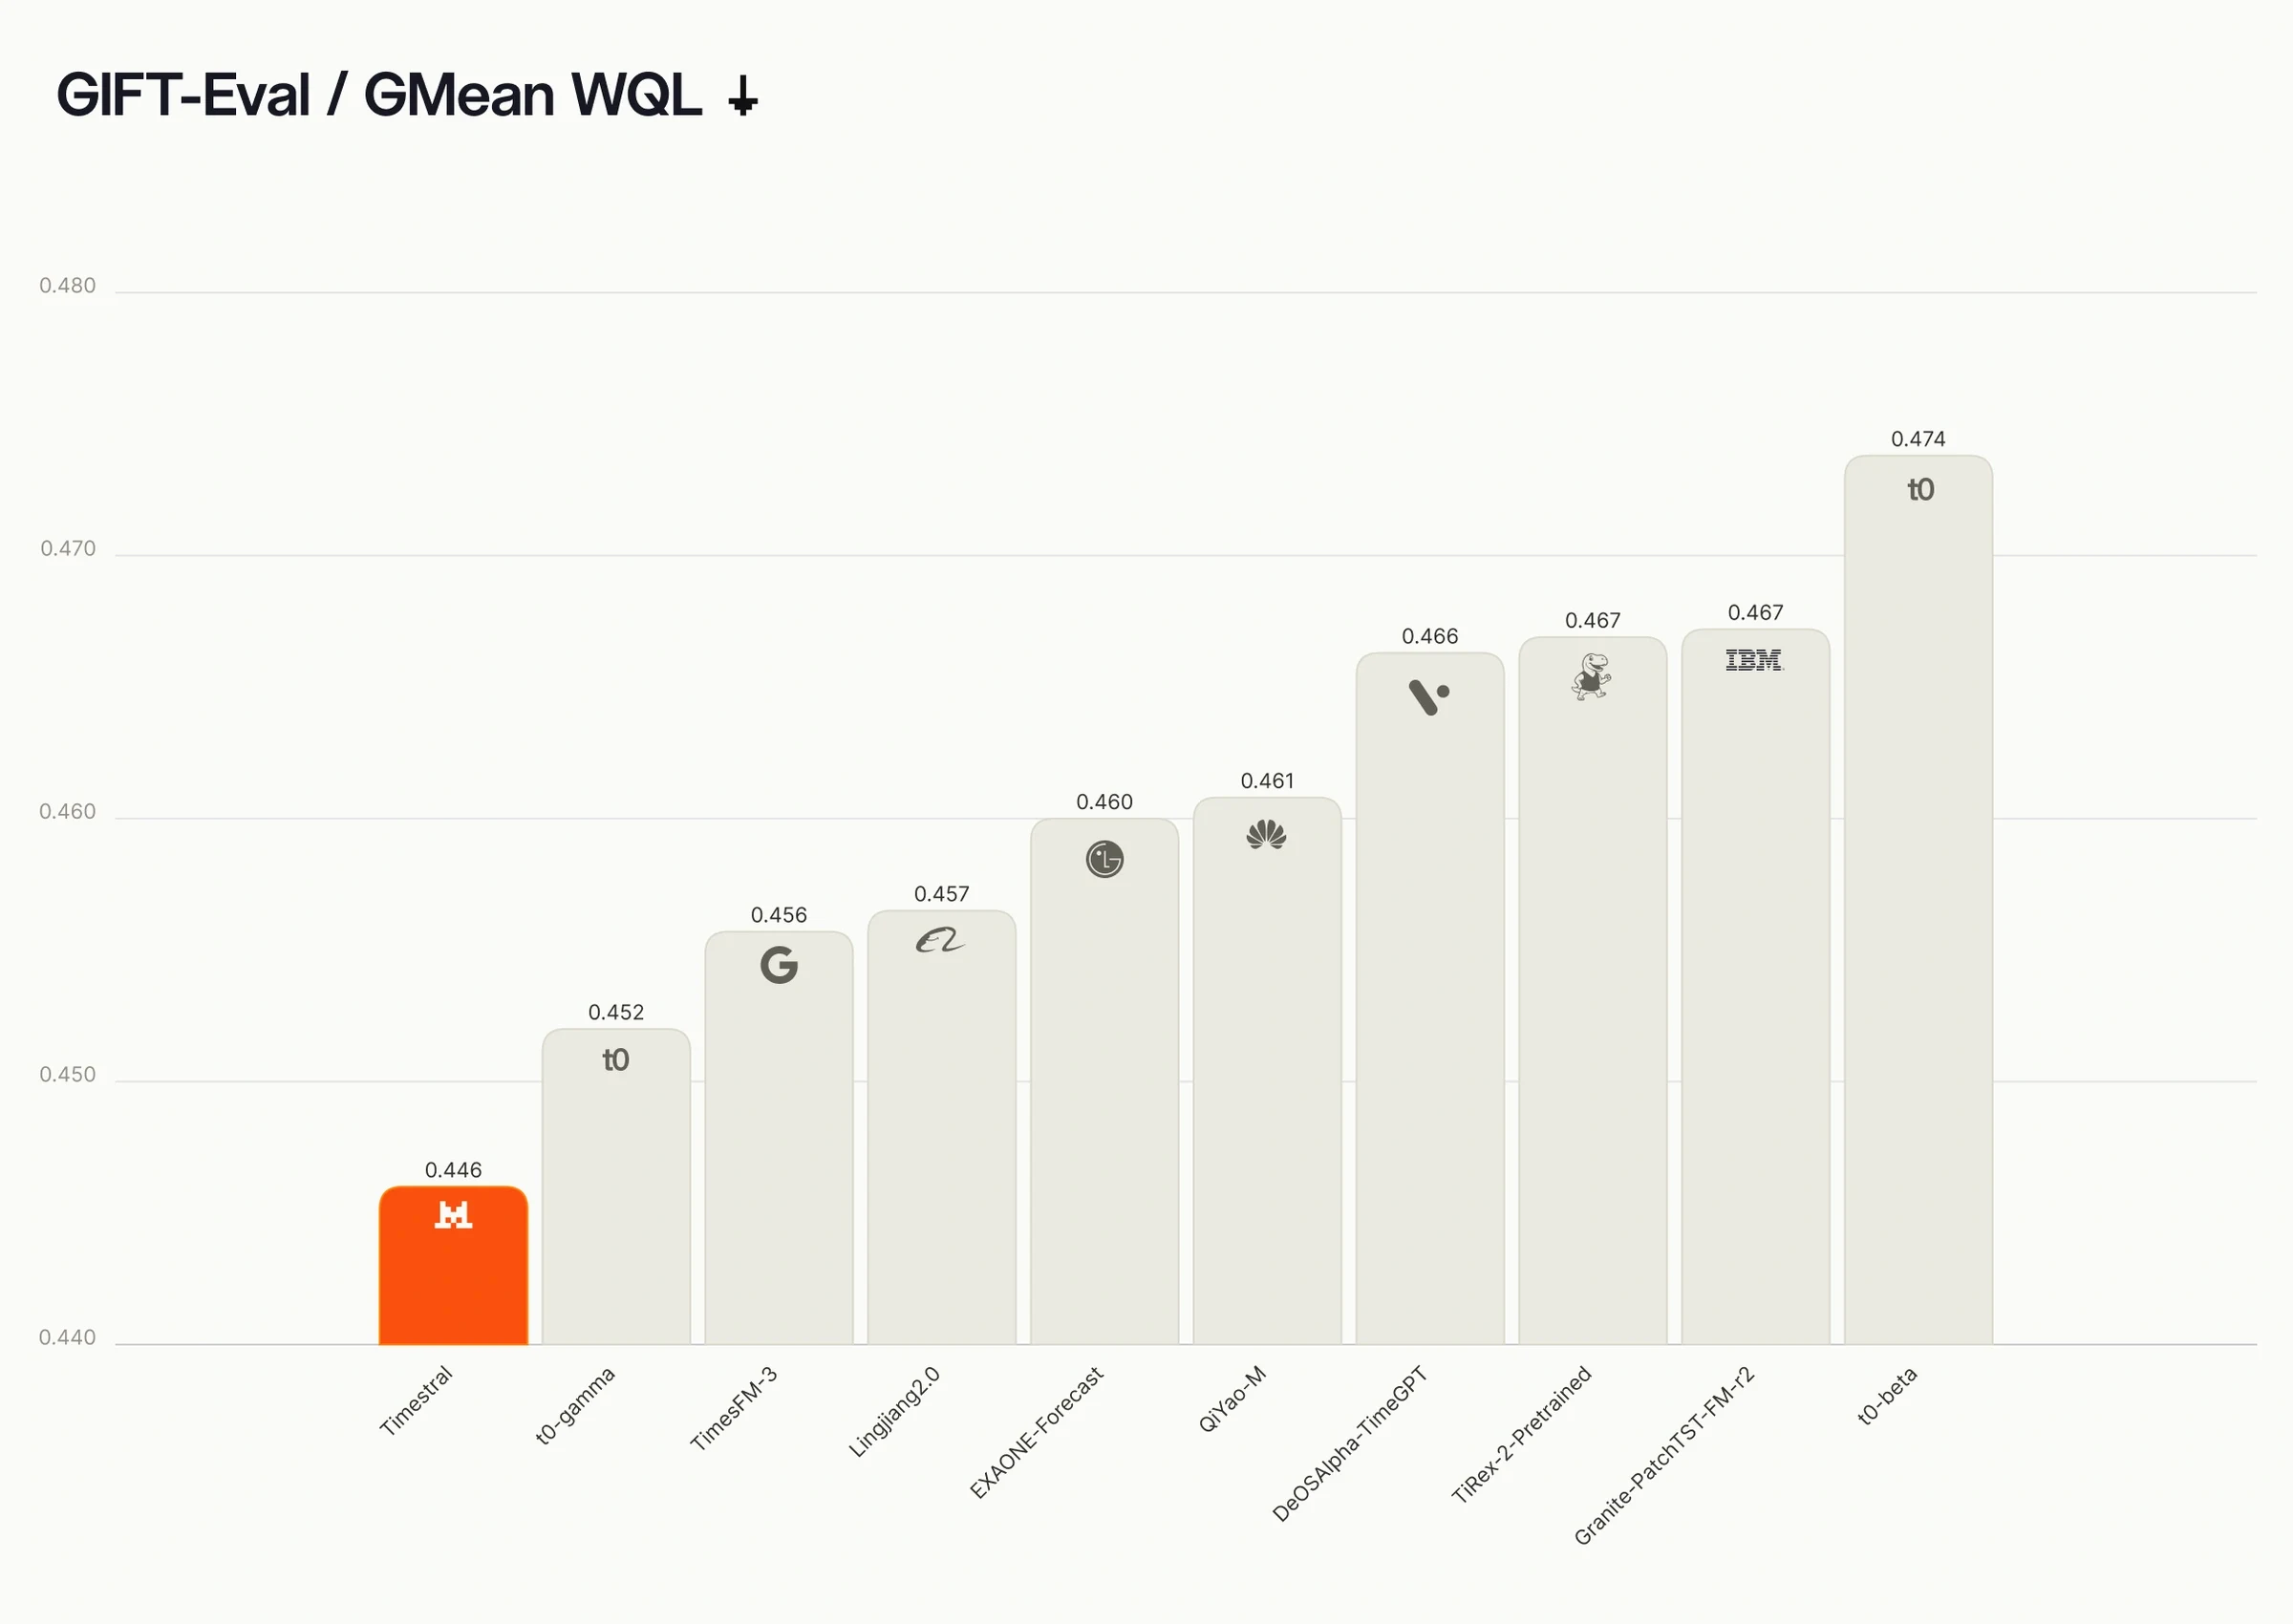
GIFT-Eval, 83개의 비교 가능한 사전 학습 및 제로샷 엔트리 중 상위 10위. 낮을수록 좋습니다.
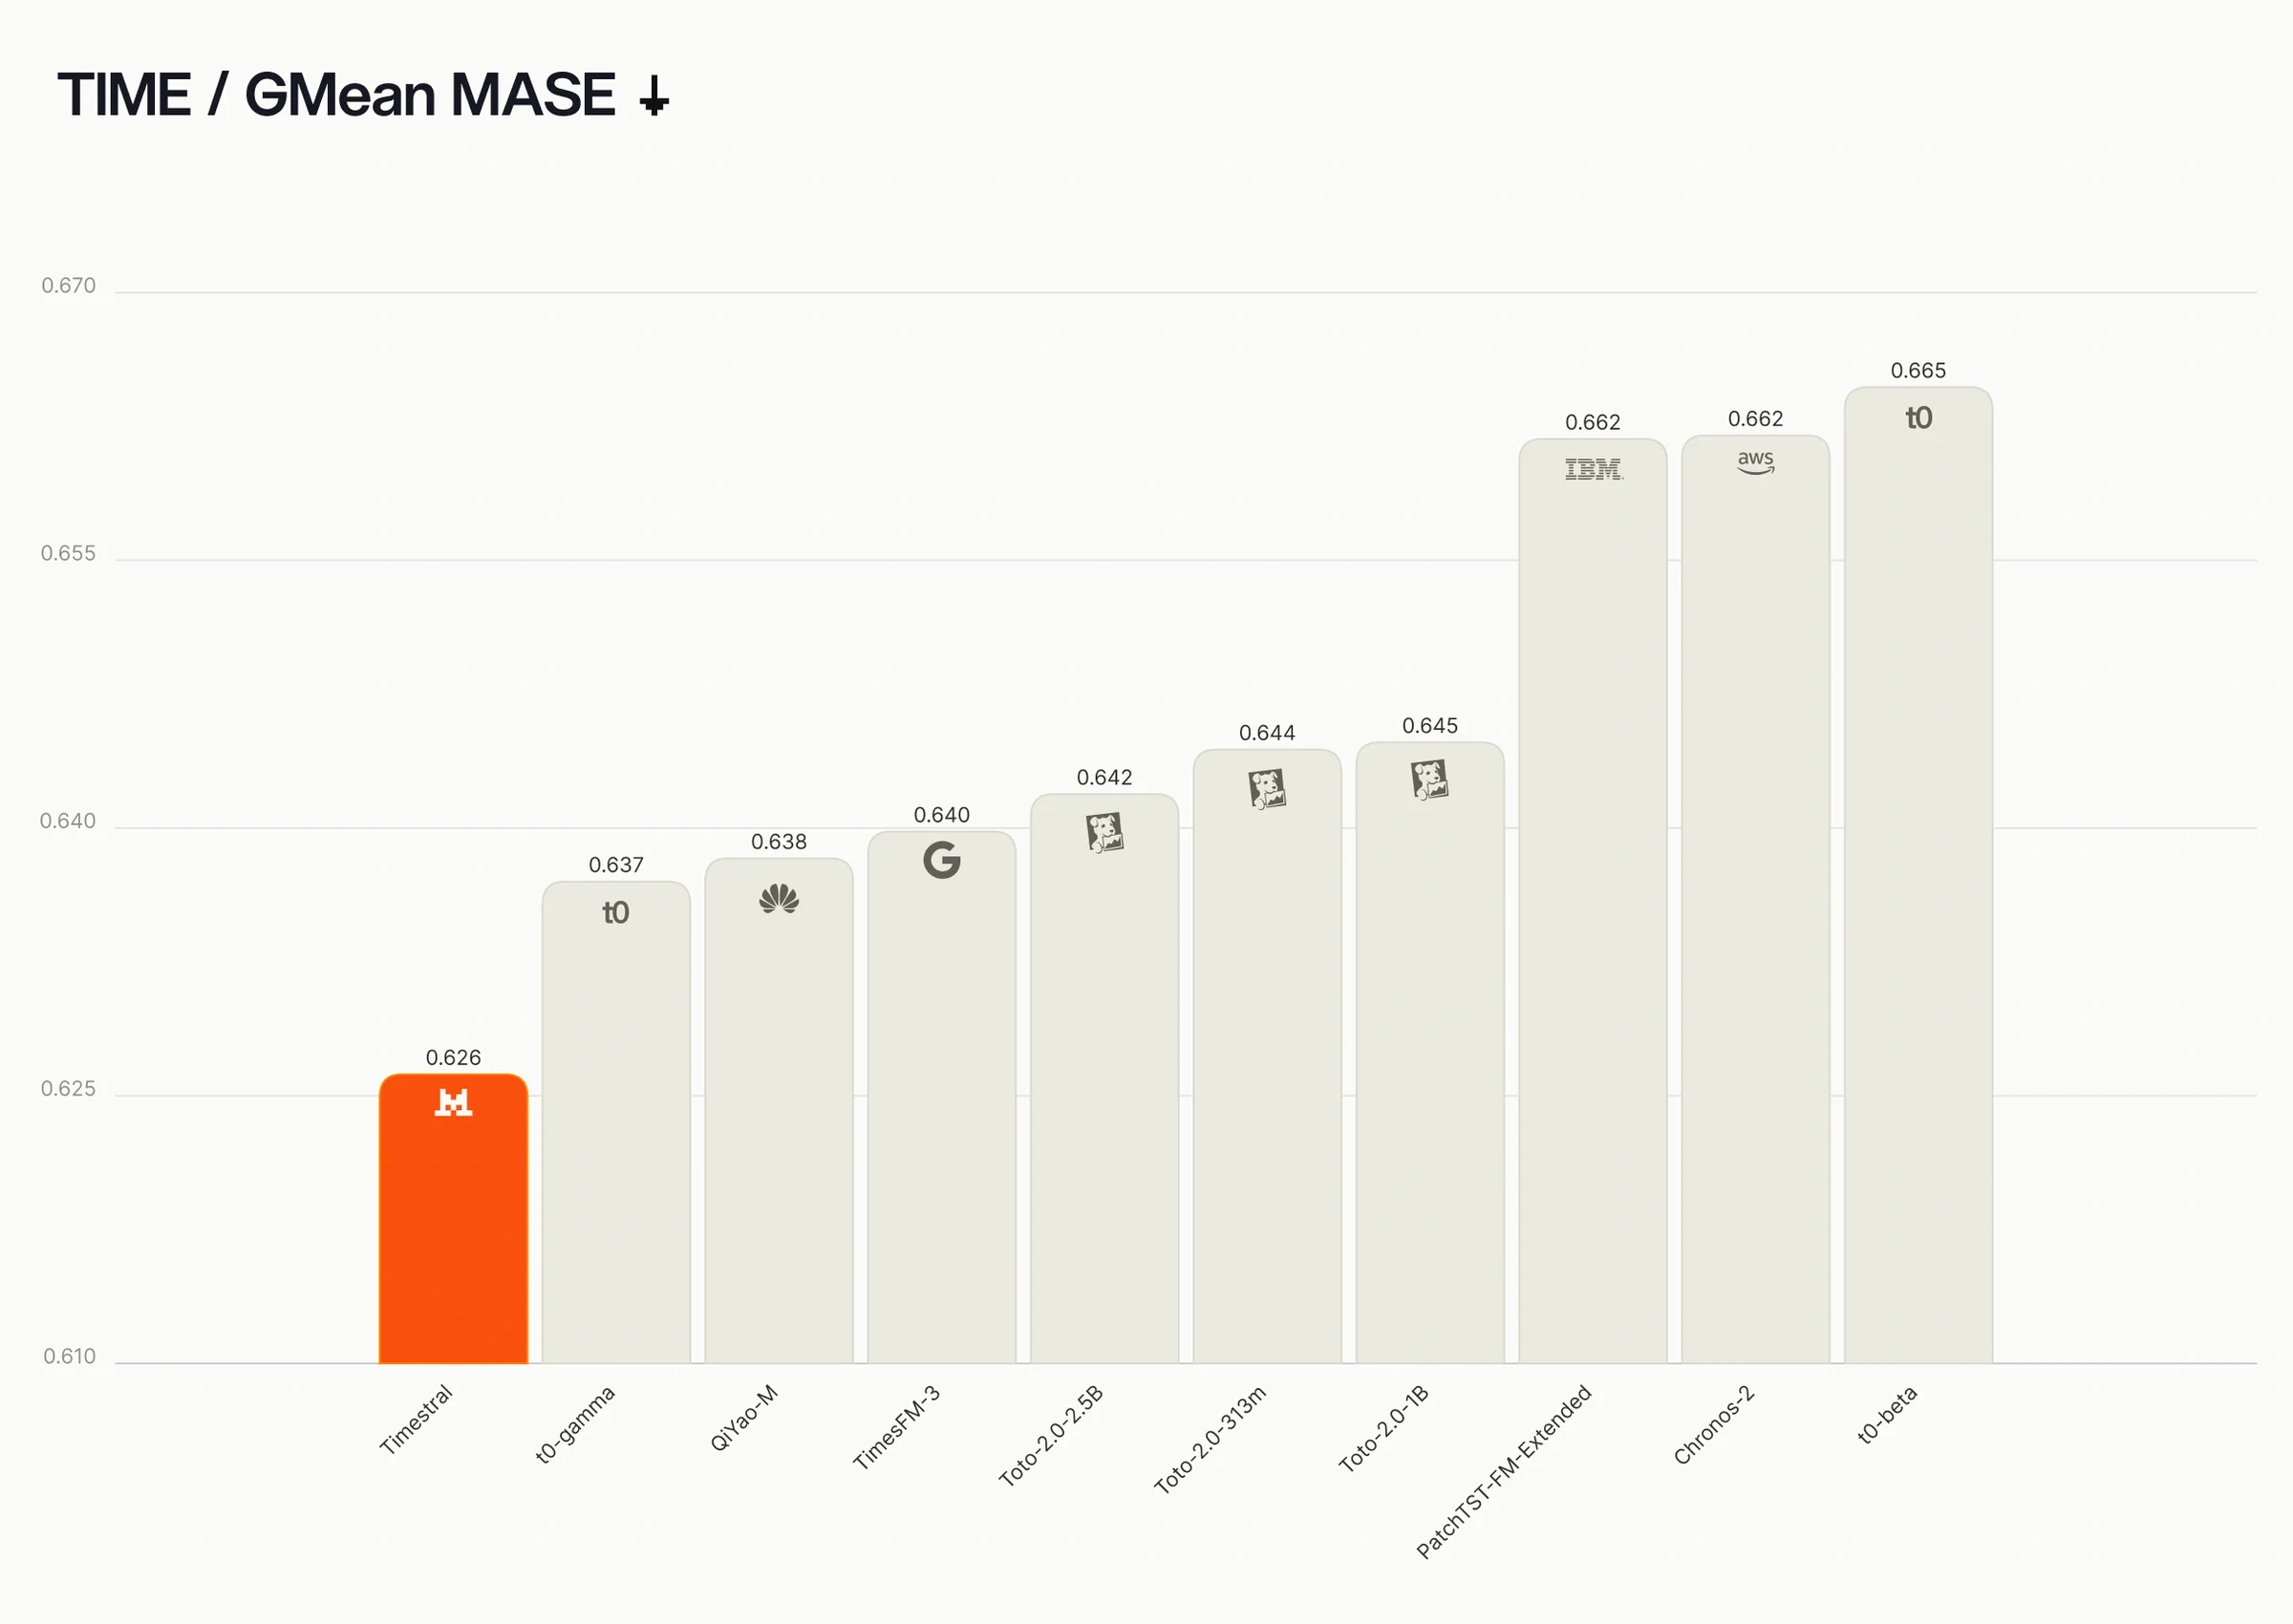
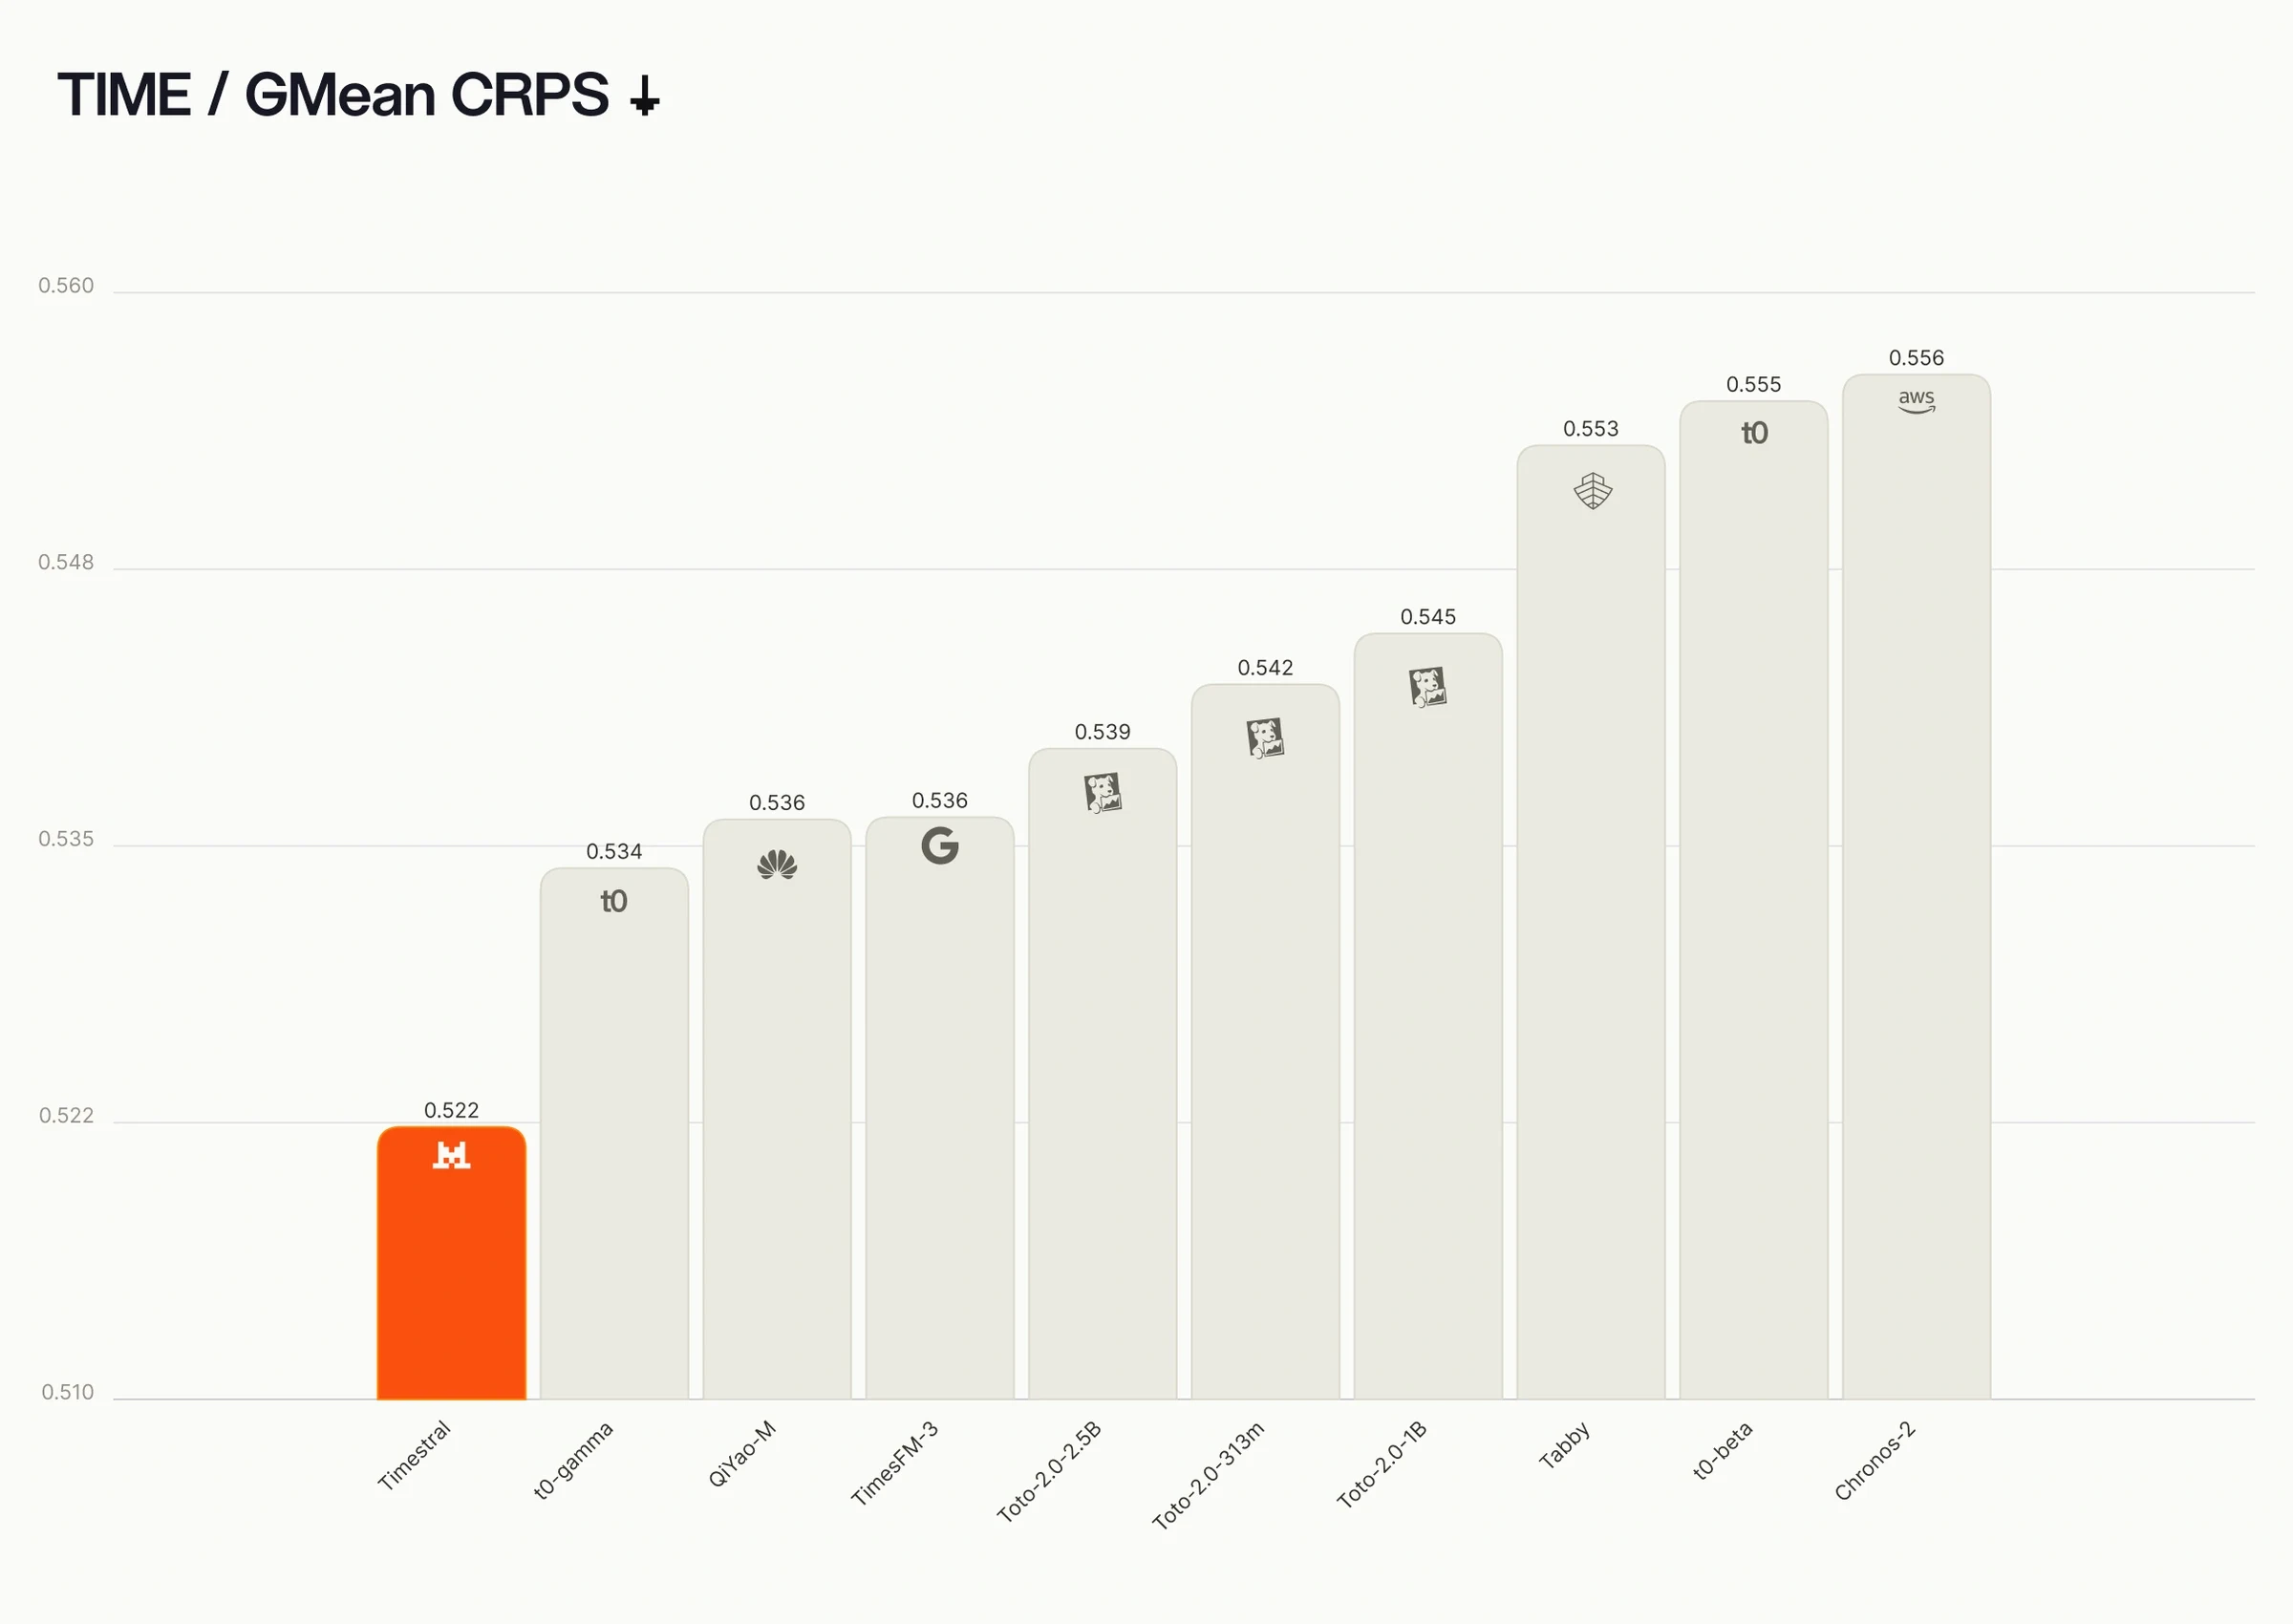
TIME, 리더보드 엔트리 35개 중 상위 10위. 두 지표 모두 낮을수록 좋습니다.
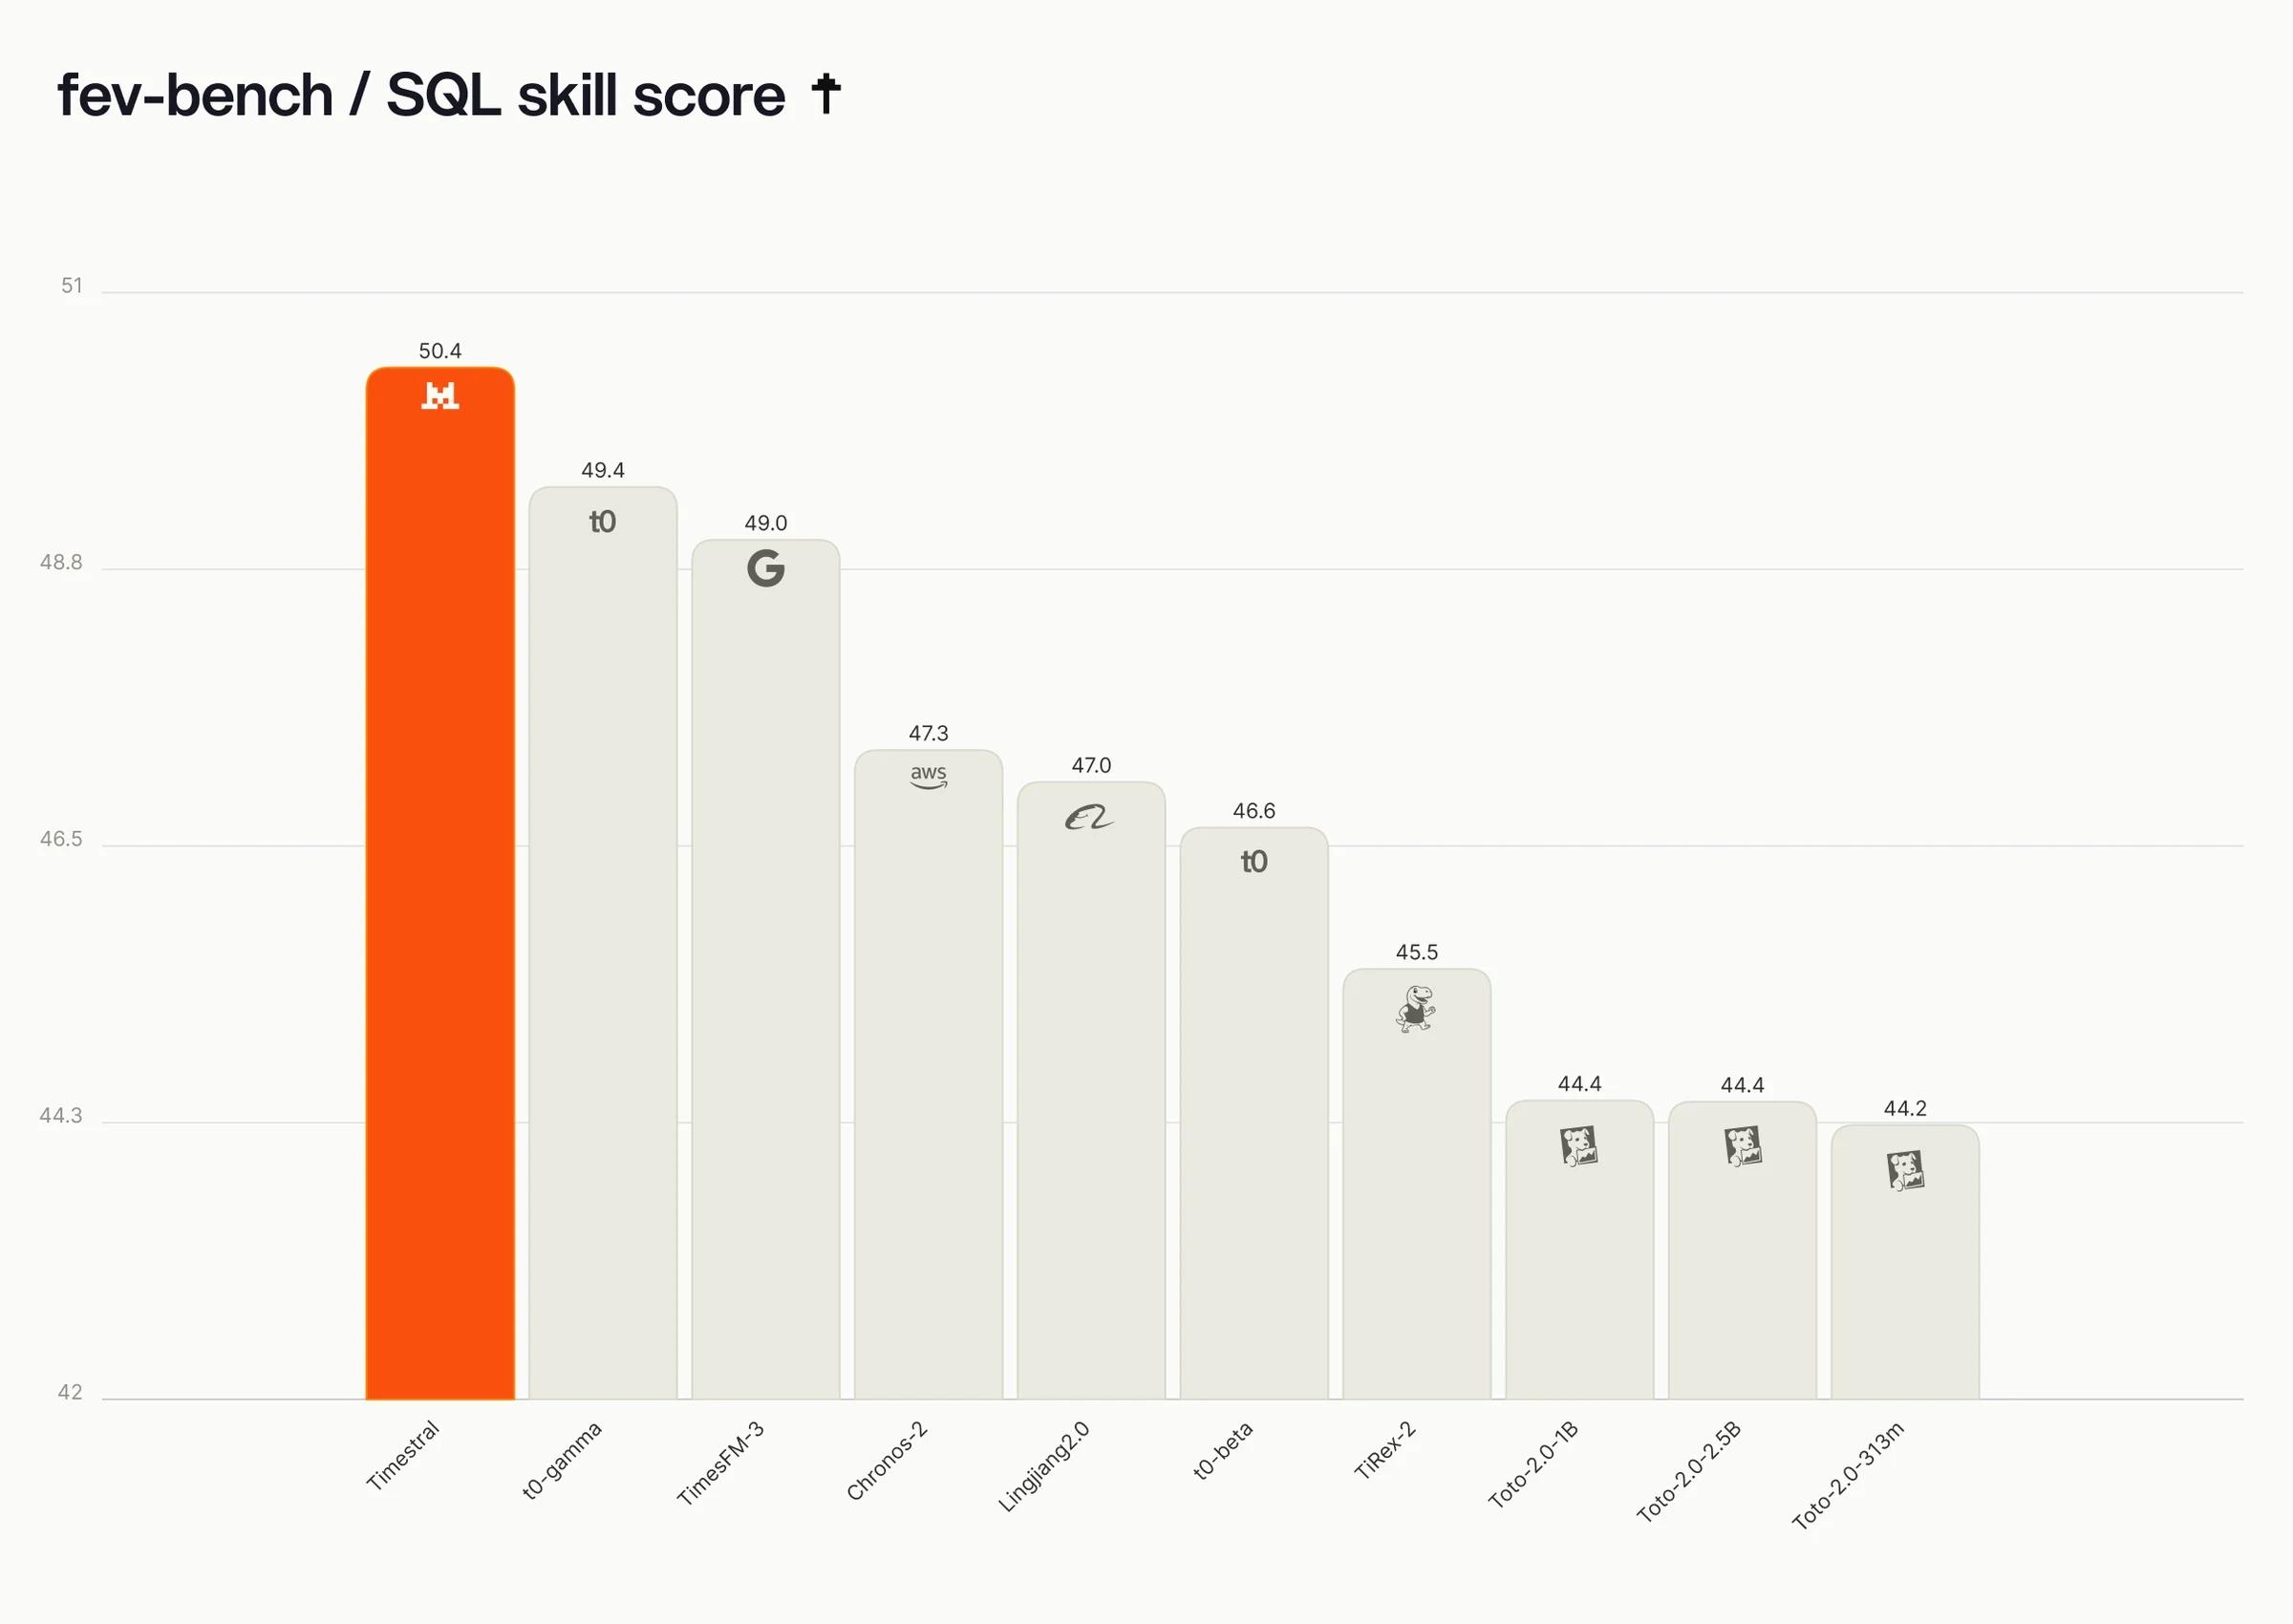
fev-bench, 리더보드 엔트리 37개 중 상위 10위, SQL skill score 기준. 높을수록 좋습니다.
모든 사양에 최적화된 모델 계열
Timestral은 5M, 28M, 123M, 209M 파라미터의 4개 모델 계열로 최적화되었습니다. 더 큰 모델은 예측 성능을 향상시키고, 더 작은 모델은 더 빠르고 저렴합니다. 4개 모델 모두 동일한 아키텍처와 학습 레시피를 공유합니다. 모든 크기가 정확도 대비 모델 크기의 파레토 경계에 위치합니다: 각 모델 크기에서 더 나은 예측을 하는 공개 모델은 없습니다.
GIFT-Eval, TIME 및 fev-bench에서의 점수 대 모델 크기 (1 − skill score로 표시). 낮을수록 좋습니다. 저희의 28M 모델은 약 4배 큰 Chronos-2를 GIFT-Eval과 TIME에서 능가합니다. 저희의 209M 모델은 더 적은 파라미터로 TimesFM-3 및 Falcon-2.0을 능가합니다.
Timestral은 추론에 GPU가 필요하지 않습니다. 8스레드 표준 서버 CPU에서, 3주 분량의 15분 이력 데이터로 하루 앞을 예측하는 데 5M 모델은 10 ms, 209M 모델은 140 ms가 걸립니다. 더 작은 모델은 일부 정확도를 속도와 교환합니다: 28M 모델은 209M 모델보다 5배 빠르고, 123M 모델은 209M 점수의 0.2% 이내에 도달하면서 지연 시간은 4분의 3 수준입니다.
산업 사례
설비에 수천 개의 센서를 갖춘 산업 플랜트를 생각해 봅시다. Timestral은 여러 방식으로 해당 데이터의 예측을 개선할 수 있습니다.
다변량 예측. 펌프의 진동, 온도, 압력은 독립적으로 움직이지 않습니다. 하나의 상승이 종종 다른 하나의 변화를 설명하거나 유발합니다. Timestral은 관련 시계열을 공동으로 모델링하므로, 각 센서를 개별적으로 예측하는 대신 이러한 의존성을 활용할 수 있습니다.
확률적 예측. 단일 예측값만으로는 전체 그림이 드러나지 않을 수 있습니다. Timestral은 전체 분위수 집합을 예측하므로, 팀은 불확실성이 얼마나 넓은지 확인하고, 이를 반영한 알림 임계값을 설정하며, 단일 숫자가 아닌 리스크를 기준으로 유지보수를 계획할 수 있습니다.
범주형 공변량. 일부 공변량은 연속적인 숫자가 아닌 범주 집합에서 값을 취합니다. 예를 들어 요일이나 기계의 상태(가동 중, 유휴, 유지보수 중)가 있습니다. 이를 숫자로 인코딩하면 원래 없는 순서나 척도가 부과됩니다. Timestral은 이를 범주형 입력으로 직접 받아 예측을 개선합니다.
알려진 미래 공변량. 센서 거동의 일부 동인은 생산 일정, 계획된 정비, 기상 예보처럼 사전에 알려져 있습니다. Timestral은 이러한 요소를 조건으로 활용해 예측 품질을 개선할 수 있으므로, 예정된 부하 증가는 놀람으로 표시되지 않고 예상된 것으로 처리됩니다.
모델에서 시스템으로
Timestral은 기존 모니터링 파이프라인 내에서 실행되거나, 멀티모달 에이전트 워크플로에서 당사의 언어 모델과 결합될 수 있는 수치 모델입니다.
현장에서는 다음과 같은 모습일 수 있습니다:
Timestral이 공장의 센서 스트림에서 지속적으로 실행되며, 이상 징후가 발생하는 즉시 탐지합니다.
펌프에서 이상 징후를 감지하면, 에이전트가 신호를 임베딩하고 과거 센서 데이터의 임베딩과 비교하여 유사한 과거 고장 사례를 찾습니다.
그런 다음 에이전트는 서브 에이전트를 시작하여 근본 원인 분석을 수행하며, 이때 해당 공장의 유지보수 기록, 교대 근무 로그, 운영자 메모, 장비 매뉴얼, 과거 작업 지시서, 관련 장비의 측정값 등의 컨텍스트를 활용합니다.
에이전트는 조사 결과를 바탕으로 뒷받침 근거와 가능한 다음 단계를 포함한 제안 진단서를 작성합니다.
공장 관리자는 단순한 경고가 아니라 센서 데이터에 기반한 진단과 계획을 받게 됩니다.
핵심 기술적 기여
여러 아이디어를 결합하여 이러한 결과를 도출했습니다. 각 내용은 기술 보고서에서 상세히 설명될 예정입니다.
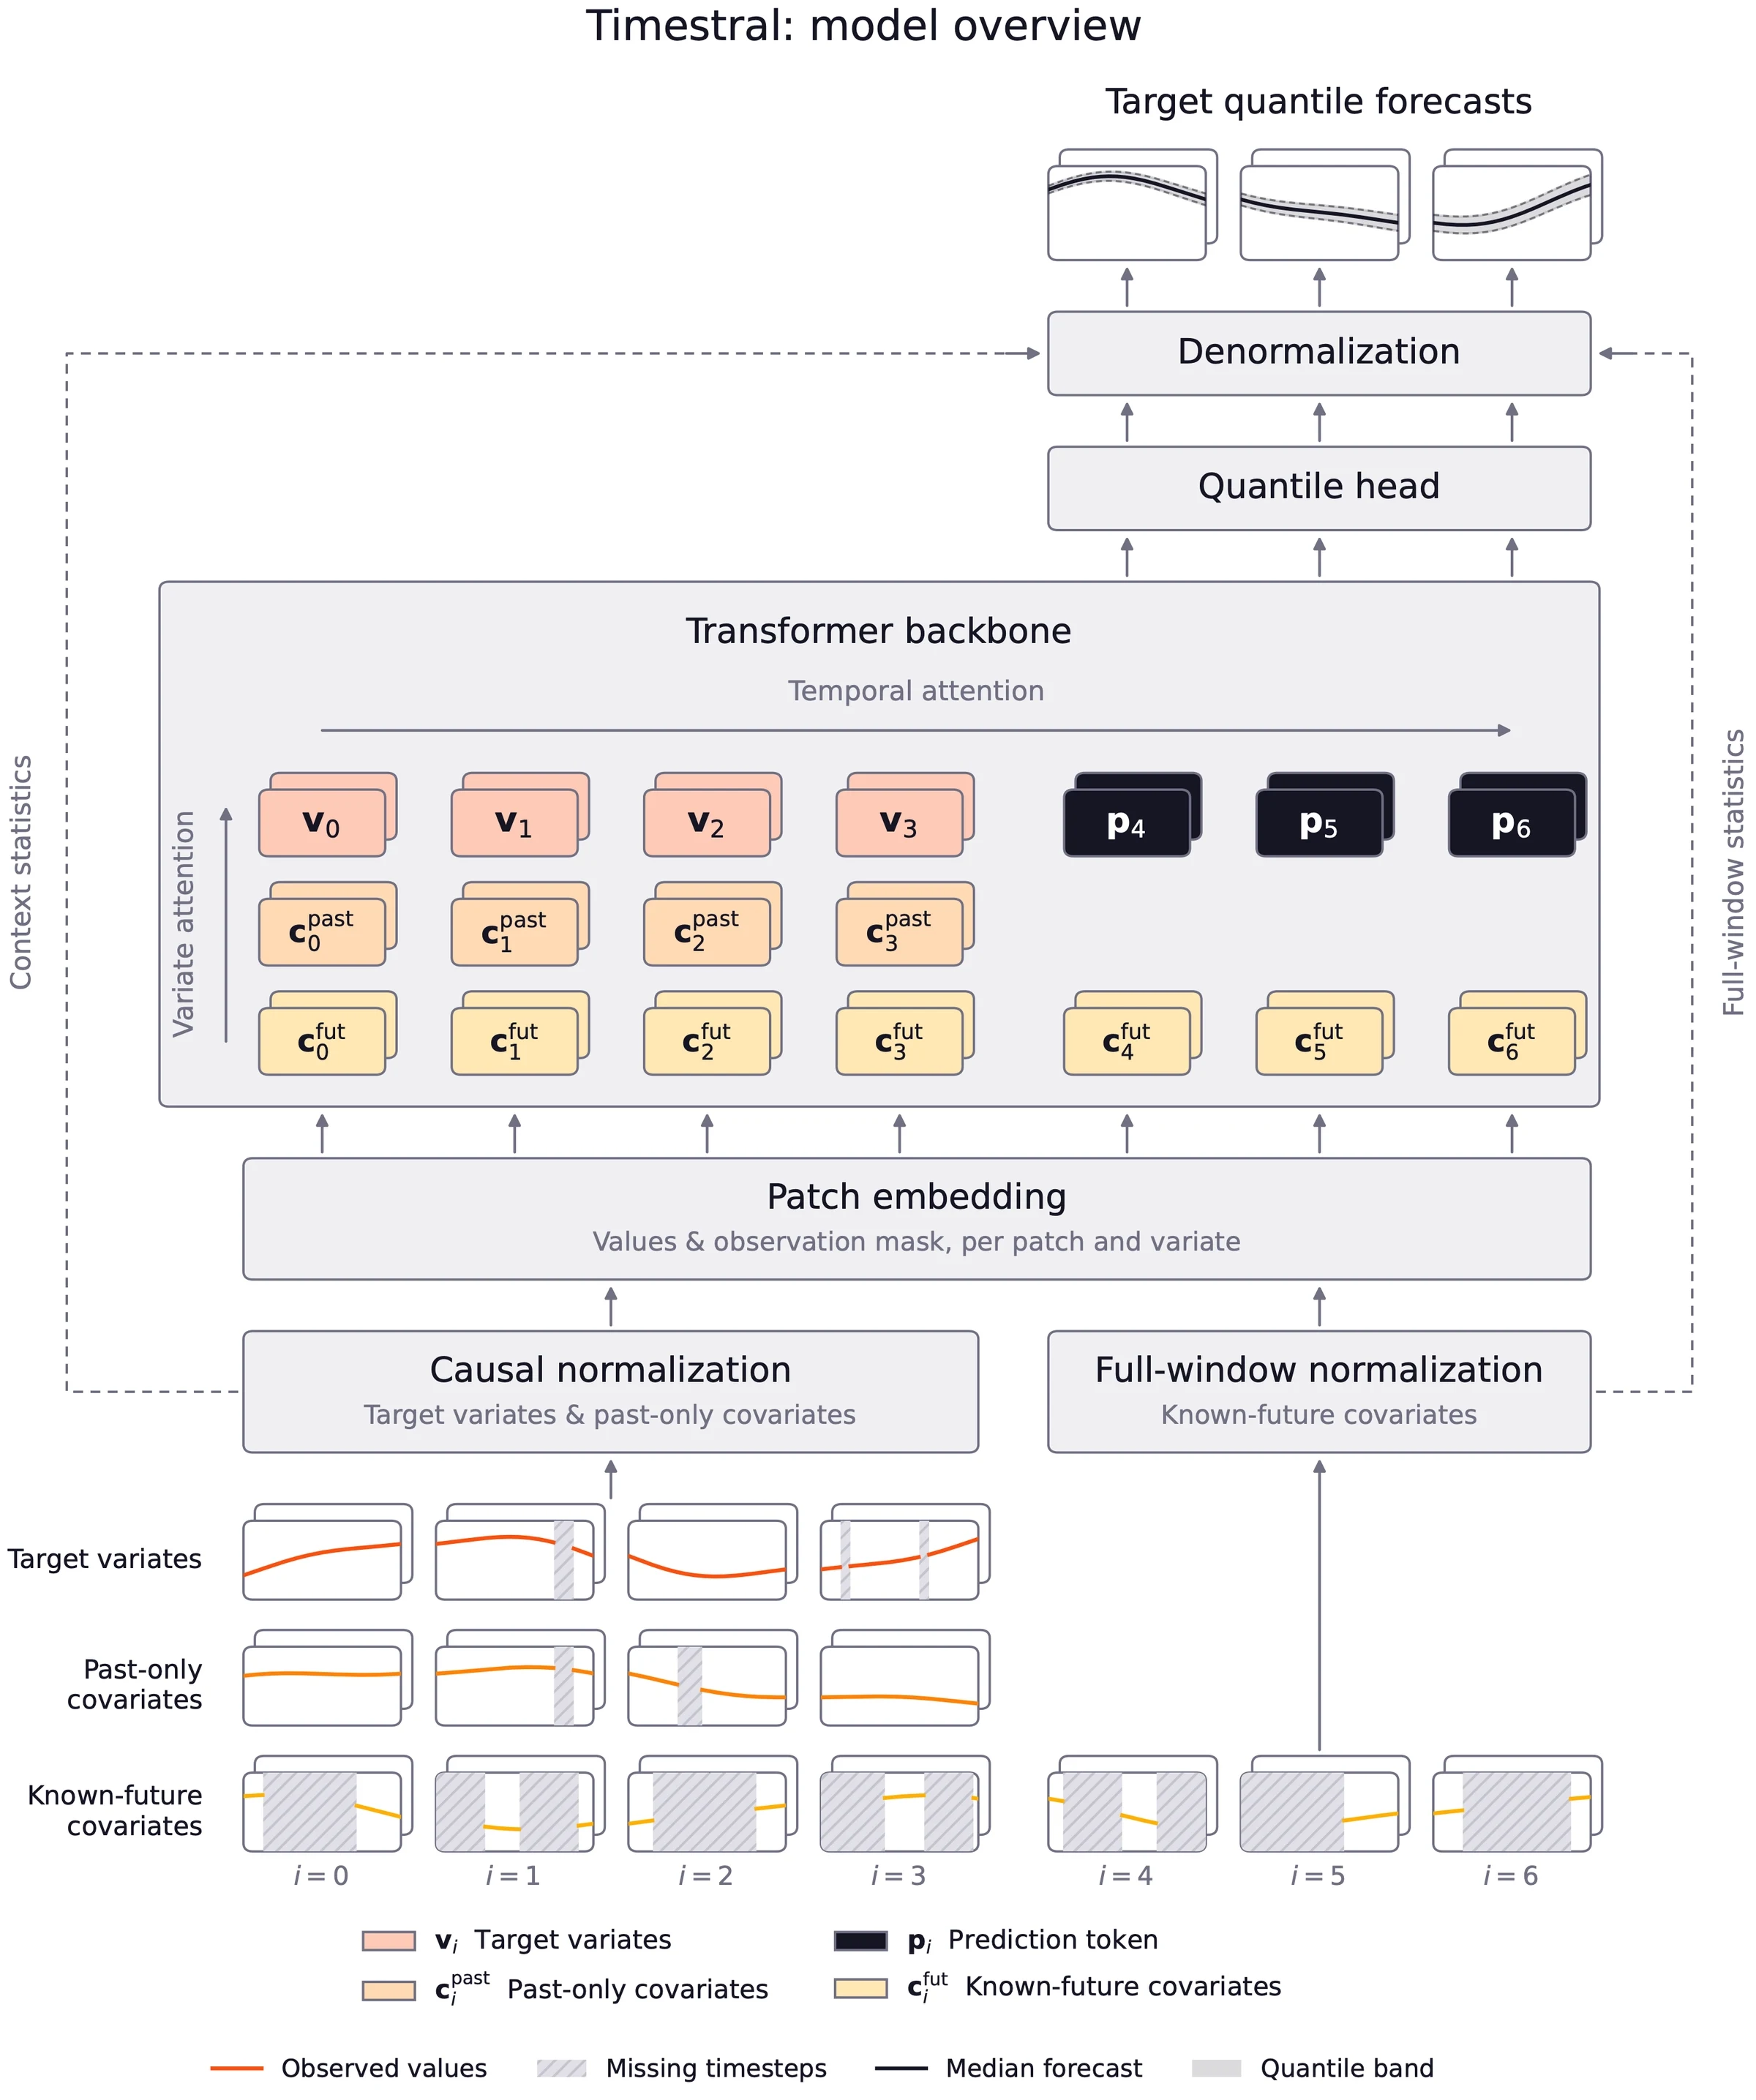
Decoupled Horizon Forecasting. Toto 2.0 및 TimesFM-3와 같이 연속 패치 마스킹으로 학습된 인과적 디코더는 예측할 값을 마스킹하므로, 해당 값이 누락된 값처럼 보이고 이후 예측의 컨텍스트로도 사용할 수 없게 됩니다. 우리의 접근 방식인 DHF는 이 둘을 분리합니다. 전체 이력이 시퀀스에 유지되고, 학습된 예측 토큰이 자신 앞의 이력을 읽어들입니다. 따라서 모든 관측값이 대상이자 컨텍스트로 활용되고, 실제 공백은 누락으로 표시된 채 유지되며, 학습 호라이즌 길이와 결측 데이터 증강을 서로 독립적으로 조정할 수 있습니다.
Covariate-aware attention. 각 입력 시계열에는 역할이 할당됩니다: 대상 변량, 과거 전용 공변량, 또는 알려진 미래 공변량입니다. 알려진 미래 공변량은 전체 윈도우에 걸쳐 표시되는 반면 대상은 인과성을 유지하며, 정보는 공변량에서 대상으로만 흐릅니다. 따라서 Timestral은 대상 자체의 미래 정보가 예측에 새어 들어가는 일 없이 공휴일 달력이나 일기 예보를 활용할 수 있습니다.
Synthetic-first data. 학습 데이터의 대다수는 합성 데이터였습니다. 먼저 추세, 계절성 및 다양한 노이즈 패턴을 포함하여 일관된 시간적 동역학을 가진 단변량 프로세스를 생성했습니다. 그런 다음 다변량 합성기를 사용하여 이러한 프로세스 간에 비선형 종속성을 도입함으로써 다변량 시계열을 구성했습니다.
Two-stage training. Timestral은 먼저 컨텍스트 크기 8192로 순수 합성 데이터를 대규모로 사전 학습한 다음, 4배 긴 컨텍스트로 실제 데이터와 합성 데이터의 혼합 데이터로 사후 학습됩니다. 학습 목표는 CRPS의 이산 근사인 21개 분위수에 대한 핀볼 손실입니다.
적응 가능한 모델
공개 벤치마크는 일반 성능을 측정하지만, 프로덕션 데이터는 행동과 구조 면에서 크게 다를 수 있습니다. 또한 시장의 체제 변화, 장비 열화, 수요 패턴 이동에 따라 시간이 지나면서 변할 수 있습니다. 지속적인 가치는 모델을 인도메인 데이터에 적응시키고 분포가 이동함에 따라 지속적으로 재학습할 수 있는 능력에 있습니다.
더 나아가고자 하는 조직을 위해 Timestral은 다음을 통해 이용할 수 있습니다: Mistral Forge, 당사 언어 모델에 사용하는 것과 동일한 학습 파이프라인입니다. 다음을 지원합니다:
Zero-shot inference 을 즉시( out of the box ) 제공합니다.
Architectural extensions, 예를 들어 도메인 특화 공변량 같은 것들입니다.
Fine-tuning on proprietary data, 일반 성능을 유지하면서 특정 도메인에 특화시킬 수 있습니다.
Control over the training data, 학습 믹스 조정, 사전 학습 데이터 리플레이, 대상 도메인을 반영하는 합성 데이터 샘플 생성 등을 포함합니다. 데이터에 대한 완전한 통제를 통해 사전 학습 중 백테스트한 어떤 것도 본 적이 없음을 보장합니다.
전체 파이프라인은 에어갭(air-gapped) 환경을 포함하여 고객의 하드웨어에 배포할 수 있습니다.
앞으로의 계획
저희는 다음을 공개했습니다: GitHub 저장소 따라서 여러분의 own 데이터로 Timestral을 실행할 수 있습니다. 전체 결과를 담은 기술 보고서가 이어서 발표될 예정입니다. 보다 전문적인 예측 문제나 연구 협력을 원하시면 저희에게 연락해 주시기 바랍니다.
Timestral | |
|---|---|
유형 | 시계열 파운데이션 모델(TSFN) |
파라미터 | 5M, 28M, 123M 및 209M |
컨텍스트 길이 | 32,768 타임 스텝 |
출력 | 확률적 예측, 21개 분위수 |
입력 | 다변량 타깃, 과거 전용 및 미래 알려진 공변량 |
배포 | 온프레미스, VPC 또는 에어갭 환경 |
라이선스 | 수정된 MIT |
Timestral
신규
Mistral의 시계열 기반 모델. 최고 수준의 확률적 예측을 제공하며, 5M–209M 파라미터로 CPU에서 실행됩니다.
확률적 예측
자세히 보기