
상시 작동하는 에이전트는 점점 더 시각 정보를 해석하고, 이를 기반으로 추론하며, 도구를 사용하고, 행동해야 합니다. 이러한 워크플로에는 멀티모달 이해와 높은 정확도의 실행을 결합한 모델이 필요합니다.
NVIDIA Nemotron 3.5 Super VL은 장시간 실행되는 에이전트를 위해 구축된 오픈 커스터마이징 가능 멀티모달 모델로, 개발자가 전문 워크플로에서 정확도와 효율성을 극대화할 수 있도록 합니다.
하나의 모델에서 추론, 지시 수행, 도구 사용과 텍스트, 이미지, 문서, 비디오 이해를 결합하여 별도의 텍스트 및 비전 모델을 배포할 필요를 줄이고, 워크플로 단계 전반에서 작업 관련 컨텍스트를 유지하는 데 도움을 줍니다.
Nemotron 3.5 Super VL은 120억 개의 파라미터를 가진 mixture-of-experts(MoE) 아키텍처에 12B 활성 파라미터를 기반으로 구축되어, 특화된 상시 실행 에이전트 작업을 위해 정확성과 효율성의 균형을 맞춥니다. 조직은 NVIDIA NeMo를 사용하여 자체 데이터, 도구, 정책 및 워크플로로 이 모델을 사후 학습(post-train)할 수 있습니다.
모델 시스템 내에서 Nemotron 3.5 Super VL은 기본적인 문서, 이미지, 비디오 이해를 갖춘 기본 고정밀 에이전틱 실행 모델로 설계되었습니다. 대용량 텍스트 실행을 위한 NVIDIA Nemotron 3.5 Lightning과 가장 어려운 텍스트 전용 추론을 위한 NVIDIA Nemotron 3 Ultra를 보완합니다.
Nemotron 3.5 Super VL은 멀티모달 상시 에이전트를 위한 두 가지 실용적인 요구 사항을 해결합니다:
- 에이전틱 실행을 갖춘 네이티브 시각 이해: 이 모델은 고정밀 추론과 도구 사용을 문서, 이미지, 비디오 이해와 결합하여 전문화된 워크플로 전반에서 작업 관련 컨텍스트를 유지합니다.
- 효율적이고 제어 가능한 배포: 하이브리드 Mamba-Transformer 아키텍처, 멀티 토큰 예측, NVFP4 양자화는 생성 효율성을 개선하고 더 많은 동시 장문 컨텍스트 세션을 위한 여유를 만들도록 설계되었습니다.
TL;DR: NVIDIA Nemotron 3.5 Super VL 개요
- 아키텍처: mixture-of-experts 설계에서 120B 전체 파라미터 및 12B 활성 파라미터
- 모달리티: 텍스트, 이미지, 문서, 비디오 입력; 텍스트 출력
- 최적화: C-RADIOv4 비전 인코더, 하이브리드 Mamba-Transformer 아키텍처, 멀티 토큰 예측, NVFP4 양자화
- 모델 역할: 모델 시스템을 위한 네이티브 시각 이해를 갖춘 고정밀 에이전틱 실행
- 커스터마이징: NVIDIA NeMo를 사용하여 조직별 데이터, 도구, 정책, 워크플로로 사후 학습
- 배포: 클라우드 및 데이터 센터 환경 전반에서 최적화된 프로덕션 서빙을 위한 NVIDIA NIM
- 배포 대상: 1x GB10, B200, B300, RTX PRO 6000, H200 및 2x H100
- 가용성:
vLLM으로 고처리량 추론 실행하기
Nemotron 3.5 Super VL은 다양한 NVIDIA 플랫폼 전반에서 구동되도록 설계되었습니다. vLLM은 연속 배칭, 접두사 캐싱, 추측 디코딩, OpenAI 호환 API를 포함하여 모델을 프로덕션 워크플로우에 도입하는 데 필요한 서빙 계층을 제공합니다.
BF16 체크포인트는 배포를 위한 간단한 기준선을 제공합니다. NVFP4는 출시 시점에 저정밀 추론을 활용할 수 있는 환경을 위해서도 제공됩니다.
vLLM 설치
docker pull vllm/vllm-openai:v0.31.0

docker run --rm -it --gpus all --ipc=host --network=host \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  --entrypoint /bin/bash \
  vllm/vllm-openai:v0.31.0
모델 서빙하기
다음 NVFP4 실행 구성은 1× GB200 설정에 대한 예시입니다. 사용 전에 대상 하드웨어에서 검증하십시오.
vllm serve nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4 \
  --served-model-name nemotron-3.5-super \
  --trust-remote-code \
  --max-model-len 114688 \
  --reasoning-parser nemotron_v3 \
  --speculative-config.method mtp \
  --speculative-config.num_speculative_tokens 5
서버가 실행되면 애플리케이션은 OpenAI 호환 클라이언트를 통해 프롬프트를 보낼 수 있습니다:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="null")

response = client.chat.completions.create(
    model="nemotron-3.5-super",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "Describe what happens in this video."},
                {
                    "type": "video_url",
                    "video_url": {"url": "https://example.com/clip.mp4"}
                },
            ],
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=4096,
)

print(response.choices[0].message.reasoning)  # thinking trace
print(response.choices[0].message.content)    # final answer
추측 디코딩(Speculative Decoding)으로 장시간 실행 에이전트 워크플로우 가속화
Nemotron 3.5 Super VL은 Multi-Token Prediction(MTP)을 지원하여 대상 모델의 출력 품질을 유지하면서 토큰 생성 속도를 높입니다.
Nemotron 3.5 Super VL에는 멀티 토큰 예측(MTP) 헤드가 내장되어 있습니다. 디코딩 중에 이러한 헤드들이 미래 토큰을 제안하면 대상 모델이 이를 검증하여, 더 긴 응답에 필요한 순차적 생성 단계의 수를 줄입니다.
예를 들어, MTP는 세 개의 speculative 토큰으로도 활성화할 수 있습니다:
vllm serve nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4 \
  --served-model-name nemotron-3.5-super \
  --trust-remote-code \
  --speculative-config.method mtp \
  --speculative-config.num_speculative_tokens 3
특화된 상시 실행 에이전트 워크플로우를 위해 설계
조직은 NVIDIA NeMo를 사용하여 Nemotron 3.5 Super VL을 자신들의 용어, 데이터, 정책, 도구 및 워크플로우에 맞게 조정할 수 있습니다. 이를 통해 범용 멀티모달 모델이 도메인 특화 에이전트 작업을 위한 특화된 실행 엔진으로 변모하면서도 모델 동작과 데이터 처리에 대한 통제권을 유지할 수 있습니다.
예시 사용 사례
- 고객 서비스: 고객이 제공한 문서와 이미지를 해석하고, 정책을 적용하며, 서비스 도구를 활용하여 다단계 요청을 처리합니다.
- 문서 인텔리전스: OCR, 표, 차트, 페이지 레이아웃을 포함한 복잡한 문서를 해석하여 정보를 추출하고 요약 또는 보고서를 생성합니다.
- 엔터프라이즈 생산성: 시각 정보를 해석하고, 이를 기반으로 추론하며, 도구를 활용하여 다단계 작업을 완료합니다.
- 비디오 이해: 검색, 콘텐츠 검토, 광고, 소매, 사고 분석을 지원하기 위해 비디오에서 핵심 정보를 추출합니다.
- 웹 리서치: 여러 웹사이트를 검색하고, 여러 출처의 정보를 연결하며, 결과를 검증합니다.
멀티모달 에이전트 작업을 위한 정확도와 효율성
Nemotron 3.5 Super VL은 특화된 멀티모달 에이전트 작업에서 높은 정확도를 제공하면서도 각 토큰마다 전체 파라미터의 일부만 사용하도록 설계되었습니다. 하이브리드 Mamba-Transformer 아키텍처와 멀티 토큰 예측, 그리고 NVFP4 양자화는 출력 생성 속도를 높이는 데 도움을 줍니다.
그림 1에서 볼 수 있듯이, 단일 GPU에서 이 모델은 에이전틱 작업에 대해 다른 모델 대비 최대 5배 빠른 처리량을 제공합니다 오픈 모델 대비 에이전트 작업 처리량이 최대 5배 빠릅니다.
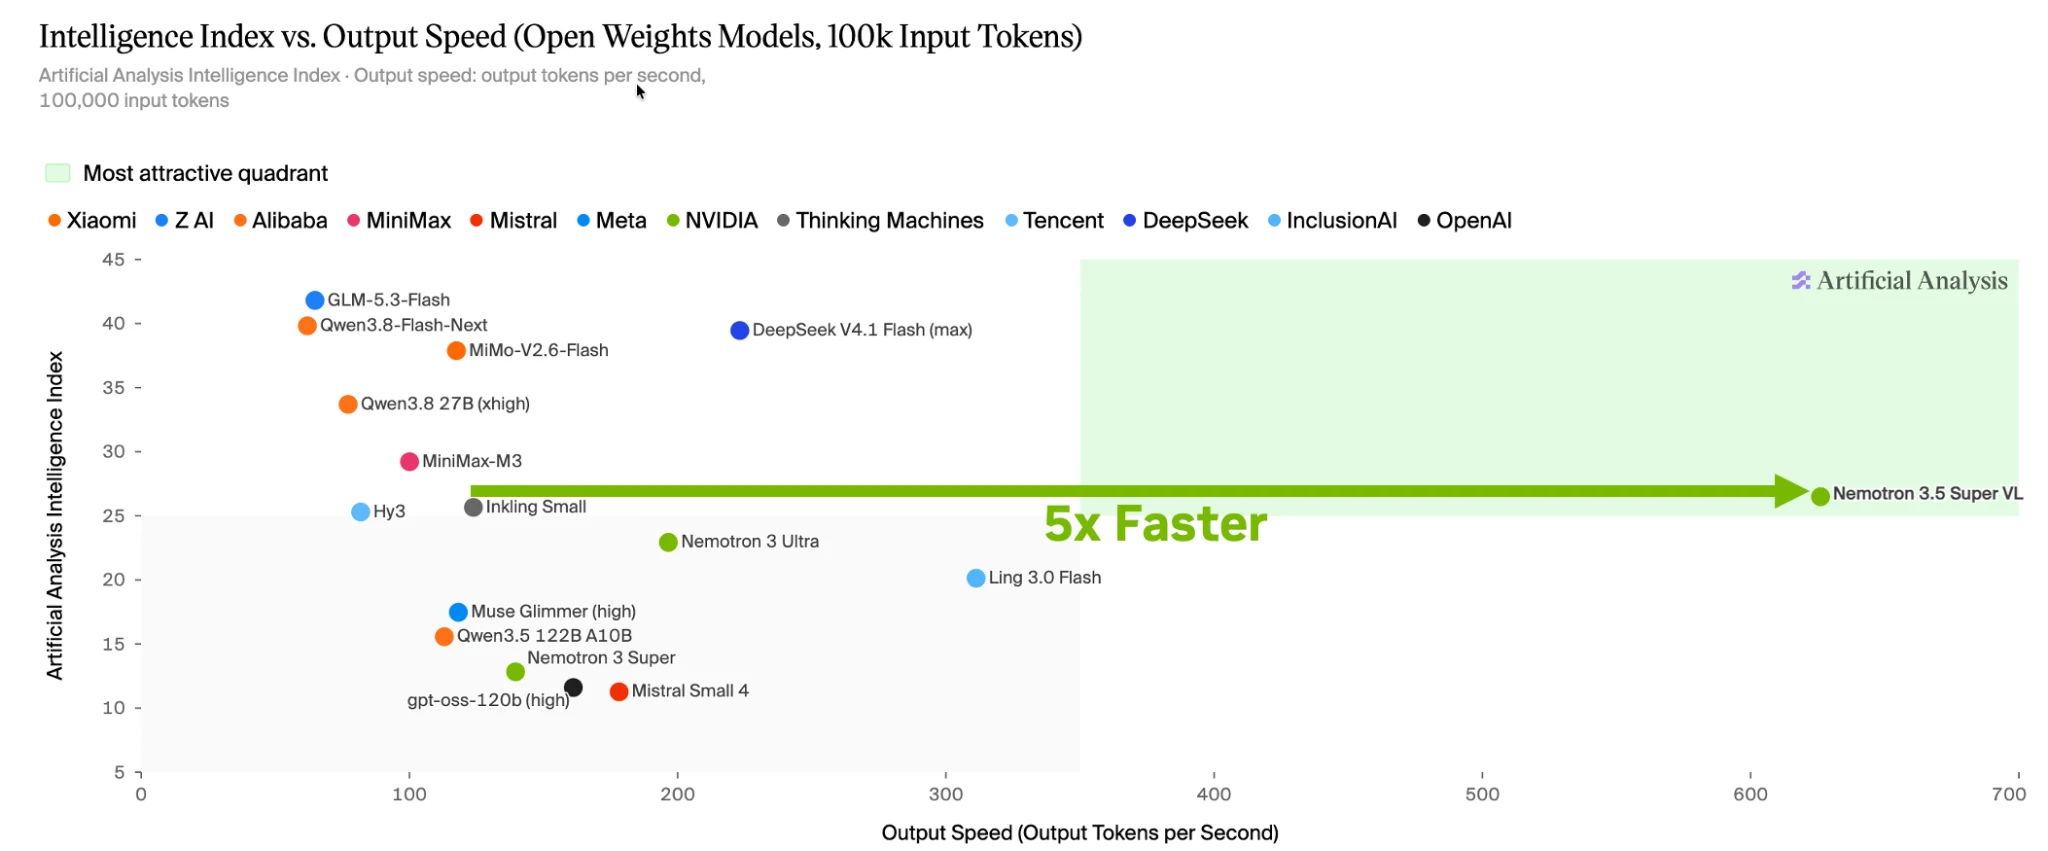
그림 1. Nemotron 3.5 Super VL은 Baseten 엔드포인트에서 Artificial Analysis Intelligence Index 에이전트 작업에 대해 600 TPS 이상을 제공합니다.
그림 2에서 볼 수 있듯이, Nemotron 3.5 Super VL은 비슷한 크기의 다른 선도적 오픈 모델 대비 작업을 4배 빠르게 수행합니다.
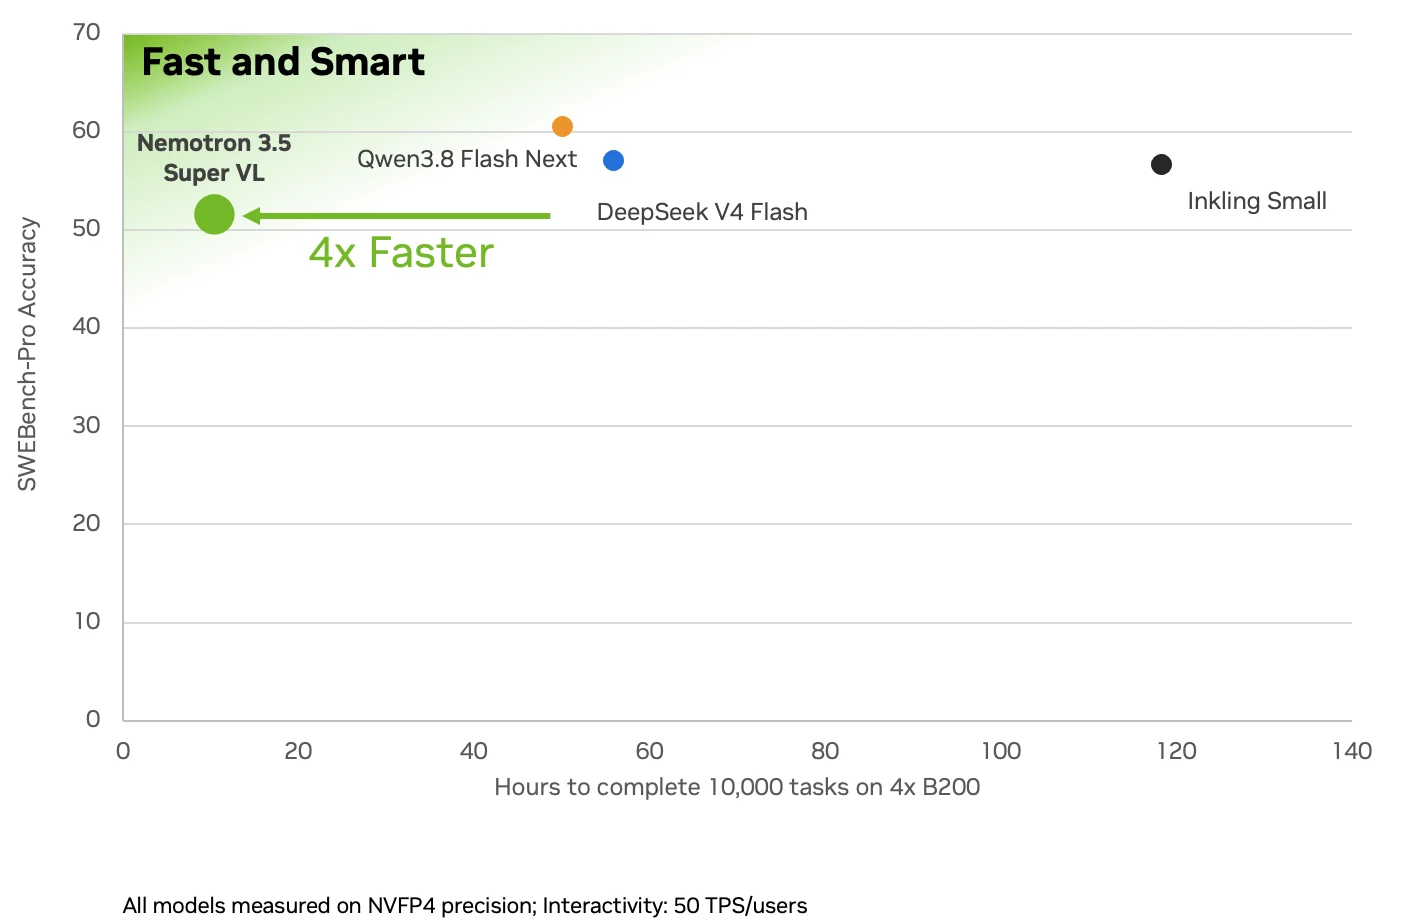
그림 2. Nemotron 3.5 Super VL은 더 높은 처리량과 토큰 효율성을 활용하여 작업 완료 속도를 4배 높입니다.
참고로, 그림 3은 관련 모델인 Nemotron 3.5 Super에 대한 DGX Spark 비교를 보여줍니다. 이 차트는 Nemotron 3.5 Super VL을 측정한 것이 아닙니다.
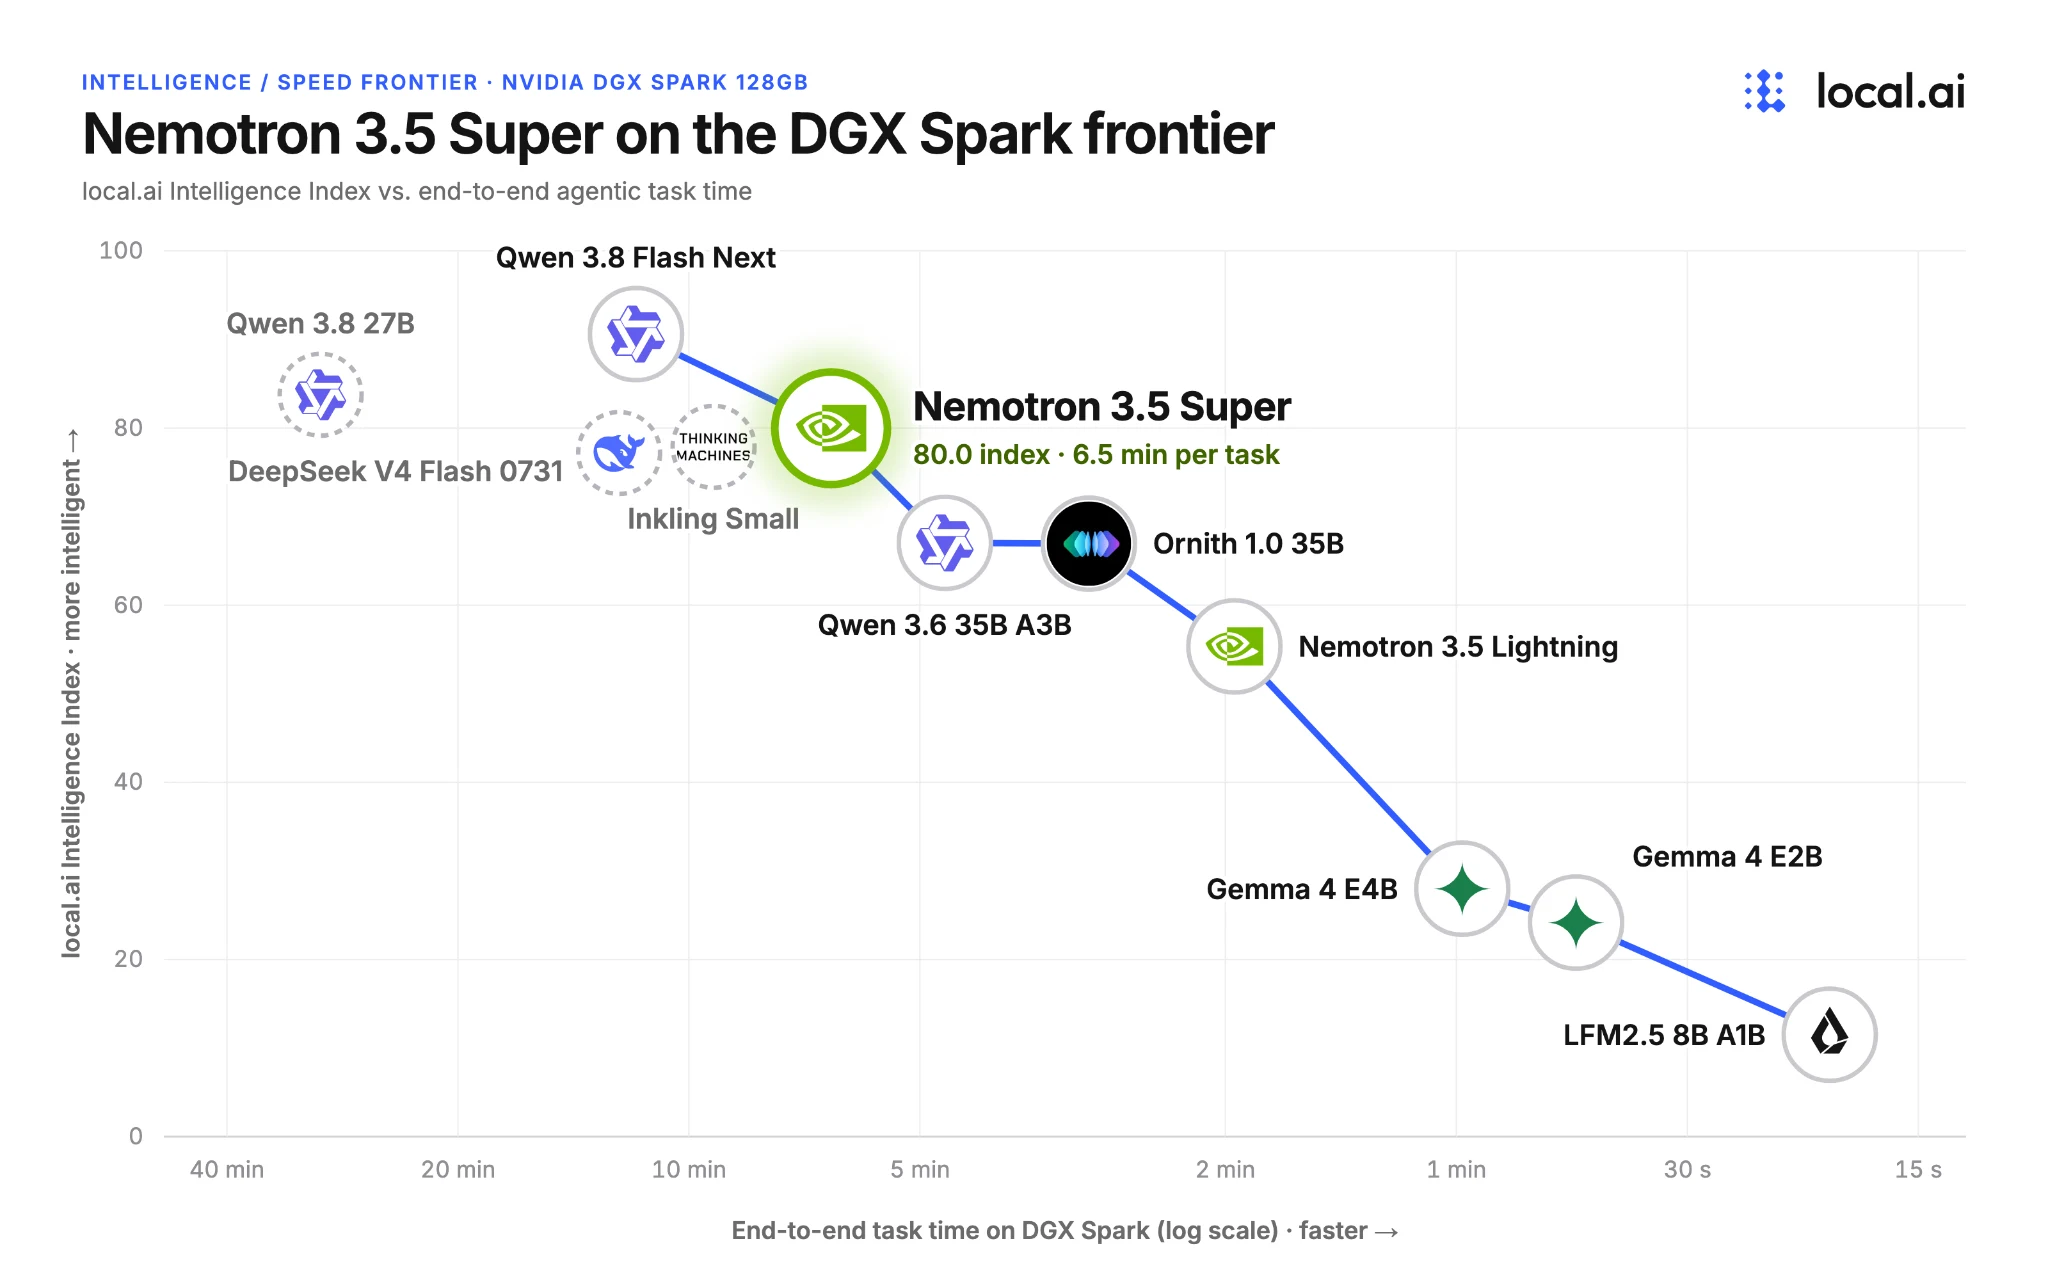
그림 3. DGX Spark 효율성 프론티어에서의 Nemotron 3.5 Super.
시작하기
보고, 추론하고, 행동할 수 있는 에이전트를 만들 준비가 되셨습니까?
감사의 말
NVIDIA: 니르말 쿠마르 줄루루(Nirmal Kumar Juluru), 아누샤 판트(Anusha Pant), 파라던 양(Faradawn Yang), 펜 충 리(Pen Chung Li), 알렉스 슈타이너(Alex Steiner), 란 질버스타인(Ran Zilberstein), 나베 아사프(Nave Assaf), 아미르 클라인(Amir Klein)