
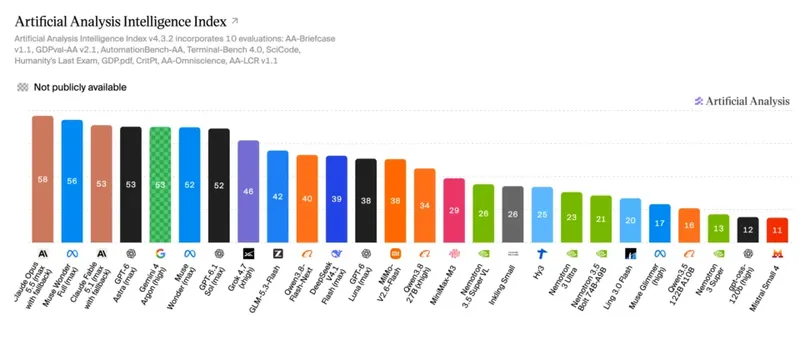
NVIDIA가 오늘, 특화된 상시 구동 에이전트를 위해 가장 빠른 작업 완료 속도와 최고 정확도를 제공하는 오픈 120B 파라미터 모델 Nemotron 3.5 Super VL을 출시했습니다.
여기에 두 개의 새로운 엣지 모델이 함께합니다: 로컬 에이전트 워크로드에서 GB당 지능과 속도의 균형에 최적화된 Nemotron 3.5 Bolt 74B-A9B 24GB, 그리고 빠른 대화형 에이전트를 위해 GB당 지능에 최적화된 Nemotron 3.5 Bolt E4B 4GB가 그것입니다.
Super VL과 Bolt 74B-A9B는 지금 이용 가능하며, Bolt E4B는 10월 23일에 출시됩니다.
이 세 가지 오픈 모델은 대형 엔터프라이즈 서버부터 엣지 기기 및 로컬 하드웨어에 이르는 에이전트 배포의 전체 범위를 함께 커버합니다.
NVIDIA 인프라에서 에이전트를 실행하려는 모든 조직은 이제 자신의 등급에 맞는 오픈되고 최적화된 모델을 갖게 되며, 성능과 배포 가능성 사이에서 선택할 필요가 없습니다.
Super VL과 Bolt는 Nemotron 패밀리에 Lightning 및 Ultra와 함께 합류합니다.
8월에 출시된 Lightning은 고처리량 워크로드를 처리하고, Ultra는 가장 어려운 추론 작업을 담당하며, Bolt는 엣지에 지능을 제공합니다.
Nemotron 3.5 Super VL: 5분의 1 크기로 프론티어급 정확도 구현
Nemotron Coalition 과 협력하여 구축된 Super VL은 명령 이행, 도구 사용, 다단계 비즈니스 워크플로, 시각적 이해 등 멀티모달 에이전트 작업에서 선도적인 정확도를 제공하며, 대략 5분의 1의 파라미터 수로 NVIDIA의 가장 큰 추론 모델에 필적합니다.Nemotron 3.5 Super VL은 대규모 에이전트 워크플로를 위해 자신의 클래스에서 프론티어급 지능을 제공합니다.
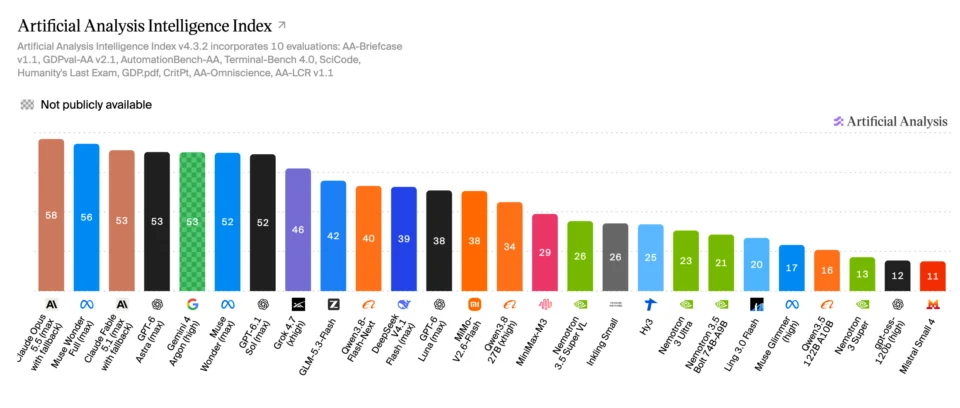
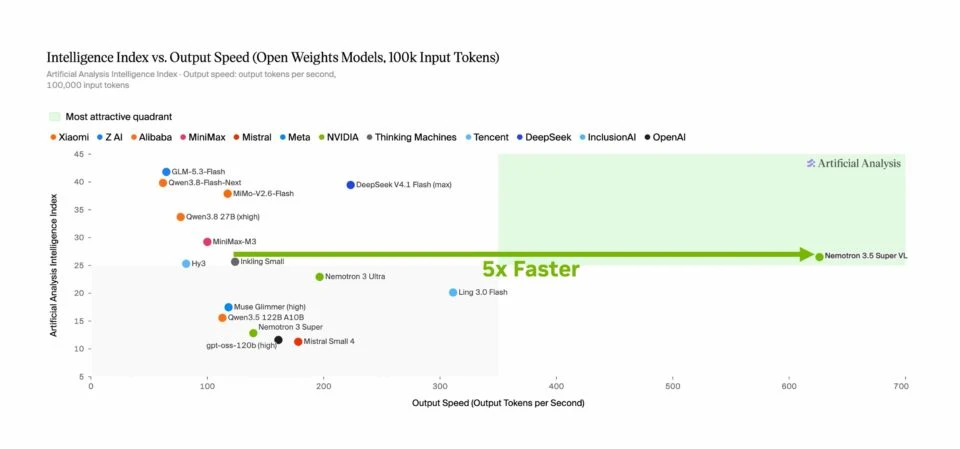
Nemotron 3.5 Super VL은 Artificial Analysis Intelligence Index 리더보드에서 자신의 클래스의 다른 모델들에 비해 최대 5배 빠른 처리량을 달성합니다.
Nemotron 3.5 Bolt: 엣지에서의 에이전트 지능
Nemotron 3.5 Bolt: 엣지에서의 에이전트 지능
Bolt 74B-A9B 24GB는 네이티브 2비트 양자화를 사용해 24GB 메모리에 맞추고 다른 애플리케이션과 함께 실행될 수 있도록 하여, NVIDIA RTX/DGX Spark에서 일상적인 에이전트 작업을 로컬로 실행하도록 설계되었습니다.
Bolt 74B-A9B 24GB를 통해 사용자는 웹 조사부터 글쓰기, 코드 디버깅에 이르기까지 자신의 프로젝트를 인기 있는 로컬 에이전트 하네스에 위임할 수 있으며, 모든 작업을 클라우드로 보낼 필요가 없습니다. 이 모델은
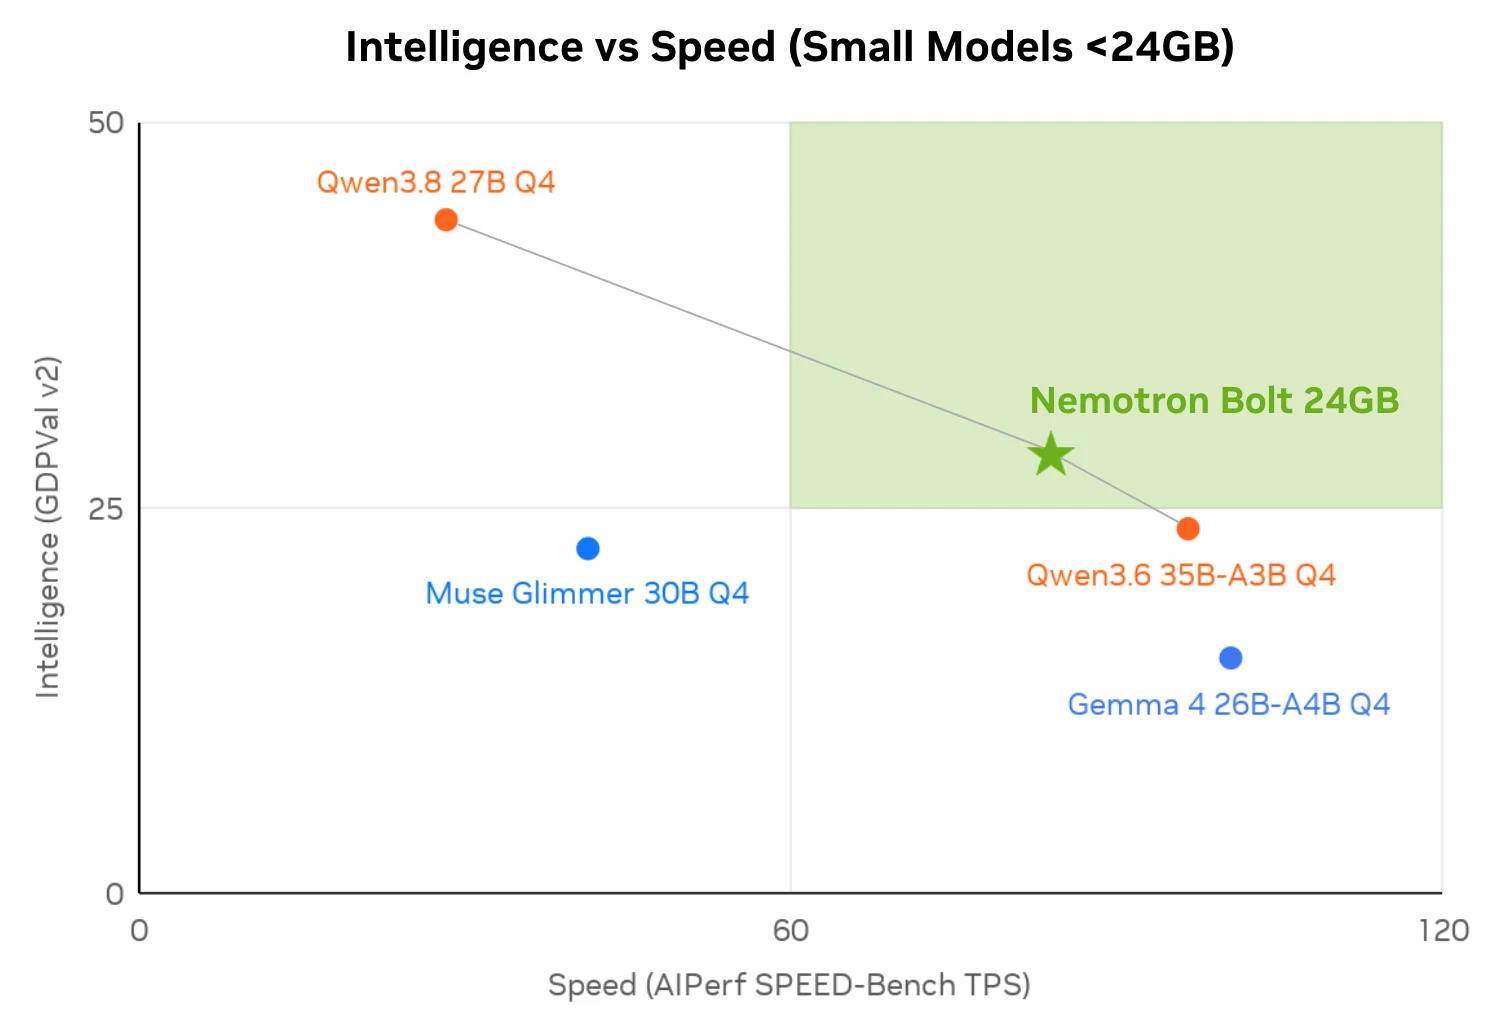
Bolt 74B-A9B 24GB를 사용하면 사용자는 웹 조사부터 글쓰기, 코드 디버깅에 이르는 프로젝트를 인기 있는 로컬 에이전트 하네스에 맡길 수 있으며, 그 어떤 워크로드도 클라우드로 보낼 필요가 없습니다. 이 모델은 클래스 내 #1 오픈 모델로서 다음에서 에서 자신의 클래스의 #1 오픈 모델이며,, 그리고 다음을 위한 #2 오픈 모델입니다. 에서 #2 오픈 모델입니다..
Bolt E4B 4GB는 GeForce RTX, Jetson 및 RTX/DGX Spark의 물리적 및 대화형 에이전트를 위해 만들어졌습니다. 자연스러운 대화와 다중 턴 에이전트 기능을 결합하여 빠른 로컬 음성 비서, 인터랙티브 캐릭터 및 임베디드 인터페이스를 구동합니다.
맞춤형 슈퍼 지능의 채택
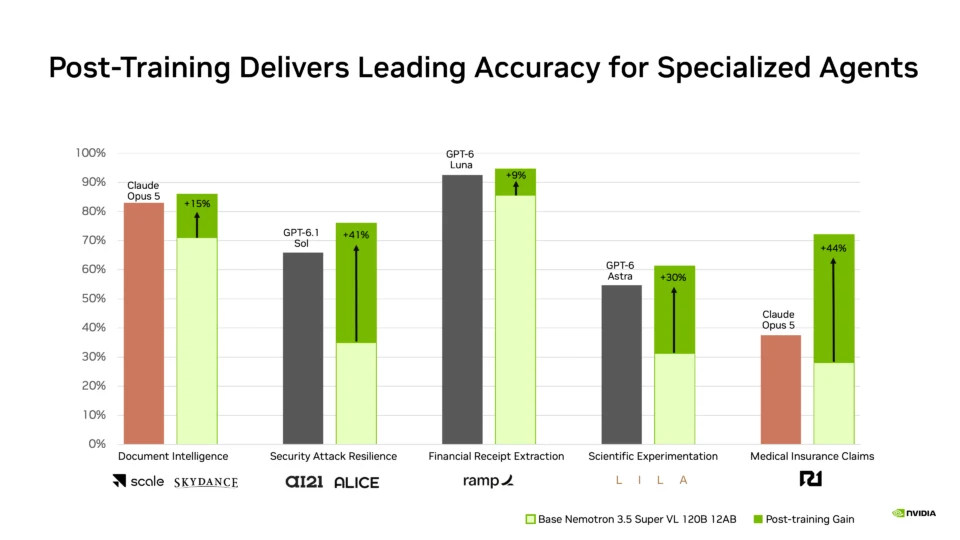
여러 산업 분야의 수십 개 조직이 자신의 데이터, 도구, 정책 및 워크플로로 Super VL을 포스트 트레이닝하여 자신의 에이전트 배포를 정의하는 특화된 작업에서 정확도를 더욱 높이고 있습니다.
Super VL은 여러 산업의 조직들이 포스트트레이닝 및 커스터마이징을 진행하고 있습니다. Scale AI 는 Skydance의 벤더 크레딧 파이낸스 에이전트와 EY의 M&A 실사(due diligence) 에이전트를 위해 모델을 포스트트레이닝했습니다. AfterQuery는 Hebbia를 위해 신용계약 분석용으로 모델을 커스터마이징했습니다. AI21 과 Alice 는 사이버 보안 공격 대응력을 위해 모델을 포스트트레이닝했습니다. Mercor는 계획, 작성, 디버깅을 수행하는 코딩 에이전트를 위해 APEX-SWE 코딩 벤치마크로 모델을 포스트트레이닝했습니다. ModelScope 는 개발자가 자사의 ms-swift 프레임워크를 통해 전문 멀티모달 애플리케이션용으로 모델을 파인튜닝할 수 있게 합니다.
Nemotron 3.5 Super VL을 커스터마이징하는 추가 기업으로는 금융 문서 인텔리전스 분야의 Ramp, 주권 AI 기반 사이버보안 연구 및 취약성 분석 기업 Dream, 과학적 발견 및 검색을 위한 Lila Sciences 등이 있으며, 그 외에 R1 의료 청구 분석 및 매출 주기 관리를 위한 것입니다. TrainLoop은 Nolla의 피부과 데이터로 모델을 포스트 트레이닝했으며, Nolla는 방금 AI가 환자의 초기 처방전을 작성하도록 승인받은 최초의 회사가 되었습니다.
Nemotron 3.5 Super VL를 통합하는 소프트웨어 플랫폼 기업은 다음과 같습니다:
- Atlassian, Jira, Confluence 같은 앱 전반에서 에이전틱 검색을 수행하는 작업을 위해서입니다.
- CrowdStrike기업 보안을 위한 에이전틱 블루 티밍(agentic blue teaming)에 맞춰 모델을 커스터마이징하고 있는 곳입니다.
- 다쏘 시스템(Dassault Systèmes), 엔지니어링 설계 및 시뮬레이션을 지원합니다.
- Perplexity, 검색 및 Perplexity Search와 Computer의 에이전트 작업을 위한 것입니다.
- Salesforce는 Missionforce Operations를 통해 안전한 고객 환경에서 복잡한 정부 워크플로를 디지털화하고 자동화하는 AI 에이전트를 구동하도록 Nemotron을 맞춤화하고 있습니다.
- Synopsys 의 반도체 설계 검증 상호 운용 소프트웨어가 이 모델과 연동됩니다.
Nemotron 3.5 Super VL이 실제로 보는 것
Nemotron 3.5 Super VL의 비전 언어 강점은 에이전트가 실무에서 마주하는 대상, 즉 광학 문자 인식, 표, 차트, 시각 문서의 구조화된 정보에 맞춰져 있습니다.
웹 페이지를 처리하고, 텍스트를 추출하고, 그래프와 차트를 읽고, 발견한 내용에서 인사이트를 반환합니다. PDF 및 에이전트가 일반적으로 다루는 다른 문서에도 동일하게 적용됩니다.
Nemotron 3.5 Super VL은 이미지, 웹페이지, PDF를 이해하고 그 이해를 바탕으로 행동합니다. 하나의 모델에서 텍스트와 시각 이해를 결합함으로써 에이전트는 별도의 시스템 간에 작업을 전달할 필요가 없습니다 — 문서에서 데이터로, 데이터에서 의사결정으로 작업이 이동할 때 맥락이 그대로 이어집니다.
최대한의 제어, 보안, 프라이버시를 위한 개방
개방성과 맞춤화 가능성은 서로를 강화합니다. 이 모델은 오픈 웨이트, 오픈 데이터셋, 훈련 레시피와 함께 제공됩니다.
제어는 두 방향으로 작동합니다. 조직은 보안 및 데이터 상주 요구 사항이 지시하는 어디에서든 모델을 실행할 수 있습니다. 또한 공급자의 제한을 받는 모델이 아니라 자신이 적응시킬 수 있는 모델을 채택하도록 선택할 수 있습니다.
예를 들어 보험 분야에서 맞춤화된 에이전트는 반복적으로 청구 건을 검사하여 사기 징후를 찾아낼 수 있습니다. 금융 서비스 분야에서는 에이전트가 신용 점수를 검토하고 조직 자체의 대출 기준에 어긋나는 활동을 표시할 수 있습니다. 모델은 온프레미스에 머물고, 데이터는 비공개로 유지됩니다.
맞춤화는 NVIDIA NeMo, Python 기반 파이프라인, 오픈 데이터셋을 통해 지원됩니다.
Nemotron 3.5 Super VL은 약 26조 개의 토큰으로 사전 훈련 및 지속 사전 훈련을 거쳤으며, 이후 약 3.8백만 개의 샘플과 수십 개 환경에 걸친 강화 학습을 통해 사후 훈련되었습니다.
NVIDIA는 또한 에이전트 도구 사용, 금융, 지시 사항 수행, 긴 컨텍스트, 공정성 및 비전-언어 이해 부문에서 뛰어난 성능을 보이며, NeMo Gym의 강화 학습 환경도 함께 제공됩니다.
NVIDIA NIM 은(는) 이 모델을 성능 최적화된 검증된 구성과 엔터프라이즈급 지원을 갖춘 프로덕션 준비 완료 마이크로서비스로 패키징하며, 보안 패치와 성능 개선이 2주마다 갱신됩니다.
또한 모델이 NVIDIA Dynamo에서 실행되면 조직은 최대 8배 더 많은 사용자를 85% 낮은 지연 시간으로 서비스할 수 있습니다.
Nemotron 3.5 Super VL은 현재 Hugging Face, Open Router, ModelScope 커뮤니티 에서 이용할 수 있으며 NVIDIA NIM으로도 제공됩니다.
DGX Spark, DGX Station 및 RTX에서 실행
Nemotron 3.5 Super VL은 NVIDIA의 전체 하드웨어 스택에서 실행됩니다: 데스크톱의 로컬 인텔리전스를 위해 DGX Spark, DGX Station, RTX PRO 및 RTX 시스템에서, 엣지에서는 NVIDIA Jetson 에서, 그리고 데이터 센터 및 클라우드 환경 전반에서 실행됩니다.
Nemotron 3.5 Bolt 74B-A9B 24GB 이제 Hugging Face에서 이용 가능하며, llama.cpp를 지원합니다, Ollama, LM Studio, Unsloth, 그리고 vLLM. ~를 위해 설계되었습니다 NVIDIA RTX Spark 노트북 10월 16일에 출시되며, 또한 다음에서도 실행됩니다 GeForce RTX PC, DGX Spark, DGX Station 그리고 RTX PRO 워크스테이션.
다음을 다운로드하세요 오픈 웨이트(open weights), NVIDIA NeMo로 맞춤화 리소스를 살펴보거나 다음을 읽어보세요 기술 블로그 전체 아키텍처 분석 내용을 확인하세요.
에이전트와 NVIDIA 관련 최신 소식을 계속 확인하세요. Nemotron 그 외 더 많은 소식을 받아보려면 다음을 구독하세요: NVIDIA 뉴스, 커뮤니티 참여, 그리고 다음에서 NVIDIA AI 팔로우: LinkedIn, Instagram, X 그리고 Facebook.
탐색하기 자기 주도형 비디오 튜토리얼 및 라이브 스트림.
보기 공지 소프트웨어 제품 정보에 관한 것입니다.