IT之家 10월 15일 소식, 엔비디아가 지속적으로 실행되며 다단계 작업을 수행하는 AI 에이전트를 위한 오픈 멀티모달 모델 Nemotron 3.5 Super VL 출시를 발표했다.
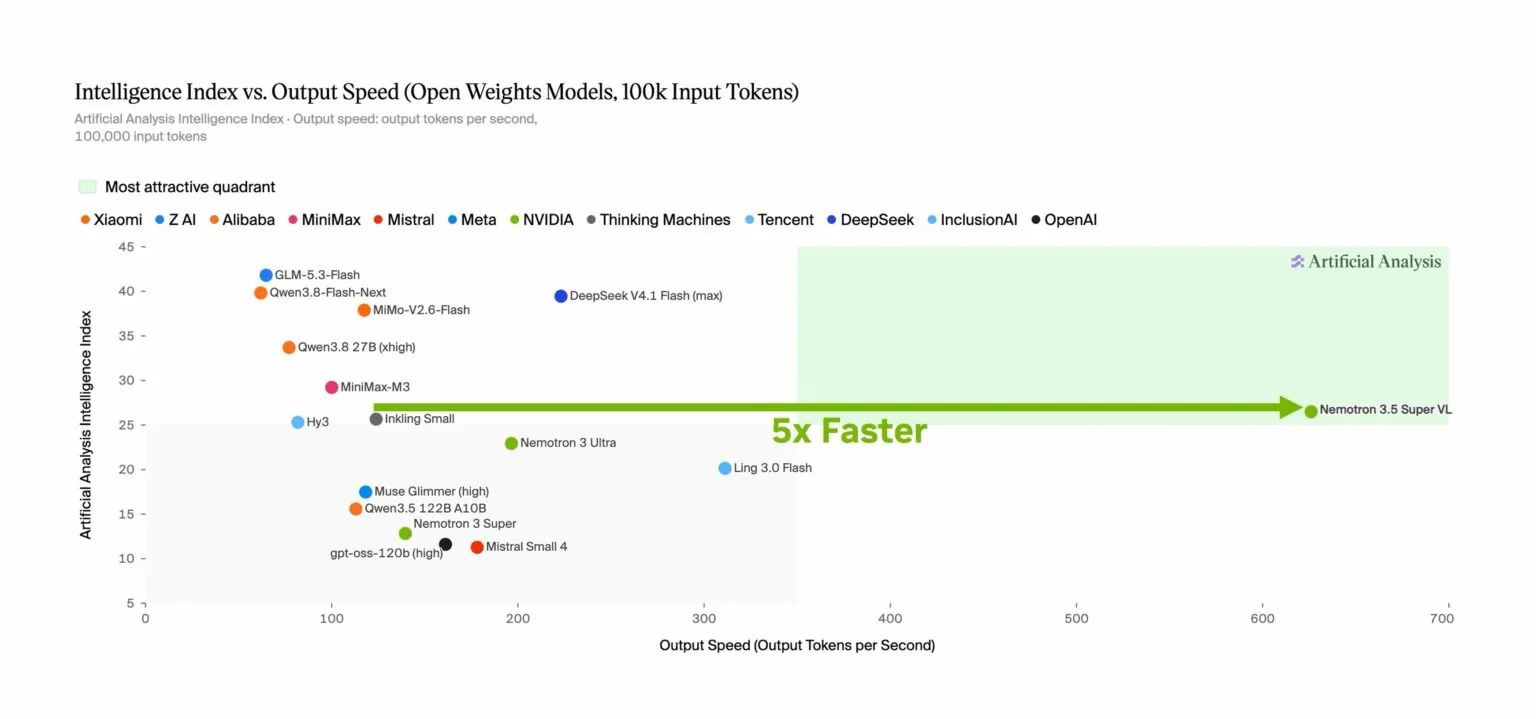
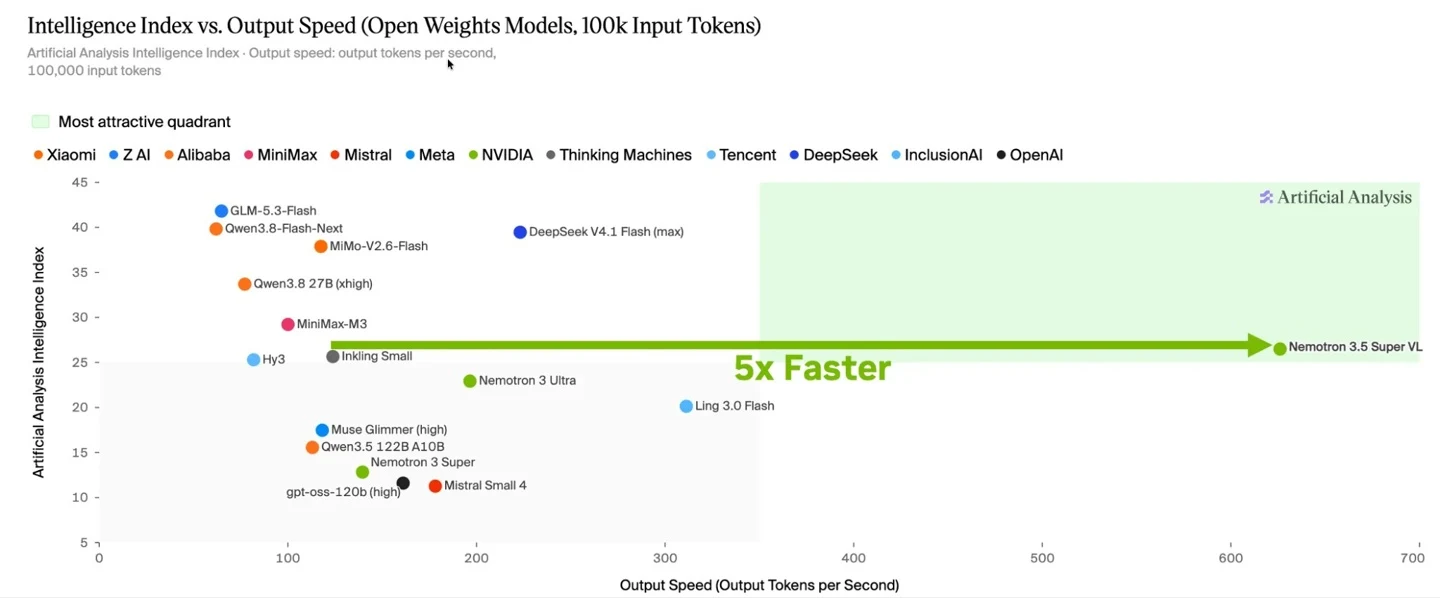
이 모델은 혼합 전문가(MoE) 아키텍처를 채택해 총 파라미터는 1200억, 활성 파라미터는 120억이다. 엔비디아에 따르면 단일 GPU에서 에이전트 작업을 실행할 때 이 모델의 처리량은 동일 규모의 다른 오픈 모델 대비 최대 5배에 달한다.
소개에 따르면 Nemotron 3.5 Super VL은 추론, 지시 사항 준수 및 도구 호출 능력과 텍스트, 이미지, 문서 및 비디오 이해 능력을 하나의 모델에 통합했으며, 코드 테스트 및 디버깅, 웹사이트 간 정보 검색, 문서 분석, 사이버 보안 위협 식별, 비디오 콘텐츠 검색 등의 시나리오에 활용할 수 있다. 개발자는 엔비디아 NeMo 툴체인을 활용해 자체 데이터, 도구, 정책 및 워크플로를 결합해 후속 학습을 진행하고 비즈니스 요구에 따라 모델 동작을 조정할 수 있다.
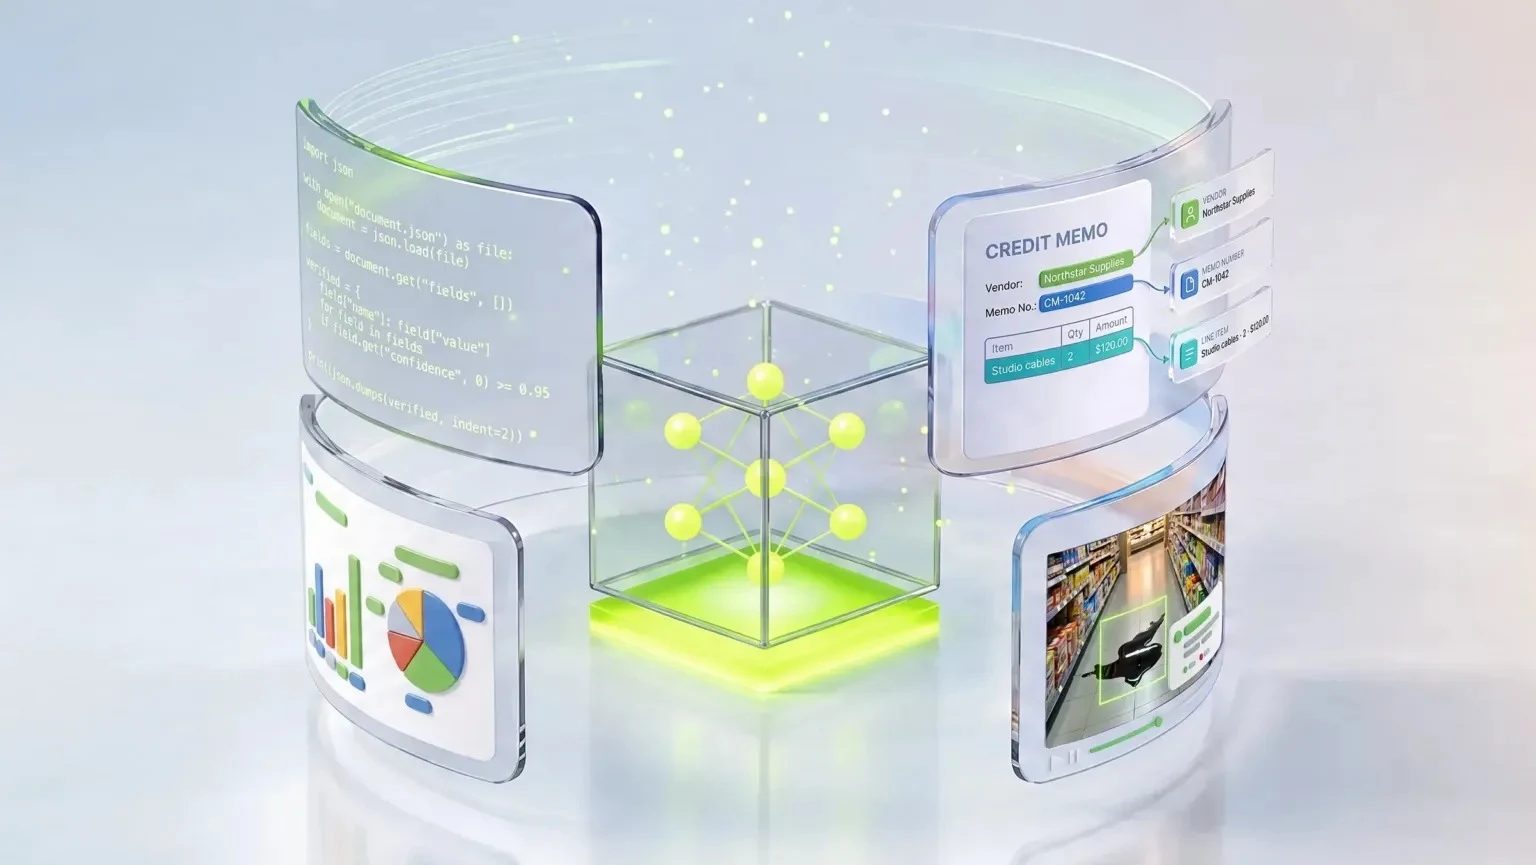
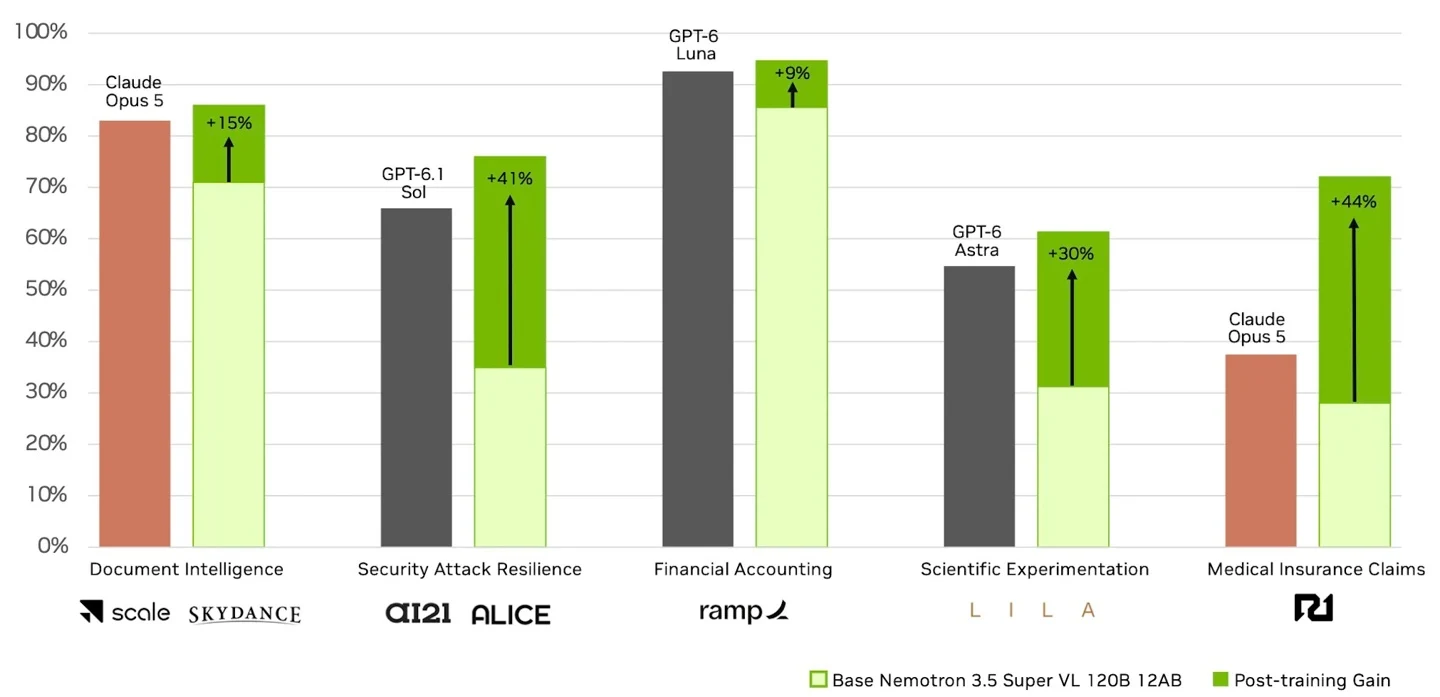
엔비디아는 동시에 여러 기업 맞춤형 사례를 공개했다. 예를 들어 AI 데이터 기술 기업 Scale AI는 미디어 엔터테인먼트 회사 Skydance Corporation을 위해 공급업체 크레딧 처리 에이전트를 맞춤 제작했으며, 관련 워크로드의 추론 비용은 97.5% 절감, 지연 시간은 80% 단축될 것으로 예상된다.
금융 운영 플랫폼 Ramp는 영수증 이미지를 판매자, 날짜 및 결제 정보를 포함한 구조화된 JSON 데이터로 변환하고 있으며, 처리량이 최대 50% 향상, 지연 시간은 90% 단축될 것으로 예상된다. AI21은 AI 보안 회사 Alice와 협력해 위협 인텔리전스 및 취약점 분석용 모델을 맞춤 제작했으며, 관련 작업 정확도가 40% 향상됐다.
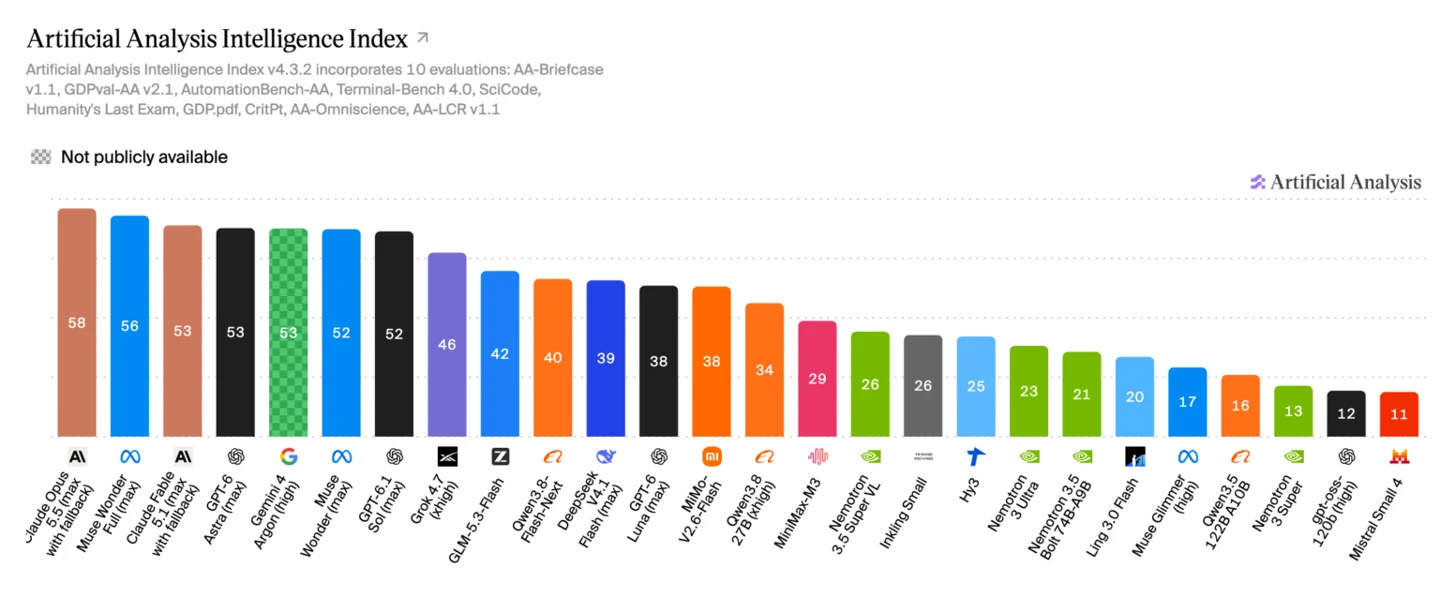
모델 평가 측면에서 엔비디아는 Nemotron 3.5 Super VL이 CharXiv 차트 추론 벤치마크에서 80.8%의 점수를 기록해 Nemotron 3 Nano Omni의 63%를 상회했으며, Python 코드 해석을 결합하면 점수가 84%에 도달한다고 밝혔다.
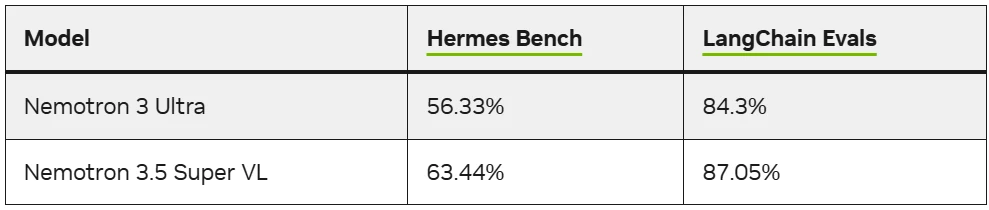
Hermes Bench와 LangChain 행동 평가에서 이 모델은 각각 63.44%와 87.05%를 기록해 Nemotron 3 Ultra의 56.33%와 84.3%를 상회했다. 엔비디아는 또한 이 모델이 OCRBench v2 순위에서 상위권을 기록하는 오픈 모델 중 하나라고 밝혔다.
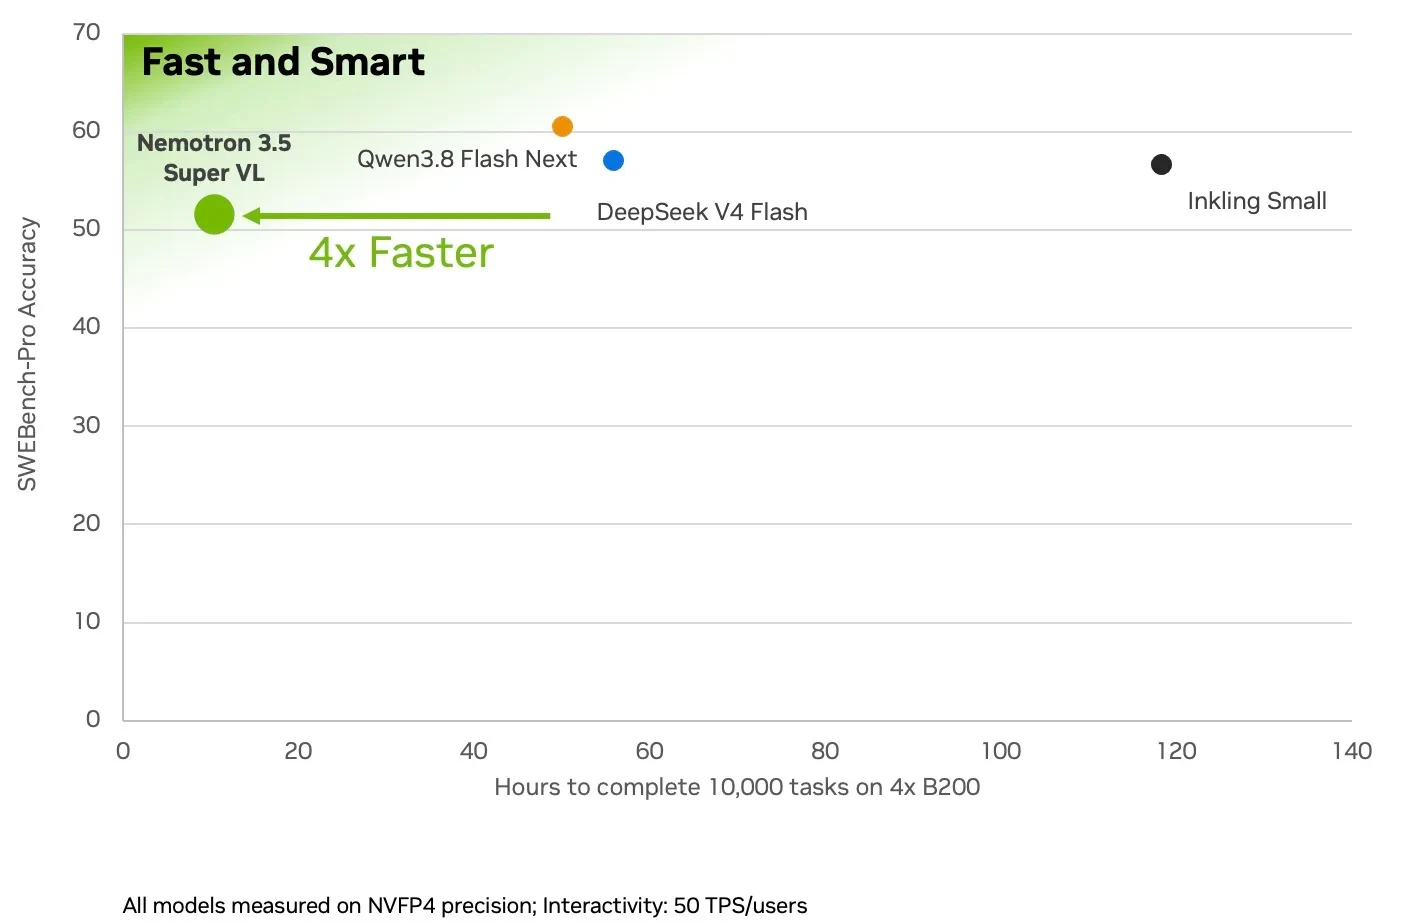
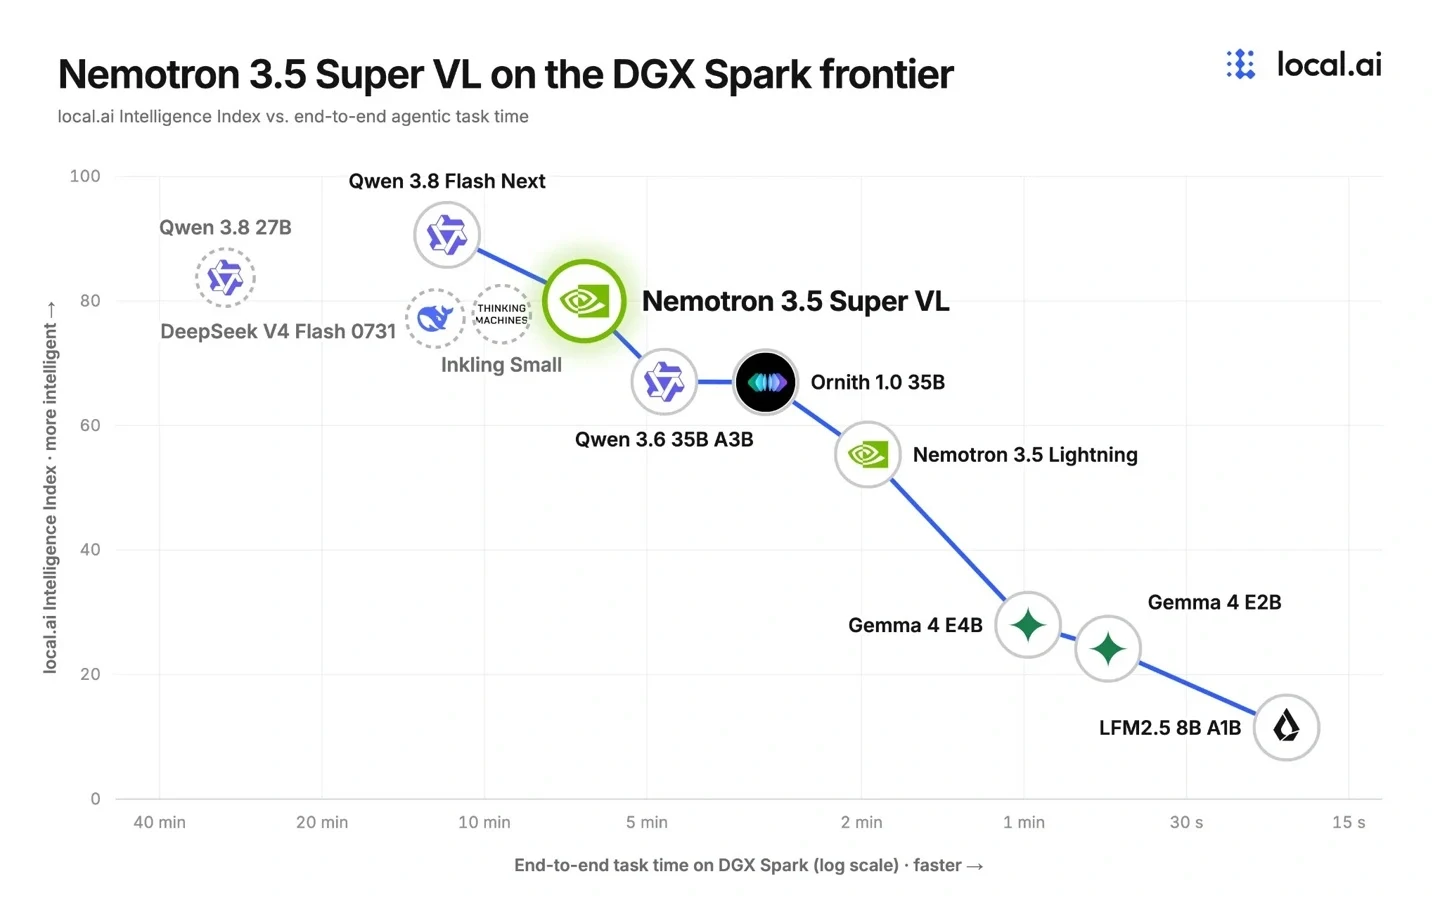
추론 오버헤드를 낮추기 위해 Nemotron 3.5 Super VL은投机 디코딩(speculative decoding), 혼합 정밀도, 컨텍스트 재사용 등의 기술을 채택했다. 엔비디아에 따르면 LiLiCorr 投机 디코딩 방법은 DGX Spark에서 토큰 생성 속도를 최대 2.3배까지 높일 수 있다. 모델은 또한 NVFP4 양자화를 지원하며, 엔비디아 Blackwell 아키텍처에서는 4비트 가중치와 4비트 활성값을 사용하고, 비 Blackwell 플랫폼에서는 동일한 체크포인트가 4비트 가중치와 16비트 활성값을 사용한다.
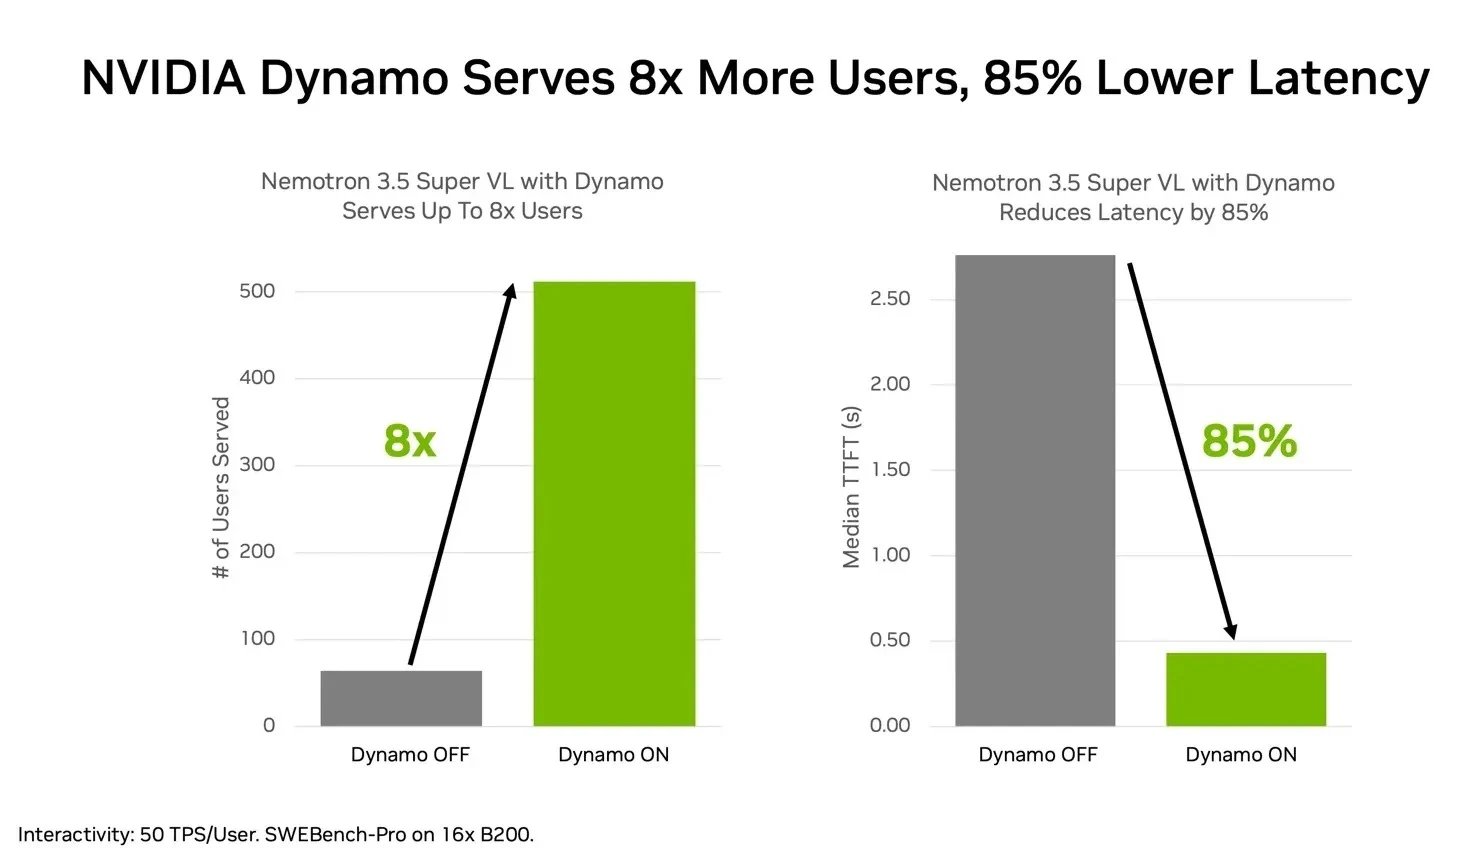
엔비디아는 또한 분산 추론을 위한 배포 최적화 방안도 공개했다. 공개된 데이터에 따르면 NVIDIA B200 GPU 16장, 사용자당 초당 50개의 토큰을 생성하는 테스트 조건에서 NVIDIA Dynamo는 캐시 인식 라우팅, 세션 어피니티 및 KV 캐시 오프로드와 결합해 최대 8배 많은 사용자를 서비스할 수 있으며 첫 토큰 지연 시간을 85% 단축했다.
이번 공개에는 기반 모델, 후속 학습 모델 및 NVFP4 양자화 모델 가중치는 물론 학습 레시피, 데이터셋 및 강화 학습 환경도 포함된다.
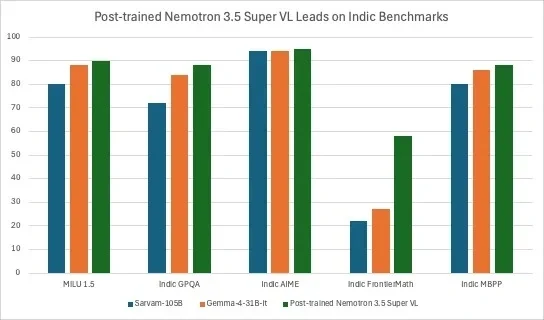
엔비디아에 따르면 Nemotron 3.5 Super VL은 사전 학습 및 지속 사전 학습 단계에서 총 약 26조 개의 토큰을 사용했고, 후속 학습 단계에서는 약 380만 개의 샘플을 사용했으며 수십 가지 환경에서 강화 학습을 진행했다. 새롭게 공개된 데이터셋은 에이전트 도구 호출, 금융 추론, 지시 사항 준수, 긴 컨텍스트, 공정성 및 시각-언어 이해 등 분야를 다룬다.
Super VL 외에 엔비디아는 Nemotron 3.5 Bolt 엣지 측 모델 두 종도 선보였다. Nemotron 3.5 Bolt 74B-A9B 24GB는 총 740억 파라미터, 활성 90억 파라미터의 MoE 아키텍처를 채택했으며, 네이티브 2비트 양자화를 통해 모델을 24GB로 압축했고, 로컬 에이전트 작업을 대상으로 llama.cpp, vLLM, Ollama, Unsloth 및 LM Studio를 지원한다. Nemotron 3.5 Bolt E4B 4GB는 로컬 음성 비서, 인터랙티브 캐릭터 및 임베디드 인터페이스 등의 시나리오를 대상으로 하며 10월 23일 출시 예정이다.
IT之家는 Nemotron 3.5 Super VL과 Bolt 74B-A9B 24GB가 이미 공개되어 있으며, 개발자는 Hugging Face, OpenRouter, ModelScope 등의 경로를 통해 관련 모델 리소스를 이용할 수 있다는 점에 주목했다. Super VL은 DGX Spark, DGX Station, RTX 시스템, 데이터 센터 또는 클라우드에 배포할 수 있으며, Bolt E4B 4GB는 10월 23일 출시 예정이다.