

Google은 Gemini 4 Argon이 로봇에게 필요한 유일한 AI 모델이 되기를 원합니다
 조나단 켐퍼
Jonathan Kemper의 LinkedIn 프로필 보기
2026년 10월 15일
 구글 딥마인드(Google Deepmind)
핵심 요점
- Gemini 4 Argon은 로봇을 제어하고, 대화형 3D 훈련 환경을 생성하며, 훈련 데이터를 평가하는 단일 AI 모델을 만들려는 Google의 시도입니다.
- 사진이나 스케치 같은 간단한 입력만으로, 이 시스템은 로봇이 실제 배치 전에 움직임을 연습할 수 있는 시뮬레이션을 구축합니다.
- 이 데모는 여전히 상세한 인간의 프롬프트 작성과 안내가 필요합니다. Argon은 Google의 유료 개발자 액세스 프로그램을 통해 이용할 수 있습니다.
Gemini 4 Argon으로 구글은 로봇공학 파이프라인 전체를 아우르는 단일 모델을 내놓고 있습니다. 이 모델은 로봇을 제어하고, 가상 연습 세계를 구축하며, 훈련 영상을 평가합니다. 하지만 예시 프롬프트들은 이 모델이 여전히 얼마나 많은 사람의 손길이 필요한지를 잘 보여줍니다.
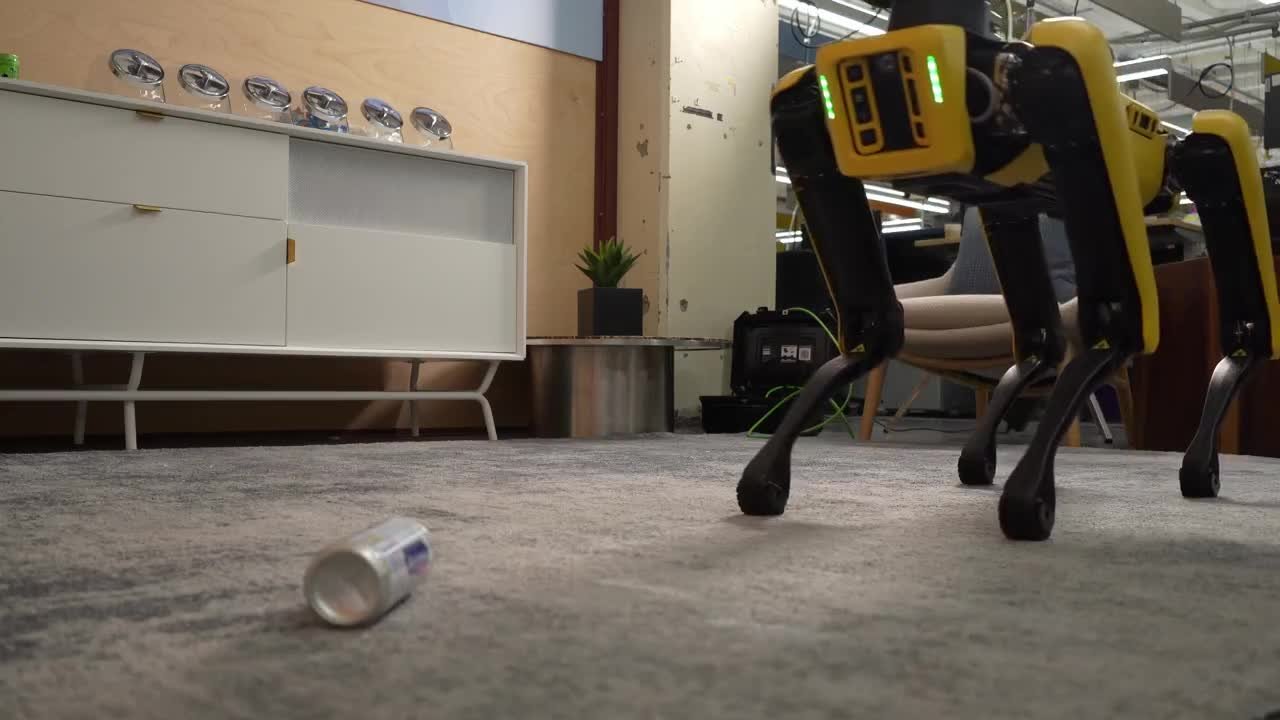
보스턴 다이내믹스(Boston Dynamics)의 Spot 로봇이 소다 캔을 페달식 쓰레기통에 던져 넣는 작업을 수행하게 된다. 실제 페달을 밟기 전에 Gemini 4 Argon이 쓰레기통의 가상 복제본을 만들고, 로봇은 그 시뮬레이션 안에서 세 개의 다리로 균형을 잡는 연습을 한다. 그 후에야 실제 하드웨어에서 작업을 시도한다. 캔을 놓기 전에는 두 개의 추가 AI 에이전트가 발과 그리퍼가 올바른 위치에 있는지 확인한다.
구글이 자사의 그런 방식으로 능력을 시연한다 로봇 작업용 최신 모델Argon은 공간적 관계를 더 잘 파악하고, 제어 코드를 작성하며, 물리학의 관점에서 비디오를 해석하도록 설계되었습니다. Google은 이 모델을 개별 로봇 제어부터 발표된 연구 재현에 이르기까지 모든 것을 아우르는 범용 도구로 보고 있으며, 자사와 AI 자회사 DeepMind가 추구해 온 목표인 "물리적 AGI(physical AGI)"를 향한 또 한 걸음이라고 불렀습니다. 수년간 추구해 온.

단 한 장의 사진이 수천 번의 학습 실행으로 변합니다
Spot 시연은 구글의 많은 예제에서 나타나는 패턴을 보여줍니다: Argon은 시뮬레이션을 사용해 작업을 준비하고, 검증하거나, 학습 데이터를 생성합니다. 파티 소품이 놓인 탁자 사진 한 장으로부터 모델은 부드러운 봉제 모자를 포함한 가상 복제본을 만들어냈습니다. 이 모델은 넘어진 물건을 바로 세우는 것부터 탁자를 치우는 것까지 77개의 작업을 도출했고, 제어 모델을 위해 4,500개가 넘는 학습 에피소드를 생성했습니다. 실제 로봇에서 테스트했을 때 성공률은 56퍼센트에서 75퍼센트로 상승했고 실행 시간은 35초에서 24초로 단축되었습니다.Ad

Argon은 다른 소스에서도 작업할 수 있습니다. 원격 조작 로봇의 녹화 데이터를 바탕으로, 동일하게 보이도록 설계된 시뮬레이션을 구축하고 손끝에서 동일한 힘 측정값을 재현합니다. 사람이 파지 작업을 수행하는 1인칭 영상에서는 이 모델이 손과 손가락 움직임을 다섯 손가락이 달린 가상 휴머노이드에 매핑합니다.
볼펜 스케치도 충분합니다. 한 그림은 휴머노이드 로봇이 공으로 상자 피라미드를 무너뜨리는 장면을 담고 있으며, Argon은 이를 로봇이 넘어지지 않고 여섯 개의 상자를 모두 쓰러뜨리는 던지기 동작을 계산하는 시뮬레이션으로 바꿔줍니다.

Argon이 AI 비디오 모델에 로봇 동작 계획을 지시한다
한 데모는 완전히 AI 생성 영상 안에서 진행됩니다. Gemini Omni Argon은 장면 안에서 무언가 일어났을 때 그 장면이 어떻게 변하는지를 보여주는 클립을 생성하는 비디오 월드 모델이며, Argon은 감독 역할을 합니다. 스크래블 타일을 테이블 중앙으로 밀어 넣는 것과 같이 손이 해야 할 동작을 설명하는 타임스탬프가 찍힌 지시문을 작성합니다. Gemini Omni는 그 지시문으로부터 비디오를 생성하고, Argon은 개별 프레임을 확인한 뒤 다음 명령을 조정합니다. 목표는 흩어진 5개의 글자 타일을 배열해 "ARGON"을 만드는 것이며, 33단계 후에 타일들이 올바른 순서로 놓입니다.

간단한 로봇 팔을 사용한 별도의 데모에서 Argon은 레고 블록을 나무 상자에 넣고 시간이 지남에 따라 자신의 성능을 개선해야 했다. 시도가 실패하면 프롬프트는 Argon에게 자신의 로그와 카메라 이미지를 검토하고 원인을 찾아 검증된 수정 사항을 적용한 후 재시도하도록 지시했다. 첫 번째 실행은 1분 약간 못 미치는 시간이 걸렸고, 두 번째는 23초로 훨씬 빨랐지만 블록이 상자 가장자리에 걸렸다. 세 번째 시도에서는 약 17초 만에 정확히 중앙에 떨어졌다.Ad

Google은 또한 Argon이 연구에 기여하기를 바란다. 논문당 하나의 프롬프트만 주어지면, 발표된 로보틱스 실험을 브라우저에서 실행되는 대화형 시뮬레이션으로 재현한다. Google에 따르면 지금까지 68개의 이러한 샌드박스가 구축되었으며, 여기에는 로봇 축구와 스케이트보드를 타는 휴머노이드 로봇이 포함된다.
The ERQA 벤치마크 (Embodied Reasoning Question Answering)는 AI 모델이 3D 환경에서 물리적·공간적 문제를 얼마나 잘 이해하고 해결하는지 테스트한다. 이 테스트는 보조 도구 없이 400개의 질문을 사용했으므로, 모델은 오직 추론만으로 모든 것을 해결해야 했다. Google에 따르면 Argon은 87퍼센트를 기록하며 다른 모든 프론티어 모델을 앞섰다. 2위인 Claude Opus 5.5는 82.3퍼센트를 기록해 약 5퍼센트포인트 뒤졌다. GPT-6 Astra는 81퍼센트로 뒤이었고, Claude Fable 5.1은 74퍼센트로 13포인트 뒤졌다.

The AA-Robotics 벤치마크는 Artificial Analysis가 하루 뒤에 발표한 것으로, 다른 이야기를 들려준다. 이 테스트에서 언어 모델은 8개의 작업에 걸쳐 실제 로봇 팔을 직접 제어하며, Argon은 100점 만점에 55점으로 3위를 차지했는데, GPT-6 Astra의 69점과 GPT-6.1 Sol의 65점에 뒤졌다.
Argon은 또한 학습 데이터 품질을 검토한다
로봇 제어와 시뮬레이션 구축 외에도, Argon은 학습 데이터를 평가하는 데 쓰이도록 만들어졌다. 양팔 로봇이 종이여우를 접는 2분 조금 넘는 영상에서, 모델은 시퀀스를 하위 단계로 나누고 멈춤과 잘못된 집기를 표시한다. 이러한 구간들은 학습 중 가중치가 낮게 적용된다. 인간이 링을 분류하는 또 다른 영상에서, Argon은 작업이 진행되거나, 정체되거나, 후퇴하는 지점을 추적했다.
Google은 또한 고전 저울 퍼즐을 중심으로 만들어진 더 장난스러운 사용 사례를 선보였다. 열두 개의 동일하게 생긴 공 중 하나가 나머지보다 무겁거나 가볍다. Argon은 두 개의 로봇 팔과 저울이 있는 시뮬레이션을 구축했으며, 저울의 기울기를 오직 카메라 이미지에서만 판독했다. 그것은 세 번 이하의 저울질로 다른 공을 찾아낸다.
진짜 비결은 프롬프트에 있다
Google은 데모에 대한 상세한 예시 프롬프트를 공개했으며, 이는 더 큰 주장들 일부를 제대로 보여준다. "제로샷"으로 묘사된 넘어진 컵 바로잡기의 경우, Argon은 센티미터 격자가 겹쳐진 카메라 이미지와 "잡기" 또는 "접촉할 때까지 내리기" 같은 미리 만들어진 명령을 받는다. 시뮬레이션의 경우, 측정된 센서 값을 단순히 복사하는 것 같은 지름길을 모델이 택하지 못하도록 하는 긴 금지 목록이 있다. Google은 블로그 포스트에서 개별 데모의 실패율을 공개하지 않으며, 75퍼센트 성공률은 그것이 몇 번의 전체 시도를 기반으로 하는지에 대한 언급이 전혀 없다.

Argon은 현재 Google AI Studio 와 개발 환경 Antigravity에서 이용할 수 있지만, Google AI Ultra 구독자에게만 제공된다. 개발자는 유료 등급의 Gemini API.
를 통해서도 모델에 접근할 수 있다. Google은 며칠 전 Gemini 4 Argon 을 전 세계에 출시했다. 로보틱스 분야에서는 이미 Gemini Robotics-ER 1.6, 즉 공간 지각과 작업 계획을 위한 모델을 선보였다. 가상 환경에서의 학습도 새로운 것이 아니다: 스타트업 World Labs 실제 장면을 가상 훈련 세계로 변환하는 방법을 보여준 반면, Nvidia의 DreamDojo는 로봇의 동작을 비디오로 시뮬레이션합니다. Google의 접근 방식을 차별화하는 것은 시뮬레이션, 제어 및 평가를 모두 동일한 모델로 처리하려는 야심입니다.
과장 없는 AI 뉴스 – 인간이 큐레이션합니다
광고 없는 읽기, 주간 AI 뉴스레터, 연 6회 제공되는 독점 "AI Radar" 프론티어 리포트, 전체 아카이브 접근, 그리고 댓글 섹션 이용을 위해 THE DECODER를 구독하세요.
출처: 구글