
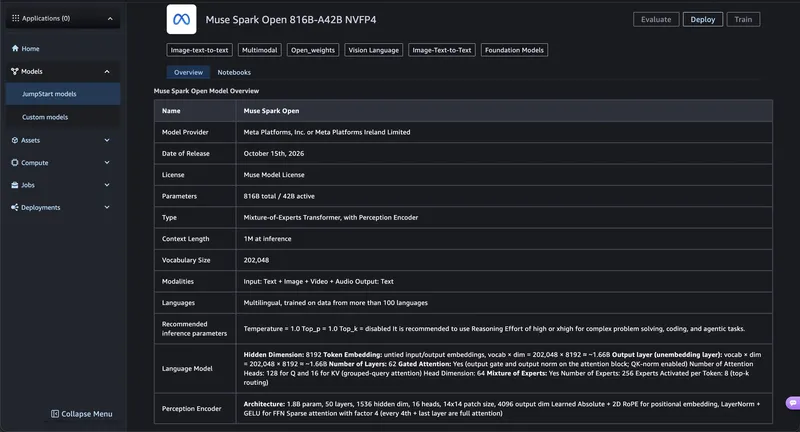
Muse Spark Open, Meta의 코딩에 최적화된 오픈 웨이트 모델이 이제 Amazon SageMaker JumpStart에 출시되었습니다. 이는 Amazon SageMaker AI의 머신 러닝(ML) 허브입니다. 이 모델은 멀티 파일 리팩토링, 긴 디버깅 세션과 같은 실제 개발자 워크플로우로 학습되었으며, 1 million 토큰의 컨텍스트 창을 지원합니다. 몇 단계만 거쳐 서빙 인프라를 직접 관리할 필요 없이 자신의 AWS 계정 내 SageMaker AI 엔드포인트에 배포할 수 있습니다. SageMaker JumpStart는 두 가지 변형을 제공합니다: BF16 (Muse-Spark-Open-816B-A42B) 및 NVFP4 양자화 (Muse-Spark-Open-816B-A42B-NVFP4).
이 게시물에서는 Muse Spark Open을 소개하고, Amazon SageMaker Studio 및 SageMaker Python SDK를 사용하여 모델을 배포하고, 첫 번째 추론 요청을 보내고, 리소스를 정리하는 방법을 보여드립니다.
Muse Spark Open 개요
Meta는 Muse Spark Open을 에이전틱 코딩 워크플로우를 위해 학습된 코딩 최적화 모델로 설명하며, 첫 시도 정확도, 도구 호출(tool calling), 대규모 코드베이스 이해에 중점을 두었습니다. 이 모델은 추론(reasoning) 모델이며, 텍스트, 이미지, 문서, 오디오, 오디오-비디오를 입력으로 받아 텍스트를 반환합니다.
Muse Spark Open은 총 8,160억 개의 파라미터를 갖는 mixture-of-experts(MoE) 아키텍처를 사용하며, 그중 420억 개가 각 토큰에 대해 활성화됩니다. 이 모델은 매우 큰 네트워크의 용량을 유지하면서도, 각 토큰에 소비하는 연산량은 훨씬 작은 dense 모델에 가깝습니다. Meta는 Muse Spark Usage Policy가 포함된 Muse Model License에 따라 가중치를 공개합니다.
다음 표는 이 모델을 요약한 것입니다.
| 속성 | Muse Spark Open |
| 제공자 | Meta |
| 아키텍처 | Mixture of experts (MoE), 추론 모델 |
| 파라미터 | 816B 총, 42B 활성 |
| 컨텍스트 길이 | 1M 토큰 |
| 입력 모달리티 | 텍스트, 이미지, 문서, 오디오, 오디오-비디오 |
| 출력 모달리티 | 텍스트 |
| SageMaker JumpStart의 변형 모델 | BF16 및 NVFP4 |
| 라이선스 | Muse Model License(Muse Spark Usage Policy 포함) |
장시간 실행되는 코딩 에이전트를 위해 설계
Meta는 개발자가 실제 리포지토리에서 작업하는 방식, 즉 코드 생성, 디버깅, 다중 파일 리팩터링, 그리고 오랜 시간 실행되는 작업을 기반으로 Muse Spark Open을 학습시켰습니다. 100만 토큰 컨텍스트 윈도우를 통해 이 모델은 의존성, 레거시 코드, 수천 개의 파일을 포함한 프로젝트 전체를 입력으로 받을 수 있습니다. 컨텍스트에 맞추기 위해 작업을 더 작은 단위로 나눌 필요가 없습니다.
Meta는 또한 Muse Spark Open을 처음부터 에이전틱 모델로 설계했습니다. Meta에 따르면 이 모델은 단일 도구 호출이 아니라 긴 시간 범위에 걸쳐 계획하고, 행동하고, 결과를 관찰하고, 스스로를 수정한다고 합니다. 추론 모델로서 행동하기 전에 작업을 처리하며, SageMaker AI 엔드포인트는 답변과 함께 그 추론 과정을 반환하므로 에이전트가 무엇을, 왜 하고 있는지 따라갈 수 있습니다. Meta는 웹 브라우징, 분할 가능한 작업을 위한 서브에이전트 조율, 데스크톱, 모바일, 브라우저 환경 전반에서의 컴퓨터 운용을 수행하도록 모델을 학습시켰습니다. 이는 모델의 기능입니다. SageMaker AI에서는 모델이 호출하는 도구, 브라우저, 컴퓨터 사용 환경을 애플리케이션 또는 에이전트 프레임워크가 제공합니다. 코드 외에도 Meta는 Muse Spark Open이 이미지, 문서, 오디오, 비디오 전반에서 추론한다고 보고합니다.
모델의 두 가지 특성이 서빙 방식을 결정합니다. 첫째, sparse activation은 토큰당 연산량을 낮게 유지하지만, 서빙에는 여전히 8160억 개의 파라미터 전체를 저장할 수 있는 충분한 GPU 메모리가 필요하므로 인스턴스 선택은 사실상 메모리 용량 문제가 됩니다. 둘째, NVFP4 변형은 NVIDIA의 4비트 부동소수점 형식으로 가중치를 저장하며, 이는 BF16 가중치의 약 4분의 1에 해당하는 메모리만 필요로 합니다. SageMaker AI에서는 이 차이가 인스턴스를 결정합니다. NVFP4 변형은 다음에서 실행됩니다. ml.p5e.48xlarge에서 실행되고, BF16 변형은 ml.p6-b300.48xlarge에서 실행됩니다. 따라서 비용 측면에서 크기를 산정할 때는 NVFP4 변형을 먼저 시도해 볼 만합니다. 자체 워크로드에서 품질이 사용 사례에 적합한지 평가해 보시기 바랍니다.
SageMaker AI에서 오픈 가중치를 사용하면 배포도 직접 제어할 수 있습니다. 엔드포인트는 사용자의 AWS 계정에서 실행되므로 소스 코드와 프롬프트는 사용자가 구성하고 제어하는 인프라에서 처리됩니다. 엔드포인트를 자신의 Amazon Virtual Private Cloud (Amazon VPC)에 연결하고, AWS Key Management Service (AWS KMS)의 키로 스토리지 볼륨을 암호화하며, 컨테이너에 대한 네트워크 격리를 활성화할 수 있습니다. 인스턴스 유형과 조정 한도도 직접 선택하고, 모델 버전을 고정할 수 있으므로 모델은 재배포할 때만 변경됩니다.
사용 사례
Muse Spark Open은 다양한 애플리케이션에 사용할 수 있습니다. Meta가 코딩과 에이전트형 워크플로에 중점을 두었기 때문에 다음과 같은 사용 사례에 적합합니다:
- 프라이빗 리포지토리 대상 코딩 어시스턴트: 전체 프로젝트를 컨텍스트에 두고 대규모 코드베이스에 대해 질문하고, 리팩터링하며, 디버깅할 수 있으며, 코드는 사용자 계정의 엔드포인트에서 처리됩니다.
- 장시간 실행되는 코딩 에이전트: 변경 사항을 계획하고, 여러 파일에 걸쳐 편집하고, 자체 샌드박스에서 테스트를 실행하고, 결과에 따라 방향을 수정하는 에이전트를 실행할 수 있습니다.
- 멀티모달 엔지니어링 워크플로: 스크린샷, 설계 문서, 또는 오디오와 비디오가 포함된 녹화된 버그 보고를 재현 계획이나 수정 초안으로 변환할 수 있습니다.
SageMaker JumpStart 시작하기
SageMaker Studio에서 또는 SageMaker Python SDK를 사용하여 Muse Spark Open을 배포할 수 있습니다. 각 경로는 사용자 계정에 실시간 SageMaker AI 엔드포인트를 생성합니다.
사전 조건
시작하기 전에 다음이 있는지 확인하십시오:
- SageMaker AI 모델 및 엔드포인트를 생성할 수 있는 권한이 있는 AWS 계정.
- SageMaker AI용 실행 역할인 AWS Identity and Access Management (IAM) . 이 워크스루에서는
AmazonSageMakerFullAccess관리형 정책이면 충분합니다. 프로덕션 환경에서는 배포에 필요한 작업과 리소스로 역할 범위를 한정하십시오. 자세한 내용은 SageMaker AI 실행 역할 사용 방법. - SageMaker Studio에 액세스할 수 있는 SageMaker AI 도메인(Studio 경로용). 설정 지침은 Amazon SageMaker AI 빠른 설정 사용.
- 엔드포인트 인스턴스 유형에 대한 서비스 할당량: NVFP4 변형의 경우 엔드포인트 사용을 위한 ml.p5e.48xlarge NVFP4 변형의 경우, 또는 엔드포인트 사용을 위한 ml.p6-b300.48xlarge BF16 변형의 경우입니다. 할당량을 상향하려면 다음을 참조하십시오: 할당량 증가 요청.
- SDK 경로의 경우: Python 3.10 이상 및 SageMaker Python SDK v3 (
pip install --upgrade sagemaker). - SageMaker JumpStart에서 Muse Spark Open을 사용할 수 있는 AWS 리전. 출시 시점에 Muse Spark Open은 미국 동부(버지니아 북부) 및 미국 동부(오하이오)에서 사용할 수 있습니다. 다른 리전에서의 가용성을 확인하려면 해당 리전에서 SageMaker JumpStart를 여십시오.
Muse Spark Open을 호스팅하는 인스턴스는 멀티 GPU 인스턴스이며, 요청 처리 여부와 관계없이 엔드포인트가 실행되는 동안 비용이 청구됩니다. 이 게시물의 정리(clean-up) 섹션에 설명된 대로 작업을 마치면 엔드포인트를 삭제하십시오. 요금은 Amazon SageMaker AI 요금.
SageMaker Studio를 사용한 배포
SageMaker Studio 경로는 첫 평가에 적합합니다. 모델을 찾고, 라이선스를 검토하고, 하나의 모델 상세 카드에서 배포할 수 있습니다.
SageMaker JumpStart에서 Muse Spark Open을 찾으려면
- SageMaker Studio를 엽니다.
- 탐색 창에서 JumpStart.
- 를 선택합니다.
- 검색 상자에 Muse Spark Open을 입력합니다. Muse-Spark-Open-816B-A42B BF16 변형의 경우 또는 Muse-Spark-Open-816B-A42B-NVFP4 Muse-Spark-Open-816B-A42B-NVFP4
그림 1은 모델 설명, 라이선스 및 다음 항목이 나열된 모델 세부 정보 카드를 보여줍니다. 그림 1은 모델 설명, 라이선스 및 Deploy
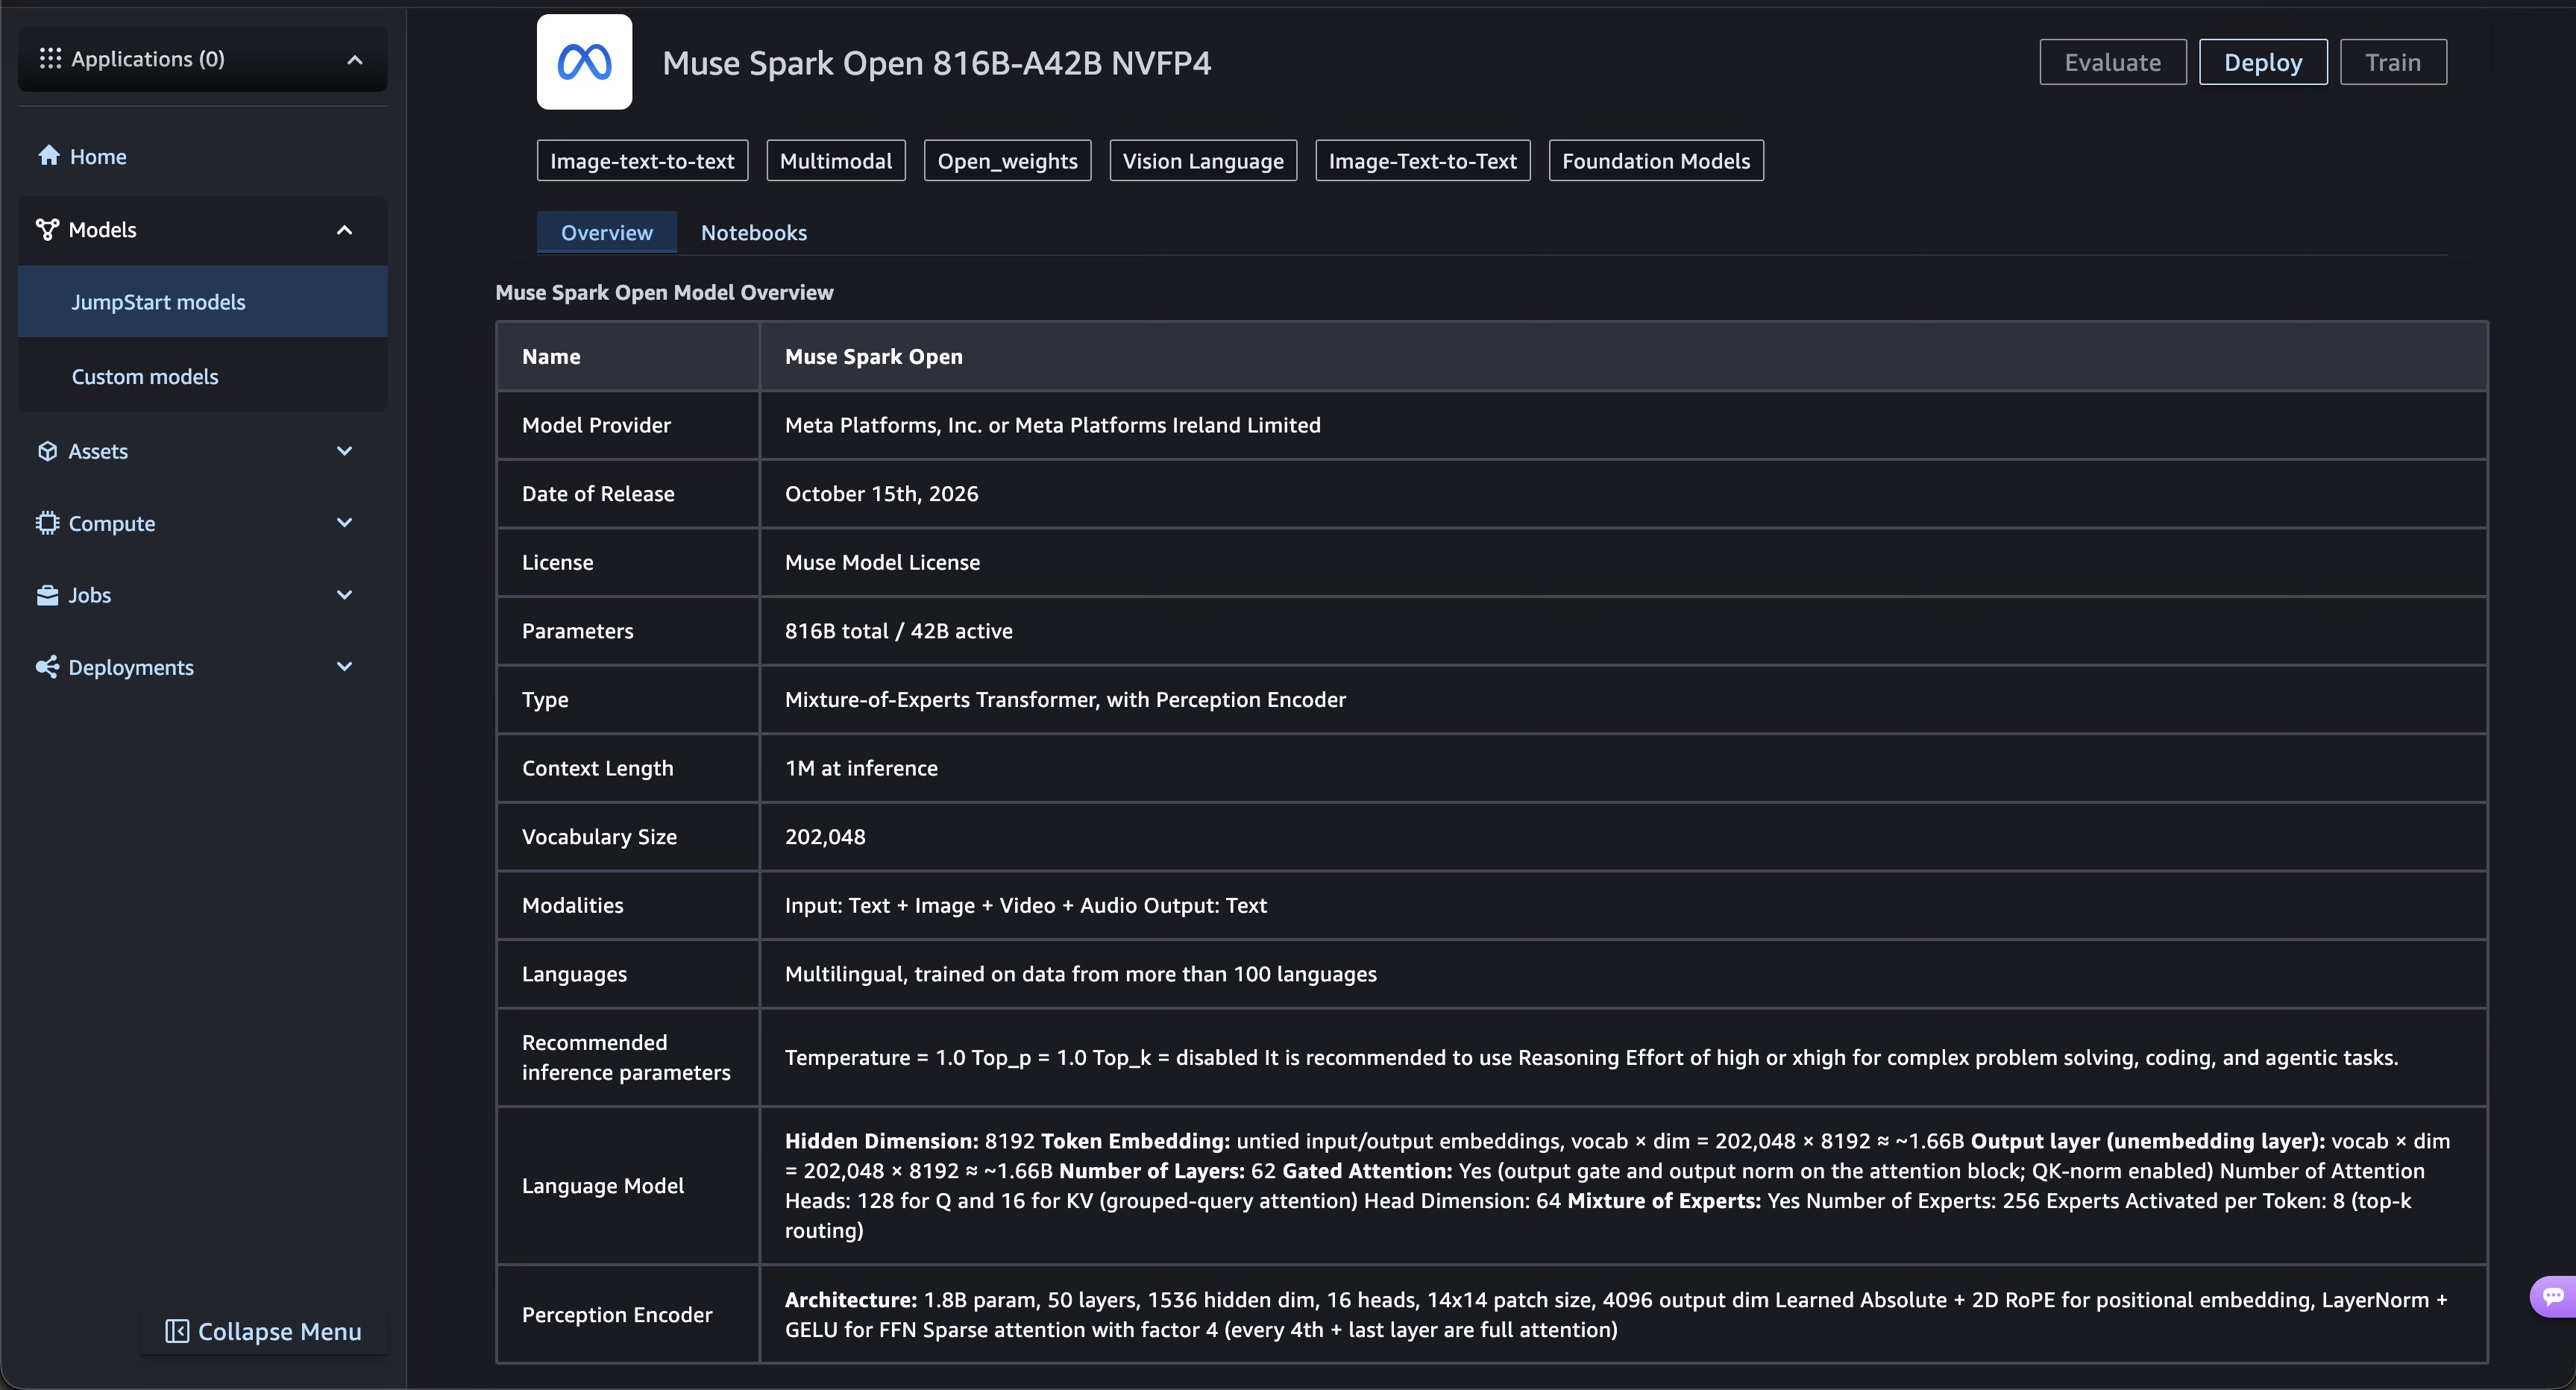
그림 1: SageMaker JumpStart의 Muse Spark Open 모델 세부 정보 카드
그림 1: SageMaker JumpStart의 Muse Spark Open 모델 세부 정보 카드
- 모델을 배포하려면 모델 세부 정보 카드에서.
- Muse Spark Open은 게이트드(gated) 모델이므로 SageMaker Studio에 최종 사용자 라이선스 계약(EULA)이 표시됩니다. 계속 진행하려면 계약 내용을 검토하고 동의합니다.
- 를 선택합니다. Muse Spark Open은 게이트 모델이므로 SageMaker Studio에 최종 사용자 라이선스 계약(EULA)이 표시됩니다. 계약을 검토하고 계속 진행하려면 이를 수락합니다.Endpoint name
- 의 경우 생성된 이름을 유지하거나 직접 입력합니다. Instance type의 경우 NVFP4용으로는 ml.p5e.48xlarge NVFP4용 또는 ml.p6-b300.48xlarge BF16용입니다. SageMaker Studio는 모델이 지원하는 인스턴스 유형만 표시합니다.
- Initial instance count 의 경우 1을 입력합니다., 1을 입력합니다.
- 아래에서 고급 옵션, VPC 및 AWS KMS 키를 선택하거나 네트워크 격리를 켜십시오.
- 선택 배포.
그림 2는 NVFP4 변형의 배포 설정을 보여줍니다.
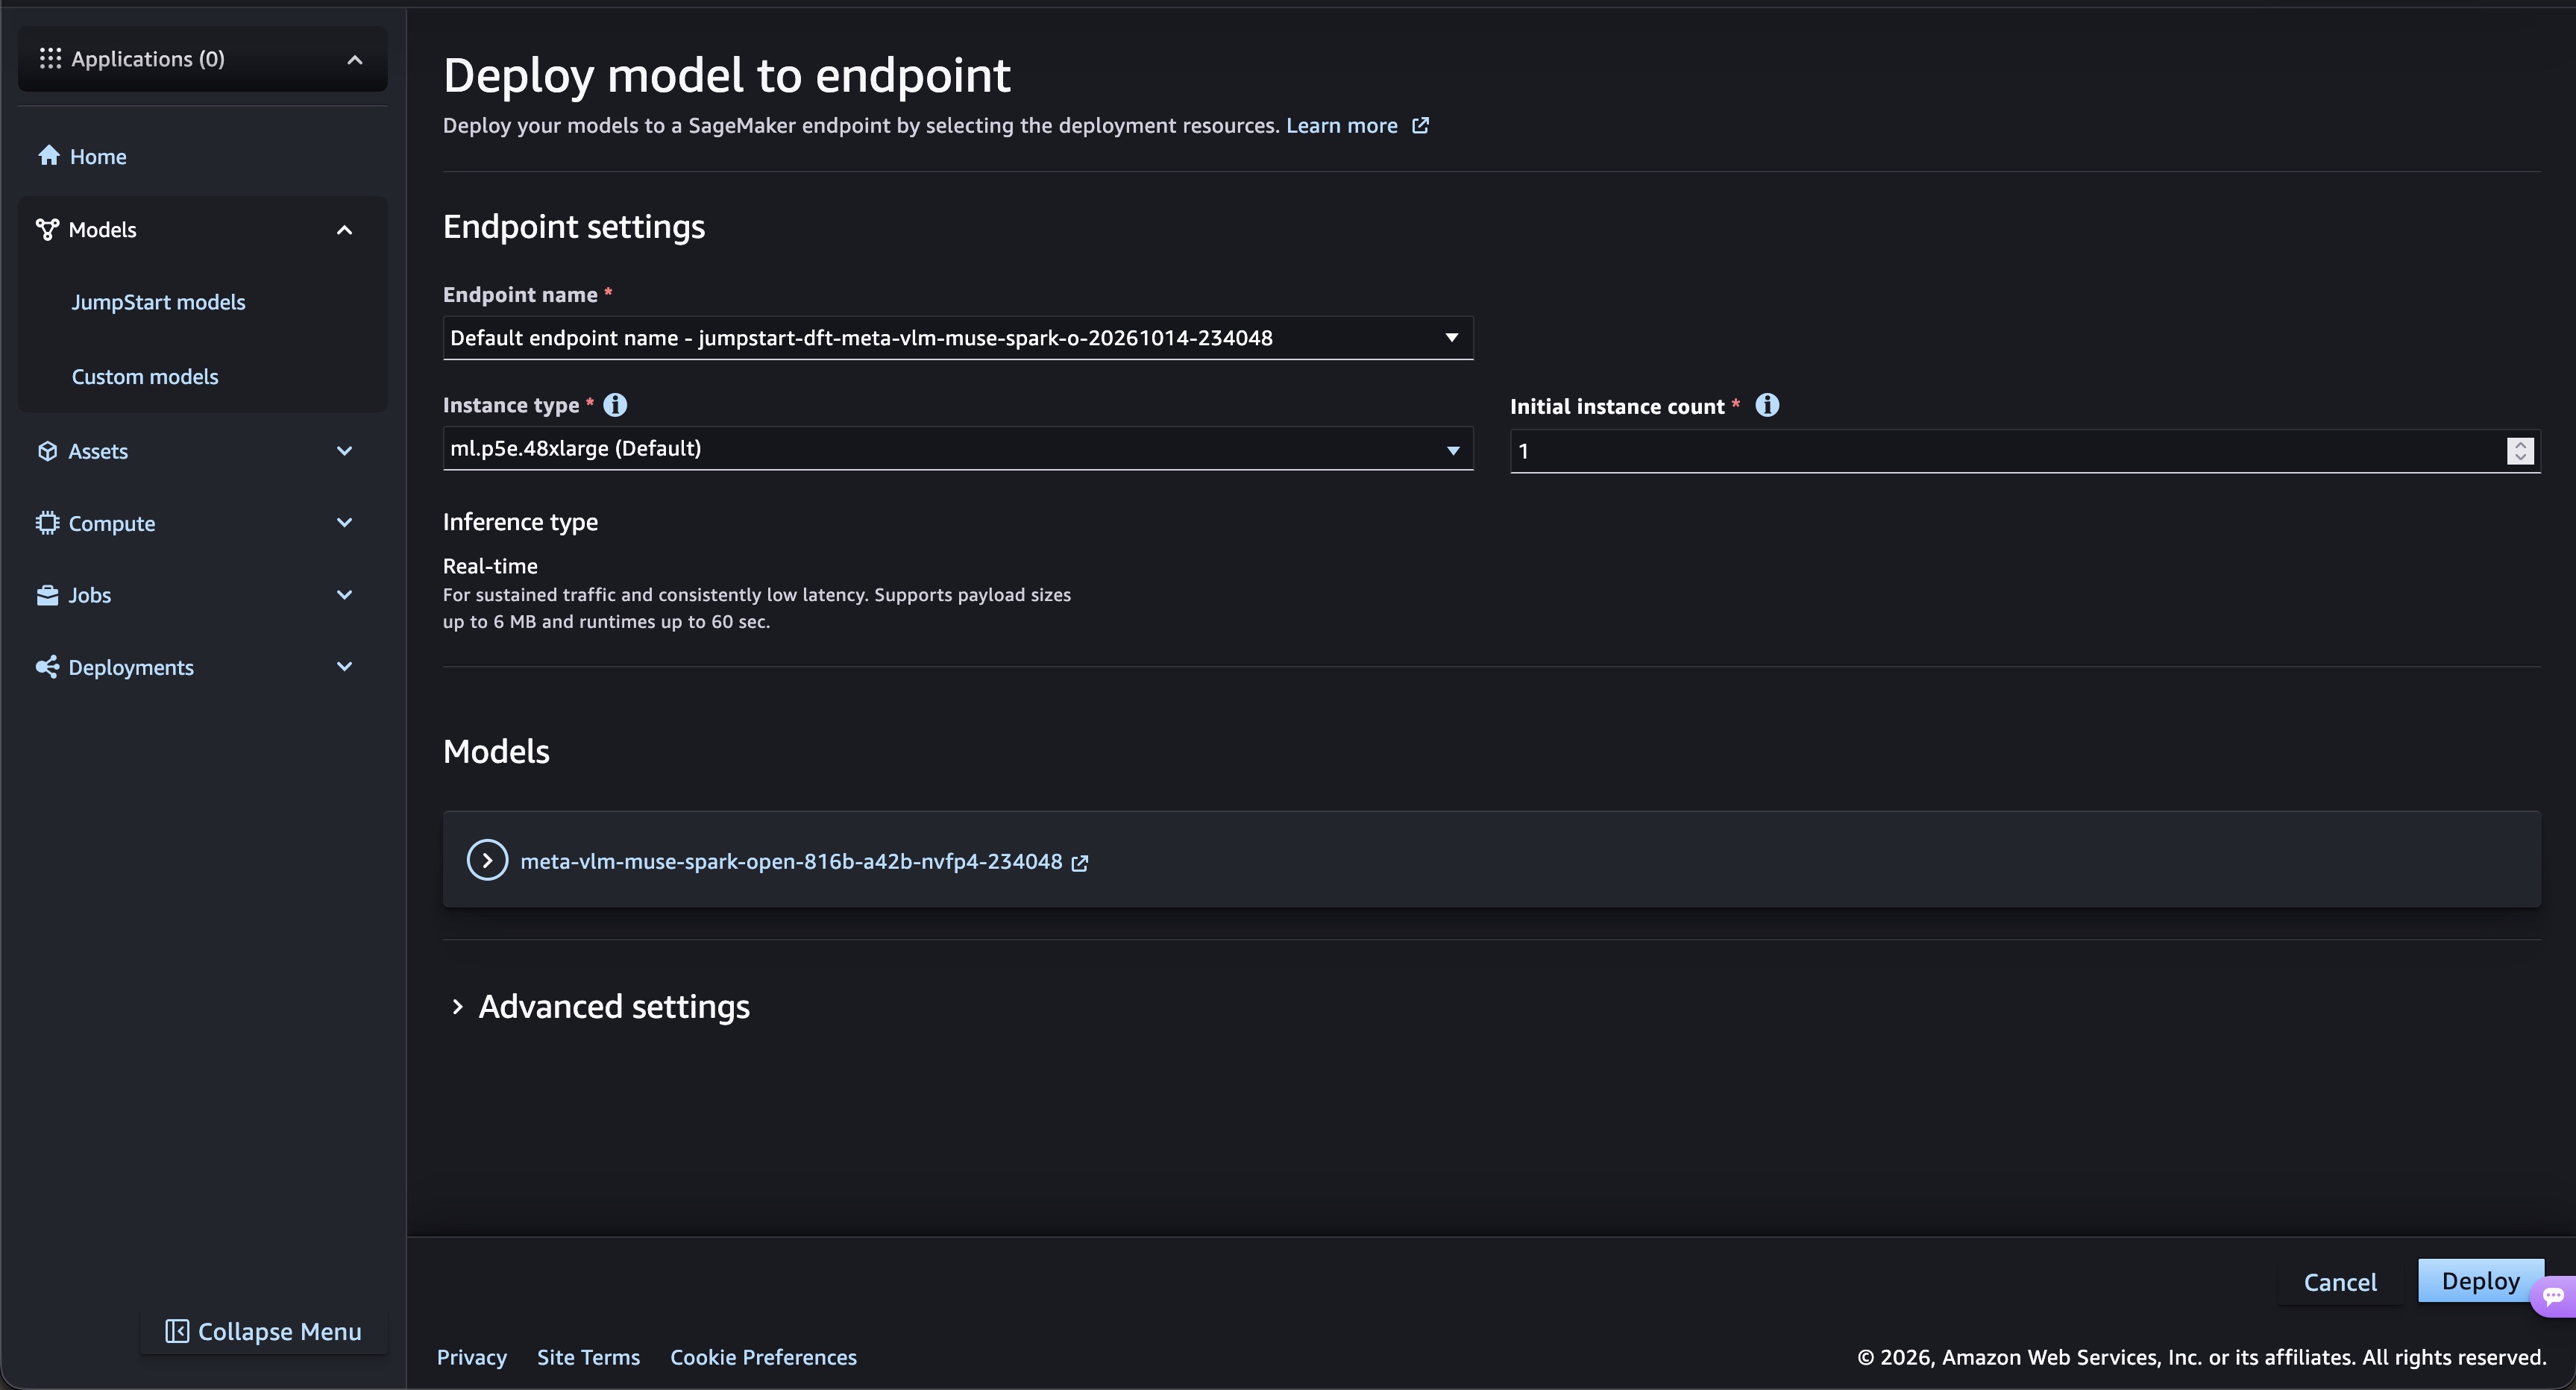
Figure 2: Muse Spark Open의 배포 설정
SageMaker AI가 인스턴스를 프로비저닝하고 가중치를 로드하는 동안 배포는 일반적으로 15–20분 정도 걸립니다. 엔드포인트 상태가 다음으로 변경되면 InService, 엔드포인트는 그림 3에서와 같이 요청을 받을 준비가 된 것입니다.
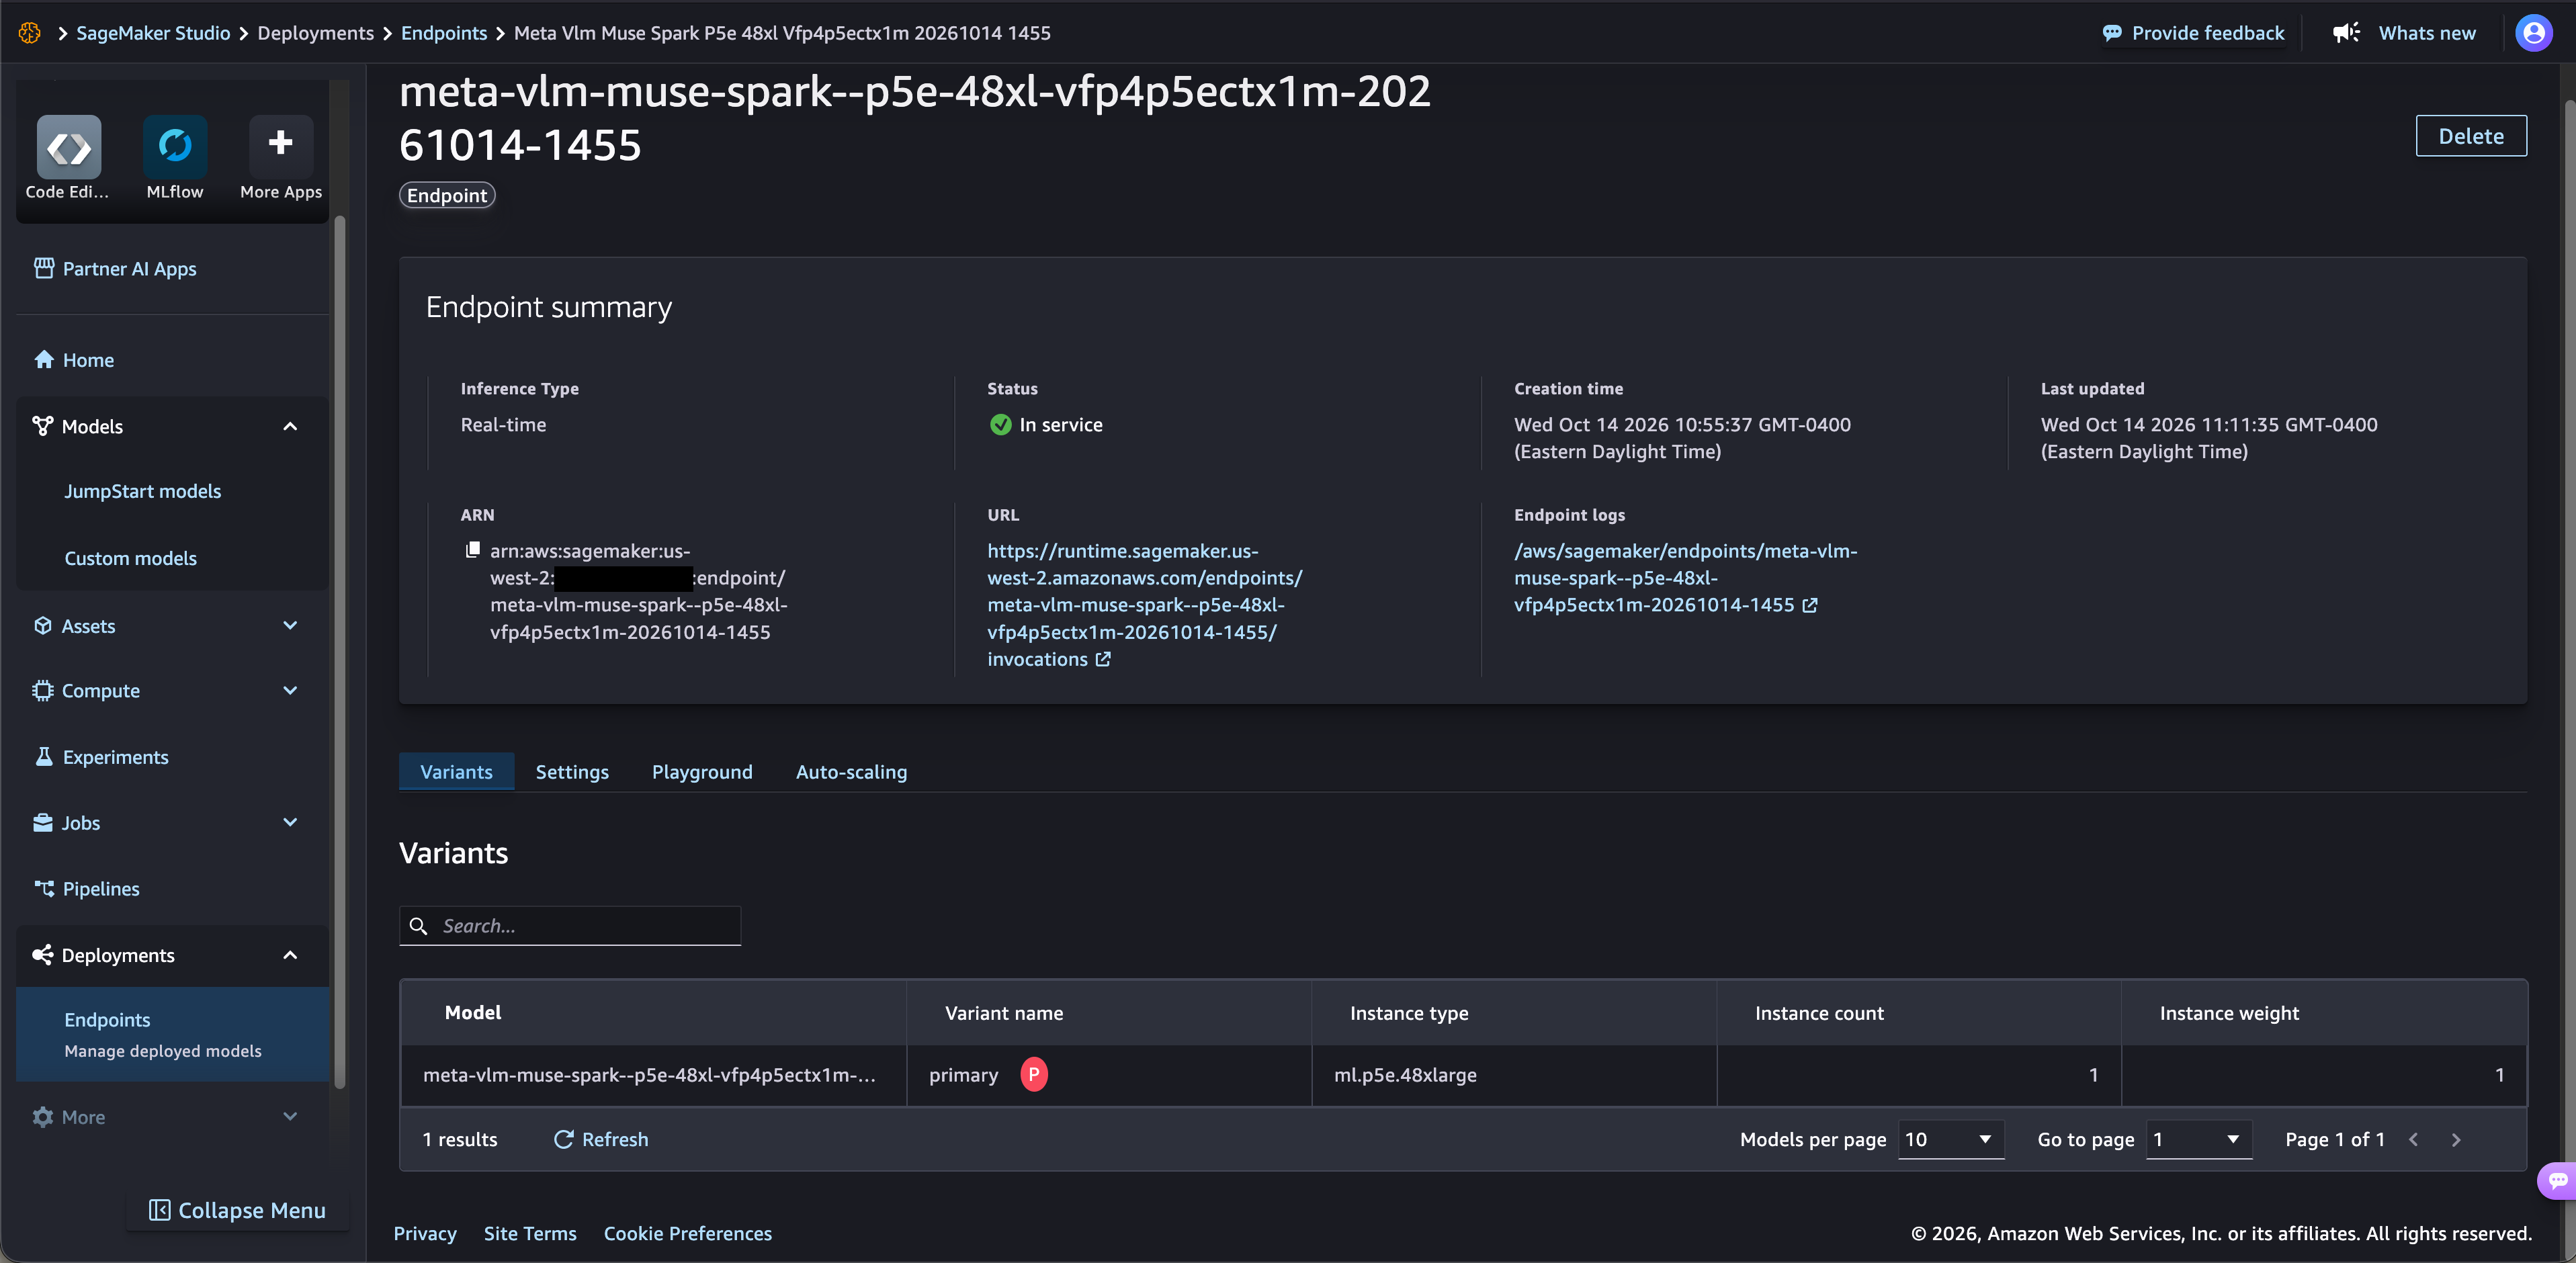
그림 3: 서비스 중인 Muse Spark Open 엔드포인트
SageMaker Python SDK를 사용하여 배포하기
SageMaker JumpStart는 각 변형을 모델 ID로 식별합니다:
- BF16:
meta-vlm-muse-spark-open-816b-a42b. - NVFP4:
meta-vlm-muse-spark-open-816b-a42b-nvfp4.
다음 코드는 SageMaker Python SDK v3로 NVFP4 변형을 배포합니다. 도메인의 실행 역할을 사용하는 SageMaker Studio 노트북에서 실행할 수 있습니다. AWS 자격 증명이 있는 다른 Python 환경에서는 SageMaker AI 실행 역할을 다음과 함께 전달하세요: role_arn 파라미터. Muse Spark Open은 게이트드(gated) 모델이므로 반드시 설정해야 합니다 accept_eula=True (을)를 지정해야 배포할 수 있습니다. 특정 모델 버전을 고정하려면 model_version 을 JumpStartConfig.
from sagemaker.core.jumpstart.configs import JumpStartConfig
from sagemaker.serve import ModelBuilder
from sagemaker.train.configs import Compute

# NVFP4 variant; for BF16, use "meta-vlm-muse-spark-open-816b-a42b" with ml.p6-b300.48xlarge
model_id = "meta-vlm-muse-spark-open-816b-a42b-nvfp4"

jumpstart_config = JumpStartConfig(
    model_id=model_id,
    accept_eula=True,  # Confirms that you accept Meta's license terms
)

model_builder = ModelBuilder.from_jumpstart_config(
    jumpstart_config=jumpstart_config,
    compute=Compute(instance_type="ml.p5e.48xlarge"),
    # role_arn="<your-sagemaker-execution-role-arn>",  # Required outside SageMaker Studio
)

model = model_builder.build(model_name="muse-spark-open-nvfp4")
endpoint = model_builder.deploy(endpoint_name="muse-spark-open-nvfp4")
추론 실행
엔드포인트가 서비스 중일 때 invoke 메서드로 요청을 보내십시오. 엔드포인트는 messages 목록을 포함하는 OpenAI 호환 채팅 페이로드를 받아 채팅 완성(chat completion)을 반환합니다. 최종 답변은 message.content에 있고, 모델의 추론 과정은 message.reasoning_content에 있으며, usage.reasoning_tokens (이)가 추론에 사용된 토큰 수를 보고합니다. Muse Spark Open은 추론 모델이므로 max_tokens 에 추론 과정과 최종 답변을 담을 충분한 공간을 남겨 두십시오.
import json

payload = {
    "messages": [
        {
            "role": "user",
            "content": "Write a Python function that validates ISO 8601 dates, and add pytest unit tests for it.",
        }
    ],
    "max_tokens": 4096,
}

response = endpoint.invoke(
    body=json.dumps(payload),
    content_type="application/json",
)

result = json.loads(response.body.read().decode("utf-8"))
message = result["choices"][0]["message"]
print("Reasoning:", message.get("reasoning_content"))
print("Answer:", message["content"])
엔드포인트는 스트리밍도 지원합니다. 토큰이 생성되는 대로 받으려면 요청 본문에 "stream": true (을)를 추가하고 endpoint.invoke_with_response_stream 대신 invoke.
(을)를 호출하십시오.
요금이 청구되는 것을 막으려면 더 이상 필요하지 않게 되면 엔드포인트를 삭제하세요. SDK를 사용하여 배포한 경우 모델, 엔드포인트, 엔드포인트 구성을 삭제하세요:
from sagemaker.core.resources import EndpointConfig

endpoint_config = EndpointConfig.get(endpoint_config_name=endpoint.endpoint_name)
model.delete()
endpoint.delete()
endpoint_config.delete()
요금이 계속 청구되지 않도록 하려면 더 이상 필요하지 않을 때 엔드포인트를 삭제하십시오. SDK로 배포한 경우 모델, 엔드포인트, 엔드포인트 구성을 삭제하십시오: SageMaker Studio에서 배포한 경우 SageMaker AI 콘솔에서 엔드포인트를 삭제하십시오:(을)를 선택한 다음 엔드포인트, 엔드포인트를 선택하고 작업, 삭제.
결론
이 게시물에서는 Meta의 코딩에 최적화된 오픈 웨이트 모델인 Muse Spark Open을 SageMaker JumpStart에서 여러분의 AWS 계정 내 엔드포인트로 배포하는 방법을 보여드렸습니다. SageMaker Studio 또는 SageMaker Python SDK를 사용하여 모델에 첫 번째 추론 요청을 보냈습니다. 프로덕션용 인스턴스를 선택하기 전에 두 가지 변형을 여러분의 리포지토리에서 벤치마크해 보시기 바랍니다.
시작하려면 SageMaker Studio의 SageMaker JumpStart에서 Muse Spark Open을 검색하십시오. 추론 구성 요소 및 최적화된 배포 구성과 같은 더 많은 배포 옵션은 Amazon SageMaker AI 개발자 안내서의 JumpStart 파운데이션 모델 사용 을 참조하십시오. 배포하기 전에 SageMaker JumpStart가 모델 배포 시 표시하는 Muse Model License를 검토하십시오. 프로덕션 배포 계획에 도움이 필요하면 AWS에 문의.