
주요 특징
- 아키텍처: 총 816B 파라미터, 토큰당 42B 활성화, 1M 컨텍스트 윈도우.
- 양자화: Meta는 BF16과 NVFP4 두 가지로 모델을 공개했습니다. MXFP4 가중치는 AMD가 공개했습니다.
- 멀티모달: Muse Glimmer와 동일한 Perception Encoder를 통한 네이티브 이미지 및 비디오 인식, 추가적인 오디오 지원.
- 병렬화: Nvidia와 AMD 모두에서 텐서 병렬화 및 파이프라인 병렬화. Nvidia에서 EP, TEP, DEP 및 PD 분리(disaggregation). TPU에 대한 초기 지원도 제공됩니다.
- Speculative decoding: CUDA와 ROCm 모두에서 지원되며 SPEED 벤치에서 테스트된, 모델 성능을 가속화하는 DSpark draft 모델을 학습시켰습니다.
사용법
두 벤더 모두 사전 빌드된 이미지가 제공됩니다:
- Nvidia: vllm/vllm-openai:muse-spark-open
- AMD: vllm/vllm-openai-rocm:muse-spark-open
코드(PR #61879)가 리뷰되고 병합된 후에야 모델은 nightly PyPI wheel에서 제공되며, 병합에는 보통 약 일주일이 걸립니다.
# Rust frontend is recommended
export VLLM_USE_RUST_FRONTEND=1

vllm serve meta-models/Muse-Spark-Open-816B-A42B-NVFP4 \
    --tensor-parallel-size 8 \
    --enable-expert-parallel \
    --max-model-len 1048576 \
    --reasoning-parser muse \
    --tool-call-parser muse \
    --enable-auto-tool-choice \
    --speculative-config '{"method":"dspark","model": "Inferact/Muse-Spark-Open-DSpark","num_speculative_tokens":7,"draft_sample_method":"probabilistic","rejection_sample_method":"block","enable_adaptive_verification":true}'
일반 텍스트로 이 모델을 사용하려면:
  curl http://localhost:8000/v1/chat/completions \
    -H 'Content-Type: application/json' \
    -d '{
      "model": "meta-models/Muse-Spark-Open-816B-A42B-NVFP4",
      "messages": [{"role": "user", "content": "Refactor this module."}],
      "reasoning_effort": "xhigh"
    }'
멀티모달 인식의 경우:
 curl http://localhost:8000/v1/chat/completions \
   -H 'Content-Type: application/json' \
   -d '{
     "model": "meta-models/Muse-Spark-Open-816B-A42B",
     "messages": [{"role": "user", "content": [
       {"type": "image_url", "image_url": {"url": "https://example.com/screenshot.png"}},
       {"type": "video_url", "video_url": {"url": "https://example.com/demo.mp4"}},
       {"type": "audio_url", "audio_url": {"url": "https://example.com/clip.wav"}},
       {"type": "text",      "text": "What is happening here, and when?"}
     ]}]
   }'
구현 세부 사항
모델 아키텍처
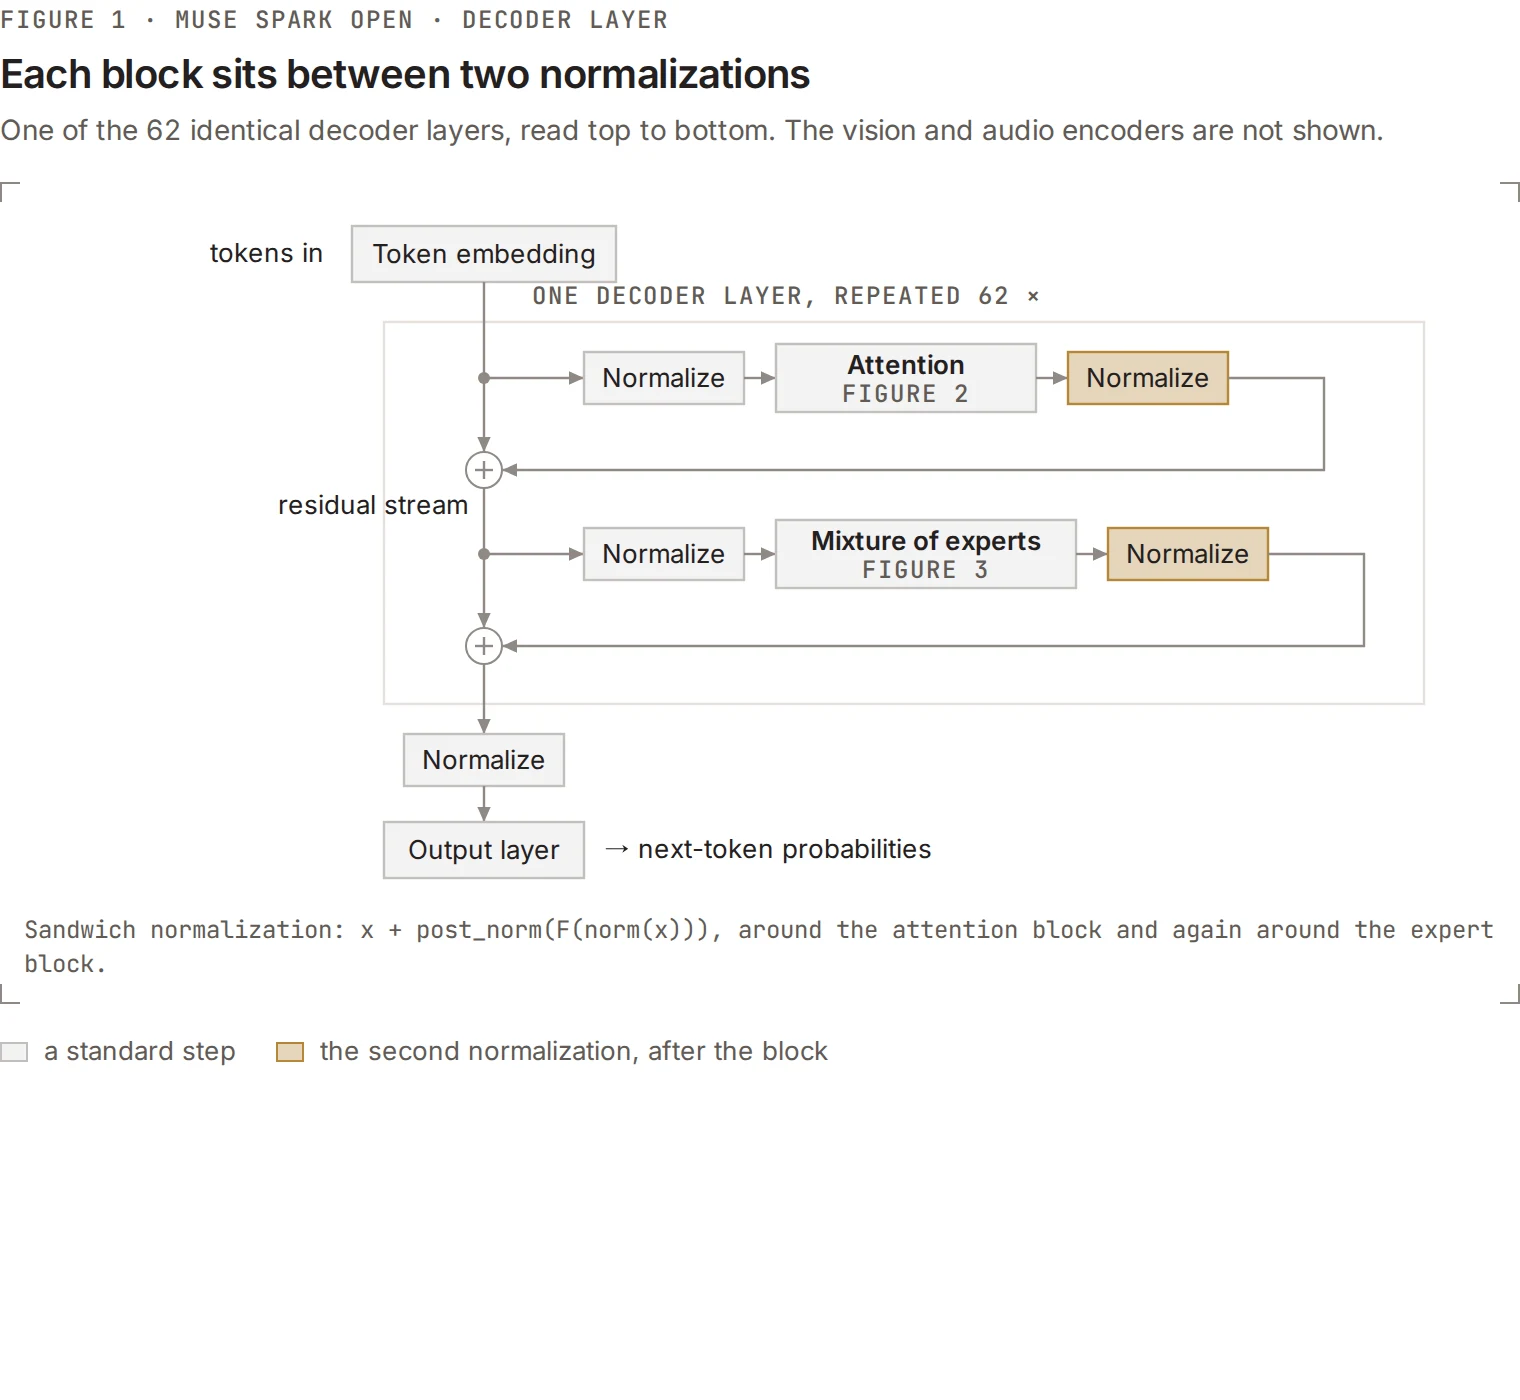
Muse Spark Open은 텍스트 디코더를 포함해 총 816B 파라미터를 가진 전문가 혼합 모델이며, 그 옆에 2B 비전 인코더와 작은 오디오 인코더가 있습니다. 디코더는 62개의 레이어로 구성되어 있으며, 모든 레이어가 전문가 혼합(mixture-of-experts) 레이어입니다. 가중치 구성은 다음과 같습니다:
| 구성 요소 | 크기 |
|---|---|
| 레이어당 256개 전문가 | 799 B |
| 어텐션 | 13.5 B |
| MoE 잠재 프로젝션 | 4.2 B |
| 임베딩 및 출력층 | 3.3 B |
| 비전 타워 (별도) | 1.9 B |
이 모델 아키텍처는 Muse Glimmer와 유사합니다. Muse Glimmer를 사용해 보지 않은 분들을 위해, 이 모델 아키텍처에서 자세히 살펴볼 만한 몇 가지를 소개합니다.
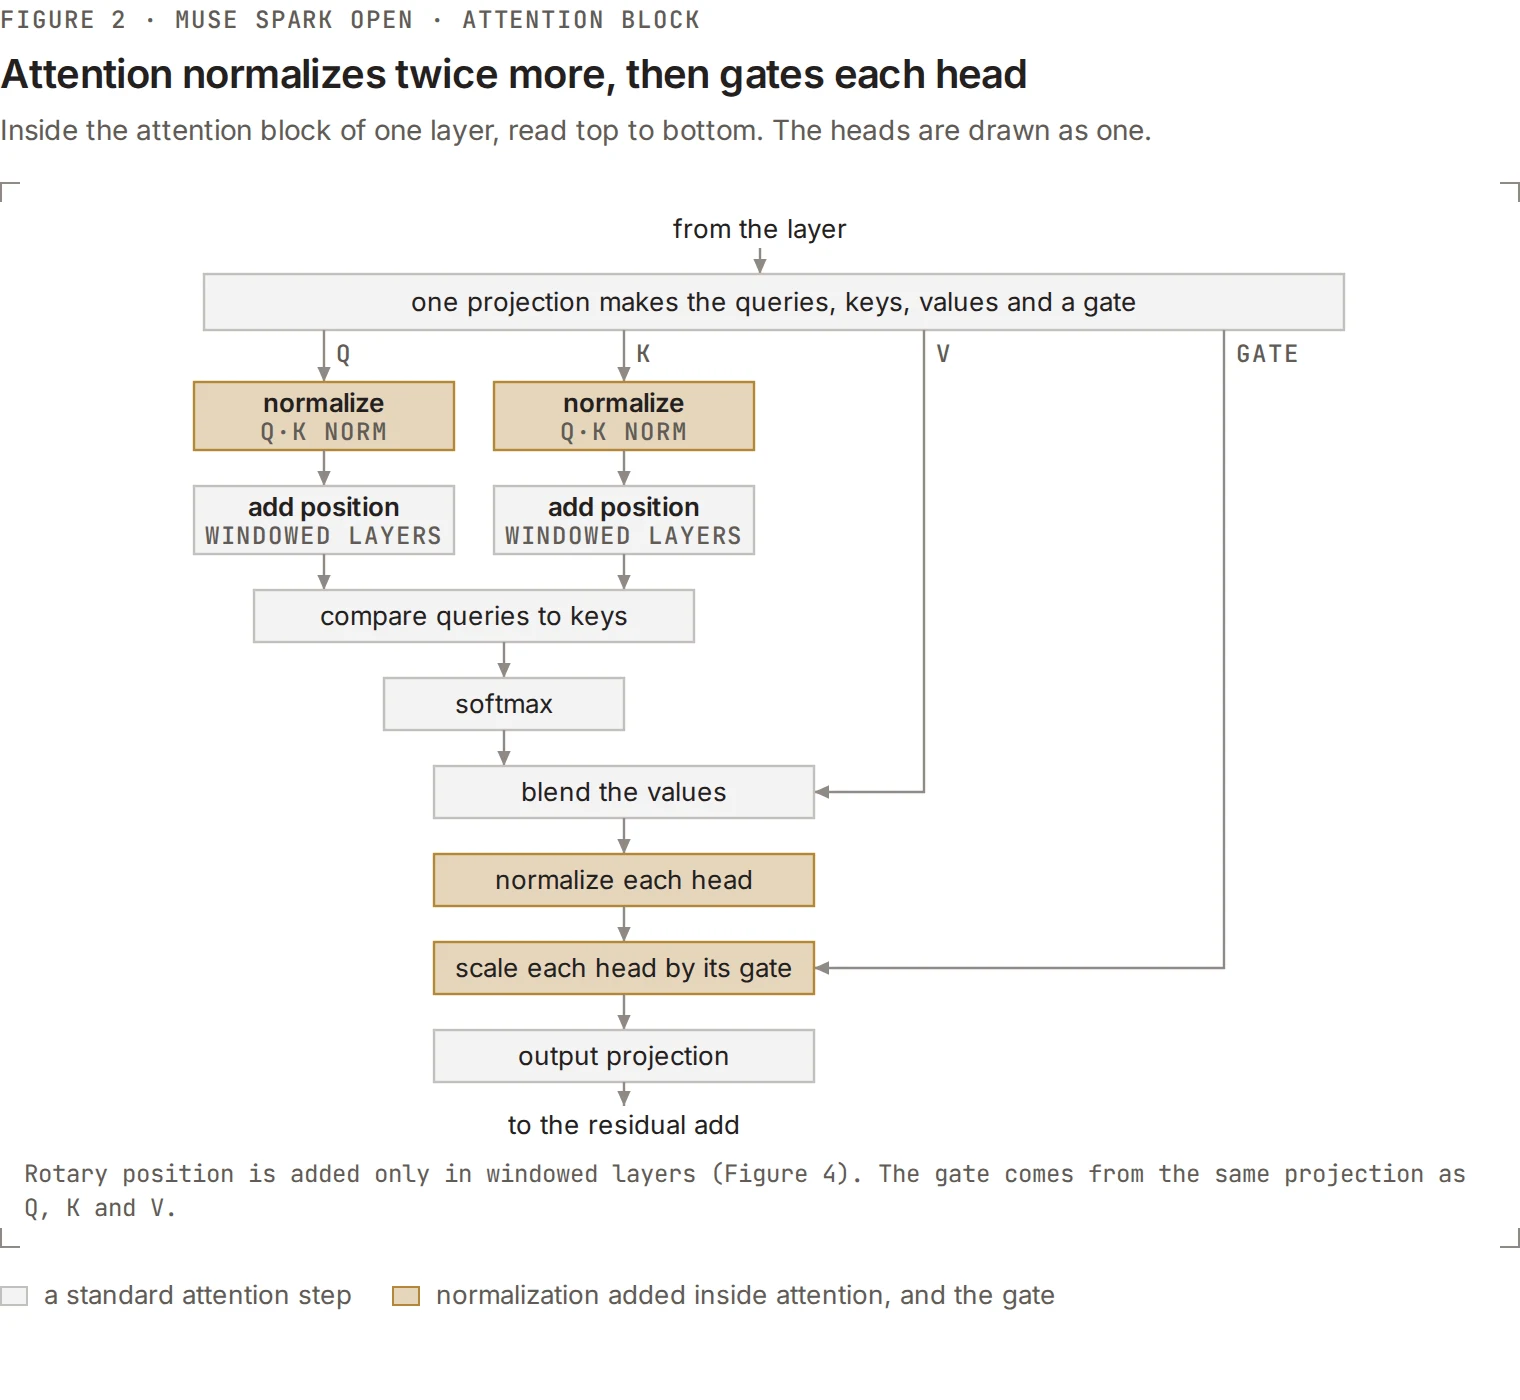
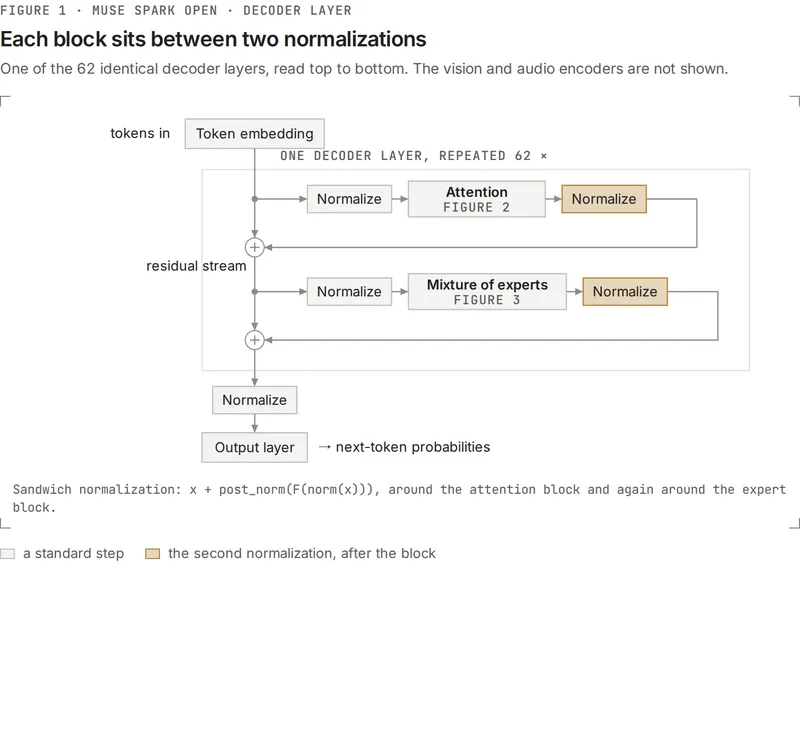
샌드위치 정규화. 대부분의 디코더는 각 블록 앞에 하나의 정규화 레이어를 두어 x + F(norm(x))를 만듭니다. Muse Spark Open은 Muse Glimmer와 마찬가지로 앞과 뒤에 하나씩 배치합니다. 이는 블록이 그 사이에 끼어 있는 샌드위치의 두 빵 조각과 같아서, x + post_norm(F(norm(x)))가 됩니다.
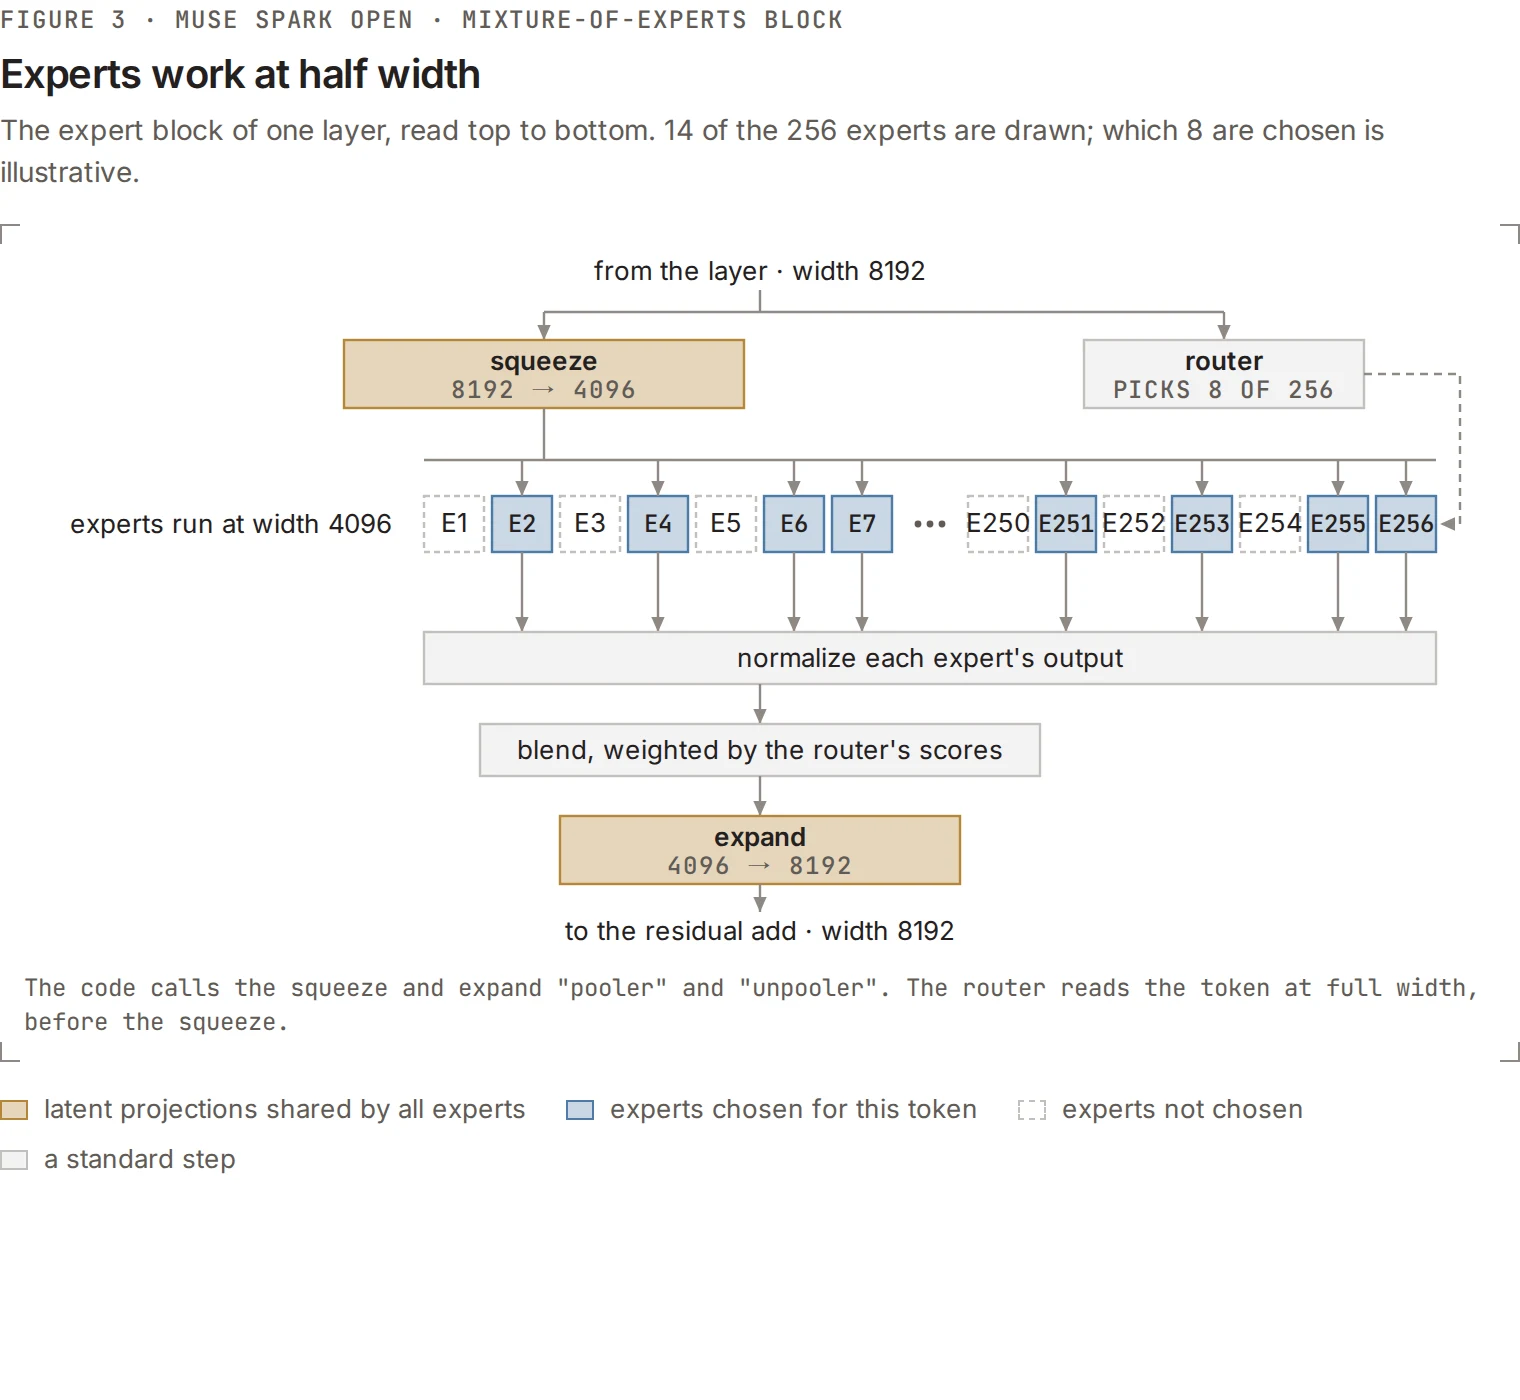
잠재 MoE. 모든 mixture-of-experts(MoE) 레이어는 해당 레이어의 256개 전문가 모두가 공유하는 두 개의 추가 행렬을 가집니다. 코드에서는 이를 풀러(pooler)와 언풀러(unpooler)라고 부르지만, 어느 쪽도 일반적인 의미의 풀링이 아니라, 차원을 압축하고 확장하는 학습된 투영입니다. 풀러는 8192 × 4096 행렬로, 토큰이 전문가에게 도달하기 전에 각 토큰의 폭을 절반으로 줄입니다. 언풀러는 이후 전체 폭을 복원합니다. 따라서 전문가들은 8192가 아닌 전적으로 4096에서 작동하며, 이는 두 전문가 투영 레이어에 필요한 파라미터 수를 사실상 절반으로 줄였습니다.
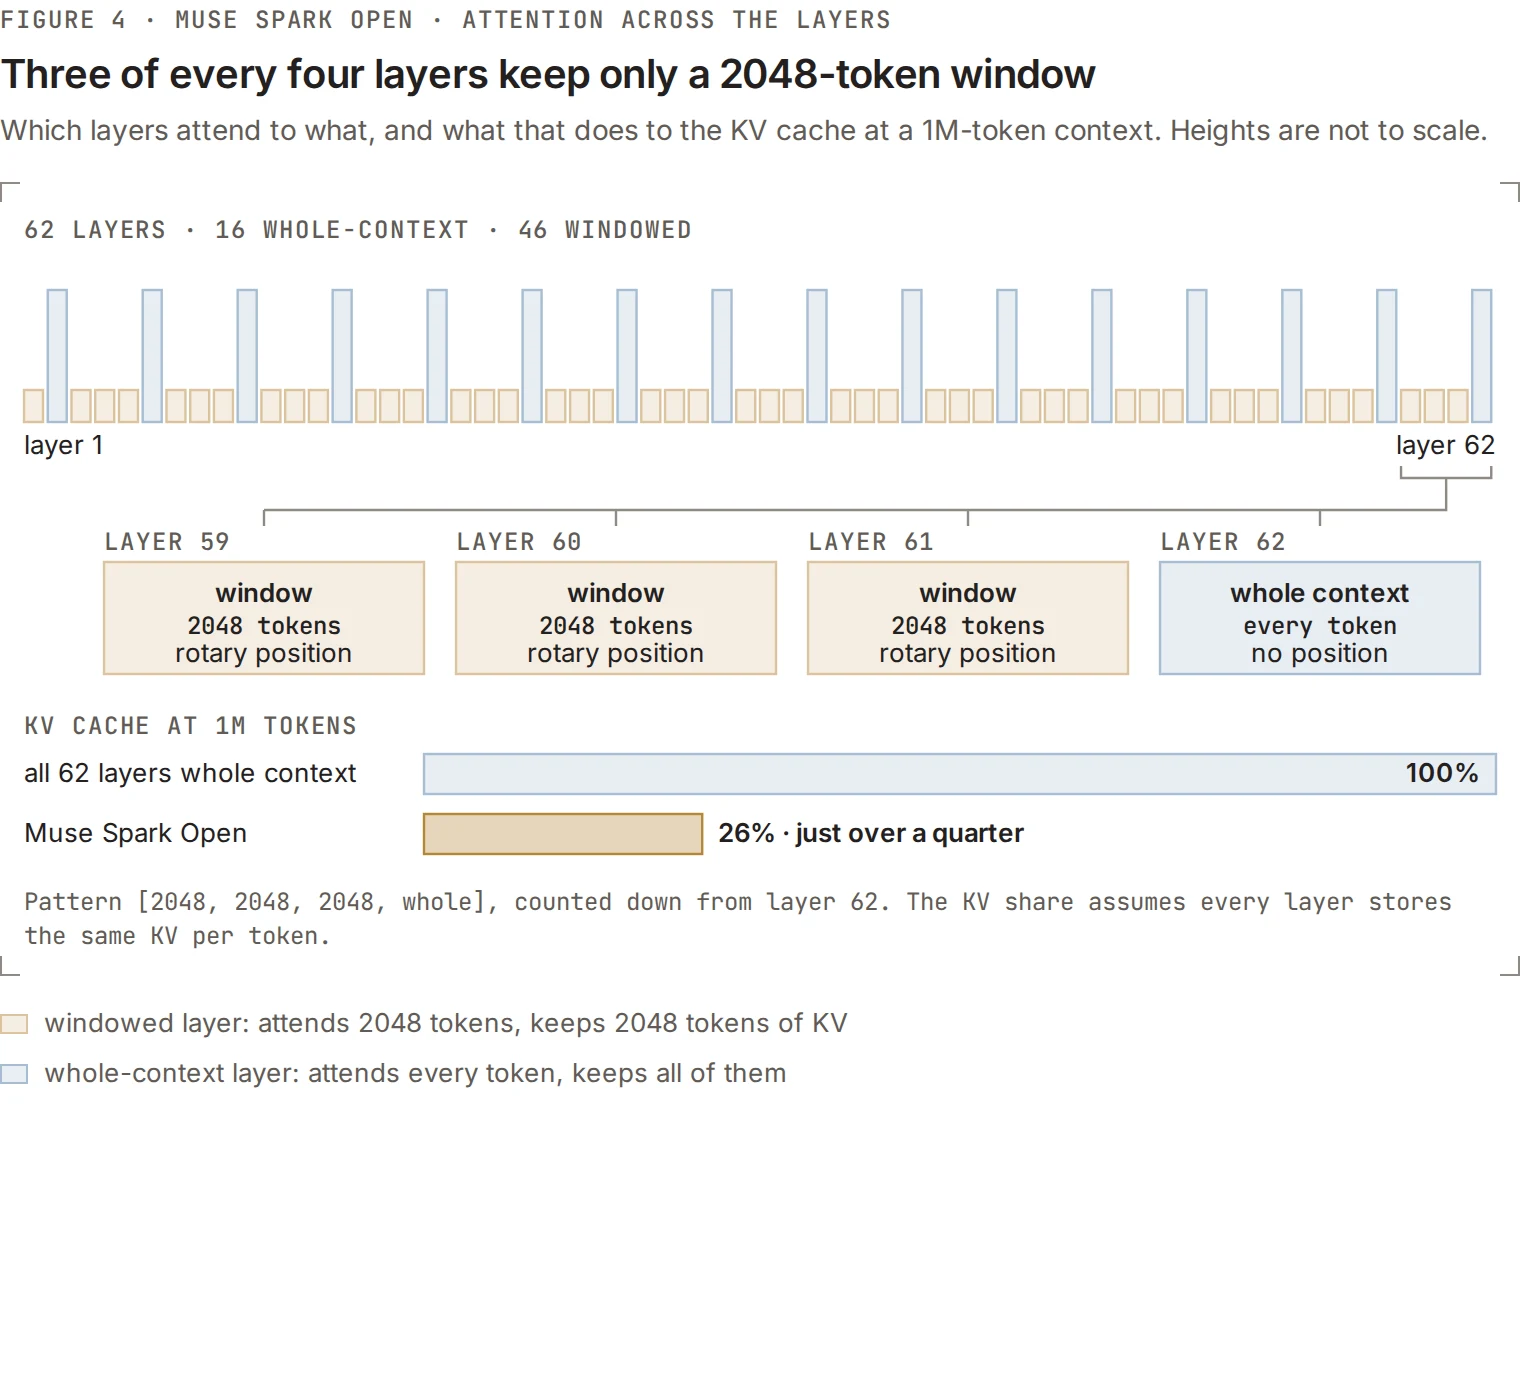
하이브리드 어텐션. 레이어는 4를 주기로 반복하면서 전체 어텐션과 슬라이딩 윈도우 어텐션(SWA)을 번갈아 사용하며, 이 중 3개의 레이어는 2048토큰 윈도우를 보고 네 번째 레이어는 전체 컨텍스트를 봅니다. 이 주기는 스택의 끝에 고정되어 있으므로 마지막 레이어는 항상 전체 어텐션 레이어입니다. 62개 레이어 전체에서 이는 46개의 좁은 레이어와 16개의 넓은 레이어를 의미하며, 좁은 레이어는 최근 KV만 보유합니다. 1M 토큰에서 이는 캐시를 모든 레이어가 전체 어텐션을 사용할 때 필요한 양의 ¼ 조금 넘는 수준으로 만듭니다. 1M 컨텍스트 길이를 저렴하게 만들 수 있는 것은 바로 이 덕분입니다.
비전 인코더. Muse Spark Open은 Muse Glimmer와 동일한 Perception Encoder를 사용합니다. 이는 2B 파라미터 타워로, 이미지를 정사각형으로 크기 조정하지 않고 원본 해상도 그대로 읽어들입니다. 비디오도 동일한 인코더를 통과합니다. 프레임은 로드 시 타임스탬프가 프롬프트에 토큰화된 일련의 샘플링된 비디오 프레임으로 샘플링됩니다.
오디오 인코더. 오디오는 24 kHz의 원시 파형으로 읽히며, 1920 샘플, 즉 80ms마다 일련의 변환을 거쳐 하나의 토큰이 됩니다. 오디오 인코더 전체는 단 118M 파라미터입니다. 단, 비디오의 오디오 트랙은 처리되지 않습니다. 모델에 클립의 그림과 소리를 모두 제공하려면, 동일한 요청에서 두 개의 별도 콘텐츠 부분으로 비디오와 추출된 오디오를 함께 보내십시오.
DSpark
vLLM에서 Muse Spark Open 추론을 가속화하기 위해, 단일 패스에서 최대 7개의 드래프트 토큰을 제안하기 위해 블록 확산을 사용하는 추측 디코딩 알고리즘인 DSpark로 스페큘레이터를 학습시켰습니다. 신뢰도 기반 스케줄링은 아래 결과에서 보듯이, 추측 디코딩이 전통적으로 효과가 감소하는 대규모 배치 크기에서도 상당한 속도 향상을 유지하는 데 도움을 줍니다.
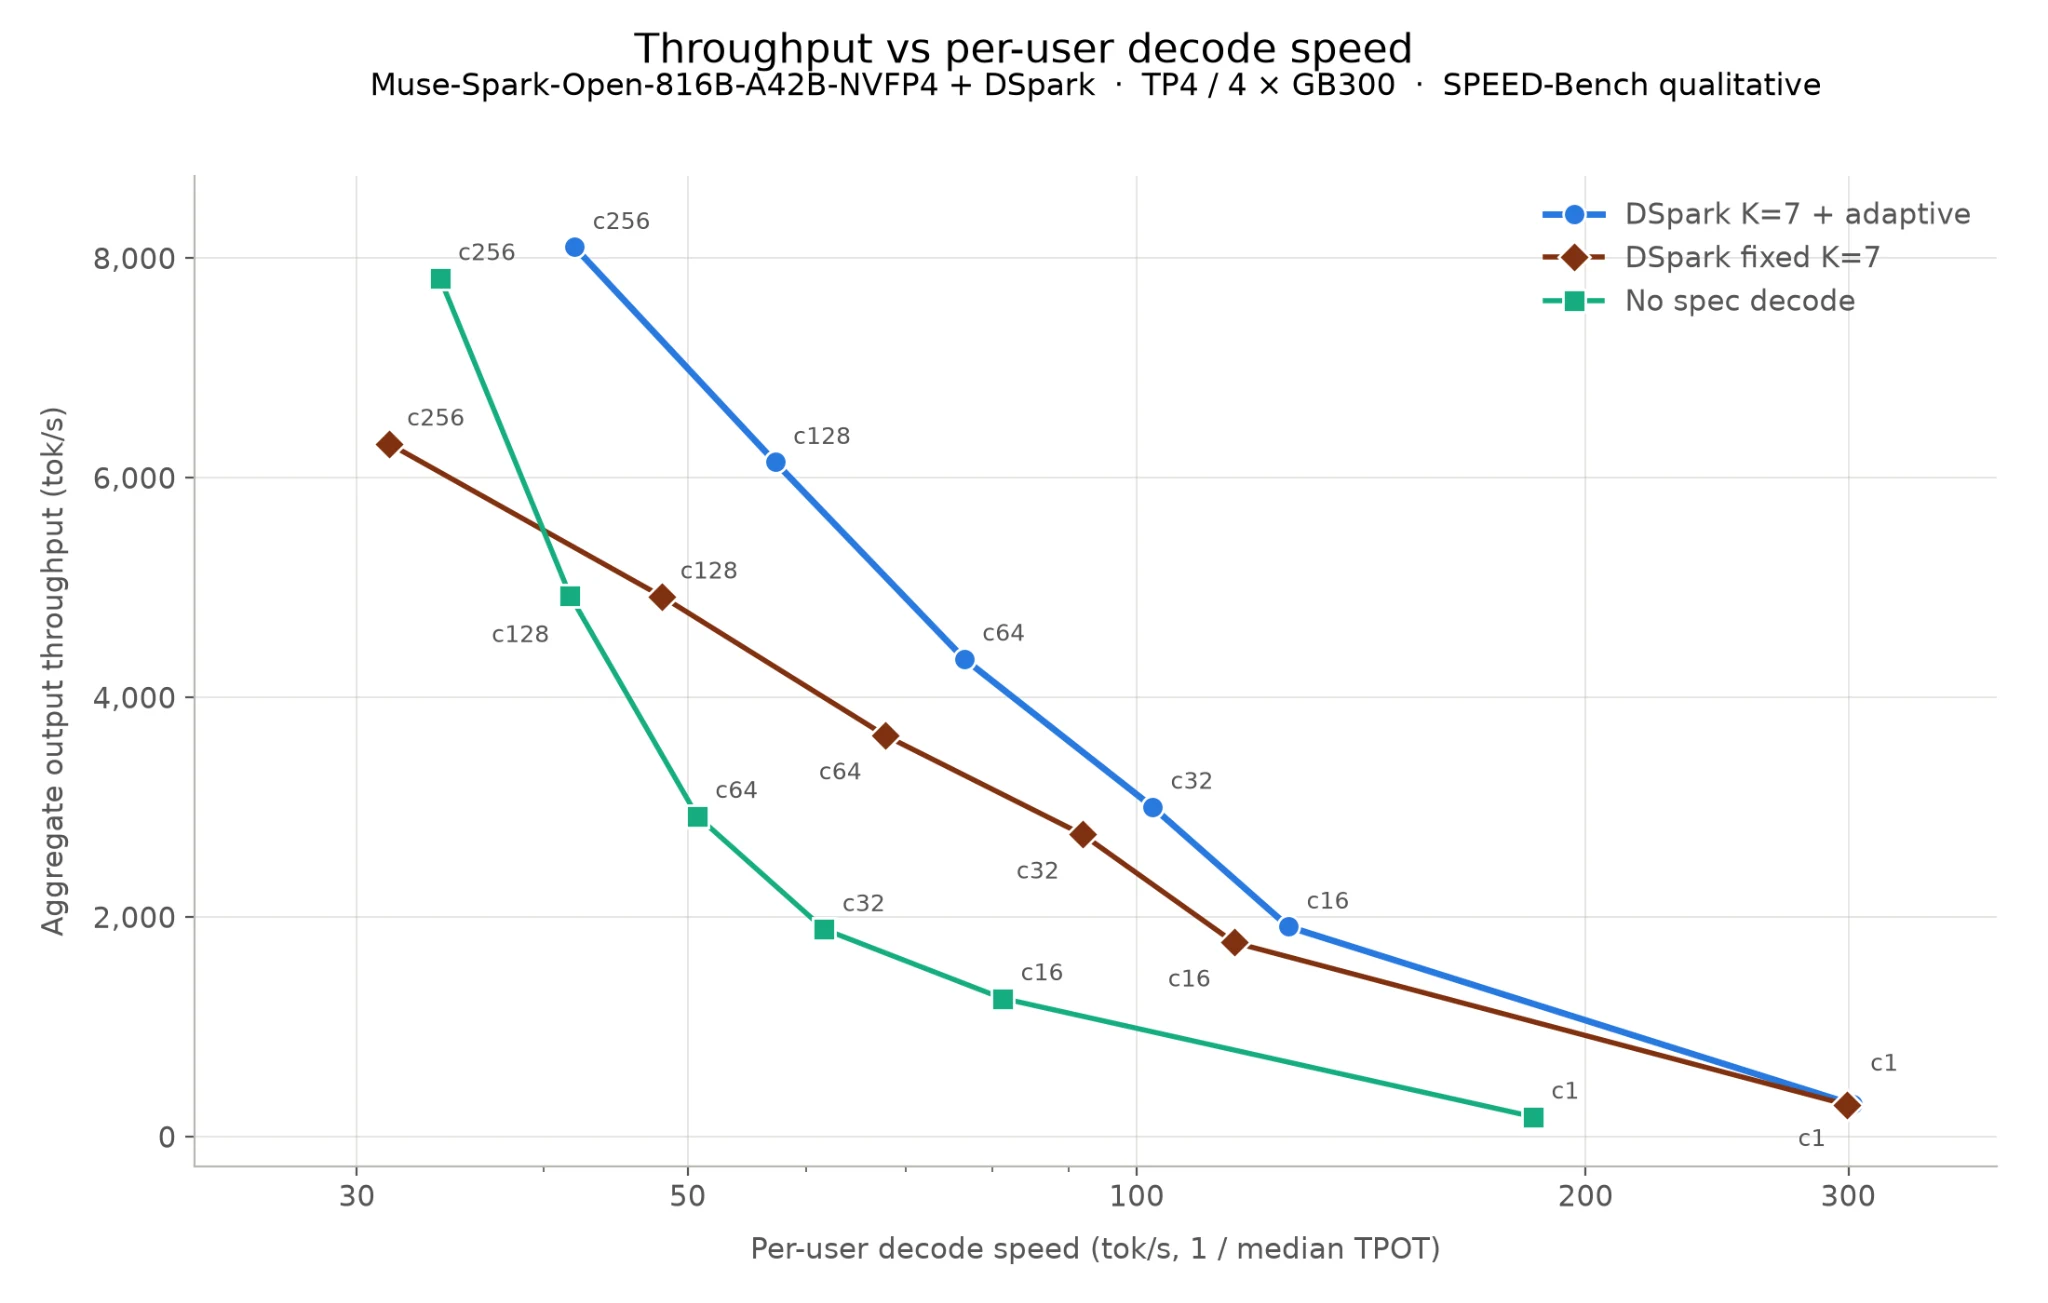
저희 스페큘레이터는 1M토큰 컨텍스트에서도 드래프팅을 가볍게 유지하기 위해 Muse Spark Open의 슬라이딩 윈도우 어텐션을 사용합니다. 이러한 선택들이 함께하여 다양한 배치 크기와 컨텍스트 길이를 아우르는 프로덕션 워크로드에 잘 맞습니다.
이를 활성화하려면 서버 시작 시 다음을 추가하십시오:
--speculative-config '{"method":"dspark","model": "Inferact/Muse-Spark-Open-DSpark","num_speculative_tokens":7,"draft_sample_method":"probabilistic","rejection_sample_method":"block","enable_adaptive_verification":true}'Nvidia
Nvidia 팀은 융합된 정규화, 게이팅 및 잔차 커널, 텐서 병렬 통신 및 RMSNorm이 결합된 융합 MoE 마무리, 새로운 저지연 BF16 GEMM 구현과 감소된 컴파일 오버헤드, 융합 MNNVL 콜렉티브를 갖춘 TEP 풀러/언풀러 샤딩, 정규화의 FP32 출력을 입력받는 TF32 라우터 GEMM, 그리고 데이터 이동, 하드웨어 지원 및 런타임 안정성 개선을 통해 FlashInfer와 vLLM 전반에서 Muse Spark Open 추론을 개선했습니다.
AMD
AMD 팀 덕분에 FP8 및 MXFP4 양자화 형식 모두에서 AMD Instinct™ MI355X GPU로 이 모델을 지원하여 향상된 추론 성능과 배포 효율성을 제공하게 되었습니다. 참고로 ROCm은 현재 텐서 병렬화와 파이프라인 병렬화를 모두 지원합니다.
TPU
TorchTPU 위에서 TPU로 Muse Spark Open 지원을 추가했습니다. 코드 접근은 저희 또는 Google에 문의하십시오. 또한 Muse Spark Open을 위한 megakernels 을 구축했습니다. DSpark 추측 디코딩(수용 길이 = 6)과 함께, 이들은 4 TPU v7 칩에서 650토큰/초 이상, 8칩에서 960토큰/초 이상을 달성합니다. 추측 디코딩 없이도 각각 270토큰/초와 350토큰/초 이상을 제공합니다.
vLLM에서의 강화 학습
vLLM은 0일차부터 Muse Spark Open에서 LoRA RL을 지원하며, Verl FSDP2를 트레이너로 사용하여 롤아웃 엔진 역할을 합니다. vLLM은 그 위에 LoRA 어댑터가 적용된 원본 NVFP4 체크포인트를 서빙합니다. 트레이너는 동일한 가중치의 BF16 역양자화 버전에서 실행되며 어댑터(rank 32, alpha 64)만 업데이트하는데, 이 어댑터는 어텐션, MoE 잠재 투영 및 모든 라우팅된 전문가를 포괄합니다. 또한 트레이너는 롤아웃의 MoE 라우팅(R3)을 재현하며, 각 단계 후에는 어댑터만 vLLM으로 다시 동기화됩니다.
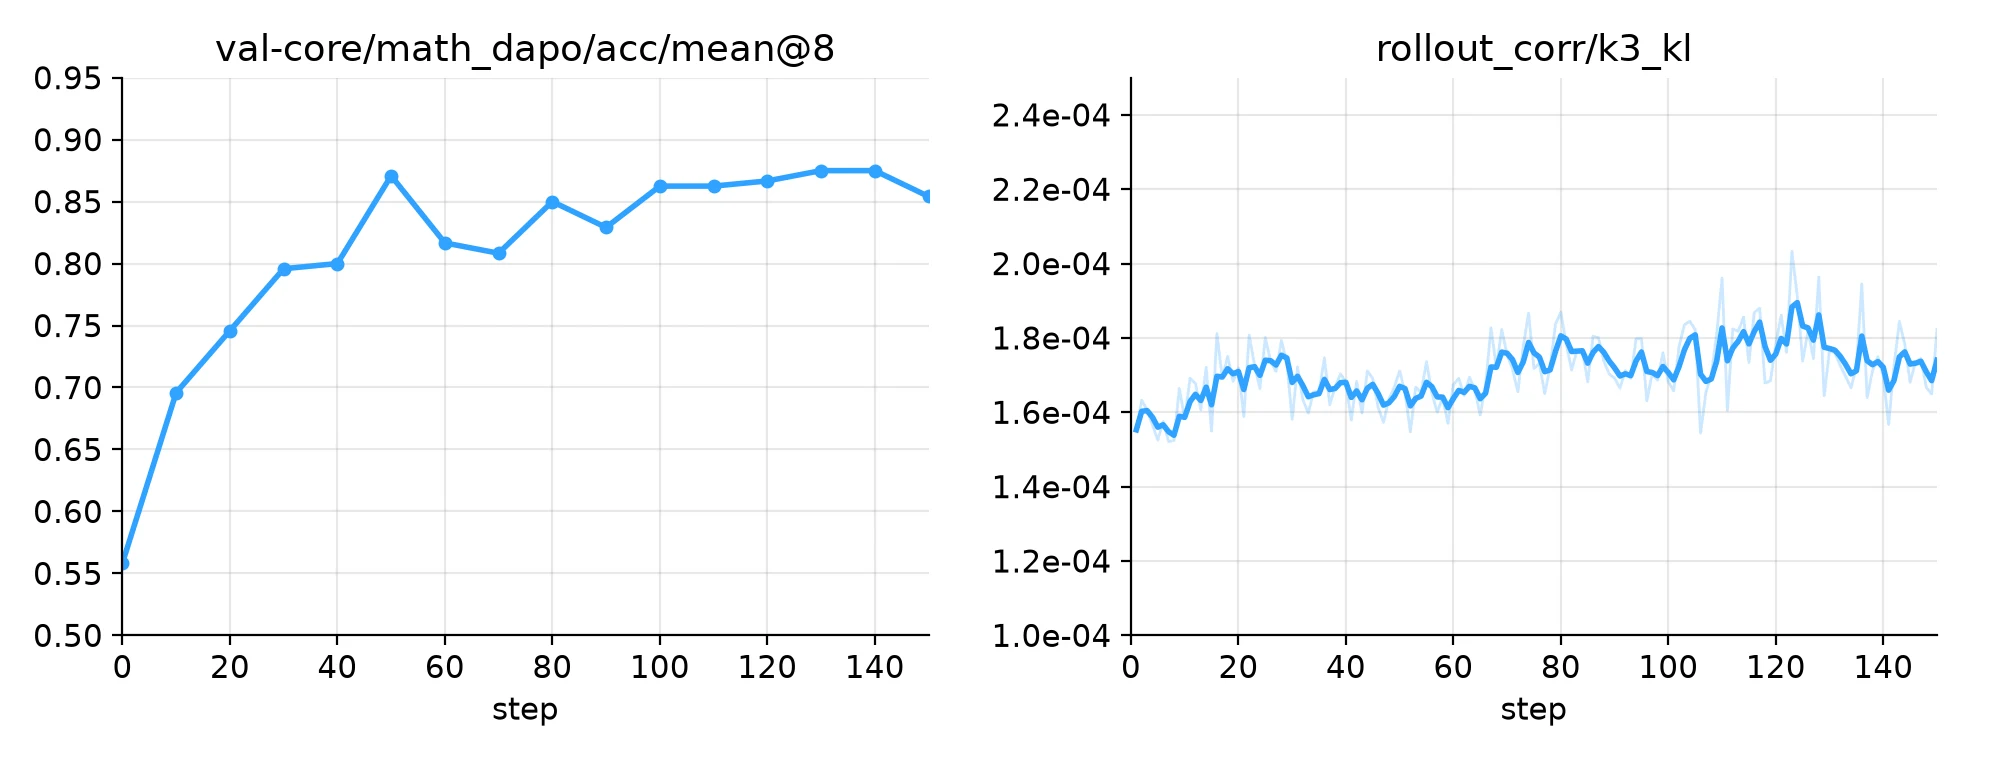
저희는 16 GB300 GPU에서 GRPO로 DAPO-Math-17K에 대해 150단계를 학습했으며, 단계당 32개 프롬프트 각각에 대해 8개 응답을 샘플링하고 응답당 최대 4K 토큰을 사용했습니다. AIME-2024 정확도(mean@8)는 학습 전 0.56에서 학습 종료 시 0.85로 향상되었습니다. 학습 내내 트레이너와 vLLM의 로그 확률 간 k3 KL은 2×10⁻⁴ 부근을 유지했습니다. 자세한 내용은 다음에서 확인할 수 있습니다. https://github.com/verl-project/verl/pull/8257. vLLM 생태계에서 Titan RL 또한 vLLM을 롤아웃 엔진으로 사용하여 day-0 RL 지원을 제공합니다.
감사의 말
Muse Spark Open의 vLLM Day 0 지원을 제공하기 위해 긴밀히 협력해 주신 Meta Superintelligence Labs 팀과 vLLM 커뮤니티에 진심으로 감사드립니다. 또한 DSpark 스페큘레이터 학습과 TPU 통합을 맡은 Inferact, 그리고 중요한 하드웨어 최적화를 제공한 NVIDIA와 AMD에도 감사를 전합니다.
기여자:
- Inferact: Jie Li, Zifeng Mo, Zixi Qi, Jeff Ma, Ziqi Zhao, Dakai An, Ao Shen
- Meta: Beto de Paola, Sidhartha Reddy Potu
- Nvidia: Cyrus Chang, Duncan Moss, Marek Pikulski, Seong Hee Lee
- AMD: Andy Luo, Hongxia Yang, Haichen Zhang