
IT之家 10월 16일 소식, 앤트 바이링은 어제 Ling-3.1-flash 모델의 오픈소스 공개를 발표했다. Ling-3.1-flash는 총 파라미터 약 560B, 토큰당 활성 파라미터 약 25B이며 최대 1M 컨텍스트를 지원한다.
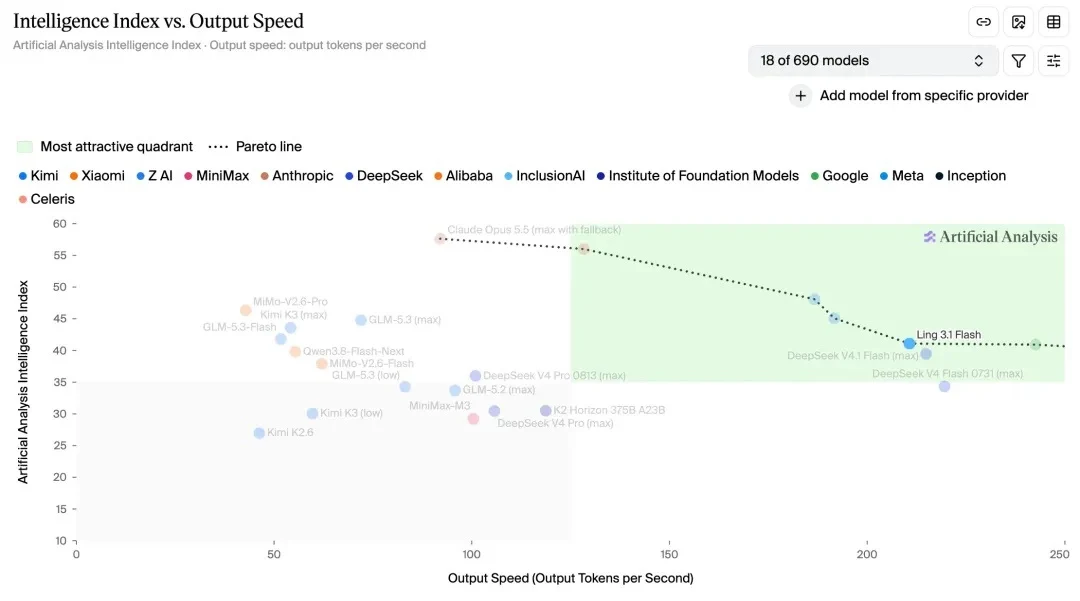
Artificial Analysis의 공개 평가에서 Ling-3.1-flash의 지능 지수는 41, 출력 속도는 초당 약 210 토큰이다.
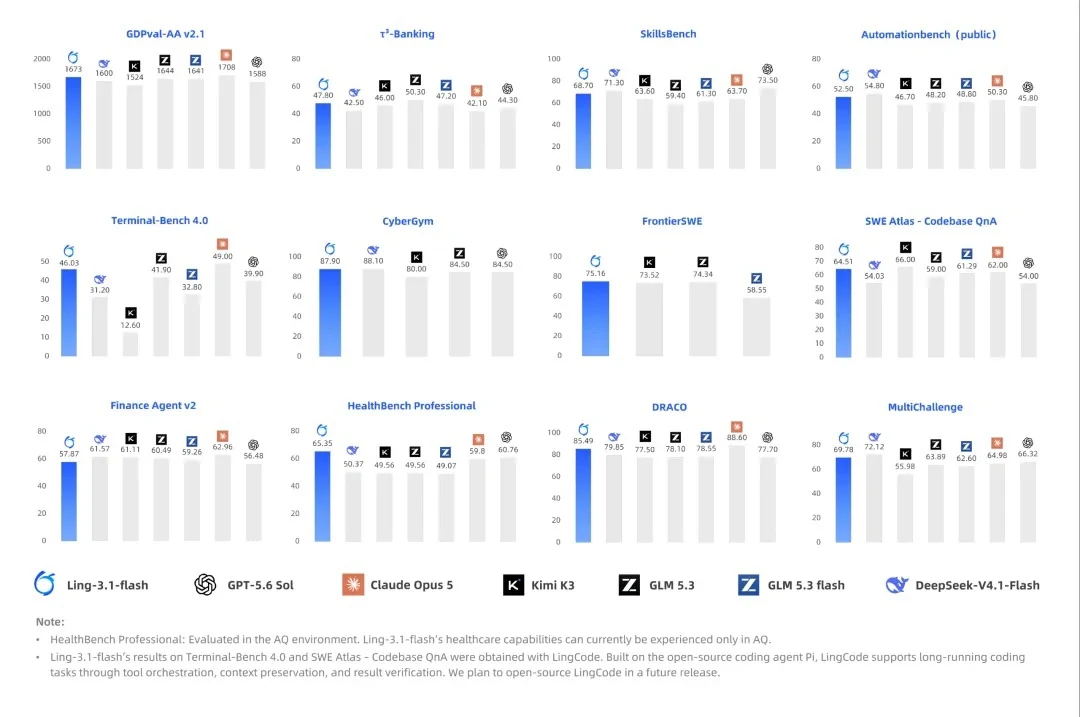
로컬 배포와 관련해 팀은 routed experts에 MXFP4 양자화를 적용하고 dense 레이어는 block-FP8을 유지하여 가중치 점유를 약 534GB에서 292GB로낮췄다. 해당 Hopper GPU 테스트 구성에서 서비스 배포는 8카드에서 4카드로줄어, 서버급 GPU를 보유한 팀이 더 적은 카드 수로 모델을 실행할 수 있게 되었다. 실제 수요는 컨텍스트, 동시성 및 서비스 구성에 따라 달라진다.
긴 자료 처리와 관련해 팀은 긴 컨텍스트 병렬 추론 방안(PCP / DCP)을 제공하며, 도구 호출도 JSON Schema 지원을 강화해 기존 비즈니스 인터페이스와의 연동을 용이하게 했다.
기업 지식 질의응답, 오피스 어시스턴트는 종종 긴 자료를 먼저 읽어야 하며, 사용자는 여전히 빠른 응답을 원한다. 팀은 연산자 융합과 DSpark 투기 디코딩을 통해 추론 오버헤드를 줄였다. 평균 입력 약 25.47K 토큰, 출력 약 224 토큰, 캐시 히트율 76%의 모의 프로덕션 요청에서,8카드 Hopper 구성의 평균 첫 토큰 시간은 604밀리초, 인접 출력 토큰 평균 간격은 3.28밀리초였다. 이는 긴 자료 입력 후 상호작용 응답에 대한 테스트 참고 자료가 된다.
지속적으로 서비스를 제공하는 비즈니스 시스템은 고정된 GPU 예산 내에서 단일 인스턴스가 처리할 수 있는 요청 수를 평가해야 한다. 평균 입력 약 8.5K 토큰, 출력 약 800 토큰의 4카드 Hopper 처리량 테스트에서 모델은 약 1.36 QPS를달성했으며, 동시에 첫 토큰 시간 P50 3초 미만, 인접 출력 토큰 간격 P90 70밀리초 미만이라는 테스트 제약을 충족했다. 이는 자체 배포의 용량 계획에 참고 자료를 제공한다.
온라인 체험과 관련해 Ling-3.1-flash는 현재 한정 기간 2.5할(75% 할인) 혜택을 제공하며, 할인 후 가격은 다음과 같다:
OpenRouter(달러 기준): 입력 0.075달러; 출력 0.225달러; 캐시 읽기 0.015달러.
Ling Studio(위안화 기준): 입력 0.5위안; 출력 1.5위안; 캐시 읽기 0.1위안.
IT之家 오픈소스 링크 첨부:
Hugging Face:https://huggingface.co/inclusionAI/Ling-3.1-flash
ModelScope:https://modelscope.cn/models/inclusionAI/Ling-3.1-flash
관련 기사:
광고 성명: 본문에 포함된 외부 이동 링크(하이퍼링크, QR코드, 구령 등의 형식을 포함하되 이에 국한되지 않음)는 더 많은 정보를 전달하고 선별 시간을 절약하기 위한 것으로, 결과는 참고용이며, IT之家는 외부 링크가 포함된 모든 글에 본 성명을 포함합니다.