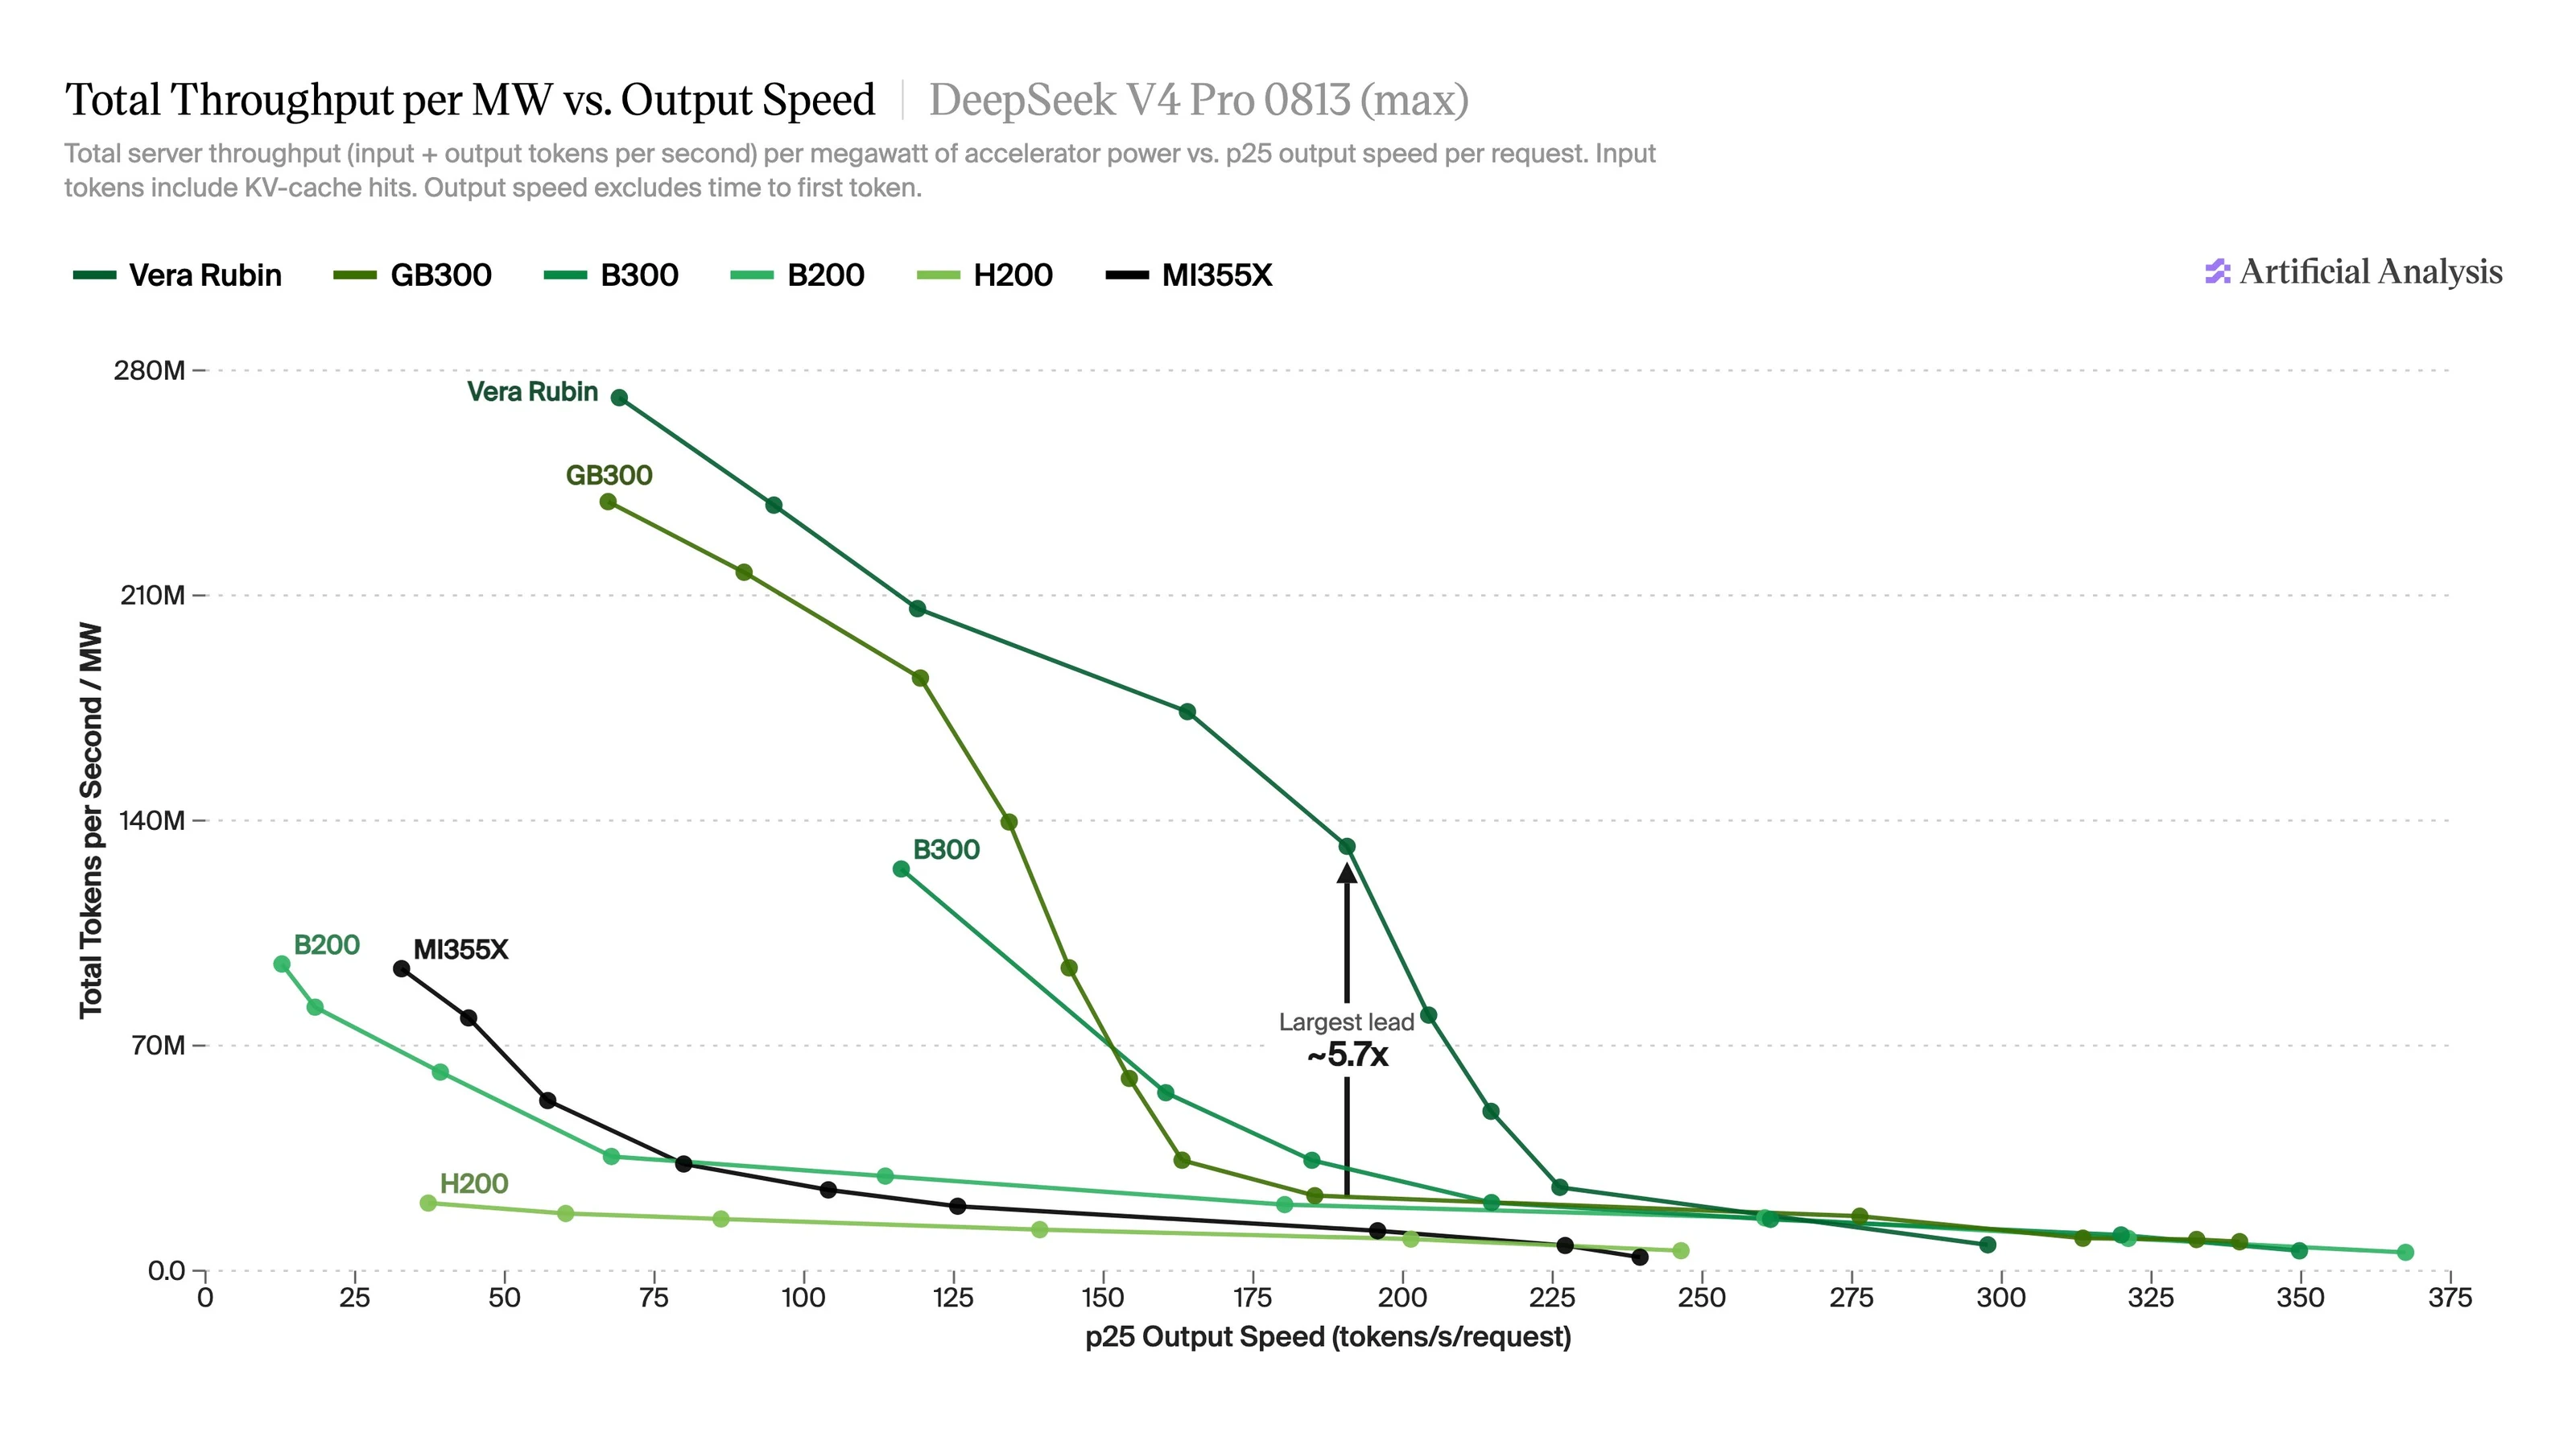
NVIDIA의 Vera Rubin NVL72에 대한 초기 결과가 이제 AA-AgentPerf에서 공개되었으며, DeepSeek V4 Pro에서 이전 모델 GB300 NVL72의 메가와트당 총 처리량의 최대 ~5.7배, DeepSeek V4.1 Flash에서는 ~5.4배, GLM-5.2에서는 ~3.0배, Kimi K3에서는 ~2.8배입니다.
베라 루빈은 NVIDIA의 블랙웰의 후계자이며, 베라 루빈 NVL72는 72개의 루빈 GPU와 36개의 베라 CPU를 갖춘 랙 규모 시스템입니다. 각 루빈 GPU는 블랙웰 울트라와 동일한 288GB의 메모리를 사용하지만, 메모리 대역폭은 2.4배, NVLink 대역폭은 1.7배, 그리고 밀도 높은 NVFP4 계산 능력은 2.3배입니다. NVIDIA는 모든 베라 루빈 결과를 제출했으며, TensorRT-LLM 및 vLLM을 NVIDIA Dynamo로 실행합니다.
AA-AgentPerf는 우리의 에이전트 기반 추론 성능 벤치마크입니다. 긴 캐시된 컨텍스트와 도구 호출 지연을 포함한 실제 에이전트 코딩 세션을 재생하여, 일상적인 에이전트 작업에서의 추론 성능을 현실적으로 측정합니다. 우리는 측정된 GPU 전력당 총 시스템 처리량과, 다양한 동시성 수준에서 각 에이전트의 출력 속도(p25 across requests)를 측정하여 시스템 활용도와 개별 사용자 경험 간의 트레이드오프를 보여줍니다.
초기 결과:
➤ Vera Rubin의 리드는 사용자당 속도가 더 빠를 때 가장 크지만, GB300의 처리량은 떨어진다. DeepSeek V4 Pro에서는 사용자당 ~120 토크/초에서 ~165 토크/초로 증가할 때 GB300은 MW당 처리량의 81%를 소비하는 반면, Vera Rubin은 16%만 소비한다.
➤ 최대 처리량에서 두 시스템은 더 가까워지며, DeepSeek V4 Pro에서는 Vera Rubin이 MW당 272M 토큰/초이고 GB300은 239M(1.14배), DeepSeek V4.1 Flash에서는 571M 대비 395M(1.45배), GLM-5.2에서는 272M 대비 201M(1.35배), Kimi K3에서는 70M 대비 56M(1.26배)입니다. Vera Rubin 커널과 다른 서버 소프트웨어가 최적화됨에 따라 두 시스템 간의 격차는 더욱 커질 것으로 예상됩니다.
➤ 베라 루빈은 우리 리더보드에서 DeepSeek V4.1 Flash(906 토크/초, 모든 모델 중 가장 빠른 결과), GLM-5.2(408 토크/초) 및 Kimi K3(255 토크/초)의 사용자당 최고 속도를 설정했습니다.
@nvidia의 뛰어난 성과에 축하드립니다!
전체 분석을 읽으세요: https://artificialanalysis.ai/articles/vera-rubin-nvl72-agentperf