
키미 K3 최적화 작업 내부에서: 병목 현상과 추론을 더 빠르게 만드는 결정 사항을 이해하는 것
이 글에서- AgentX: 작업량과 결과
- 킴i K3 내부: 전문가, 주의력 및 재발성 상태
- 1. 캐시: 대화 상태를 재사용 가능하게 유지
- 2. MoE: GPU들 간의 중복 작업 제거
- 3. 메모리 트래픽: 파이프라인 작업 수행 및 불필요한 복사본 제거
- 4. MLA: AMD AITER 어셈블리를 활용한 긴 컨텍스트 디코딩의 가속화
- 5. KDA: 병렬로 프리필 작업 및 추측 검증을 수행하기
- 6. 추측적 디코딩: 몇 개의 토큰을 초안으로 작성할지 선택하세요
- 다음에 최적화해야 할 내용
- 기여와 감사의 말
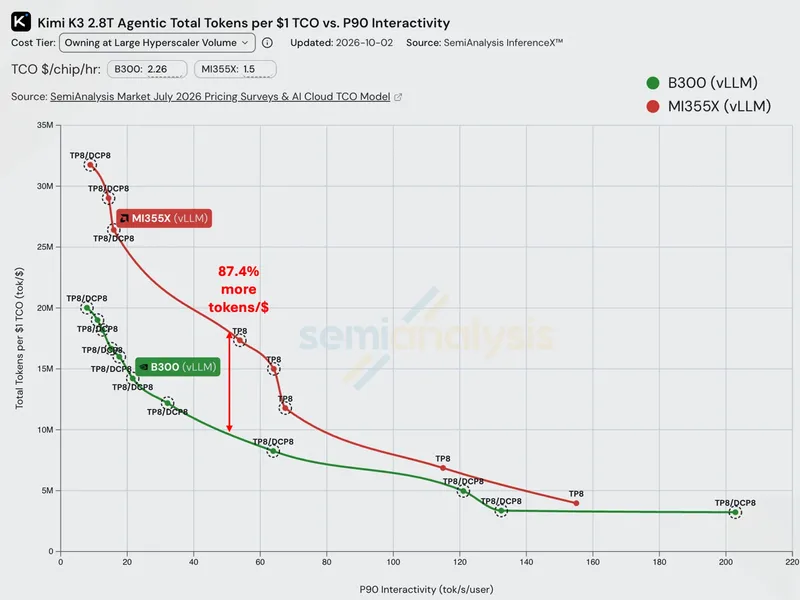
AgentX에서는 AMD Instinct MI355X 8개 GPU 시스템이 vLLM을 사용하여 Kimi K3를 제공하며, 50 터미널/사용자 P90 상호작용에서 NVIDIA HGX B300보다 1초당 각 GPU당 24.4% 더 많은 총 토큰을 제공합니다. 벤치마크의 소유 비용 모델에 따르면, 1달러당 87.4% 더 많은 토큰을 제공합니다.
이 글에서는 AMD Instinct MI355X에 탑재된 Kimi K3의 엔지니어링 구조를 분석하고, vLLM의 서비스 결정과 GPU 커널 및 하드웨어 간의 연결 관계를 설명할 것입니다. 왜 이러한 최적화가 효과적인지 알려주고, 낭비되는 작업을 식별하고 병목 현상을 찾으며, 자신의 인프라에서 다음 단계의 최적화를 찾는 데 필요한 통찰력을 제공할 것입니다.
인터랙티비티는 상호적입니다. P90 응답의 인터토큰 지연 시간을 포함하며, 첫 번째 토큰에 걸리는 시간은 제외됩니다. 총 토큰 수에는 재사용된 입력과 생성된 출력도 포함됩니다.
SemiAnalysis InferenceX, 2026년 10월 9일 스냅샷. 비교 설정.
밀도가 높은 매트릭스 피크는 AMD Instinct MI355X의 10.1 PFLOP/s MXFP4와 NVIDIA B300의 13.5 PFLOP/s FP4입니다. 두 장치 모두 288 GB HBM3E와 8 TB/s의 피크 메모리 대역폭을 갖습니다. 이러한 서비스 성능을 달성한 것은 AMD과 vLLM 커뮤니티 전체의 협력자들이 지속적으로 소프트웨어 공학을 발전시킨 결과입니다.
AgentX: 작업량과 결과
공개된 AgentX 벤치마크는 합성 토큰을 사용하여 실제 코딩 에이전트 세션 트레이스를 재생하며, 요청 길이, 타이밍 및 프리픽스 공유 패턴을 그대로 유지합니다. 이 워크로드는 무제한 캐시를 제공하여 96% 이상의 이론적 프리픽스 재사용이 가능합니다. 추층적인 실행에서는 고정된 합성 수용 참조가 사용됩니다.
50 토큰/초/사용자 P90 상호작용성에서 AMD Instinct MI355X는 약 7,567 총 토큰/초/GPU를 제공하며, 이는 NVIDIA HGX B300의 6,083에 비해 24.4%의 처리량 우위가 있습니다. SemiAnalysis의 모델링된 TCO를 사용하면 각각 $1.50와 $2.26/GPU시간당이 되며, 이는 18.16백만과 9.69백만 총 토큰/달러에 해당합니다. 즉, 달러당 87.4% 더 많은 토큰입니다.
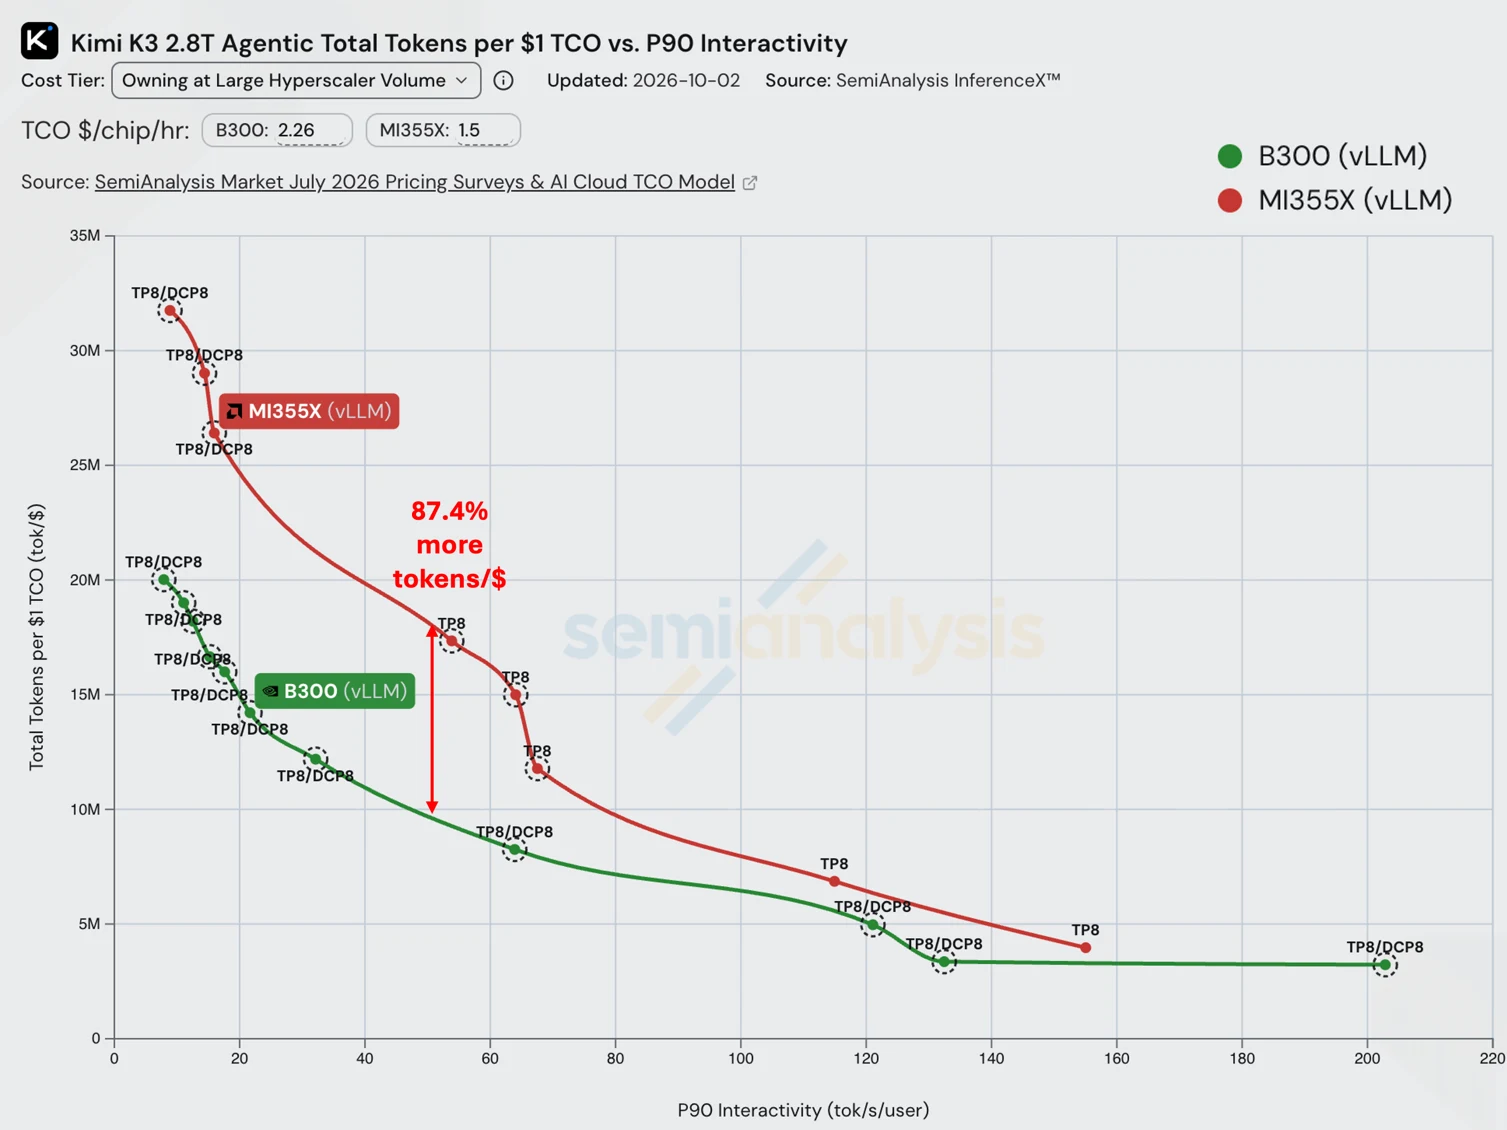
SemiAnalysis InferenceX의 공개 곡선으로, 50 토큰/s/사용자 목표가 표시되어 있습니다. 벤치마크 노트.
공개된 곡선은 전체 서버 구조를 비교합니다. 각 최적화 옵션에 따른 측정값들은 별도의 테스트에서 얻어졌으며, 이는 명시된 구성 하에서의 개별적인 메커니즘을 설명합니다.
킴이 K3 안에서: 전문가들, 주의, 그리고 반복되는 상태
반환하는 에이전트 턴은 대부분의 프리픽스를 재사용할 수 있지만, 짧은 연속 처리를 할 때는 세 가지 종류의 데이터가 관련된다.
Kimi K3는 두 종류의 주의를 사용합니다. 24 MLA 층은 대화가 진행됨에 따라 성장하는 압축된 KV 역사를 보존합니다. 새로운 질문이 들어오면 여전히 그 역사를 참조합니다. 대신 69 KDA 층은 고정된 차원의 상태 행렬을 전달하며, 새로운 토큰이 도착할 때마다 그 행렬을 업데이트합니다. 모델 설정.
MoE 레이어에서 라우터는 각 토큰을 변환하기 위해 전문 네트워크를 선택합니다. 이 네트워크들의 가중치는 요청들 사이에 공유됩니다.
대화가 진행될수록 MLA는 더 많은 역사를 보존합니다. KDA는 고정 크기의 상태를 업데이트하며, 이전 체크포인트를 보존하면 해당 상태의 추가 사본도 유지됩니다.
회전 전체에 걸쳐: 캐시 재사용 및 오프로드(1절).
모델 단계 내에서: 전문가 예측, 커널 핸들오프, MLA/KDA 스케줄링(2–5절).
드래프트 깊이 선택: 확정된 출력과 완전한 사이클 비용의 차이(6절).
1. 캐시: 대화 상태를 재사용할 수 있도록 유지
DCP는 GPU 메모리 내의 중복된 역사 정보를 줄여줍니다; CPU 오프로드 기능은 그 외부에서 재사용 가능한 상태를 유지합니다.
DCP: GPU들을 통해 역사를 공유하기
TP8 하에서 각 GPU는 Kimi K3의 96개 MLA 쿼리 헤드 중 12개를 처리하지만, 전체 압축된 KV 역사는 저장합니다. 텐서 병렬성은 캐시를 분할하지 않고 헤드들을 나눕니다.
8가지 방식의 컨텍스트 병렬 처리(DCP8)를 사용할 때, 각 GPU는 캐시된 위치의 1/8을 저장합니다. 디코딩 과정에서 GPU들은 서로 질문을 교환하고 자신들의 로컬 역사에 따라 계산을 수행하며, 부분적인 답변을 합쳐나갑니다.
두 개의 GPU는 TP8/DCP8에서 사용된 동일한 파티션을 보여줍니다. 이 추가적인 분할은 MLA 역사에 적용되며, KDA 상태는 각 헤드 간에 기존의 파티션을 유지합니다.
각 부분적인 답변에는 정규화 정보가 포함되어 있어 병합 과정에서 샤드를 올바르게 가중치화할 수 있습니다. #51705는 ROCm AITER DCP 경로를 다중 토큰 검증으로 확장합니다.
142,000토큰의 대화에 대해 추정된 MLA 페이로드는 24개의 레이어 × 142,000개의 위치 × 576 FP8 바이트 ≈ 각 GPU당 1.96 GB입니다. DCP8을 사용하면 할당 오버헤드 전에 이 값이 약 245 MB로 줄어듭니다. 각 GPU는 역사의 1/8에 해당하는 수치를 처리하기 위해 8배 더 많은 헤드를 처리하며, 주요 연산은 거의 변하지 않습니다.
CPU 오프로드: 더 이상 HBM에 들어가지 않는 상태를 유지
상태가 더 이상 GPU 메모리에 들어가지 않을 때, AMD 레시피의 native vLLM CPU 오프로드가 호스트 DRAM에 MLA 역사와 KDA 체크포인트를 보존합니다.
캐시 히트는 일치하는 리스폰 점수가 필요합니다. MLA 히스토리가 3,072번째 토큰에 도달하더라도 최신 호환되는 KDA 체크포인트가 2,048일 경우, 요청은 2,048부터 다시 시작해야 하며 남은 프렉시스를 재계산해야 합니다.
사용 가능한 이력서 포인트는 모든 필요한 층위에서 호환되는 상태를 가져야 합니다. 위치는 예시일 뿐입니다.
KDA 체크포인트와 함께 attention-block tail을 저장하면 그들의 리스퀴더 포지션이 맞춰집니다 (#54736). 그 상태를 복원하면 GPU로의 전송을 피함으로써 프리픽스 재계산을 방지할 수 있습니다. 요청이 다시 시작되면, 새로운 토큰들은 여전히 여러 GPU가 동일한 계산을 반복하도록 할 수 있습니다.
2. MoE: GPU들 간의 중복 작업을 제거
한 개의 GPU에서 루팅-전문가 출력 프로젝션은 소비자가 기대하는 전체 벡터를 반환합니다. 원래 ROCm 경로에서는 이전에 수행된 감소 및 정규화 과정으로 모든 8개의 GPU에 동일한 잠재 입력이 주어졌으며, 각각은 전체 가중치를 유지했습니다. 따라서 같은 프로젝션이 8번이나 실행되었습니다.
출력 좌표는 GPU들 사이에 분배될 수 있지만, 각 랭크는 완전한 결과를 필요로 합니다. Kimi K3는 공유 전문 부분에 대한 모든 감소 연산을 이미 지원합니다.
각 GPU는 자신이 소유한 라우팅된 출력만을 공유 전문 부분에 추가합니다. 기존의 all-reduce 처리 방식은 새로운 집합 결과를 생성하지 않고 완전한 결과를 생성합니다 (#51253). ROCm 구현은 해당 CUDA 전략을 기반으로 합니다.
두 개의 GPU가 출력 좌표의 소유권을 나타냅니다. 두 경로 모두 기존의 전체 감소 연산을 사용하며, 각 GPU에 동일한 완전한 결과를 반환합니다.
각 출력 좌표는 정확히 한 번만 라우팅에 참여합니다. 전체 프로젝션 웨이트는 그대로 복제됩니다.
출력 처리량은 TP8에서 8개의 AMD Instinct MI355X GPU를 사용하여 동시 실행 수가 8–128인 환경에서, 무작위 8K 입력/1K 출력 요청과 프리픽스 캐싱이 비활성화된 상태로 PR 테스트를 진행했을 때 3.05–4.91% 증가했습니다.
더 많은 캐시된 상태를 유지하기 위해 GPU 메모리를 확보하세요
각 랭크는 전체 가중치를 유지한 채로, 할당된 투영 좌표만을 계산합니다.
각 랭크가 사용하는 행만 로드하면 TP8에서 92 MoE 계층에 걸쳐 3.85 GiB의 GPU 공간이 절약됩니다 (#59591). 융합 경로의 계산은 동일하게 유지되며, 추가된 공간은 MLA 역사와 KDA 체크포인트를 저장할 수 있습니다.
이 변경 사항은 헤드라인에 사용된 이미지의 공개 결과 이후에 발생했습니다. 별도의 AgentX 실험에서는 동시 처리 수가 32 및 48일 때 1% 미만의 더 높은 처리량을 보였으나, 70일 때는 28.9%가 되었습니다. 또한 보고된 프리픽스-캐시 일치율은 74.8%에서 80.1%로 증가했습니다.
#59591 측정 결과: 8개의 AMD Instinct MI355X GPU, TP8/DCP8, FP8 KV, 30분 실행, CPU 오프로드나 추측 디코딩 없음. 점수는 보고된 실행 결과를 나타내며, 반복 실행에 대한 불확실성은 보고되지 않았습니다.
높은 동시성 수준에서의 더 큰 이점은 캐시 압력과 일치합니다. 동일한 캐시 용량에서 두 구현 방식을 비교하면 그 효과를 명확히 파악하는 데 도움이 됩니다.
전문적인 라우팅과 4비트 활성화에 대해 더 알아보기.
3. 메모리 트래픽: 연산을 통합하고 불필요한 복사본을 제거
각 GPU 내에서 다음으로 살펴봐야 할 곳은 커널들 사이를 통과하는 데이터입니다.
Kimi K3의 단일 토큰 KDA 경로는 세 개의 컴퓨트 커널과 두 개의 출력 복사본을 실행했습니다. 콘볼루션 연산은 Q/K 정규화, 감쇠 및 베타 게이트가 이미 결합된 커널 앞에서 수행되었고, 재귀적 업데이트도 그 뒤에 이루어졌습니다. 출력 정규화는 그 다음에 이루어졌습니다. 결합된 HIP 경로는 이러한 연산들을 하나의 실행으로 처리하며, 직접 목적지 버퍼에 기록됩니다 (#50654).
중간 전달 과정은 칩上에서 이루어진다. кон볼루션 역사와 재규슬 상태는 다음 토큰을 위해 여전히 GPU 메모리로 전송된다.
단일 토큰, 비추상적인 KDA 해독은 #50654에서 이루어집니다. 이전에는 융합된 Triton 정규화 경로가 사용되었습니다. 카운트는 소스 코드에 따라 진행되며, 프로젝션은 보기 외부에 있습니다. 저장 상태의 읽기 및 쓰기는 그대로 유지됩니다.
AttnRes는 이전 레이어 블록의 출력과 실시간 잔차를 혼합합니다. 그 혼합물을 RMSNorm과 결합하면 임시 혼합물이 레지스터에 저장됩니다 (#50593). 후속 레이어를 위해 저장된 실시간 잔차는 BF16 라운딩을 유지하며, 정규화 과정에서도 FP32 형태로 유지됩니다. 테스트에서는 정확한 지속적인 업데이트가 필요하며, 정규화된 출력에 대한 수치적 허용 범위를 허용합니다.
AttnRes fusion을 사용할 때, TP8에서 8개의 AMD Instinct MI355X GPU를 사용하여 100K입력/1K출력 요청 및 프리픽스 캐싱을 비활성화한 경우 처리량이 14.2% 증가했습니다. 긴 프리필 지연 시간은 실질적으로 변하지 않았습니다.
그들을 사용하는 커널만을 입력으로 복사하세요
ROCm matrix-곱 배치기기는 커널을 선택하기 전에 입력을 포장했습니다. 대체 커널이 선택될 때, 그 커널은 원본 입력을 읽고 복사본은 사용되지 않았습니다. 포장 작업을 전문화된 브랜치로 옮기면 이러한 복사본이 사라집니다 (#58566).
프로필은 낭비를 드러냈습니다: 디코딩 단계당 69개의 불필요한 복사본, KDA 레이어당 하나씩. 각각 1,792바이트만 이동했지만 약 4.8마이크로초가 걸렸습니다. 그 바이트를 더 빠르게 이동시키는 것은 거의 도움이 되지 않았으며, 실행 오버헤드가 우세했습니다.
PR의 TP8에서 동시성 하나, 6개 초안, 384K-컨텍스트 프로필으로, 제거된 복사본이 각 스텝마다 0.339 ms의 복사 커널 시간을 차지합니다.
4. MLA: AMD AITER 어셈블리를 이용한 더 빠른 긴 컨텍스트 디코딩
Kimi K3는 TP8에서 각 GPU에 12개의 쿼리 헤드를 갖습니다. 16개로 확장함으로써 AMD AITER의 어셈블리 디코딩 경로가 가능해졌습니다. 보고된 긴 �텍트 테스트에서 출력 토큰당 시간은 43.8ms에서 23.6ms로 감소했습니다.
비교에서는 DCP 없이 TP8을 사용했으며, 동시성 수는 하나였습니다. #50578에 있는 어댑터는 네 개의 쿼리 헤드를 복사하여 16개의 헤드로 구성된 레이아웃에 넣고 그 출력을 버립니다. DCP8은 다른, 96개의 헤드 형태를 제시합니다.
이로써 모델의 작동이 보존됩니다. 각 쿼리 헤드가 캐시된 위치에 독립적으로 접근하기 때문입니다. 추가적인 헤드를 추가해도 원래 헤드의 softmax는 변하지 않습니다. 이 디코드 경로에서는 쿼리만 패딩되며, 저장된 압축된 KV 역사는 동일한 크기로 유지됩니다.
긴 대화는 많은 주의를 필요로 하지만, 그 작업은 GPU에 분산되어야 합니다. 우리가 검토한 역사적 코드에서는 보수적인 접근이 사용되었습니다. 일정 설정 힌트 Gluon 경로를 제한했습니다 요청마다 하나의 워킹그룹그 워킹그룹은 여전히 전체 대화를 처리하고 있었다. 패딩으로 인해 AMD AITER의 어셈블리 경로가 사용 가능해졌으며, 다른 정책 역사를 평행한 조각들로 나누고 그 결과를 결합하는 데 사용됩니다.
역사 분할은 한 GPU 내의 작업그룹에 할당된 작업입니다. 예시를 위해 네 개가 표시되었으며, 검사된 조립 정책은 열여섯을 선택했습니다. KV 저장소는 변하지 않았습니다.
| 입력 / 출력 토큰들 | 원본 Gluon 경로 | Padded 조립 경로 |
|---|---|---|
| 1K / 1K | 22.9 ms/토큰 | 22.8 ms/토큰 |
| 32K / 1K | 43.8 ms/토큰 | 23.6 ms/토큰 |
PR로 보고된 출력 토큰당 평균 시간: 8개의 AMD Instinct MI355X GPU, TP8, 동시 처리 수는 1개, MXFP4 모델의 가중치, BF16 인지 기능 및 일반적인 단일 토큰 디코딩.
단순한 입력 상황은 거의 변하지 않지만, 긴 입력 상황에서는 출력 토큰당 시간이 거의 절반으로 줄어듭니다. 이러한 서비스 측정값에는 쿼리 준비 및 출력 처리가 포함됩니다.
5. KDA: 병렬 처리로 프리필 작업 및 추측 검증 수행
MLA는 보존된 역사를 여러 작업 그룹으로 분할할 수 있다. KDA는 더 어려운 일정 설정 문제를 제시한다: 각 토큰은 이전 상태에 의존한다. #54038의 융합 프리필은 들어오는 상태가 알려지기 전에 각 토큰 그룹의 합성 변환을 준비한다.
예를 들어 “상태를 절반으로 줄이고 두를 더한다”는 것과 “상태를 절반으로 줄이고 하나를 더한다”는 것을 결합하여 “시작 상태의 4분의 1을 가져가고 두를 더한다”로 만들 수 있습니다. 이 규칙은 시작 상태가 도착하기 전에 계산할 수 있습니다.
KDA는 매트릭스 변환을 통해 이를 수행합니다. 그룹 요약의 순서대로 스캔함으로써 각 그룹의 시작 상태를 결정하며, 그룹들은 그 후 병렬적으로 토큰을 재생합니다. 토큰의 순서는 그대로 유지되지만, 각 그룹은 이전 그룹의 재생을 기다리지 않습니다.
그룹화는 두 번의 실행으로부터 네 번의 실행으로 부분적으로 결합된 경로를 확장하여 두 번째 워크를 추가합니다. 일부 시퀀스나 헤드가 너무 적은 평행 작업을 수행할 때 도움이 되지만, 그렇지 않으면 추가적인 실행이 절약하는 것보다 더 많은 비용이 발생할 수 있습니다.
각 그룹 내에서 반복적인 워크는 셸들 사이의 매트릭스-액셀레이터 레지스터에 상태를 저장하여 전체 메모리에 대한 쓰기 및 재로드를 피합니다. 상태 저장 다이어그램.
별도의 3개 백엔드 비교에서, 융합된 KDA는 4K 및 16K 입력 길이에서 트리톤보다 5.3–5.6% 더 많은 입력 처리량을 제공했습니다. 이는 8개의 AMD Instinct MI355X GPU, TP8, 동시성 32, 프리픽스 캐싱 비활성화, 하나의 토큰 출력이 적용된 경우입니다. 이는 전체 백엔드를 측정한 것입니다. 베네마크 결과.
추측적 검증을 위해 더 작은 타일을 사용하세요
짧은 검증 배치에는 다른 분할 방식이 필요합니다. TP8에서 각 GPU는 12개의 KDA 헤드를 가진 128개의 값 열을 가지고 있습니다. 각 헤드를 4개의 32열 타일로 분할하면 256개의 계산 단위에서 48개의 작업 그룹만 생성됩니다. #58045는 4열 타일로 전환하여 384개로 증가시킵니다.
각 타일은 서로 다른 값 열을 가지고 있으며, 같은 토큰 순서를 일정하게 따라갑니다. 더 좁은 타일의 경우 독립적인 작업 그룹의 수가 48개에서 384개로 증가합니다.
별도의 그래프 재생 커널 테스트에서 AMD Instinct MI355X GPU(TP8 크기, 한 번의 시퀀스, 4개의 검증 위치)에서 시간이 각 레이어당 16.20 마이크로초에서 5.61 마이크로초로 감소했으며, 이는 2.89배 감소입니다. 여기에는 좁은 타일, 단일 파동 워크그룹, 균일 길이의 전문화 및 들어 올린 토큰 불변 작업이 포함됩니다. 불규칙한 배치는 동적 경로를 유지하며, 테스트에서는 출력과 재발생 상태를 비교합니다.
6. 추층적인 디코딩: 토큰을 몇 개 작성할지 선택하세요
더 빠른 검증으로는 체크해야 할 초안 토큰의 수가 달라질 수 있습니다. 유용한 비율은 약속된 출력량을 전체 초안 검증 및 커밍핑 사이클 시간으로 나눈 값입니다.
예를 들어, AgentX의 고정된 수용 참조에 따르면 세 개의 초안을 사용할 때 각 사이클당 예상된 약속된 토큰 수는 3.00이 되고, 네 개의 초안을 사용할 때는 회복 또는 보너스 토큰 포함하여 3.36가 됩니다. 이는 각 사이클당 약속된 출력이 12% 더 많다는 의미입니다. 네 개의 초안을 사용하면, 전체 사이클이 세 개의 초안보다 12%보다 적게 걸린다면만 처리량이 향상됩니다.
통제된 수용 참조 하의 예시적 비교. 12% 임계값은 비용 예산입니다; 전체 사이클 성장은 여기서 측정되지 않았습니다.
공개된 AMD 레시피는 DCP1을 사용하여 3개에서 7개의 드래프트를 활용하며, 더 큰 DCP8 동시성 설정에서는 추측 기능을 비활성화합니다.
다음에 최적화해야 할 것
지속적인 프리필/디코드 분해 작업으로 인해 또 다른 확인해야 할 부분이 생겼습니다: 작업자 균형과 데이터가 필요될 때까지 전송이 완료되는지 여부입니다.
다른 모델이나 작업량의 경우, 배포된 요청 구조로부터 시작하여 세 가지 검사를 수행하세요:
랭크를 비교하세요. 여러 GPU가 같은 결과를 계산하고 있는데, 그 결과를 모아서 처리할 수 있는 집합이 있나요?
버퍼을 따릅니다. 각 임시 텐서에 선택된 경로를 통해 소비자가 있나요? 데이터가 칩 내에 남아 있을 수 있나요?
독립적인 작업 수를 세세요. 실제 헤드, 토큰, 타일이 부하를 분산할 수 있을 만큼 충분한 작업 그룹을 생성하는가?
필요한 응답 속도에 맞게 전체 요청을 측정하고, 출력 결과와 저장된 상태를 모두 확인하세요. 다음 토큰을 처리하는 데 걸리는 시간을 줄여주는 더 빠른 커널이 중요합니다.
기여와 감사의 말
킴이 K3 프로젝트는 AMD, 임베디드 LLM 및 더 넓은 커뮤니티로부터 50개가 넘는 AMD/ROCm 관련 vLLM PR을 통합한 것을 포함하며, AITER 개발, 통합, 리뷰 및 벤치마킹도 포함됩니다. 기여 내용에는 주의력, 재사용, MoE, 양자화, 그래프 실행, 캐시 지원 및 플랫폼 통합 등이 포함됩니다.
특별한 감사의 말: 핀 시앙 탄, 준 강 초우, 예 후창, 홍샤 양, 성록 중, 빌 헤, 이치아오 주, 혁준 이, 앤디 루오, 미르날 카르빈, 리처드 리, 선 펑
앤디 프리드리히, 에단 양, 탕루이, 안드레아스 카라차스, 안쿠르 싱, 이화 청, 바드르 바 소위드, 벤자민 치슬렛, 타오유 주, 빌 헤, 빈 딩, 보웬 바오, 브랜든 장, 차민 림, 찰스 우, 쉬안 (리처드) 리, 펠릭스 리, 캐머런 퀼리치, 위쉬우 덩, 왕 데웨이, 디바카르 베르마, 더글러스 레어, 에드윈 림, 유동 판, 엘비르 크른체비치, 팡체, 팡저우 아이, 싱란 팬, 푸루 리, 펠릭스 마르티, 칸린 곽, 서머 양, 장하이창, 유펑 허, 허 루, 홍샤양, 이영준, 이판 카오, 제임스 E T 스미스, 자후이 카오, 양원 진, 조나단 첸, 준티안 루, 쇼춘 리, 케다르 포트다르, 케빈 H. 루우, 쿠안-푸 류, 쿤타이 두, 카일 세이어스, @lalala-sh, @linnea-lin-00638949, 류인펑, 루카스 윌킨슨, 가브리엘 우, 마르쿠스 하르티카이넨, 마이틸리 조시, 제프 (준즈) 마, 마태웡, 미샤 고잉, 미카 윌리엄슨, @minmengdie, 마트베이 파시코프스키, 마티우스 네하, 니콜로 루케시, 닉 힐, 니콜라스 수사토, 옥사나 코르즈, 페이 장, @ppalanga, 페이란 진, 秋陽月, 리타 브루가롤라스, 레베카 리, 라이언 록, 로한 포트다르, @Saddss, 사무엘 센, 셰인 필리몬, 정승록, 샨티프리야 파리다, 산산 심, 성난서, 시몬 다니엘손, 시라즈 샤이크, 스테이시 로버츠, 스테판 코나르체비치, 아산 스테프스키, 밍후이 장, 타리크 사라치, 툰 자안 탄, 링펑진, 반시 바티아, 마크시민 베데네프, 예훈충, @wenwzhan, 위 자오, 자비에 아기야르, 장샤오빙, 샤오후 구오, 신 리, 수동 류, 양서인, 예웨탕, 왕용친, 리긴스 첸, 차오 홍, 유천 센, 맷 진, 주이차오, 로저 왕, 정공, 장윈 주, 지비 그린베르그, 쥐오이 주.
베너마크 노트
비교 대상에 대한 서비스 구성
| P90 상호작용성 (토큰/사용자) | AMD Instinct MI355X | NVIDIA HGX B300 |
|---|---|---|
| 30과 50 | SimpleCPU 오프로드; DCP8 / DCP1으로의 드래프트 없음 / 세 개의 드래프트 | 문캐크 오프로드; DCP8 |
| 150 | GPU 전용; DCP1; 5~7개의 초안 | 문캐크 오프로드; DCP8 |
두 시스템 모두 8개의 GPU를 사용하며, TP8, FP4 가중치와 FP8 KV를 활용합니다. 각 발표된 오프로드 또는 GPU 전용 세트 내에서 값은 일치하는 상호작용 수준에 따라 중간값으로 변환됩니다. 동시성, DCP 및 초안 깊이는 여러 실행 사이에 달라질 수 있습니다. AMD 레시피 (YAML)와 NVIDIA 런처는 이미지 태그와 전체 설정을 제공합니다.
Replay는 cc-traces-weka-062126 데이터셋과 pin된 AIPerf harness를 사용하며, 워밍업은 제외되고 고정된 합성 수용 곡선 하에서 한 시간의 프로파일링이 이루어집니다. 레시피에는 시드, 세션 시작 및 워밍업 설정이 포함됩니다. 다운로드된 데이터셋 버전은 기록되지 않습니다. 폐쇄 루프 재생은 다른 완료된 요청 조합을 생성할 수 있습니다.
소프트웨어 및 오프로드. 제출된 모델은 vLLM 36768d1bf (AMD)와 5894fdf98 (NVIDIA)를 사용합니다. 구성된 호스트-캐시 예산은 각각 GPU당 224.875GB와 281GB입니다; 커넥터 및 이미지 설정은 링크된 레시피에 있습니다.
비용. SemiAnalysis의 대규모 하이퍼스케일러 소유 모델 및 공개된 GPU 비용 상수는 AMD Instinct MI355X의 경우 GPU 시간당 $1.50, NVIDIA HGX B300의 경우 $2.26를 사용합니다. 총 토큰/$ = 총 토큰/s/GPU × 3,600 ÷ 모델링된 $/GPU 시간. 일부 자본 및 활용에 대한 가정은 아직 공개되지 않았습니다. 50토큰 상호작용 목표에서의 비교 결과, 각 토큰당 모델링된 비용은 46.6% 낮습니다.
스냅샷. 2026년 10월 9일에 수집된 SemiAnalysis InferenceX 데이터; 제출된 데이터는 2026년 9월 30일(AMD)과 2026년 8월 16일(NVIDIA)입니다. PR 벤치마크는 명시된 워크로드를 사용합니다; #59591는 헤드라인 이미지 이후의 별도 실험입니다.
| GPU별 게시된 사양 | AMD Instinct MI355X | NVIDIA B300 GPU |
|---|---|---|
| 밀집된 저정밀 행렬 피크 | 10.1 PFLOP/s MXFP4 | 13.5 PFLOP/s FP4 |
| GPU 메모리 | 288 GB HBM3E | 288 GB HBM3E |
| 최대 메모리 대역폭 | 8 TB/s | 8 TB/s |
출처: AMD Instinct MI355X, NVIDIA HGX B300, NVIDIA 메모리 사양. 벤치마크 세부 정보: AgentX 방법론.
기술적 참고: 전문적인 라우팅 및 정밀도
키미 K3는 896명의 전문가 중 각 토큰당 16명을 선택하므로, 대규모 서버 배치에서도 각 전문가당 몇 개의 행만 남을 수 있습니다. 그 결과로 생성된 전문가 타일에는 패딩이 포함될 수 있습니다.
A4W4는 트래픽의 다른 부분을 줄여줍니다: #53940에서의 통합 작업으로 활성화 수가 8비트에서 4비트로 변경되며, 가중치는 여전히 4비트로 유지됩니다. 총 트래픽에는 BF16 중간 출력과 전문 타일 패딩도 포함됩니다.
기술적 참고: KDA 정밀도 및 온칩 메모리
각 블록은 여전히 자체 토큰들 간의 의존 관계를 해결해야 합니다. 커널은 이들을 하나로 통합하여, 나중에 행렬 제품이 적용할 수 있는 변환을 만듭니다. 이로 인해 두 가지 실용적인 질문이 생깁니다: 어떤 정밀도가 답을 보존하는가, 그리고 칩 위에 얼마나 많은 임시 데이터가 들어갈 수 있는가?
작은 예시가 그 개념을 보여줍니다. 이전 수정값을 후속 수정값으로 대체하면, 각 답은 알려진 입력값으로 직접 표현될 수 있습니다. 결과로 나온 계수 테이블에는 의존 관계의 연쇄가 이미 반영되어 있습니다.
이 스칼라 그림에서, 위치 3에 대한 효과는 두 가지 경로를 거칩니다: 직접적으로, −1/8; 위치 2를 통과하여, (−1/4) × (−1/4) = 1/16입니다. 이 두 값을 합하면 −1/16이 되며, 이는 테이블의 왼쪽 아래 셀에 해당합니다. 대각선 위의 0들은 이후 위치가 이전 위치에 영향을 주지 못함을 나타냅니다.
실제 프롤로그는 64×64 크기의 내분판 의존성 행렬의 역행렬을 계산합니다. 이후 행렬 연산에서는 이 변환을 사용하여 해당 의존성을 고려합니다.
역함수의 중간 값들은 증가하거나 상쇄될 수 있습니다. 너무 일찍 반올림하면 최종 결과에 필요한 정보를 잃게 됩니다. 구현에서는 AMD의 natively 제공하는 FP32 행렬 명령어을 사용하여 FP32 입력과 민감한 역함수를 위한 누적 작업을 유지합니다. 완료된 역함수만이 후속 제품을 위해 BF16로 반올림됩니다. 커널 구현.
FP32 축적이 반올림된 입력값을 복구할 수 없는 이유
256.5에서 256를 빼는 것을 고려해 보세요. 두 입력값은 모두 FP32로 정확합니다. 이 정도의 크기에서는 256.5를 BF16으로 변환할 때 256으로 반올림됩니다.
| 입력 정밀도 | FP32에서 수행된 차감 연산 | 결과 |
|---|---|---|
| 원본 FP32 입력을 그대로 유지하세요 | 256.5 − 256 | 0.5 |
| 입력을 먼저 BF16으로 반올림하세요 | 256 − 256 | 0 |
FP32 감소 연산은 시작되기 전에 손실된 정보를 복구할 수 없습니다. 이러한 간단한 값들은 역연산이 네이티브 16×16×4 FP32 행렬 명령을 사용해야 하는 이유를 보여줍니다. 이를 통해 입력 및 합산 정밀도를 모두 유지할 수 있습니다.
FP4 모델도 더 높은 정밀도의 연산에 의존합니다. 그 성능은 이러한 수치적 경로를 효율적으로 만들어지는지에 달려 있습니다.
프롤로그에도 로컬 메모리 예산이 있습니다. AMD는 온칩 공유 스크래치인 LDS를 사용합니다. Q와 K 타일은 다른 시점에 필요하기 때문에 저장 공간을 재사용합니다; 삼각형 입력은 16×16 블록 중 10개가 사용된 부분만 저장합니다. 워크그룹은 79.5 KiB를 요청하며, 이는 80 KiB로 근사되며, 이는 AMD CDNA 4 컴퓨트 유닛의 160 KiB LDS 예산의 절반에 해당합니다.
1,280바이트 단위로 할당을 진행합니다. 표시된 추가 KiB는 거주 기간 임계치를 넘어섭니다. 두 번의 할당은 더 이상 적합하지 않습니다. 이는 용량 계산입니다; 레지스터와 다른 리소스들은 추가적인 제한을 가질 수 있습니다.
커널 바이너리를 고정한 상태에서 그 임계값을 넘을 수 있도록 충분한 사용되지 않은 LDS를 예약하여 이를 테스트하세요. 실행 시간이 거의 변하지 않는다면, 추가된 재식재지 않은 작업그룹이 그 형태에 거의 영향을 미치지 않았습니다.
쿼트들 사이의 상태
그룹 요약 및 시작 상태는 여전히 커널 경계를 넘습니다; 요청된 체크포인트와 최종 상태가 저장됩니다.
면책 조항
이 문서에 제시된 정보는 정보 제공 목적으로만 제공되며, 기술적 부정확성, 누락, 철자 오류가 있을 수 있습니다. 이 문서에 포함된 정보는 많은 이유로 변경될 수 있으며 부정확할 수 있습니다. 여기에는 제품 및 로드맵 변경, 구성 요소 및 마더보드 버전 변경, 새로운 모델 및/또는 제품 출시, 서로 다른 제조업체 간의 제품 차이, 소프트웨어 변경, BIOS 플래시, 펌웨어 업그레이드 등이 포함됩니다. 모든 컴퓨터 시스템에는 완전히 예방하거나 완화할 수 없는 보안 취약점의 위험이 있습니다. AMD는 이 정보를 업데이트하거나 수정하거나 개정할 의무가 없습니다. 그러나 AMD는 이 정보를 수정하고 내용을 때때로 변경할 권리를 보유하며, 이러한 수정이나 변경에 대해 누구에게도 통지할 의무는 없습니다. 이 정보는 “그대로” 제공됩니다. AMD는 이 정보의 내용에 대해 어떠한 보증이나 약속도 하지 않으며, 이 정보에 나타날 수 있는 오류, 잘못된 내용, 누락 사항에 대한 책임도 지지 않습니다. AMD는 특히 불법적 침해가 없는다는 명시적 보증, 판매 가능성, 또는 특정 목적에 적합함에 대한 보증을 부인합니다. 어떠한 경우에도 AMD는 본 문서에 포함된 정보를 사용함으로써 발생하는 모든 신뢰, 직접적, 간접적, 특별적 또는 기타 결과적 손해에 대해 어떠한 개인에게도 책임을 지지 않습니다. AMD가 그러한 손해의 가능성을 명시적으로 알고 있다 하더라도 마찬가지입니다. AMD, AMD Arrow 로고 및 그 조합은 Advanced Micro Devices, Inc.의 상표입니다. 이 출판물에 사용된 다른 제품명들은 식별 목적만을 위한 것이며, 해당 회사들의 상표일 수 있습니다. © 2026 Advanced Micro Devices, Inc. 모든 권리 보유.