
Reflection의 Beam이 Hugging Face에 출시되었습니다! 새로운 미국 랩 Reflection의 첫 번째 모델이며, 오픈 소스입니다! 501B 파라미터(토큰당 23B 활성)의 mixture-of-experts(MoEs) 모델로, 텍스트 입력을 지원하며, 1M 토큰의 컨텍스트 윈도우를갖추고 있고, Apache 2.0 라이선스로 공개되었습니다.
Beam은 코딩 및 에이전트 사용 사례에 집중합니다. 자체 하드웨어, 인프라 또는 클라우드에서 프론티어급 모델을 원하고, 이를 자신의 사용 사례에 맞게 커스터마이즈하려는 팀을 위한 모델입니다. Beam은 모델의 최고 성능을 끌어내는 전용 오픈 소스 Rust 기반 하네스를 함께 제공합니다.
Beam은 네이티브 transformers 구현체를 갖추고 있으며, vLLM 및 SGLang 같은 다운스트림 라이브러리도 지원합니다. 우리는 Reflection 팀과 협력하여 이 모델을 필요에 맞게 구축할 수 있도록 추론, SFT(지도 파인튜닝), RL(강화학습) 레시피를 준비했습니다. transformers, SGLang, vLLM의 day-0 지원에 더해, 이 글에서는 모델 실행 방법, 포스트트레이닝 방법, 그리고 우리가 이 모델로 무엇을 만들었는지 보여드립니다.
TL;DR
- 토큰당 23B 활성의 501B 파라미터 MoEs LLM. 52개 레이어, MoE 레이어당 256개 전문가, 토큰당 8개 라우팅.
- 텍스트 입력, 텍스트 출력이며 1M 토큰의 컨텍스트 윈도우를 지원합니다.
- 체크포인트 포맷: BF16, FP8, 및 NVFP4
- 여러 턴에 걸쳐 컨텍스트를 유지할 수 있는 추론(
preserve_thinking), 전용 문법을 사용한 도구 호출. 모델은 "low", "medium"(기본값), "high", "xhigh", "max"의 다섯 가지 추론 값을 지원합니다.- 토크나이저의 응답 템플릿.
- DFlash2를 사용한 스페큘러티브 디코딩 드래프터 모델
- Day-0 라이브러리: transformers, SGLang, vLLM. Miles를 통한 전체 파라미터 RL.
- 다음과 함께 제공: Rust 기반 커스텀 하네스.
- Apache 2.0.
Beam으로 만들기
Reflection은 Beam을 사용하는 최고의 프로젝트에 10,000달러 상당의 Hub 크레딧을 제공합니다. 무엇이든 만들어서 Hub에 공유하기만 하면 됩니다:
- Spaces에서 Beam 모델을 사용하는 데모를 만들 수 있습니다
- 선호하는 하드웨어에 맞게 양자화할 수 있습니다
- 즐겨 찾는 문제에 대한 합성 데이터셋을 생성할 수 있습니다
- Beam으로 혹은 Beam을 위한 RL 환경을 구축할 수 있습니다
- Beam을 벤치마크하고 결과를 공유할 수 있습니다.
- 우리를 놀라게 해보실 수도 있습니다!
Beam으로 무언가를 만들었다면, $10,000을 받을 기회를 위해 Hub에 공유하세요. 스페이스, 모델 또는 데이터셋 저장소를 만들어 모델의 저장소 페이지에 공유하기만 하면 됩니다. 모든 링크를 수집하여 최고의 작품을 선정하고 Hub 계정으로 크레딧을 보내드립니다.
Beam이란 무엇인가요?
Beam은 긴 컨텍스트(1M 컨텍스트 길이) 추론과 에이전트 작업을 위해 만들어진 텍스트 전용 모델입니다. 각 토큰이 네트워크의 작은 일부에 의해서만 계산되는 sparse MoE 모델로, 대규모 모델의 용량을 유지하면서 훨씬 작은 모델의 속도로 실행됩니다.
어텐션
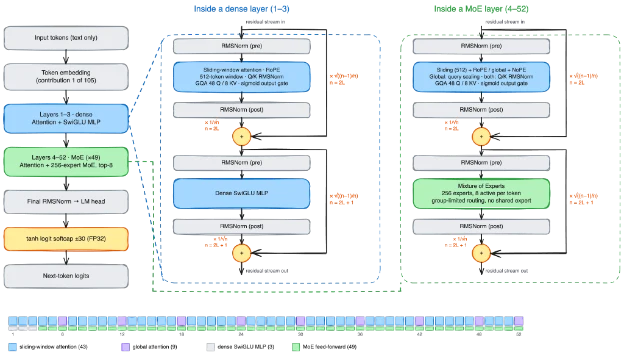
디코더는 52개의 레이어와 5,120의 hidden size를 가집니다. 대부분의 레이어는 이전 512개 토큰에 대한 sliding-window attention을 사용하며, 여섯 번째마다 있는 레이어와 마지막 레이어는 전체 컨텍스트에 어텐션합니다. 이를 통해 43개의 sliding-window 레이어와 9개의 글로벌 레이어가 됩니다.
어텐션 블록 내부 (두 레이어 유형 모두)
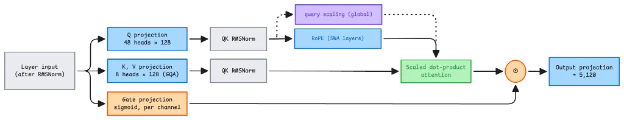
두 종류의 레이어는 위치를 다르게 처리합니다. Sliding-window 레이어는 짧은 윈도우 내에서 상대적 위치가 가장 중요하기 때문에 RoPE를 사용합니다. 글로벌 레이어는 위치 인코딩을 사용하지 않습니다. 대신 각 쿼리는 보이는 토큰 수에 따라 천천히 커지는 스케일러와 곱해집니다, (1 + (pos + 1) / 2048) ** 0.1. 이는 온도(temperature) 역할을 합니다: 컨텍스트가 길어질수록 softmax가 평탄해지는 대신 정밀도를 유지합니다. 구현체에서는 이를 scalable-softmax 쿼리 스케일링이라고 부릅니다.
어텐션은 48개의 쿼리 헤드와 8개의 키-값 헤드를 갖는 grouped-query attention을 사용하며, 쿼리와 키에 RMSNorm을 적용합니다. 레이어 입력으로부터 계산되는 학습된 sigmoid 게이트가 출력 프로젝션 전에 모든 헤드의 모든 채널을 스케일링합니다.
Mixture of Experts
처음 3개 레이어는 dense SwiGLU MLP를 사용합니다. 나머지 49개 레이어는 이를 256개의 전문가로 구성된 Mixture-of-Experts 블록으로 대체하며, 각 전문가는 중간 크기가 2,560인 SwiGLU MLP로 약 39M 파라미터입니다. 전문가들이 모델 파라미터의 98.4%를 차지합니다.
라우터는 DeepSeek-V3의 group-limited 방식을 따릅니다. 256개 전문가 전체를 sigmoid로 점수 매긴 뒤, 32개씩 8개 그룹으로 나누고, 각 그룹의 상위 두 점수의 합을 기준으로 가장 좋은 4개 그룹을 남긴 후, 그 안에서 상위 8개 전문가를 선택합니다. Beam은 DeepSeek-V3와 동일한 그룹 크기를 사용하지만 공유 전문가는 없습니다. 전문가 출력은 정규화된 라우터 가중치로 결합되고 2.5로 스케일됩니다.
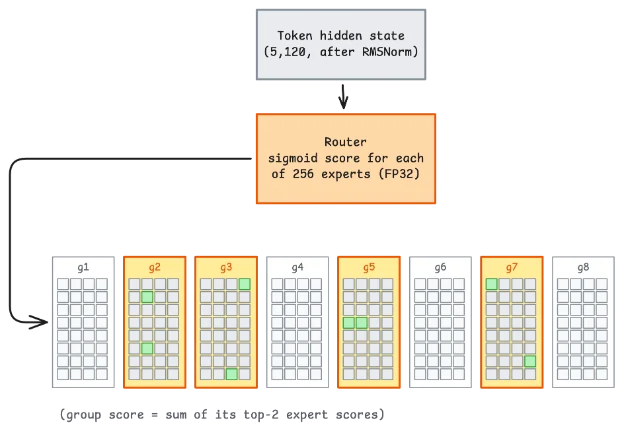
토큰당 8개의 전문가만 실행되므로 모델은 각 토큰을 약 23B 파라미터로 계산합니다. 256개 전문가 전체가 메모리에 유지되므로 배포에는 501B 모델의 메모리가 필요하지만 23B 모델의 속도로 실행됩니다. BF16 체크포인트는 safetensors 형식으로 약 1 TB입니다. NVFP4 체크포인트는 NVIDIA Blackwell GPU를 위해 대부분의 파라미터를 4비트 정밀도로 저장하며, 정확도를 위해 일부 파라미터는 BF16으로 유지됩니다. 또한 허브에는 Hopper 및 Ampere 시리즈 칩에 이상적인 FP8 체크포인트도 있습니다.
Beam을 직접 배포하고 싶으시다면 아래의 vLLM 또는 SGLang 레시피를 확인하세요.
Residual Stream
잔차 연결이 가장 독특한 부분입니다. 표준 트랜스포머는 각 서브레이어 출력을 가중치 1로 스트림에 더하기 때문에 스트림이 깊이에 따라 커집니다.
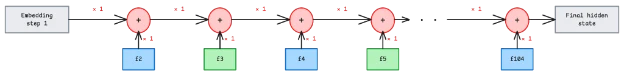
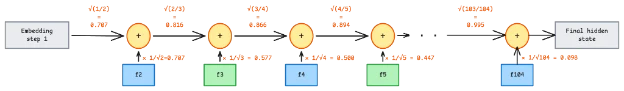
Beam은 입력 임베딩을 단계 1로 계산합니다. 단계 k 에서 서브레이어 출력을 가중치 1/sqrt(k) 로 더하고 기존 스트림을 가중치 sqrt((k-1)/k)로 유지합니다. 두 가중치의 제곱합이 1이므로 스트림은 첫 레이어부터 마지막 레이어까지 일정한 크기를 유지합니다. 104번의 모든 덧셈 후, 모든 서브레이어 출력과 입력 임베딩은 최종 히든 상태에서 동일한 가중치를 가집니다.
모든 서브레이어는 전후로 정규화되며, 최종 로짓은 FP32로 계산되는 ±30의 tanh softcap을 통과합니다. 구현은 FP32로 계산하는 위치를 고정합니다: 라우터, SwiGLU 곱, 정규화, RoPE, 쿼리 스케일링 및 softcap.
Long Context
하이브리드 어텐션은 긴 컨텍스트에서 잘 작동합니다. 각 레이어는 토큰당 2 x 8 KV heads x 128 dims = 2,048개의 값을 캐시합니다. 52개 레이어 모두 모든 토큰을 유지하면 캐시가 토큰당 208 KiB씩 증가합니다. 9개의 전역 레이어만 전체 시퀀스를 유지합니다. 43개의 슬라이딩 윈도우 레이어는 각각 고정된 512토큰 윈도우를 유지하며 더 이상 증가하지 않습니다. 따라서 캐시는 토큰당 36 KiB씩 증가하며, 이는 순진한 방식의 약 6분의 1입니다.
| Context | 52개 레이어가 모두 전역인 경우 | Beam |
|---|---|---|
| 32K tokens | 6.5 GiB | 1.2 GiB |
| 128K tokens | 26 GiB | 4.6 GiB |
| Full context (1M) | 208 GiB | 36.08 GiB |
이 수치는 transformers dynamic cache 기준, BF16으로 시퀀스당 수치입니다.
Benchmark Results
Reflection 팀이 제공한 다양한 정밀도 수준별 벤치마크 결과입니다.
| Beam (BF16) | Beam (FP8) | Beam (NVFP4) | |
|---|---|---|---|
| Agentic Coding / Terminal | |||
| DeepSWE v1.1 | 43.3% | 43.0% | 42.7% |
| SWE Bench Pro v2-Hard | 76.5% | 78.4% | 78.6% |
| SWE Bench Pro v1 | 66.1% | 65.9% | 65.6% |
| Terminal Bench v2.1 | 80.1% | 78.9% | 78.2% |
| SWE Atlas Codebase QnA | 31.8% | 32.2% | 31.4% |
| SWEBench Multilingual | 78.3% | 78.1% | 77.5% |
| SWEBench Verified | 81.6% | 80.2% | 80.7% |
| 추론 | |||
| AIME 2026 | 97.7% | 98.0% | 97.5% |
| HLE (도구 없음) | 36.0% | 36.0% | 34.8% |
| HLE (도구 사용) | 51.1% | 51.1% | 51.1% |
| SciCode | 49.2% | 48.3% | 46.9% |
| CriPT AA | 16.3% | 17.4% | 15.4% |
| GPQA Diamond | 90.6% | 90.3% | 89.3% |
| LiveCodeBench | 88.3% | 88.1% | 87.4% |
| 도구 호출 / 검색 | |||
| AutomationBench - 공개 분할만 해당 | 39.3 | 38.2 | 39.8% |
| MCP Atlas | 80.8% | 81.5% | 80.5% |
| Tau3 Banking | 36.1% | 36.8% | 35.4% |
| 컨텍스트 관리를 사용한 BrowseComp | 76.8% | 76.7% | 75.6% |
| 컨텍스트 관리를 사용한 DeepSearchQA | 80.5% | 79.6% | 81.1% |
| 일반 역량 | |||
| AA-LCR | 78.2% | 79.4% | 78.7% |
| LongBench v2 | 67.5% | 67.6% | 67.2% |
| IFBench | 79.6% | 80.7% | 79.2% |
| AA Omniscience (지수) - 공개 분할만 해당 | 10.8 | 8.8 | 9.8 |
하드웨어 요구 사항
모델을 서빙하는 가장 실용적인 방법은 NVFP4 체크포인트를 서빙하는 것이며, 이는 bf16 체크포인트의 품질 대부분을 유지합니다. NVFP4는 일부 가중치를 4비트로 저장하며, 이를 통해 BF16의 501B 파라미터를 1 TB에서 약 280 GB로 줄입니다. Blackwell GPU는 NVFP4를 네이티브로 실행하지만 H200과 같은 Blackwell 이전 GPU는 실행할 수 없습니다. FP8 체크포인트는 Blackwell 이전 GPU에 적합합니다.
B200은 180 GB의 HBM3e를 갖고 있으므로, 두 개(360 GB)면 Beam 가중치를 수용할 수 있지만 활성화 값과 KV 캐시를 위한 여유 공간은 거의 없습니다. B200 4개(720 GB)를 계획하세요. 그러면 긴 컨텍스트와 동시 요청을 위한 충분한 여유 공간이 생깁니다. 전체 8xB200 노드, 각각 288 GB인 B300 2개, 또는 8xRTX Pro 6000에서도 서빙할 수 있습니다. Blackwell 하드웨어가 없다면 Inference Providers(서버리스)를 사용하여 Reflection을 테스트하세요.
추론 지원
Beam은 transformers, SGLang 및 vLLM에서 day-0 지원과 함께 제공됩니다.
Transformers
최신 버전의 transformers를 설치하세요.
pip install -U "transformers>=5.20.1"
Beam을 실행하는 가장 쉬운 방법은 text-generation 파이프라인입니다:
from transformers import pipeline

pipe = pipeline(
    "text-generation", model="reflectionai/Beam-1.0-501B-A23B", device_map="auto"
)

messages = [
    {"role": "user", "content": "Write a limerick about Python exceptions."}
]
output = pipe(messages, max_new_tokens=2000)
output[0]["generated_text"][-1]
파이프라인은 전체 채팅을 반환합니다. 마지막 메시지는 응답 템플릿에 의해 이미 파싱된 Beam의 답변입니다.
한 단계 더 아래로 내려가서 다음을 사용합니다 AutoModelForCausalLM 그리고 AutoTokenizer.
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "reflectionai/Beam-1.0-501B-A23B"
tokenizer = AutoTokenizer.from_pretrained(model_id)

model = AutoModelForCausalLM.from_pretrained(
    model_id, dtype="auto", device_map="auto"
)
채팅
messages = [
    {"role": "system", "content": "You should only answer with a number."},
    {"role": "user", "content": "What is 17 * 23?"},
]

inputs = tokenizer.apply_chat_template(
    messages,
    add_generation_prompt=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt",
    reasoning_effort="medium" # by default
).to(model.device)

input_len = inputs["input_ids"].shape[-1]

outputs = model.generate(**inputs, max_new_tokens=2000)

tokenizer.parse_response(
    outputs[0][input_len:], prefix=inputs["input_ids"][0]
)
Beam의 토크나이저는 응답 템플릿을 포함하고 있습니다. parse_response 토크나이저가 이를 읽어 원시 출력을 메시지 dict로 변환합니다. 여기서 추론(reasoning), 답변(answer), 툴 호출(tool calls)이 각각 별도의 필드에 담깁니다. 이를 통해 추론과 답변, 툴 호출을 구분하기 위한 일반적인 정규식 처리를 피할 수 있습니다. 그리고 이 규칙들은 토크나이저와 함께 제공되므로, 파싱된 구조가 Beam이 학습을 통해 생성하도록 훈련된 형태와 일치합니다. 챗 템플릿은 어시스턴트 턴(assistant turn)의 일부를 미리 작성할 수 있는데, 파서는 이 부분을 확인해야 합니다.
도구 호출
전체 tool-calling 예제def get_weather(city: str, unit: str = "celsius"):
"""
Get the current weather for a city.
Args:
city: The city to look up.
unit: Temperature unit, "celsius" or "fahrenheit".
"""
...
tools = [get_weather]
messages = [
{"role": "user", "content": "I land in Paris tonight. Do I need a coat?"}
]
inputs = tokenizer.apply_chat_template(
messages,
tools=tools,
add_generation_prompt=True,
tokenize=True,
return_dict=True,
return_tensors="pt",
).to(model.device)
input_len = inputs["input_ids"].shape[-1]
outputs = model.generate(**inputs, max_new_tokens=1000)
message = tokenizer.parse_response(
outputs[0][input_len:], prefix=inputs["input_ids"][0], tools=tools
)
message.get("tool_calls")
Pass tools to parse_response 역시 마찬가지입니다. Beam은 자체 XML 스타일 문법으로 도구 호출 인수(tool-call arguments)를 인라인으로 작성하므로, bare 7 숫자 또는 문자열일 수 있습니다. 도구 스키마를 통해 파서는 각 인수를 선언된 타입으로 캐스팅합니다.
멀티 GPU 및 멀티 노드
Beam의 config는 expert-parallel 플랜을 정의합니다. Expert parallelism은 각 expert를 하나의 디바이스에 배치합니다. Attention, dense 레이어, 임베딩, LM head는 모든 디바이스에 복제됩니다. 이는 8B 파라미터, 즉 BF16 기준 16 GB입니다. 모델을 다음과 함께 로드하세요. DistributedConfig:
import os

from transformers import AutoModelForCausalLM
from transformers.distributed import DistributedConfig

model = AutoModelForCausalLM.from_pretrained(
    "reflection/Beam-1.0-501B-A23B",
    distributed_config=DistributedConfig(
        tp_size=int(os.environ["WORLD_SIZE"]), enable_expert_parallel=True
    ),
)
다음과 같이 스크립트를 실행하십시오: torchrun 16개의 H200 GPU에 걸쳐 분산됩니다. 그러면 각 GPU는 78 GB의 가중치를 담당합니다. GPU가 8개라면 각각 139 GB를 담당해야 하는데, 이는 141 GB H200에는 남는 공간이 없습니다. 장치 수는 전문가 수인 256을 나누어떨어지게 되어야 합니다.
vLLM
Beam은 vLLM에서 day-0 지원을 제공합니다. 아래 명령은 16개 GPU(8x H200 노드 2대)에 걸쳐 텐서 병렬화로 BF16 체크포인트를 서빙하며 OpenAI 호환 API를 노출합니다:
vllm serve reflection/Beam-1.0-501B-A23B --tensor-parallel-size 16 --served-model-name beam
더 빠른 생성을 위해 DFlash2 speculative decoding을 추가하세요. 작은 drafter 모델이 최대 15개 토큰까지 앞서 제안하고, Beam이 이를 한 번의 forward pass로 모두 검사하므로 각 단계에서 여러 토큰을 받아들일 수 있습니다. 비용은 drafter를 위한 약간의 추가 메모리입니다:
vllm serve reflection/Beam-1.0-501B-A23B \
  --tensor-parallel-size 16 \
  --speculative-config '{ "method": "dflash", "model": "reflection/dflash2-drafter-preview", "num_speculative_tokens": 15 }'
두 명령 모두 OpenAI 호환 서버를 시작하므로 OpenAI 클라이언트를 다음 주소로 지정할 수 있습니다 http://localhost:8000/v1. 추가 서빙 구성에 대한 내용은 다음을 참조하십시오: vLLM을 위한 제안된 Beam 레시피.
SGLang
Beam은 SGLang에서도 day-0 지원을 제공합니다. 아래 두 명령 모두에서 활성화되는 DFlash2 추측 디코딩(speculative decoding)으로 서빙할 것을 권장합니다. Blackwell에서는 NVFP4 체크포인트가 4 B300에 들어갑니다:
python -m sglang.launch_server \
--model-path reflection/Beam-1.0-501B-A23B-NVFP4 \
--served-model-name beam \
--tp 4 \
--attention-backend trtllm_mha \
--page-size 64 \
--context-length 1048576 \
--mem-fraction-static 0.85 \
--enable-unified-memory \
--speculative-algorithm DFLASH \
--speculative-draft-model-path reflection/Beam-1.0-501B-A23B-DFlash2 \
--speculative-dflash-block-size 8 \
--tool-call-parser beam --reasoning-parser beam \
--host 0.0.0.0 --port 30000
Hopper GPU에서는 대신 8개의 H200에서 FP8 체크포인트를 사용하세요. 바뀌는 것은 세 가지 플래그뿐입니다: 체크포인트, 텐서 병렬 크기(4 대신 8), 그리고 어텐션 백엔드(Blackwell이 필요한 trtllm_mha 대신 fa3):
python -m sglang.launch_server \
--model-path reflection/Beam-1.0-501B-A23B-FP8 \
--served-model-name beam \
--tp 8 \
--attention-backend fa3 \
--page-size 64 \
--context-length 1048576 \
--mem-fraction-static 0.85 \
--enable-unified-memory \
--speculative-algorithm DFLASH \
--speculative-draft-model-path reflection/Beam-1.0-501B-A23B-DFlash2 \
--speculative-dflash-block-size 8 \
--tool-call-parser beam --reasoning-parser beam \
--host 0.0.0.0 --port 30000
추론 제공자
Beam은 Hugging Face Inference Providers에서 Baseten, Fireworks, Together를 통해 제공되며, 곧 더 많은 제공업체가 추가될 예정입니다.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://router.huggingface.co/v1",
    api_key=os.environ["HF_TOKEN"],
)

completion = client.chat.completions.create(
    model="reflection/Beam-1.0-501B-A23B:auto",
    messages=[{"role": "user", "content": "What is the capital of France?"}],
)

print(completion.choices[0].message)
추론 엔드포인트
Inference Endpoints 카탈로그에서 원클릭으로 배포할 수 있도록 Beam 레시피를 준비해 두었습니다. FP8 또는 NVFP4, 또는 다음으로 설치하세요 hf 다음과 같이 cli를 사용합니다:
hf endpoints catalog deploy --repo reflection/Beam-1.0-501B-A23B --name beam
테스트한 내용
Reflection 플랫폼을 통해 5가지 작업에 대해 Reflection Beam-501B-A23B의 vibe eval을 낮은 추론 노력과 높은 추론 노력으로 각각 한 번씩 공유합니다. 이는 벤치마크가 아닌 vibe eval입니다. Beam을 사용할 계획이라면, 이를 통해 직접 사용해 보고 특정 사용 사례에서 어떻게 동작하는지, 그리고 중요하게는 어떤 부분에서 강하고 약한지 확인할 수 있는 훌륭한 방법입니다.
아래는 우리가 실행한 프롬프트 개요와 허브의 출력 트레이스입니다. 전체 입력, 출력, API 사용량, 작업 fixture, 채점기 및 대화 트레이스는 다음에 있습니다 이 공개 Hugging Face 버킷.
| 카테고리 | 프롬프트 설명 | 낮은 추론 (토큰) | 높은 추론 (토큰) |
|---|---|---|---|
| 다단계 도구 호출 | ORD-742 처리: 재고, 예약, 추가 요금 및 도착 날짜를 비교하고 가장 저렴한 적합 창고를 예약합니다. | ✅ 544 | ✅ 811 |
| 코드 베이스에 대한 긴 컨텍스트 검색 | 세 개의 완전한 소스 파일로부터 Click 명령 구성과 두 개의 호출 결과를 도출하고 6개의 구현 심볼을 인용합니다. | 🔴 1,613 * | ✅ 5,007 |
| 샌드박스에서의 터미널 작업 | CSV 원장 CLI를 점검하고 수리하기; 모든 버그 수정, 테스트 보존, 테스트 실행 및 CLI 점검 수행. | ✅ 582 | ✅ 1,548 |
| 수학 추론 (AIME 스타일) | {1, …, 16}의 여덟 원소 부분집합 중 합이 17로 나누어떨어지는 것은 몇 개인가요? 근거를 제시하세요. | 🟠 829 † | ✅ 2,809 |
| 구조화된 출력 | 순서가 뒤섞인 개정 로그를 엄격한 JSON으로 변환: 패치, 취소, null, 날짜, 통화 및 합계 병합. | ✅ 1,040 | ✅ 2,088 |
* Low의 긴 컨텍스트 응답은 모든 코드 동작과 여섯 개의 출처 인용을 모두 정확히 맞혔습니다. 그러나 응답이 파서 형식에 부합하지 않았기 때문에, 이는 부분적으로 프롬프트의 모호성 탓입니다.
† Low는 정답을 반환했지만 요청된 근거를 생략했습니다. High는 독립적으로 검토된 올바른 단위근(root of unity) 증명을 제공했습니다.
우리 말만 믿지 마세요. 자세히 살펴보세요: bucket, 여러분의 사용 사례나 프로젝트에 맞게 재작성하고 Beam을 한계까지 밀어붙이세요.
Beam 사후 학습
여러분의 사용 사례에 맞게 Beam을 파인 튜닝할 수 있습니다. 여기서는 지도 파인 튜닝과 강화 학습을 시작하는 데 도움이 되는 TRL과 Miles의 예제 몇 가지를 공유합니다.
TRL로 SFT
Beam을 여러분의 데이터에 맞추는 가장 빠른 방법은 TRL의 SFTTrainer를 사용한 지도 파인 튜닝입니다. 메모리를 관리 가능한 수준으로 유지하기 위해, 전체 501B 파라미터를 업데이트하는 대신 PEFT로 LoRA 어댑터를 학습합니다:
우리는 TRL의 SFTTrainer 을(를) 사용하여 Beam을 간단한 목표, 즉 사용자가 요청한 언어로 추론을 유지하도록 적응시켰습니다. 우리는 다음 데이터로 파인 튜닝했습니다: Multilingual-Thinking , LoRA를 사용하며, 이는 기본 모델을 동결한 상태에서 소규모 어댑터 가중치 집합을 학습합니다.
이 설정은 로드 시점의 모델 샤딩, 전문가 병렬화, FlashAttention 4 및 시퀀스 패킹을 결합합니다. LoRA SFT는 8개의 B300 GPU가 있는 단일 노드에서 실행 가능하며, 초당 약 19,000 토큰에 도달합니다. 이에 해당하는 H100 설정은 4개의 노드를 사용합니다.
Multilingual-Thinking 1 에포크 학습 후, Beam은 보류된 16개 프롬프트 중 16개에서 요청된 언어로 추론했으며, 기본 모델은 16개 중 3개에 그쳤습니다. 이 소규모 평가는 추론 자체의 정확성이 아니라 언어 준수성을 측정합니다.
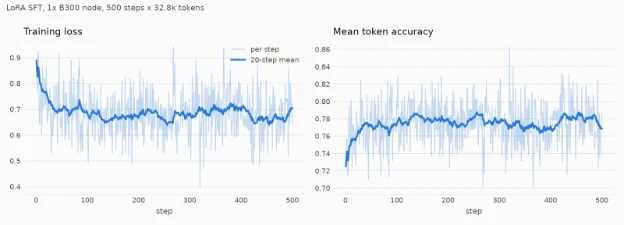
open-r1/Mixture-of-Thought의 추론 하위 집합에 대해 8-GPU B300 노드 한 대로 진행한 별도의 500스텝 실행 중 학습 손실(왼쪽)과 평균 토큰 정확도(오른쪽). 이 학습 지표는 공식 TRL 예제 PR.
Miles로 GRPO
Reflection과 RadixArk는 Miles에서 BF16으로 GRPO를 사용해 모델을 학습시키는 레시피를 구축했습니다. 전체 모델을 업데이트하거나, 기본 가중치를 동결한 상태에서 LoRA로 어댑터를 학습시킬 수 있습니다. Megatron이 학습을 수행하고, SGLang이 롤아웃을 생성하며, Miles가 각 업데이트 후 새 가중치를 롤아웃 엔진에 게시합니다. 우리는 이 레시피를 검토했습니다.
| 워크로드 | 참조 구성 |
|---|---|
| 추론 / 평가, BF16 | 엔진당 16x H200 |
| 전체 파라미터 GRPO, BF16 (Miles) | 96x H200: 학습 64, 롤아웃 32. 또는 64x H200 colocated. |
| LoRA GRPO, BF16 (Miles) | 32x H200: 학습 16, 롤아웃 16. |
| 전체 파라미터 GRPO, BF16, 128토큰 컨텍스트 (Miles) | 48x H200: 훈련 32, 롤아웃 16. 이 구성은 실제 체크포인트에서 Reflection과 RadixArk가 먼저 검증했습니다. |
이 레시피는 DAPO-Math-17K에서 GRPO를 실행하고 AIME25에서 평가합니다. 이미지를 빌드하고, 데이터를 다운로드한 뒤, 8x H200 노드 열두 대로 구성된 Ray 클러스터에 작업을 제출하세요:
docker build -f docker/Dockerfile.beam -t miles-beam .

python scripts/run_beam.py prepare \
  --model-id reflection/Beam-1.0-501B-A23B \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets

export MASTER_ADDR=10.0.0.1
export RAY_ADDRESS=http://${MASTER_ADDR}:8265

python scripts/run_beam.py execute \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets \
  --output-dir /root/shared_data/beam-run \
  --num-rollout 100
롤아웃에서 일어나는 일:
샘플: 32개의 프롬프트가 모델에 전달되며 각 프롬프트마다 8개의 응답을 생성합니다. 두 개의 SGLang 엔진이 각각 16개의 GPU에서 롤아웃을 처리합니다.
점수: 박스로 묶인 답안을 정답 라벨과 대조하여 확인하고, 길이 제한에 가까운 응답에는 소프트 페널티를 부과합니다.
업데이트: 256개 샘플 전체에 대해 옵티마이저 스텝을 한 번 수행합니다. 절단된 중요도 샘플링(truncated importance sampling)을 적용한 그룹 상대 어드밴티지를 사용하며, KL 또는 엔트로피 페널티는 없습니다.
병렬로 학습: 텐서 병렬성 8, 전문가 병렬성 8, 데이터 병렬성 8, 그리고 시퀀스 병렬성과 전체 재계산을 적용했습니다.
최적화기: Adam을 일정한 1e-6으로 사용합니다. 그래디언트는 BF16, 마스터 웨이트는 FP32, 모멘트는 BF16입니다. 옵티마이저 상태는 노드 로컬 NVMe를 통해 스트리밍되므로 각 트레이너 노드에 2 TB의 스크래치 공간이 필요합니다.
평가: AIME25은 5번의 롤아웃마다, 문제당 8개의 샘플입니다. 체크포인트는 20번마다 저장됩니다.
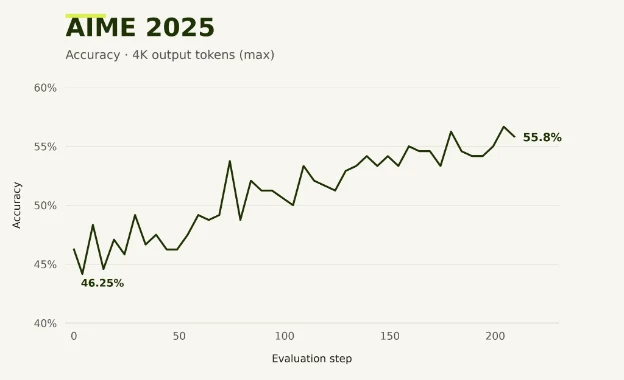
다음 롤아웃은 현재 롤아웃이 학습되는 동안 생성되므로, 응답은 한 단계 뒤쳐진 업데이트를 반영합니다. Add --resume 마지막 체크포인트에서 계속합니다. execute-colocate 8개 노드에서 동일한 레시피를 실행하며, 모든 GPU가 번갈아 학습과 서빙을 수행합니다.
LoRA로 학습하기
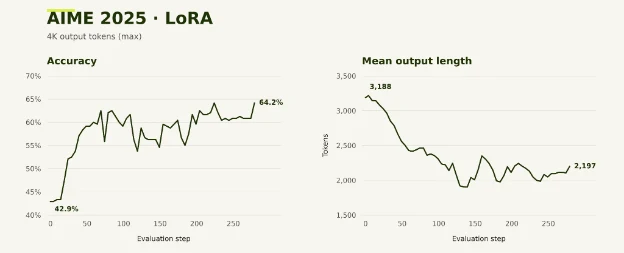
네 개의 8× H200 노드에서도 LoRA로 GRPO를 실행할 수 있습니다: 훈련용 GPU 16개와 롤아웃용 GPU 16개입니다. 이 레시피는 기본 가중치를 동결한 상태에서 Beam의 attention, dense MLP, expert 레이어에 대해 rank-16 어댑터를 훈련합니다. SGLang과는 어댑터 가중치만 동기화되며, 옵티마이저 상태는 GPU 메모리에 유지되므로 NVMe 옵티마이저 오프로딩이 필요 없습니다.
python scripts/run_beam_lora.py execute \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets \
  --output-dir /root/shared_data/beam-run \
  --num-rollout 100
Beam으로 빌드하기: 데모
Beam으로 무언가를 만들었다면, $10,000을 받을 기회를 잡기 위해 Hub에 공유해 보세요. 스페이스, 모델 또는 데이터셋 저장소를 만들어 공유하기만 하면 됩니다. 모델의 저장소 페이지. 여러분에게 영감을 주기 위해, 우리가 만든 몇 가지 사례를 소개합니다.
이봐 Beam, 네이티브 로컬 MacOS 애플리케이션을 만들어 줘!
Hugging Face에서는 하드웨어에 기본으로 실행되는 오픈 및 로컬 모델을 사랑하지만, Mac에서 네이티브 앱을 만드는 것은 어려울 수 있습니다! Beam이 우리를 도와줄 수 있는지 살펴보겠습니다.
우리는 Beam에게 음성을 텍스트로 변환하고 편리하게 커서 위치에 넣어주는 네이티브 MacOS 애플리케이션을 만들어 달라고 요청했습니다. 우리는 MLX를 사용해 Mac Metal의 성능을 최대한 끌어내고, 훌륭한 음성-텍스트 변환을 위해 Parakeet 모델을 사용하고자 합니다.
Build BeamSpeak, a native macOS menu bar dictation app with a compact recording pill and no main window or account.

Use ⌘⇧Space to start and stop microphone recording, showing elapsed time, microphone level, and transcription status. Run speech recognition entirely locally using a Hugging Face model, preferably Parakeet v3 through MLX, and keep the model loaded between recordings. Paste the transcript into the original app if it remains focused and Accessibility permission is granted; otherwise copy it to the clipboard, preserving newer clipboard changes and never pressing Enter. Handle permissions, cancellation, silence, errors, a two-minute recording limit, and temporary audio cleanup. Deliver source code, a runnable BeamSpeak.app, setup instructions, and verification of offline transcription, the physical shortcut, microphone capture, and text delivery.
우리는 Pi 코딩 하네스와 함께 Beam을 사용하여 MLX로 Parakeet을 구동하는 초기 네이티브 macOS 메뉴 바 앱을 제작했습니다. 저장된 실행 기록에는 후속 프롬프트들이 포함되어 있으며, 최종 소스에는 이후의 Codex 수정 사항도 포함되어 있습니다. 위의 프롬프트는 빌드 요구 사항을 요약한 버전입니다.
Beam이 이것을 pi in에서 어떻게 구축했는지에 대한 에이전트 트레이스를 확인하실 수 있습니다. 이 트레이스를 사용하려면 데모를 체험해 보고 싶다면 다음을 다운로드하십시오: 소스 코드 또는 다음을 읽거나 설치 지침.
안녕 Beam, 여러 에이전트로 확장하려면 어떻게 하나요?
우리는 프로그래밍 작업을 여러 에이전트에 분산하면 Beam이 더 빠른 진전을 이룰 수 있는지 알아보고자 했습니다. Beam을 오픈소스 Pi 코딩 에이전트와 결합하여 세 가지 구성을 비교했습니다: 1. 혼자 작업하는 단일 에이전트, 2. 공유 Git 저장소를 통해 협업하는 5개의 지속적인 피어, 3. 비동기 서브에이전트에게 작업을 위임하는 리드 에이전트. 이 하네스는 Hugging Face jobs에서 실행되었으며 추론은 Reflection의 플랫폼 API를 통해 수행되었습니다.
과제에는 ProgramBench를 사용했습니다. 에이전트는 소스 코드나 평가자의 테스트를 보지 않은 채, 컴파일된 실행 파일과 문서로부터 프로그램을 재현해야 합니다. 각 설정은 동일한 8M API 토큰 상한과 작업당 2시간 솔버 제한을 두었으며, 이는 해당 설정의 에이전트들이 공유했습니다. 우리는 구현 스냅샷을 저장했고, 다음의 고정된 비공개 테스트 스위트를 기준으로 평가했습니다. ProgramBench-Tests 데이터셋.
우리의 점수 대 지연 시간(score-versus-latency) 플롯 통과한 테스트의 평균 비율을 보여줍니다. 시간 축은 경과된 실제 시간이 아니라 모델 토큰에 대한 고정 기준 요율과 측정된 도구 시간을 사용합니다. 우리는 처음에 다섯 가지 작업을 실행했습니다. 현재 그림은 jq, xsv, FIGlet, hexyl의 사후 분석 부분 집합을 보여줍니다. ripgrep은 저장된 아티팩트를 채점하는 것이 너무 느려서 세 가지 설정 모두에서 제외되었습니다. 공개된 결과에는 원래의 15개 에피소드가 모두 유지되어 있습니다.
에서 실행 결과를 살펴보고, Trackio 대시보드, 게시된 결과 데이터를 탐색하며, 공개된 결과 데이터, 스터디 하네스를 재사용할 수 있습니다. 스터디 하네스.
Hey Beam, 내 코드베이스를 위한 의사결정 모델을 파인튜닝해 줘!
의사결정 모델은 매우 빠르고 다양한 사용 사례에 실용적이어서 요즘 큰 인기를 얻고 있습니다. 우리는 Beam으로 시작했고, Beam의 쿼터가 소진된 후에는 Pi에서 GLM-5.3으로 이어져 개발자 인시던트 트리아지를 위한 맞춤형 의사결정 모델을 학습하고 평가했습니다.
우리는 코딩 에이전트가 인시던트 트리아지 정책을 작고 빠른 의사결정 모델로 변환할 수 있는지 확인하고자 했습니다. 과제는 개발자 인시던트를 읽고 담당 팀, 심각도, 그리고 즉시 누군가를 호출해야 하는지 여부를 선택하는 것이었습니다. Unsloth를 사용하여 Qwen3.5-0.8B를 파인튜닝해 이러한 선택을 직접 채점하도록 했습니다.
먼저, 이 워크플로는 학습, 보정(calibration), 테스트용으로 사고 클러스터별로 나뉜 2.3k 건의 사고를 포함하는 합성 데이터셋을 구축했습니다. Science Slurm 클러스터의 H100 80GB 한 대에서 4비트 백본으로 LoRA 어댑터와 결정 헤드(decision head)를 3에포크 동안 학습시켰습니다.
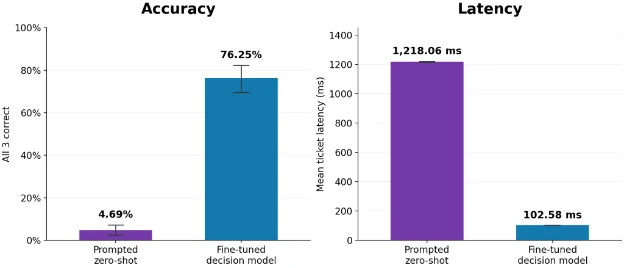
기준선으로서, 예시 없이 전체 트리아지 정책과 티켓을 적응되지 않은 모델에 입력하고 세 가지 결정을 JSON으로 생성하도록 요청했습니다. 동일한 320개의 합성 테스트 티켓에서 파인튜닝된 의사결정 모델은 세 가지 답을 모두 76.25%의 사례에서 정확히 맞췄는데, 반면 프롬프트 기반 제로샷은 4.69%에 그쳤습니다. 평균 티켓 지연 시간은 1,218.06 ms에서 102.58 ms로 감소하여 11.9배의 속도 향상을 보였습니다.
이 실험을 직접 해보고 싶다면 다음을 확인해 보세요. 아티팩트 버킷 데이터, 코드, 체크포인트 및 결과가 포함되어 있는 자료입니다.
마무리
Beam은 자신의 하드웨어에서 직접 실행하고 변경할 수 있는 501B 오픈 모델입니다. 다음으로 시작해 보세요: BF16 체크포인트를 사용하거나 양자 중 하나를 시도해 보세요 FP8, NVFP4. Beam으로 무언가를 만들었다면 다음에 공유해 주세요: 토론 탭.