
TL;DR: Reflection의 Beam은 토큰당 23B의 활성 파라미터를 가진 501B 파라미터 MoE 모델입니다. vLLM은 0일 차부터 이를 지원하며 NVIDIA Blackwell에서 최적화합니다:
- 전체 기능 지원. 추론, 도구 호출, 구조화된 출력이 기본적으로 작동하며, 텐서, 데이터 또는 전문가 병렬 처리로 모델을 실행할 수 있습니다.
- 에이전트 기반 최적화. 코딩 에이전트가 자율적으로 모델을 최적화하여, 첫 구현 대비 batch-1 디코드를 2.71×, prefill을 1.87× 빠르게 만들었습니다.
- 적응형 검증을 갖춘 DFlash2. Beam의 DFlash2 drafter를 사용하면 TP8에서 단일 요청이 708 tokens/s TP8에서 수용 길이(acceptance length)는 3.7입니다. 각 단계에서 몇 개의 draft 토큰을 검증할 가치가 있는지 결정하는 적응형 검증은 추가합니다 10% 더 높은 처리량 을 추가합니다.
사용해 보려면 저희 Docker 이미지를 이용하세요 vllm/vllm-openai:reflection-beam:
docker run --gpus all --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai:reflection-beam \
  reflection/Beam-1.0-501B-A23B-NVFP4 \
  -tp 4 \
  --max-num-seqs 128 \
  --reasoning-parser beam \
  --tool-call-parser beam --enable-auto-tool-choice \
  --kv-cache-dtype fp8 \
  --attention-config '{"backend":"FLASHINFER"}' \
  --kernel-config '{"enable_flashinfer_autotune":false}' \
  --speculative-config '{
    "method": "dflash",
    "model": "reflection/Beam-1.0-501B-A23B-DFlash2",
    "num_speculative_tokens": 7,
    "attention_backend": "FLASH_ATTN"
  }'
모델 아키텍처
Beam은 hidden size 5120을 갖는 52레이어 MoE 디코더입니다. MoE 라우팅은 DeepSeek-V3를 따릅니다. 주요 차이점은 attention 레이어와 residual stream의 정규화 방식에 있습니다.
그림 1: Beam의 레이어 스택과 하나의 sparse 디코더 레이어. 금색 표시는 표준 pre-norm MoE와 다른 부분입니다. 전체 화면으로 열기.
Attention
- 하이브리드 sliding-window 및 NoPE 레이어. 43개 레이어는 RoPE와 함께 마지막 512개 토큰에 대한 sliding-window attention을 사용합니다. 나머지 9개 레이어(여섯 번째마다 하나씩, 그리고 마지막 레이어)는 전체 컨텍스트에 대해 위치 인코딩 없음(NoPE).
- NoPE 레이어의 SSMax. RoPE가 없으면 키 수가 늘어남에 따라 attention이 평평해집니다. SSMax는 각 쿼리를
(1 + p/2048)^0.1로 스케일링합니다. 여기서p는 1부터 시작하는 위치이며, 이를 통해 컨텍스트가 커질수록 softmax가 날카로워집니다. - 헤드별 Q/K norm을 갖춘 GQA. 48개 쿼리 헤드, 8개 KV 헤드, 헤드 차원 128. Q와 K는 RoPE 또는 SSMax 이전에 헤드별로 RMS 정규화됩니다.
- 시그모이드 출력 게이트. Before
o_proj, 각 헤드의 출력은 σ(gate + bias)를 곱해지며, 게이트는 학습된 헤드별 바이어스가 적용된 자체 전체 폭 프로젝션에서 나옵니다. 각 헤드는 토큰별로 줄이거나 끌 수 있습니다. - 작은 KV 캐시. 9개의 full-attention 레이어만이 전체 시퀀스에 대해 KV를 유지합니다:
- 토큰당 9 × 2 × 8 × 128개의 값으로, BF16에서는 36 KiB, FP8에서는 18 KiB입니다.
- 샤딩 이전 기준, 1M 토큰 전체 컨텍스트에 대해 약 18 GiB의 FP8 KV가 필요합니다.
MoE와 잔차 스트림(residual stream)
- DeepSeek-V3 스타일의 MoE. 256개의 라우팅 전문가(d_ff 2,560, NVFP4)는 DeepSeek-V3와 동일한 방식으로 라우팅됩니다: 시그모이드 점수와 보정 바이어스로 8개 전문가 그룹 중 최고의 4개를 선택한 다음, 상위 8개 전문가를 고르고, 재정규화된 가중치에 2.5를 곱해 스케일링합니다. DeepSeek-V3와 달리 공유 전문가는 없습니다. 0–2층은 대신 밀집 SwiGLU MLP(d_ff 20,480)를 사용합니다.
- FP32 라우터. 5120 × 256 라우터 가중치, 누적값, 로짓은 모두 FP32입니다.
- 샌드위치 관례. 각 서브레이어 앞에는 RMSNorm이 하나 있고 뒤에도 하나가 있습니다.
- 깊이에 따라 크기가 조정된 잔차. The n-번째 잔차 덧셈은 계산한다
h ← √((n−1)/n)·h + x/√n대신에h + x하위 계층 출력이 단위 분산을 가지면 잔차 스트림은 깊이에 따라 커지는 대신 모든 깊이에서 단위 분산을 유지합니다.
에이전트 기반 최적화
초기 구현 버전은 최적화되지 않은, 거의 순수한 PyTorch 버전의 모델이었습니다. 이후 코딩 에이전트를 통해 자율적으로 최적화를 진행했습니다. 에이전트들은 모델을 프로파일링하고, 커널을 작성하며, 각 변경 사항을 벤치마크했습니다. TP8 환경에서 아래 일곱 가지 변경 사항을 통해 batch-1 디코드가 스텝당 8.95 ms에서 3.30 ms로, 8 × 2K 프리필은 328 ms에서 176 ms로 개선되었습니다.
그림 2: 각 변경 후 GB200에서의 TP8 모델 포워드 지연 시간. 배치 1 디코드 및 ~100K 컨텍스트에서 8 × 2,048토큰 프리필 기준입니다. 두 패널은 서로 다른 스케일을 사용합니다. 정확한 값은 표를 참조하거나 전체 화면으로 여세요.
- Fused norm → residual → norm (디코드 −40%). 104개 서브레이어 경계 각각에서 포스트-노름, 스케일된 잔차 합산, 그리고 다음 프리-노름이 이제 FP32 연산과 참조 구현의 BF16 반올림 지점을 유지한 채 하나의 Triton 커널로 실행됩니다.
- 융합된 Q/K 노름, RoPE/SSMax, 그리고 출력 게이트. 헤드별 Q/K RMSNorm과 RoPE(또는 SSMax)가 하나의 커널로 실행되고, 시그모이드 게이트는 또 다른 커널로 실행됩니다.
- 노름에 all-reduce가 융합됨. 각 레이어의 두 개의 TP all-reduce가 FlashInfer의 멀티캐스트 all-reduce를 기반으로 하는 노름 커널 내부에서 실행됩니다. MoE 이후에는 동일한 커널이 top-8 전문가 출력을 결합합니다.
- FP32 라우터를 위한 특화 GEMM 커널. 라우터는 이전에는 범용 경로로 폴백되었습니다. 이제 vLLM의 소규모 배치 FP32 라우터 커널이 Beam의 5120 × 256 형상을 지원하여 FP32 가중치, 누적 및 로짓을 유지합니다.
- 저지연 GEMM으로 병합된 QKV + 게이트 프로젝션. Q, K, V, 게이트 가중치가 로드 시점에 하나의 행렬로 패킹되므로 네 개의 프로젝션이 하나의 GEMM으로 실행됩니다. 소규모 배치의 경우 저지연 CuTe DSL GEMM 또는 FlashInfer의 TinyGEMM을 사용합니다.
- Fused KV-캐시 업데이트. Q/K norm 및 RoPE 커널이 이제 K와 V를 KV 캐시에 함께 기록하므로 별도의 캐시-쓰기 커널이 필요 없습니다.
- 단일 커널로 처리하는 Dense-MLP 활성화 3개의 dense 레이어를 위해.
융합된 그래프
이러한 변경 후, 하나의 MoE 레이어는 batch-1 decode, TP8에서 13개 커널 TP8에서 배치-1 디코드 시.
그림 3: batch-1 TP8 decode의 rank-0 트레이스에서 가져온, 하나의 MoE 레이어에 대한 실행 순서별 커널. 금색 커널은 Beam을 위해 작성, 융합 또는 확장되었습니다. 각 커널은 계산하는 연산을 나열합니다. 전체 화면으로 열기.
- 6개 커널은 Beam을 위해 작성, 융합 또는 확장되었습니다. 모든 작은 Beam 전용 연산은 이웃 커널에 병합되었으며, 두 all-reduce는 모두 norm 커널 내부에 포함됩니다.
- 7개 커널은 라이브러리에서 제공됩니다: TRTLLM-gen attention, cuBLAS 출력 프로젝션, 그리고 TRTLLM NVFP4 MoE 경로(양자화, 두 개의 라우팅 커널, 두 개의 grouped GEMM)입니다. 남은 시간 대부분이 여기에 있으므로, 다음 작업 대상입니다.
Attention DP + MegaMoE
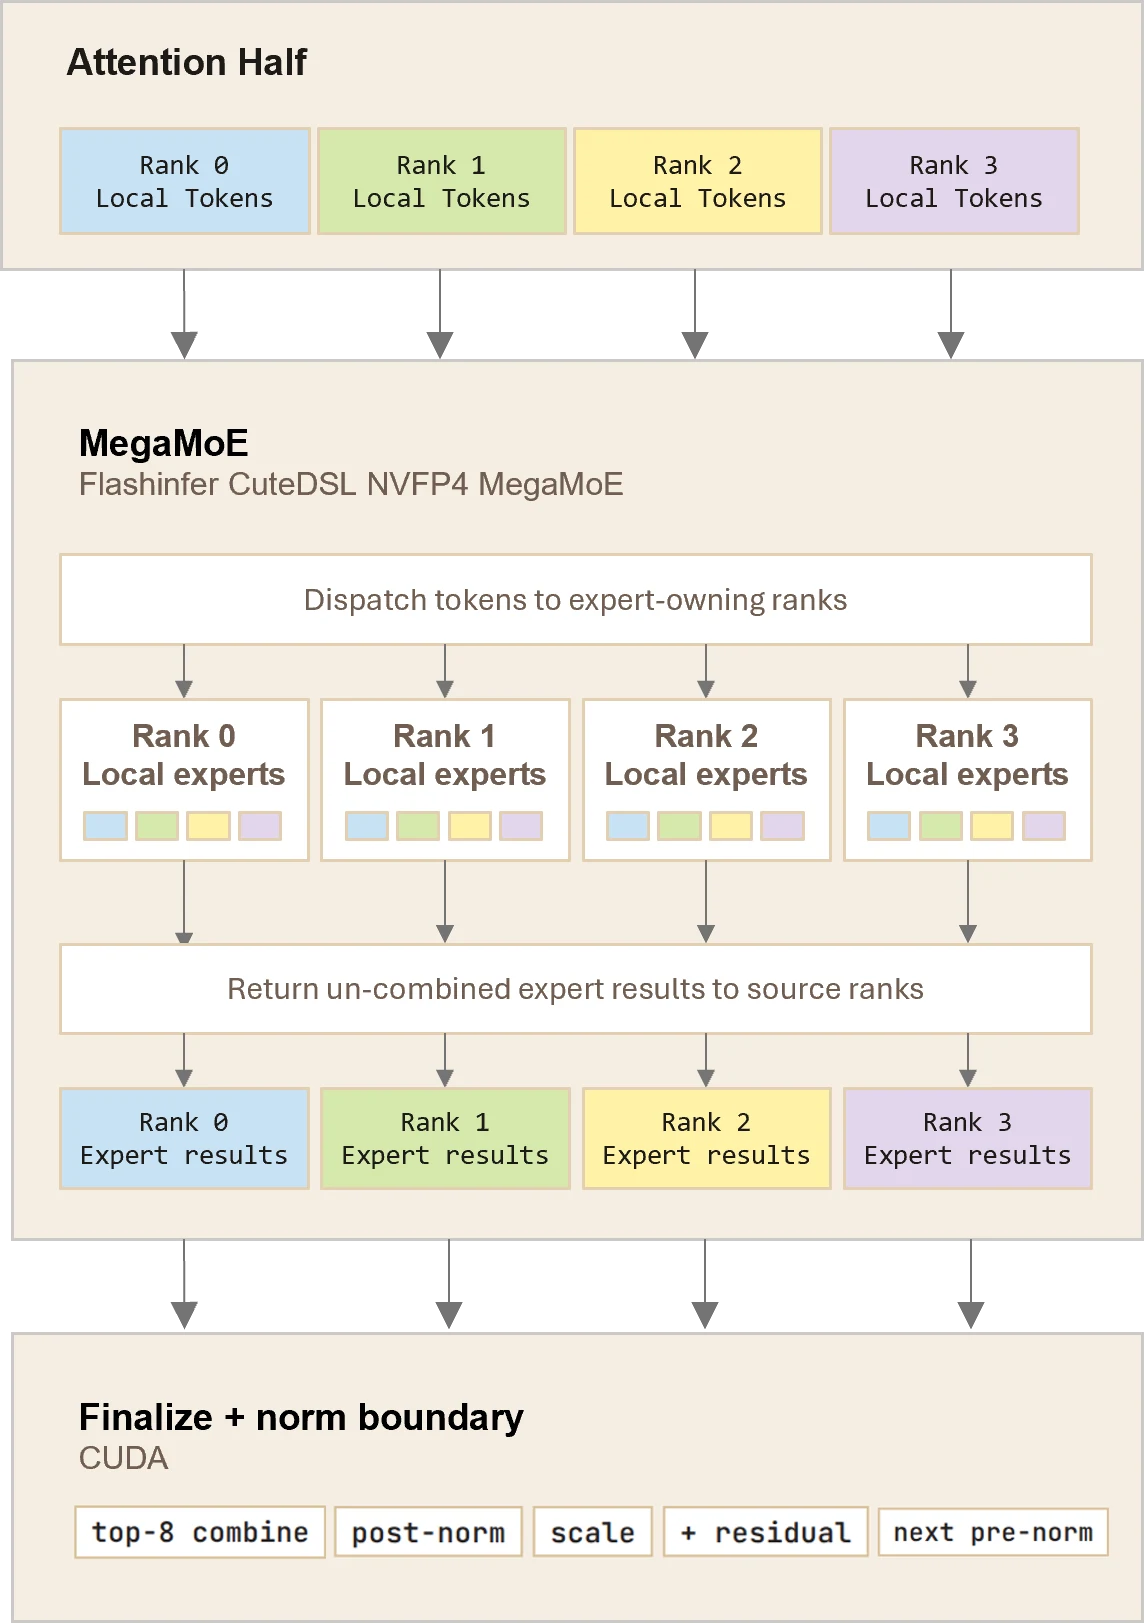
그림 4: FlashInfer CuteDSL NVFP4 MegaMoE는 통신을 전문가 계산과 융합할 수 있습니다.
높은 동시성 영역에서, FlashInfer의 CuTe DSL NVFP4 MegaMoE 커널로 구동되는 MegaMoE와 Attention DP를 결합하여 Beam의 성능을 더욱 향상시킬 수 있습니다. Finalize + norm 경계 융합은 여전히 적용 가능합니다.
| 구성 | 최대 입력 토큰 처리량 |
|---|---|
| Attention DP + MegaMoE | 초당 168.8K 토큰 |
TP (flashinfer_trtllm, flashinfer_nvlink_one_sided) | 초당 98.7K 토큰 |
MegaMoE가 적용된 Attention DP는 TP4보다 1.71배 높은 최대 프리필 처리량을 제공했습니다. 벤치마크 구성: 4×GB300, 입력 시퀀스 길이 32K 토큰, 출력 시퀀스 길이 1 토큰으로 프리필 성능을 분리 측정했습니다.
Attention DP + MegaMoE를 활성화하려면 MoE 및 병렬화 설정을 다음으로 교체하십시오:
  --moe-backend flashinfer_moe_ep_cutedsl \
  --data-parallel-size 4 \
  --enable-expert-parallel
DFlash2 추측 디코딩
Beam은 DFlash2 draft head은 vLLM이 day 0부터 지원하는 기능입니다. 한 번에 하나의 토큰을 드래프트하는 대신, 대상 모델의 hidden states에서 단일 forward pass로 토큰 블록 전체를 예측합니다.
- 드래프터. 대상 레이어 5개에서 은닉 상태를 읽어들이고 대상의 임베딩과 LM 헤드를 공유하는 5개의 슬라이딩-윈도우 레이어. grouped 컨볼루션과 작은 후보 선택기는 병렬 드래프터가 잃는 좌에서 우로의 의존성을 일부 복원합니다.
- 적응형 검증. With
"enable_adaptive_verification": true, vLLM은 각 draft 토큰이 accept될 가능성을 예측하고 비용 대비 가치가 있는 토큰만 검증하며, 단계당 고정된 개수를 검증하지 않습니다. DFlash2는 confidence head가 없으므로, accept 추정치는 drafter 자신의 logits에서 나옵니다(관련 내용은 저희의 adaptive verification에 관한 최근 포스트). - Kernels. Drafter의 convolution, norm, KV 쓰기는 융합되었고, 전체 draft 단계는 CUDA graph로 실행됩니다. FP8 KV cache는 drafter에서도 accept율 변화 없이 작동합니다.
TP8에서 adaptive verification 사용 여부에 따른 serving 결과이며, 다음의 low-entropy 카테고리 기준입니다: SPEED-Bench의 throughput_1k split: 약 1K 토큰 프롬프트, 대부분 코드 완성과 텍스트 정렬, greedy decoding 및 최대 4K 출력 토큰. Low-entropy 텍스트는 예측이 쉬우므로, 개방형 채팅에서는 accept율이 더 낮을 것으로 예상하세요.
| 동시성 | 고정 draft (tok/s) | Adaptive (tok/s) | 변화 | Acceptance length |
|---|---|---|---|---|
| 1 | 708 | 707 | −0.1% | 3.71 → 3.61 |
| 8 | 3,232 | 3,221 | −0.3% | 3.67 → 3.57 |
| 32 | 7,744 | 8,275 | +6.9% | 3.68 → 3.29 |
| 128 | 15,012 | 16,632 | +10.8% | 3.68 → 3.23 |
Adaptive verification는 부하가 걸릴 때 효과를 발휘합니다. 동시성 128에서 출력 처리량을 10.8% 향상시키고 p99 TPOT을 9% 단축하며, 단계당 검증하는 draft 토큰 수가 줄어들어 acceptance length가 약간 감소하지만 잃는 것보다 더 많은 연산을 절약합니다. 추가 draft 토큰이 거의 무료인 낮은 동시성에서는 중립적입니다.
시작하기
이 포스트 상단의 명령어가 좋은 기본값입니다: 단일 GB300 노드에서 TP4, DFlash2 및 FP8 KV cache 사용. Adaptive verification를 활성화하려면 "enable_adaptive_verification": true 를 --speculative-config에 추가하세요. 위의 다른 최적화들은 기본적으로 활성화되어 있습니다.
- 병렬 설정 선택.
- 가장 낮은 지연 시간을 위해서는 TP4 또는 TP8을 사용하십시오.
- 더 높은 처리량을 위해 전문가 병렬화와 함께 데이터 병렬 어텐션을 사용하십시오. 예를 들어:
-dp 4 --enable-expert-parallel.
- 추론 및 도구 호출. 그
beam파서는 체크포인트와 함께 제공되는 응답 템플릿을 읽습니다. 기본적으로 vLLM은 모든 응답을 해당 템플릿으로 제한하므로, 도구 호출은 항상 파싱되어 각 도구의 JSON 스키마와 일치합니다.response_format및thinking_token_budget평소와 같이 작동합니다. 기본 제약 조건을 끄려면 다음을 설정하십시오.VLLM_BEAM_ALWAYS_CONSTRAIN_OUTPUT=0.
SkyRL을 통한 RL의 Day 0 지원
또한 SkyRL 팀과 협력하여 Beam에서 RL을 위한 Day 0 지원을 실현했습니다. LoRA, BF16 full fine-tuning 및 MXFP8 RL을 기본으로 지원하며, 500B 규모를 위한 업그레이드된 RL 스택을 갖추고 있습니다.
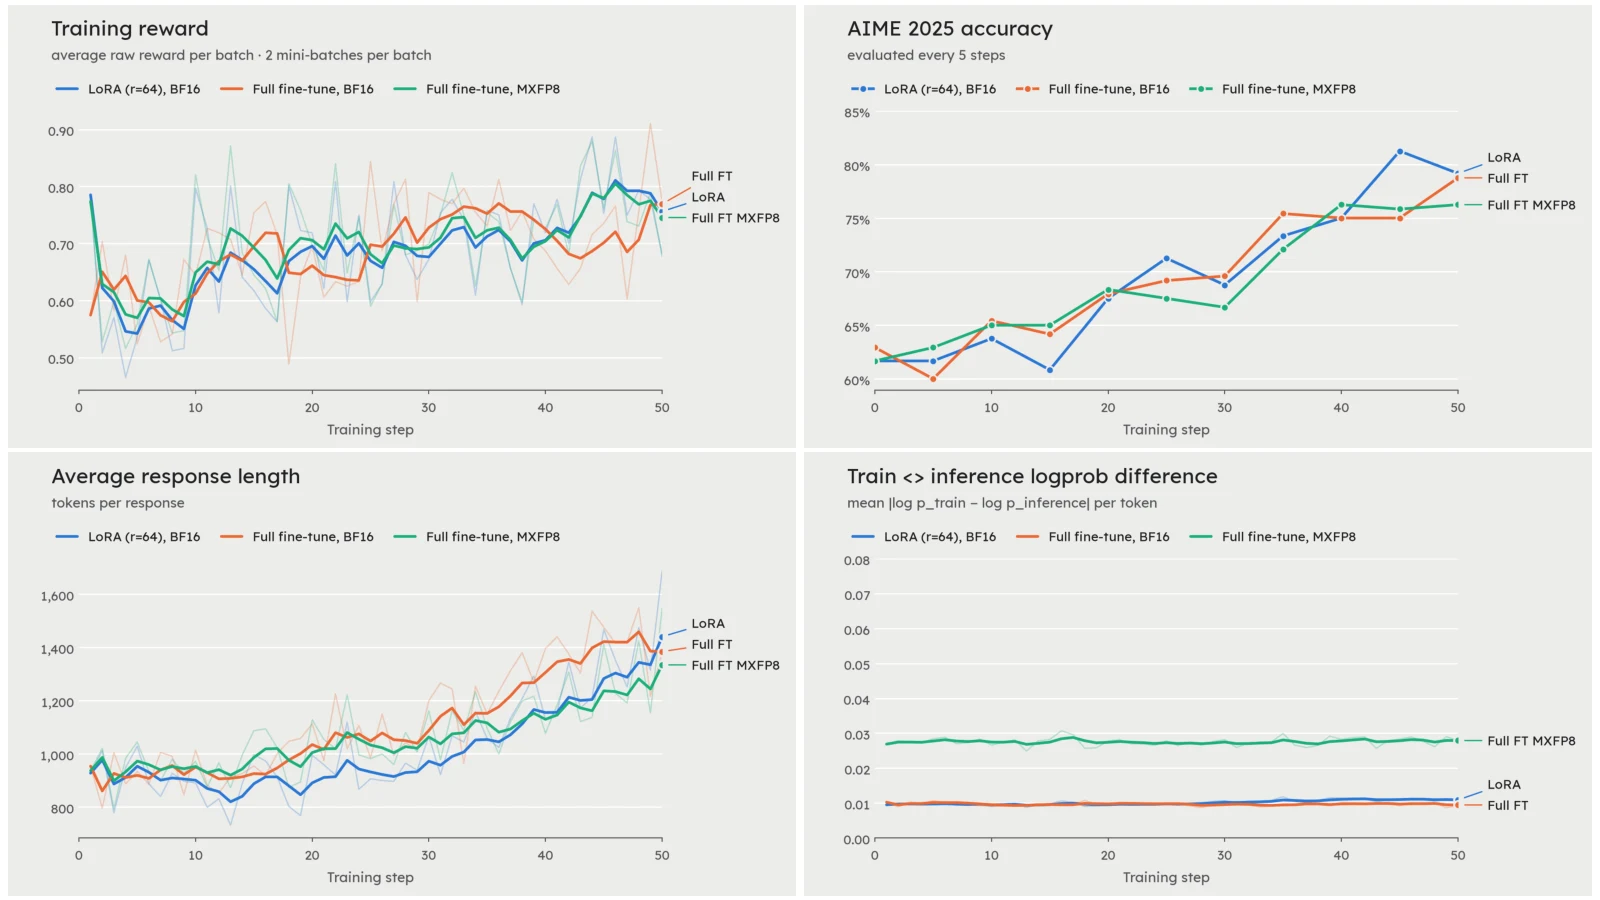
SkyRL 팀은 추론에는 vLLM을, 학습에는 Megatron을 사용하여 DAPO 레시피로 Beam 모델을 포스트트레이닝했습니다. LoRA, full fine-tuning 및 MXFP8 RL은 50번의 학습 스텝, 즉 100번의 옵티마이저 업데이트 만에 유사한 성능 향상을 달성했으며(추론 minimal), AIME25에서 평균 정확도(avg@8)가 약 61%에서 약 79%로 상승했습니다. LoRA 및 BF16 full fine-tuning에 Rollout Routing Replay(R3)를 활성화한 경우 Megatron과 vLLM 간의 평균 절대 로그확률 차이는 0.01 미만을 유지했으며, MXFP8 RL의 경우 0.03 미만이었습니다.
자세한 내용은 SkyRL 블로그 를 확인하세요!
감사의 말
이 작업은 Inferact, Reflection, Nvidia 팀 간의 긴밀한 협력으로 이루어졌습니다:
- Inferact: Woosuk Kwon, Ziqi Zhao, Ao Shen, Tiezhen Wang
- Reflection: 카이싱 우(Kaixing Wu), 요니 고즐란(Yoni Gozlan), 닐 골라푸디(Neil Gollapudi), 티보 바르로예(Thibaut Barroyer), 아이멘 칼랄라(Aymen Kallala), 마티아스 레소(Matthias Reso), 플로랑 그벨리지(Florent Gbelidji)
- Nvidia: Siyuan Fu