

구글의 Gemini 4 Argon은 몇 달 전에 나온 구글 모델보다 AI의 최전선에 더 가까워졌습니다.
 마티아스 바스티안
의 링크드인 프로필을 보기
Oct 16, 2026
 Google
구글 딥마인드는 ARC-AGI-3 벤치마크에서 95퍼센트를 달성한 두 번째 주요 AI 연구소입니다. 하지만 이 결과는 테스트 방법에 크게 의존하며, 에폭 AI에 따르면 아르곤은 수학과 소프트웨어 공학 분야에서 경쟁자들을 앞서고 있습니다.
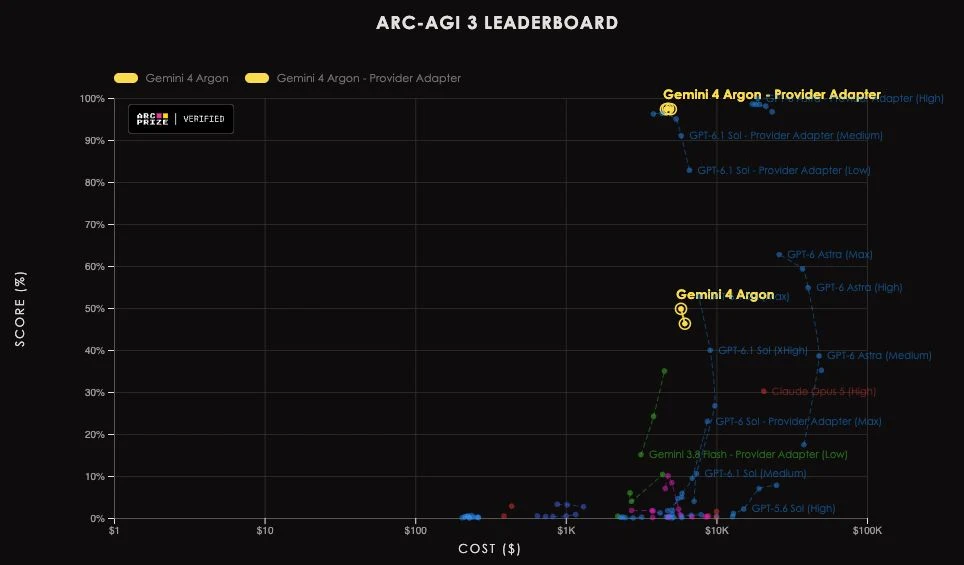
Google Deepmind의 새로운 프론티어 모델인 Gemini 4 Argon은 “Provider Adapter Harness”라는 테스트 설정과 함께 $4,800의 비용으로 ARC-AGI-3 시험에서 97.5%의 점수를 얻었습니다. 이 테스트 설정은 보유된 추론 능력과 컨텍스트 압축과 같은 공급업체 고유 기능을 활용합니다. ARC Prize에 따르면, Google는 일반적인 문제 해결에 있어 가장 어려운 벤치마크에서 95%를 달성한 두 번째 AI 연구소가 되었습니다. GPT-6 Astra만이 99.9%의 점수를 기록했습니다.
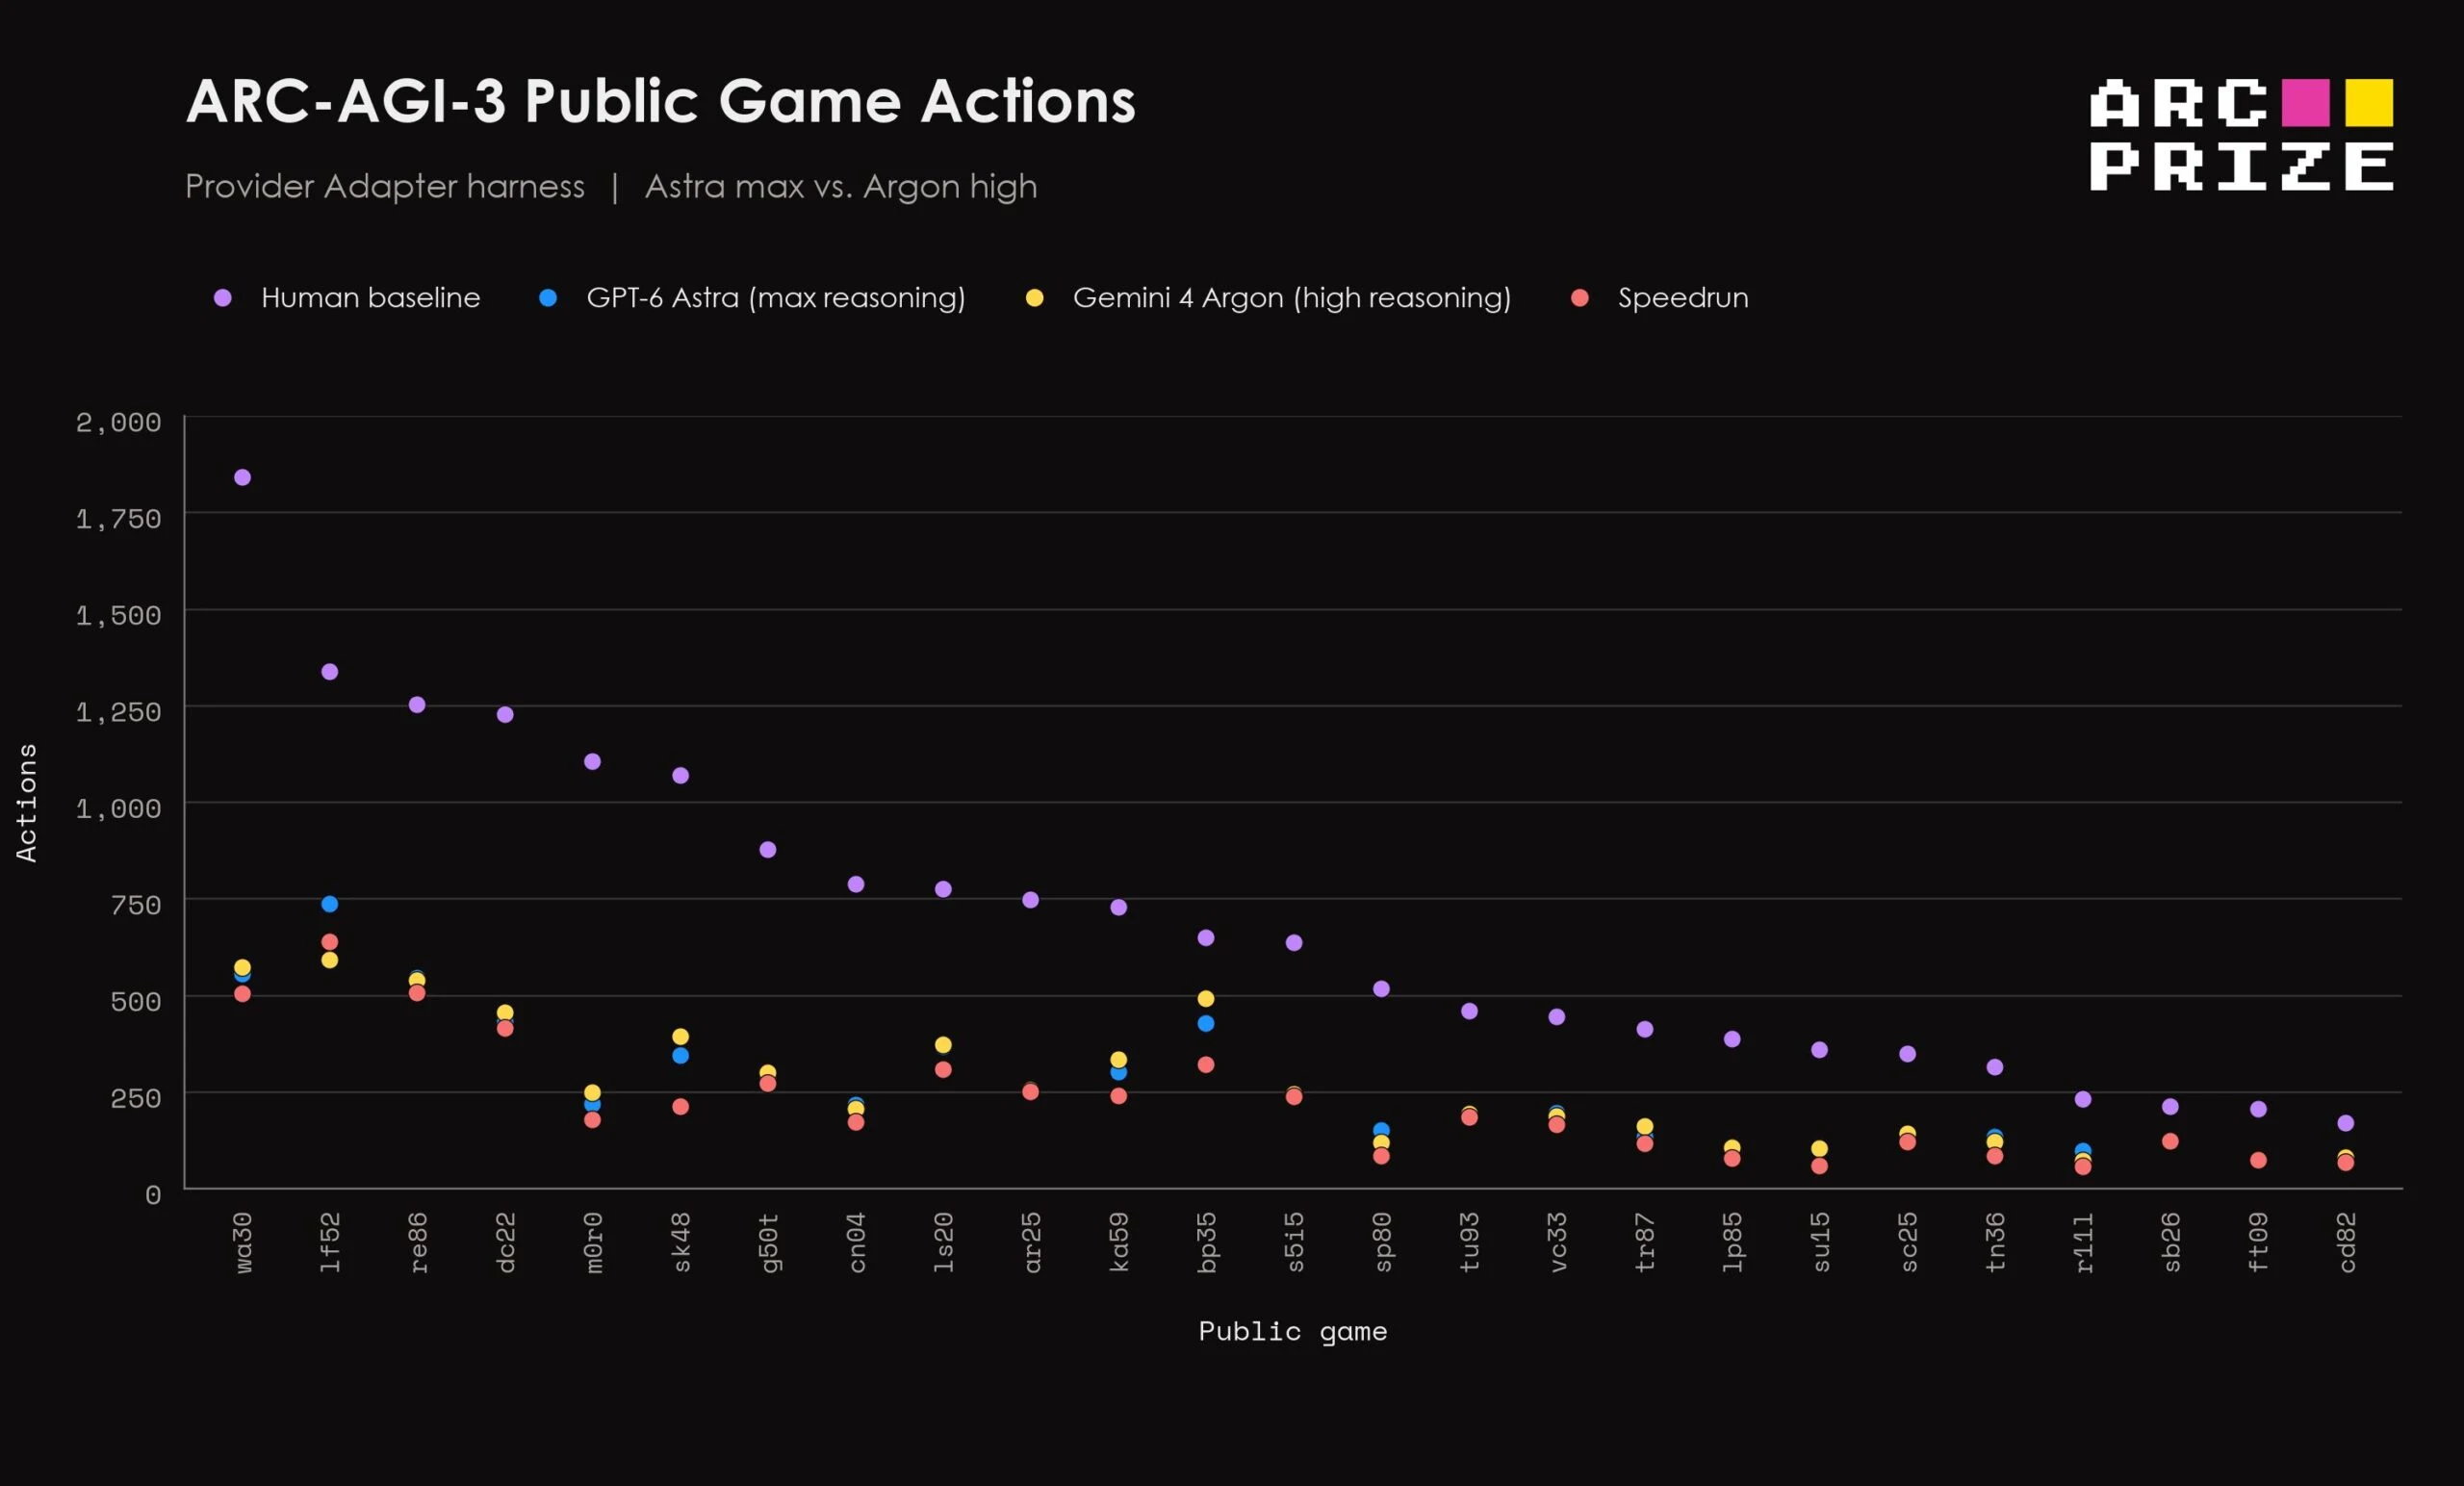
Astra와 마찬가지로, Argon은 25개의 공개 게임에서 인간 기준치보다 62% 적은 행동을 필요로 했습니다. 세 개의 게임에서는 속도경기 기록과 맞거나 그를 넘었으며, 여섯 개의 게임에서는 최고 시간의 10% 이내에 도달했습니다. 더 오래된 벤치마크 버전에서, Argon은 ARC-AGI-2(작업당 $0.32)에서는 91.3%, ARC-AGI-1(작업당 $0.16)에서는 98.5%의 점수를 기록했습니다. 이는 백만 입력 토큰당 $2, 백만 출력 토큰당 $10이라는 초기 가격에 기반한 것입니다.
베스트셀러 결과는 테스트 환경에 크게 의존합니다
“표준 하네스”에서는 라운드 간에 간단한 메모만 허용되며, 아르곤은 5,800달러로 낮은 추론 수준에서 49.8%까지 떨어졌다. 이 격차는 2026년 7월에 발생한 분쟁에서 비롯되었다. OpenAI의 GPT-5.6 Sol은 두 가지 API 설정을 사용하여 ARC-AGI-3에서 Claude Opus 5를 이겼습니다..ad
GPT-5.6 Sol은 표준 환경에서 7.8퍼센트만을 달성했으며, 각 행동 후에 내부 추론을 포기하고 더 새로운 Claude API 기능이 없는 구형 인터페이스를 사용했다. 이는 Claude가 GPT-5.6과는 다른 조건 하에서 테스트되었다는 것을 의미한다. OpenAI의 자체 Responses API를 사용하여 “보존된 추론” 및 “스마트 컨텍스트 압축” 기능을 포함해 테스트했을 때, 모델은 38.3퍼센트까지 상승했으며 Opus 5의 30.2퍼센트를 능가했다. OpenAI는 벤치마크가 항상 기술 환경도 측정한다고 주장했습니다. ARC 상의 공동 창립자인 프랑수아 쇼레는 일반적이고 공개적으로 사용할 수 있는 API 설정을 허용했습니다.
API 문제로 인해 Argon은 Standard Harness의 55개 경기 전체를 완료하지 못했습니다. 테스터들에 따르면 저수준에서는 42경기(49.8%)를, 중간 수준에서는 46경기(46.3%)를 완료했지만, 최고 수준에서는 19경기만 완료되었기 때문에 ARC Prize는 점수를 발표하지 않았습니다. 보고된 결과는 중단된 경기의 부분 점수를 포함하여 55개 경기를 모두 포함합니다.
아르곤은 격차를 좁히지만 수학과 코딩에서는 뒤처진다
에포크 AI 연구소도 구글의 진행 상황을 추적했다. 아르곤 165점을 기록했습니다 에포크 능력 지수(ECI)에서 Fable 5.1은 Opus 5.5(167)과 GPT-6 Astra(166) 바로 뒤에 위치합니다. ECI는 인공 분석이 주 점수를 만드는 방식과 유사하게 50개 이상의 벤치마크를 하나의 능력 척도로 통합합니다.
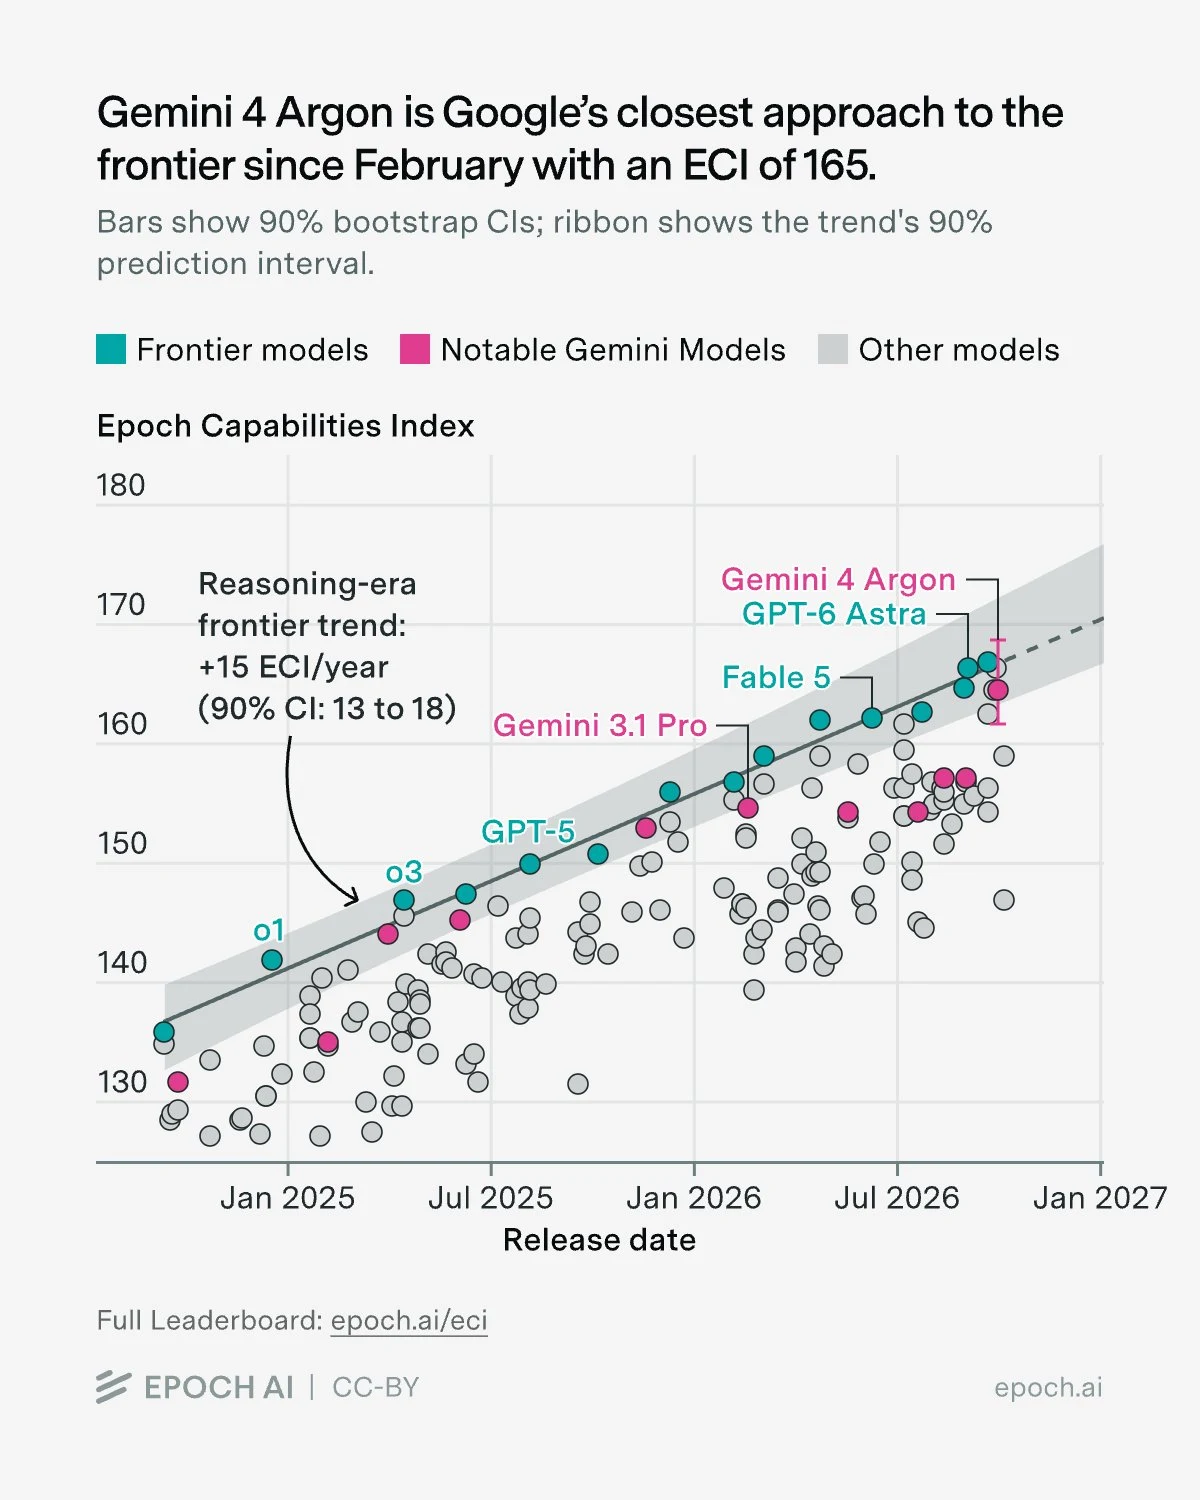
알곤은 젬니 3.8 플래시(157점)보다 훨씬 앞서 순위를 올렸으며, 2월의 젬니 3.1 프로 이후로 가장 높은 순위에 도달했습니다. 인공 분석 및 Vals.ai도 이 추세를 미리 확인했습니다.
그러나 성능은 분야에 따라 다릅니다. Epoch AI에 따르면, Argon은 여러 지식, 에이전트, 비전 벤치마크에서 선두를 달리고 있지만, 초기 추정에 따르면 Math ECI에서는 8위, 소프트웨어 엔지니어링 인덱스(SWE ECI)에서는 6위에 해당합니다.
과장 없는 AI 뉴스 – 인간이 선별한 내용
THE DECODER에 가입하여 광고 없는 읽기, 주간 AI 뉴스레터, 매년 6회 발행되는 독점적인 "AI Radar" 전선 보고서, 전체 아카이브 접근 권한, 그리고 우리의 코멘트 섹션에 대한 접근을 받으세요.
출처: EpochAI | ARC Prize