
Reflection AI 은 코드 유지 관리, 도구 사용, 결과 해석, 다단계 워크플로 완료와 같은 에이전틱 코딩 및 장기 작업을 위한 오픈 웨이트 모델인 Beam을 소개했습니다. 이번 오픈 웨이트 릴리스는 개발자와 연구자에게 런타임, 배포 환경 및 사용자 지정 프로세스에 대한 제어권을 제공합니다.
이 게시물에서는 Reflection의 비전을 설명하고 AWS에서 Beam을 배포하는 방법을 보여줍니다. 완전 관리형 경로를 원한다면 Amazon SageMaker JumpStart 실시간 엔드포인트로 시작하십시오. 분산 GPU 인프라에 대한 Kubernetes 네이티브 제어가 필요한 경우 JumpStart, SGLang 또는 vLLM과 함께 Amazon SageMaker HyperPod Inference 를 사용하십시오. 또한 Beam의 총 5010억 개 파라미터가 체크포인트 저장, 가중치 메모리, 샤딩 및 병렬화에 어떤 영향을 미치는지, 그리고 230억 개의 활성 파라미터가 토큰당 연산에 어떤 영향을 주는지 설명합니다.
출시 시점에 Beam은 US East (N. Virginia) 및 US East (Ohio) 리전의 Amazon SageMaker JumpStart에서 사용할 수 있습니다.
오픈 인텔리전스를 향한 Reflection의 비전
Reflection의 사명은 공개 모델 가중치, 연구 결과 공개, 오픈 소스 소프트웨어를 통해 모든 사람에게 지능을 개방하고 접근 가능하게 만드는 것 입니다. Reflection의 전체 AI 스택 은 모델, 핵심 소프트웨어, 프로덕션 인프라 및 애플리케이션을 아우릅니다. Beam은 이러한 접근 방식을 소프트웨어 엔지니어링 및 에이전틱 시스템을 구축하는 개발자에게 제공합니다.
Reflection Beam 소개
Beam은 소프트웨어 이슈 해결, 코드 수정, 도구 호출, 중간 결과에 대한 조치를 위한 sparse mixture-of-experts 모델입니다. 총 5010억 개의 파라미터와 230억 개의 활성 파라미터를 보유하고 있으며, Reflection은 유효 컨텍스트 길이가 100만 토큰이라고 밝혔습니다.
Reflection은 Apache 2.0 라이선스로 Hugging Face를 통해 Beam의 가중치를 공개합니다. Beam 1.0은 BF16, FP8 및 NVFP4 체크포인트 변형으로 제공됩니다. 이러한 포맷은 서로 다른 메모리 사용량과 하드웨어 호환성을 제공합니다. AWS 관리형 JumpStart 컨테이너 구성으로 모델을 배포하거나, AWS 환경에서 SGLang 또는 vLLM으로 모델을 검사하고 사용자 지정할 수 있습니다.
배포 아키텍처 이해
제어 및 확장 요구 사항에 맞는 서빙 경로를 선택하십시오.
- Kubernetes를 운영하지 않고 AWS 관리형 모델 패키지, 엔드포인트 및 호출 API를 원한다면 SageMaker JumpStart 실시간 엔드포인트 Kubernetes를 직접 운영하지 않고 AWS 관리형 모델 패키지, 엔드포인트 및 호출 API를 원하는 경우.
- Amazon Elastic Kubernetes Service(Amazon EKS)로 오케스트레이션되는 HyperPod 클러스터에서 AWS 관리형 컨테이너 및 모델 구성을 원한다면 HyperPod Inference에서 JumpStart Amazon Elastic Kubernetes Service(Amazon EKS)가 오케스트레이션하는 HyperPod 클러스터에서 AWS 관리형 컨테이너 및 모델 구성을 원하는 경우.
- 서빙 이미지, 런타임 인수, 양자화 또는 분산 실행을 제어해야 하는 경우 HyperPod Inference에서 SGLang 또는 vLLM 서빙 이미지, 런타임 인수, 양자화 또는 분산 실행을 직접 제어해야 하는 경우.
- 체크포인트 저장, 가중치 메모리, KV 캐시, 컨텍스트 길이, 배칭, 런타임 오버헤드 및 지원되는 병렬화에 맞게 배포 규모를 조정하십시오.
- 예상 동시성과 지연 시간 목표를 정의한 다음, 측정된 워크로드 동작을 기반으로 복제본, 캐싱, 라우팅 및 오토스케일링을 구성하십시오.
JumpStart 실시간 경로는 관리형 배포 워크플로 뒤에서 모델, 컨테이너 및 엔드포인트를 패키징합니다. HyperPod 경로는 클러스터와 서빙 런타임을 노출하여 분산 실행, 캐싱, 라우팅 및 확장을 제어할 수 있게 해줍니다.
다음 다이어그램은 HyperPod 경로에서 사용되는 구성 요소를 보여줍니다. Beam은 SageMaker JumpStart, Hugging Face Hub 또는 선택적 Amazon Simple Storage Service(Amazon S3) 미러를 통해 확보할 수 있습니다. 분산 워커는 AWS 관리형 JumpStart 컨테이너 또는 사용자 지정 SGLang 또는 vLLM 런타임을 사용합니다.
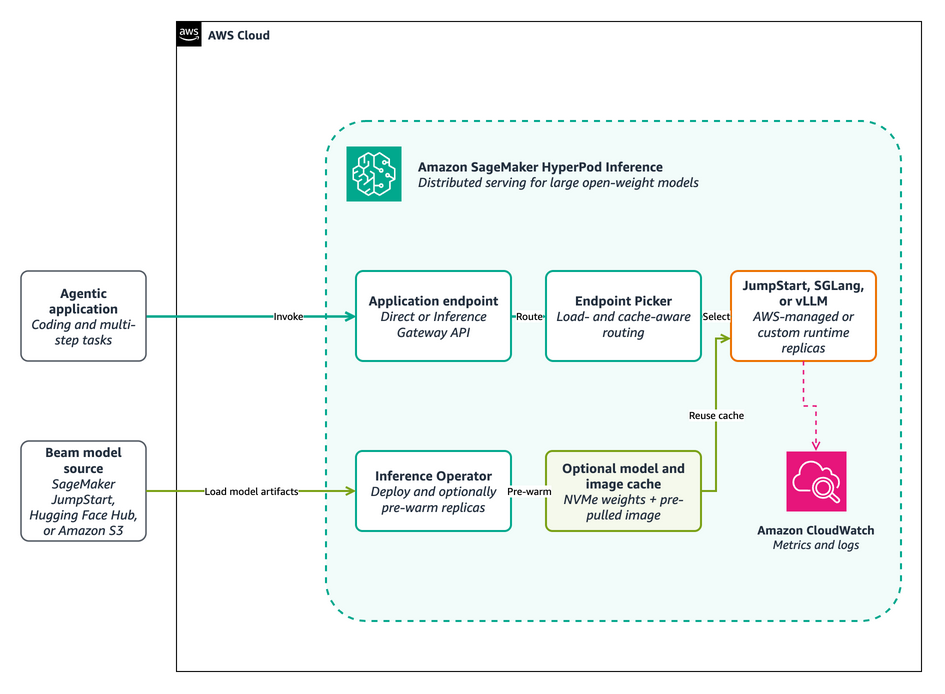
그림 1: Amazon SageMaker HyperPod Inference를 통한 분산 Beam 배포
사전 조건
다음이 필요합니다:
- 선택한 SageMaker 배포 경로와 이를 지원하는 AWS Identity and Access Management(IAM), 네트워킹 및 스토리지 리소스에 대한 권한이 있는 AWS 계정.
- SageMaker JumpStart 또는 Hugging Face의 Beam 1.0 체크포인트 리포지토리 중 하나를 통한 Beam 액세스.
- 모델 약관 동의, AWS Command Line Interface(AWS CLI), 그리고 Python 3.11 이상.
- 지원되는 Beam 구성을 위한 GPU 할당량 및 용량.
GPU 용량 계획 및 확보
Beam의 총 5010억 개 파라미터는 멀티 GPU 배포가 필요합니다. BF16은 가중치 메모리 요구 사항이 가장 크므로, 가중치와 런타임 오버헤드를 충분히 수용할 수 있는 집계 GPU 메모리를 갖춘 멀티 노드 구성을 계획하세요. FP8의 경우 NVIDIA H100 GPU에서는 ml.p5.48xlarge NVIDIA H100 GPU를 사용하거나 ml.p5e.48xlarge 및 ml.p5en.48xlarge 을(를) 사용하세요. NVFP4의 경우 NVIDIA B200 GPU에서 ml.p6-b200.48xlarge NVIDIA B200 GPU를 사용하는 경우입니다. 릴리스된 체크포인트, 런타임 및 병렬 레이아웃이 선택한 인스턴스 유형을 지원하는지 확인하세요.
- 한 개의 복제본에 대한 가중치, KV 캐시 및 런타임 오버헤드의 메모리를 계산한 후, 부하 테스트로 추정치를 확인하세요.
- 필요한 가속 인스턴스를 지원하는 AWS 리전을 선택하세요.
- 선택한 인스턴스 유형에 대한 서비스 할당량과 사용 가능한 용량을 확인하세요. 가능하면 온디맨드 용량을 사용하거나, 예정된 작업을 위한 단기 예약으로 SageMaker training plan 을(를) 사용하세요.
- 이미지 전송, 가중치 다운로드, 샤드 로딩, 런타임 초기화에 시간이 걸릴 수 있으므로 여유를 두십시오.
경로 1: SageMaker JumpStart 실시간 엔드포인트로 시작하기
모델 카탈로그에서 관리형 HTTPS 엔드포인트까지의 가장 빠른 경로를 원한다면 먼저 JumpStart 실시간 엔드포인트를 사용하십시오. 이 샘플은 하나의 variant 인식 명령을 통해 BF16, FP8, NVFP4 모델 ID를 지원합니다. 지원되는 인스턴스 유형, 요청 스키마, 배포 명령, 정리 명령에 대해서는 README와 Python 파일이 신뢰할 수 있는 원본 자료입니다.
- 샘플 리포지토리를 복제하세요.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git - SageMaker JumpStart 배포 샘플 디렉터리로 이동합니다.
cd sagemaker-genai-hosting-examples/01-models/ReflectionAI/Beam-1.0-501B-A23B-NVFP4/ - Python 가상 환경을 생성하고 활성화합니다.
python3 -m venv .venv source .venv/bin/activate - 샘플 종속성을 설치합니다.
python -m pip install -r requirements.txt - FP8에 대해 경계가 설정된 배포, 호출 및 정리 수명 주기를 실행합니다.
python jumpstart_real_time.py \
--variant fp8 \
--endpoint-name reflection-beam-fp8-smoke
이 명령은 FP8 엔드포인트를 배포하고, 짧은 요청을 전송하고, 응답을 출력한 뒤, 엔드포인트를 정리합니다. 사용 방법은
bf16또는nvfp4다른 체크포인트 변형을 선택하기 위한 옵션입니다. NVFP4는 생략할 경우 기본값입니다.--variant엔드포인트를 계속 실행해 두어야 할 때는 README의 Python 함수를 사용하세요.
경로 2: SageMaker HyperPod Inference로 배포
분산 GPU 인프라에 대한 Kubernetes 네이티브 제어가 필요할 때 HyperPod Inference를 사용하십시오. AWS 관리형 JumpStart 컨테이너 구성을 사용하거나 SGLang 또는 vLLM과 함께 Beam을 배포할 수 있습니다. The HyperPod Inference 배포 샘플 README 및 해당 구성 파일은 릴리스된 매니페스트, 모델 및 이미지 식별자, 지원되는 런타임 버전, 명령어에 대한 신뢰할 수 있는 단일 출처입니다.
시작하기 전에 다음을 구성하십시오 kubectl HyperPod Inference Operator와 필수 애드온이 구성된 EKS로 오케스트레이션된 HyperPod 클러스터에 대한 액세스 권한이 필요합니다. 또한 클러스터 가상 프라이빗 클라우드(VPC), 서브넷, 보안 그룹, 선택한 Beam 및 런타임 아티팩트에 대한 액세스, 그리고 모델 캐싱을 활성화하는 경우 로컬 NVMe 용량이 필요합니다. 선택한 리포지토리에 인증이 필요한 경우 격리된 Hugging Face 액세스 토큰을 사용하세요.
개발 및 실험을 위해 Hugging Face Hub에서 고정(pinned)된 Beam 리비전을 배포하세요. 프로덕션 배포 및 모델 캐싱을 위해서는 체크포인트를 Amazon S3 또는 Amazon FSx로 복사하세요. HyperPod 모델 및 이미지 캐싱 노드 로컬 NVMe 스토리지에 가중치를 미리 적재하고 서빙 이미지를 미리 풀(pull)해 둘 수 있습니다.
이 HyperPod Inference Gateway 복제본(replicas) 전반에 걸쳐 요청을 라우팅하는 OpenAI 호환 인터페이스를 제공합니다. HyperPod Inference는 또한 다음을 지원합니다 관리형 계층형 KV 캐싱과 지능형 라우팅. 이는 다음과 같은 사례들 중 하나입니다 2026년에 소개된 Amazon SageMaker 추론 기능.
다음 다이어그램은 모델 준비 및 런타임 요청 흐름을 확장하여 보여줍니다. 모델 캐싱이 활성화되면 Inference Operator가 적격한 노드에 선택된 가중치와 서빙 이미지를 미리 워밍합니다. 런타임에 Inference Gateway와 Endpoint Picker는 각 요청을 적합한 JumpStart 관리형, SGLang 또는 vLLM 복제본으로 전달할 수 있습니다.
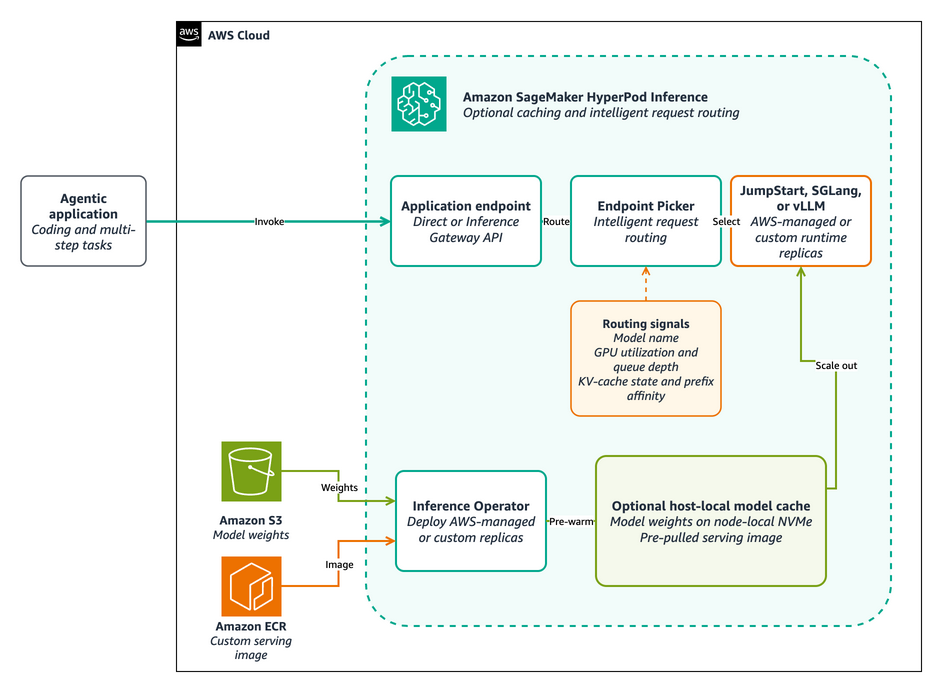
그림 2: HyperPod 모델 캐싱 및 요청 라우팅
배포 아티팩트 준비
배포와 성능 결과를 재현할 수 있도록 불변 입력을 사용하십시오.
- 배포 샘플에 기록된 JumpStart 모델 릴리스를 사용하십시오.
- 사용자 지정 런타임을 위해 BF16, FP8 또는 NVFP4 체크포인트를 선택합니다.
- 사용자 지정 런타임의 경우 샘플 릴리스 구성에 공개 Beam 커밋 SHA와 이미지 다이제스트를 유지합니다.
- 클러스터가 업스트림 이미지를 풀할 수 없거나 조직에서 승인된 레지스트리를 요구하는 경우에만 릴리스된 이미지를 프라이빗 Amazon Elastic Container Registry(Amazon ECR) 리포지토리로 미러링합니다.
- 토큰, 생성된 시크릿, 프라이빗 모델 ID, 레지스트리 자격 증명, 미공개 결과는 리포지토리에 포함하지 마십시오.
서빙 경로 선택
워크로드에 특정 추론 런타임이나 구성이 필요한 경우가 아니라면 SageMaker JumpStart로 시작하십시오.
| 서빙 경로 | 사용 시점 | 사용자가 관리하는 항목 |
| SageMaker JumpStart | 런타임 유지 관리가 적은 AWS 관리형 컨테이너 및 모델 구성을 원하는 경우. | Beam 모델 버전, 지원되는 인스턴스 유형, 엔드포인트 구성 및 스케일링 정책을 선택합니다. |
| SGLang 또는 vLLM | 특정 추론 런타임이나 구성이 필요한 경우, 예를 들어 사용자 지정 런타임 인수, 파서, 양자화 또는 병렬화가 필요할 수 있습니다. | 지원되는 런타임 이미지, 모델 리비전, 파서 구성 및 분산 실행 설정을 고정하십시오. |
SageMaker JumpStart로 배포하기
SageMaker JumpStart는 컨테이너 통합 작업을 줄여주는 반면, HyperPod는 클러스터 용량, 확장 및 관측성에 대한 제어권을 유지합니다.
- SageMaker Studio에서 다음을 엽니다 JumpStart 모델 카탈로그.
- 아래 모든 공개 모델, 선택 Beam.
- 선택 SageMaker HyperPod 배포 대상으로 지정합니다.
- 클러스터와 Kubernetes 네임스페이스를 선택합니다.
- 엔드포인트 이름을 입력하고 다음을 선택합니다 배포.
- 배포된 JumpStart 요청 스키마로 엔드포인트를 호출하기 전에 배포 상태를 확인합니다.
Infrastructure-as-code 워크플로의 경우 HyperPod 샘플의 릴리스된 JumpStart 구성을 사용하세요. 다음을 검토할 수 있습니다. reflection-beam-jumpstart.yaml 매니페스트 템플릿 배포를 구성하기 전에.
- 샘플 리포지토리를 복제하고 HyperPod Beam 디렉터리로 이동합니다.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git cd sagemaker-genai-hosting-examples/SageMakerHyperpod/reflection-beam/ - README에 설명된 로컬 구성 파일을 생성하십시오.
cp config/deployment.env.example config/deployment.env cp config/release.env.example config/release.env - 클러스터를 변경하기 전에 JumpStart 구성을 검증하십시오.
python hyperpod_tool.py \ --config config/deployment.env \ --config config/release.env \ validate jumpstart - JumpStart 구성을 배포합니다.
python hyperpod_tool.py \
  --config config/deployment.env \
  --config config/release.env \
  deploy jumpstart \
  --timeout-seconds 1800
해당 헬퍼는 공개된 JumpStartModel 디스크에 populated release 값을 기록하지 않고 리소스를 사용합니다.
SGLang 또는 vLLM으로 배포하기
배포 런타임을 직접 제어해야 할 때는 SGLang 또는 vLLM을 선택하세요. 배포를 구성하기 전에 다음을 확인하십시오. reflection-beam-sglang.yaml 매니페스트 템플릿 혹은 reflection-beam-vllm.yaml 매니페스트 템플릿. 릴리스된 값과 명령어의 기준은 샘플 README입니다.
- 샘플 리포지토리를 복제합니다.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git - HyperPod Beam 디렉터리로 이동합니다.
cd sagemaker-genai-hosting-examples/SageMakerHyperpod/reflection-beam/ - README에 설명된 로컬 구성 파일을 생성합니다.
cp config/deployment.env.example config/deployment.env cp config/release.env.example config/release.env - 클러스터를 변경하기 전에 선택한 구성을 검증합니다.
python hyperpod_tool.py \ --config config/deployment.env \ --config config/release.env \ validate sglang - Beam을 배포하고 최종 배포 상태가 될 때까지 기다립니다.
python hyperpod_tool.py \
  --config config/deployment.env \
  --config config/release.env \
  deploy sglang \
  --timeout-seconds 1800
다음을
sglang으로 교체하면vllmvLLM을 사용할 수 있습니다. 이 헬퍼는 선택한 설정을 검증하고, 릴리스 값을 디스크에 쓰지 않고 렌더링된 매니페스트를 적용하며, 고정 타임아웃으로 대기한 후 배포에 실패하면 진단 정보를 출력합니다.
Beam 호출
릴리스된 모델 요청 스키마로 JumpStart 엔드포인트를 호출합니다. SGLang 또는 vLLM의 경우 HyperPod 샘플에 포함된 범위가 제한된 스모크 테스트를 사용하십시오.
배포된 엔드포인트 호출
- 샘플 클라이언트 종속성을 설치합니다.
python3 -m venv .venv source .venv/bin/activate python -m pip install -r requirements.txt - 권장되는 시작 샘플링 설정으로 비공개 상태 확인(헬스 체크)과 짧은 요청을 실행합니다.
python hyperpod_tool.py \
--config config/deployment.env \
smoke sglang \
--prompt "List three checks for a healthy model deployment." \
--temperature 1.0 \
--top-p 0.7
다음을
sglang으로 교체하면vllmvLLM 배포에 해당합니다. 이 헬퍼는 준비된 워커를 선택하고, 임시 포트 포워드를 열고, 엔드포인트 상태를 확인한 후, 요청을 전송하고, 포트 포워드를 닫습니다.
응답은 다음과 유사합니다:
1. Confirm that the endpoint reports ready.
2. Send a short inference request.
3. Review the service logs for startup errors.
인증이 필요한 Inference Gateway의 경우 HyperPod 샘플 README의 베어러 토큰 절차를 사용하십시오. 자격 증명이 소스 코드, 매니페스트, 명령 기록에 노출되지 않도록 하십시오.
성능 측정 및 튜닝
- 예상되는 동시성 수준에서 반복적이고 대표적인 코딩 및 도구 사용 요청으로 각 서빙 경로를 테스트하세요.
- Beam 모델 버전, 이미지 다이제스트, 인스턴스 유형, 정밀도, 컨텍스트 길이, 병렬 처리, 서빙 인자, 캐시 상태, 그리고 테스트 반복 횟수를 기록합니다.
- 요청 성공률, p50 및 p95 첫 토큰 도달 시간, 출력 토큰당 시간, 엔드투엔드 지연 시간, 초당 총 출력 토큰 수를 측정합니다.
- 해당 결과를 바탕으로 배치 크기, KV 캐시 할당, 레플리카 수, 오토스케일링, 모델 및 이미지 캐싱을 조정하십시오.
- 정밀도나 양자화를 변경한 후에는 출력 품질을 다시 확인하십시오.
정리
테스트를 마친 후에는 지속적인 요금이 청구되지 않도록 리소스를 삭제하세요.
- SageMaker JumpStart 실시간 엔드포인트의 경우, SageMaker JumpStart 배포 샘플 README의 정리 지침을 따르십시오.
- Amazon SageMaker HyperPod Inference에서 JumpStart, SGLang 또는 vLLM을 사용하는 경우, HyperPod Inference 배포 샘플 README의 정리(cleanup) 지침을 따르십시오.
- 실습을 위해 생성한 전용 HyperPod 또는 Amazon EKS 클러스터를 삭제합니다.
- 사용하지 않는 캐시된 가중치, 미러링된 아티팩트, 로드 밸런서, 로그 그룹, 임시 IAM 역할, 캡처된 추론 데이터를 삭제하십시오.
결론
Reflection Beam은 개발자에게 에이전트형 코딩 및 다단계 작업을 위해 설계된 오픈 웨이트 모델을 제공합니다. 완전 관리형 배포를 위해서는 SageMaker JumpStart 실시간 엔드포인트로 시작하십시오. 서빙 컨테이너를 관리하지 않으면서 Kubernetes 네이티브 인프라 제어가 필요하다면 JumpStart와 함께 SageMaker HyperPod Inference를 사용하고, 사용자 정의 런타임이 필요하다면 SGLang 또는 vLLM을 선택하십시오.
다음을 사용하세요 SageMaker JumpStart 배포 샘플 또는 HyperPod Inference 배포 샘플, 그런 다음 지침을 따르십시오.
Reflection AI와 오픈 인텔리전스에 대한 비전을 자세히 알아보려면 다음을 방문하세요 Reflection AI 그리고 읽어 보세요 Beam 소개.
리소스
- Reflection Beam 체크포인트 변형: BF16, FP8, 그리고 NVFP4
- SageMaker JumpStart 배포 샘플
- JumpStart, vLLM 및 SGLang을 활용한 HyperPod 추론 배포 샘플
- SageMaker JumpStart에서 HyperPod Inference로 파운데이션 모델 배포
- Amazon SageMaker Inference 2026년 연초부터 현재까지의 출시 소식 돌아보기