
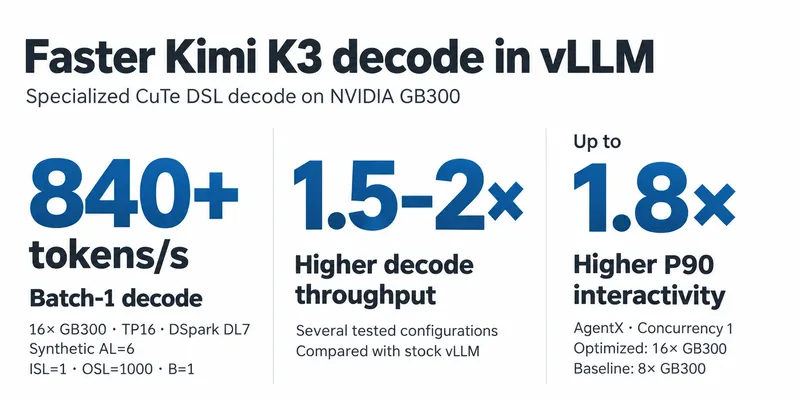
코딩 에이전트는 이제 모델 최적화의 가장 어려운 부분들을 도와줄 수 있습니다: 복잡한 GPU 커널 작성, 여러 오퍼터블 간의 결합 처리, 통신과 계산의 겹침, 그리고 다양한 배치 크기와 GPU 구성에서 실행 설정 조정 등입니다. Kimi K3에 대해서는 에이전트 지원 개발을 통해 NVIDIA GB300에서 통합 CuTe DSL 디코딩 경로를 구축했으며, 이는 8개 또는 16개의 GPU를 사용하는 경우 주의, MoE, 그리고 통신 기능을 포함합니다. 최적화 결과, DSpark(합성 AL=6)를 사용한 16개의 NVIDIA GB300 GPU에서 배치 1일 때 840 토큰/초 이상의 속도를 달성했으며, 여러 테스트된 구성에서는 1.5–2배 더 높은 디코딩 처리량을 보였고, AgentX 워크로드에서는 1.8배 더 높은 P90 상호작용성을 달성했습니다.
에이전트 최적화된 추론 코드는 우리의 리뷰 및 유지보수 워크플로우를 앞지르고 있습니다. 각 커널의 모든 줄을 이해하고 잠재적인 문제를 파악하며 지원되는 모든 설정을 테스트하는 수동 리뷰 과정은 매우 시간이 많이 드는 작업입니다. 반면, 이 작업을 생략하면 생산 환경에서 실패할 수 있는 결함이 있는 소프트웨어를 배포하는 위험이 있습니다.
두 가지 목표를 달성하는 방법에 대해 명확한 경로가 있습니다: 성능 작업을 조직하는 방식을 바꿔야 합니다. 에이전트 기반 최적화와 함께, 신뢰성과 성능의 자동 검증이 가능한 시스템을 설계해야 하며, 설계상으로 격리와 위험 감소를 보장하는 소프트웨어 구조를 만들어야 합니다.
제안된 빠른 프로세스 모델 최적화 RFC는 이러한 접근 방식의 기반을 제공합니다. 우리의 지침 원칙은 위험을 관리하면서 검토 부담을 줄이는 것입니다. 이를 달성하기 위해 우리는 다음과 같이 합니다:
- 변경 사항을 분리하세요. 최적화 작업은 모델의 코드 내부에 유지하세요.
- 범위를 제한하고 핵심 기능을 유지하세요. 지원되는 하드웨어와 워크로드를 정의하되, 생산적인 LLM 사용에 필수적인 기능은 유지해야 합니다.
- 체계적으로 정확성을 검증하세요. 보안과 신뢰성을 확보하기 위해 공식적인 성능 및 정확성 벤치마크를 실행하고, 지원되는 모든 구성에서 성능이 더 우수하도록 하세요.
- 스케일 검증. 기여자들이 자신의 GPU로 표준 평가를 수행하고 재현 가능한 결과를 공유한 후에 유지보수자의 관심을 요청해야 합니다.
Kimi K3는 이 접근 방식을 따른 우리의 첫 번째 기여물입니다. 이 글에서는 Kimi K3을 어떻게 최적화했는지, 이러한 최적화를 출시하고 유지하는 데 필요한 신뢰를 어떻게 구축했는지, 그리고 성능 결과에 대해 설명합니다.
목차
파트 1: 키미 K3 최적화
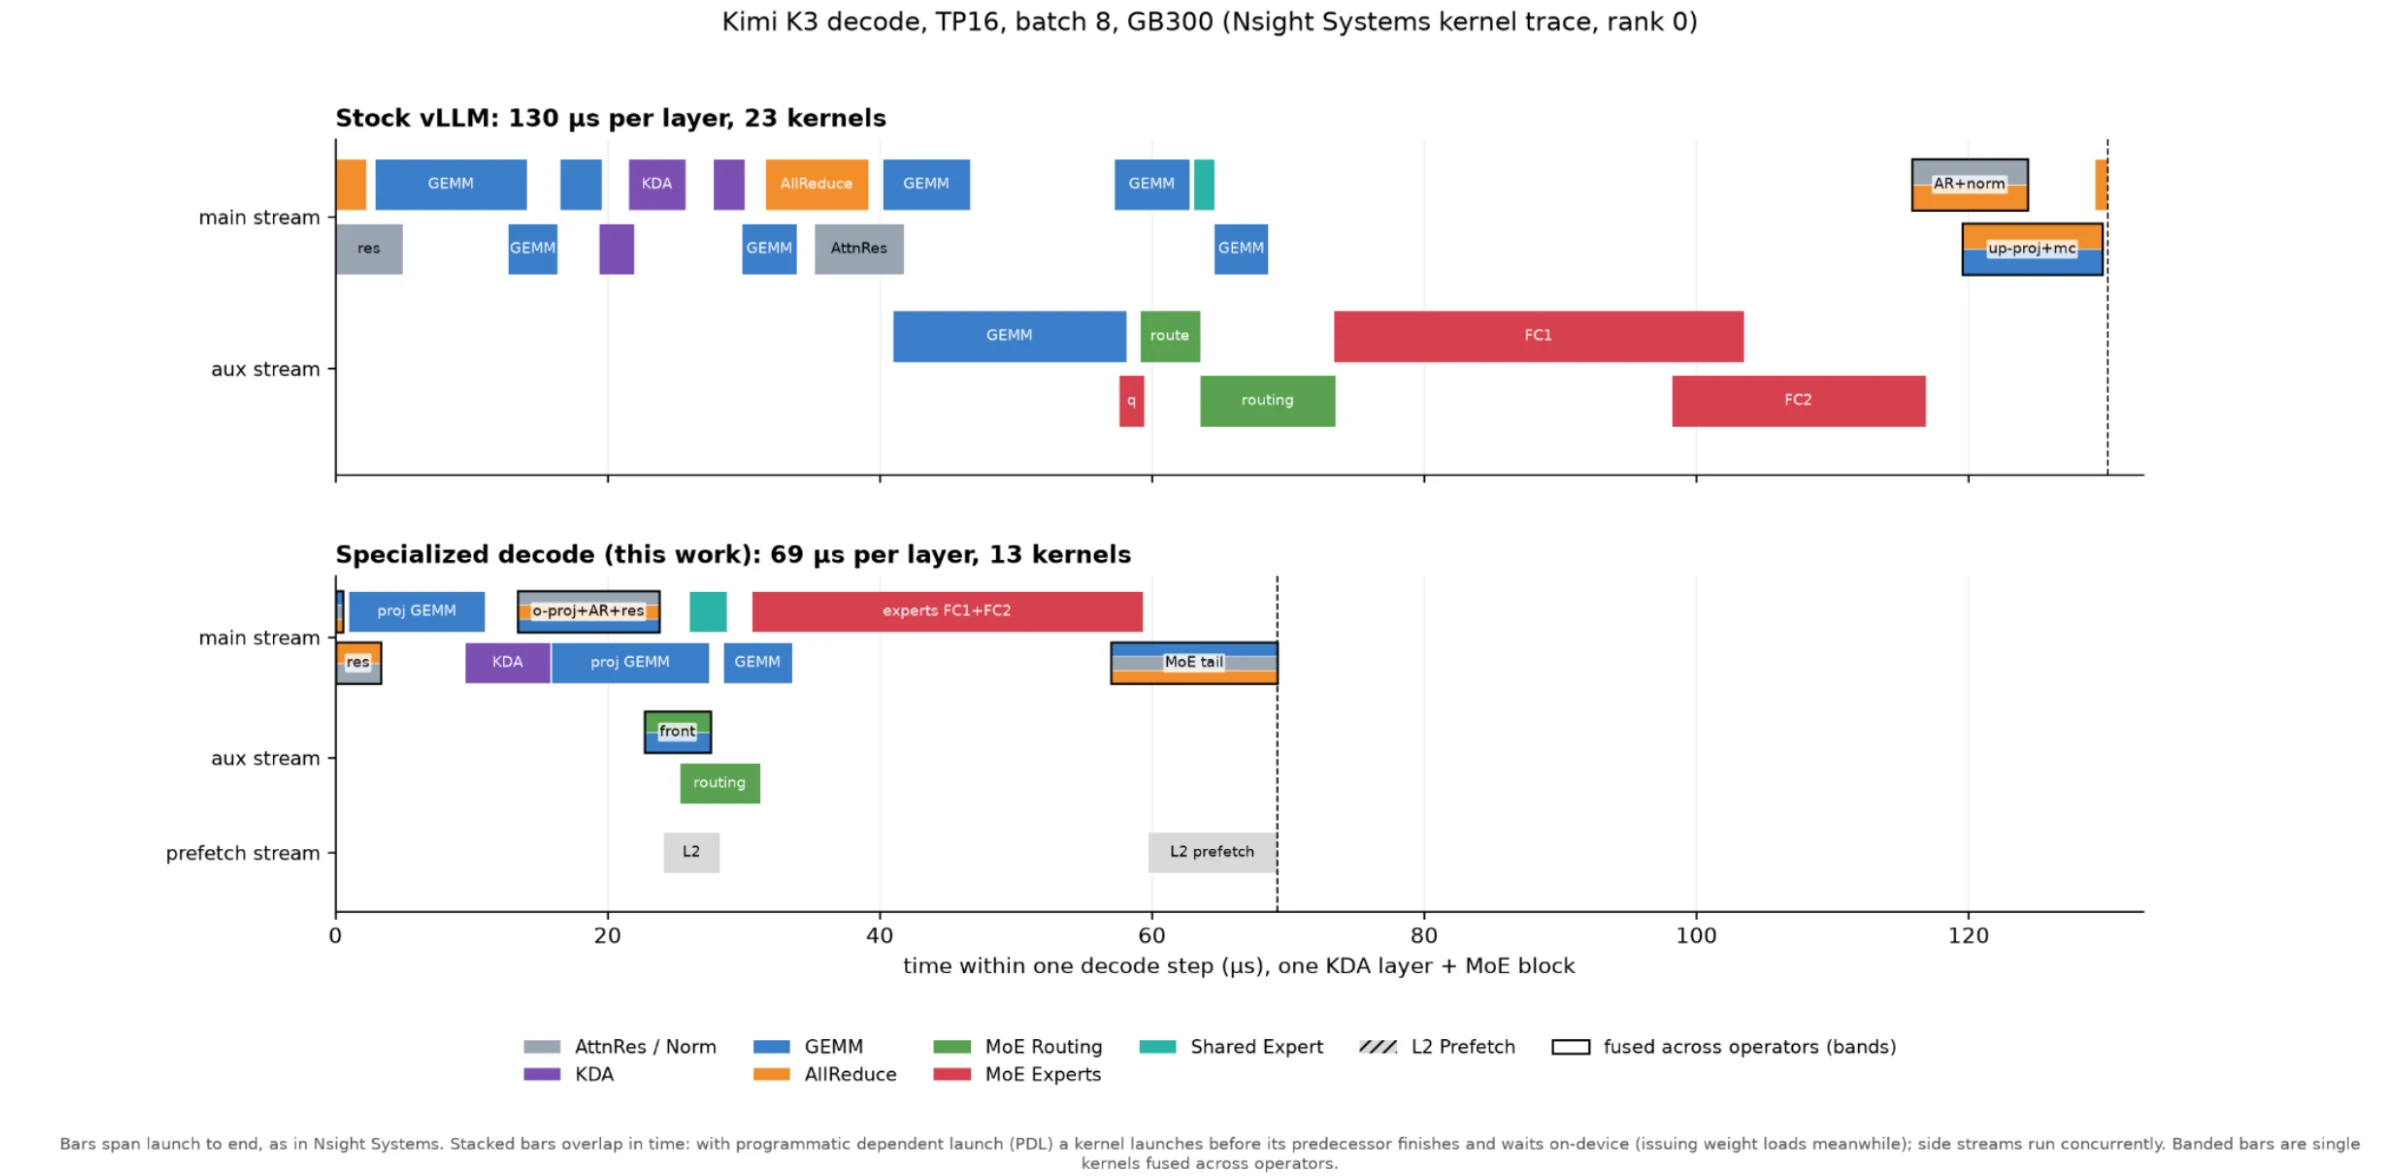
이 공헌에서는 Kimi K3에 새로운 디코딩 경로를 도입했습니다. 이 경로는 특정 하위 문제에 맞게 조정된 맞춤형 CuTe DSL 커널을 사용하여 거의 모든 연산을 통합하고 대체합니다. 이 기능은 8개 또는 16개의 GPU를 가진 NVIDIA Blackwell GPU를 대상으로 하며, 1개에서 64개까지의 디코딩 배치를 처리할 수 있고, 긴 컨텍스트에 대해 선택적 디코딩 컨텍스트 병렬 처리를 지원합니다. GPU들은 멀티캐스팅 지원을 위한 하나의 NVLink 도메인을 공유합니다. 자세한 내용은 PR을 참조하시기 바랍니다.
1. 작업량에 맞게 형태를 조정하기
다양한 배치 크기에는 다른 커널 선택이 필요합니다. 주의를 요하는 입력 프로젝션의 경우, 1–2의 배치 크기에서는 특화된 작은 행렬 커널을 사용하고, 더 큰 배치 크기에서는 분할-K 커널을 사용하여 행렬 곱셈 작업을 더 많은 GPU 노드에 분산시킵니다. 이러한 모든 프로젝션은 GPU 리소스를 완전히 활용하고 메모리 읽기/통신 및 계산 작업을 최대한 공유할 수 있는 적절한 크기의 커널을 실행하도록 세심하게 조정되었습니다.
KDA는 또한 최적화된 CuTe DSL 디코드 커널을 사용하며, 각 GPU上的 배치 크기와 주의 헤드 수에 맞게 스케줄링이 조정되어 있습니다.
긴 컨텍스트 상황에서는 컨텍스트 병렬 처리(DCP)를 사용하여 KV 캐시를 GPU들에 분배합니다. 각 GPU는 자신이 담당하는 부분에 대해 주의를 계산하며, 조정된 융합 커널이 부분적인 결과를 v-proj 및 게이팅을 통해 결합합니다.
2. 겹침 계산과 통신
우리는 주의도출 프로젝션을 직접 전체 감소 처리 및 다음 주의잔차 계산에 통합합니다. GPU 커널은 부분 결과를 NVLink에 접근 가능한 버퍼로 공개하며, 수신 커널은 이를 결합하여 계산을 계속합니다. 일부 소규모 배치 구성에서는 생산자와 소비자를 하나의 커널로 통합합니다. 데이터 교환은 최소한의 오버헤드로 펜스 없는 방식으로 이루어집니다.
더 큰 배치 크기에서는 2단계 감소 방식으로 구현이 이루어집니다. 즉, GPU가 먼저 출력된 데이터의 할당된 부분을 결합한 다음 결과를 분배합니다. 이로써 GPU 간의 데이터 이동이 줄어듭니다.
3. MoE 스케줄링 및 겹치기 기능 개선
전문가들이 이미 텐서 병렬 처리를 사용하고 있지만, 기본 방식에서는 모든 GPU에서 전체 라우터 점수와 잠재적 입력 프로젝션을 계산합니다. 우리는 이러한 계산을 TP 순위에 걸쳐 분배하여 각 순위의 결과를 하나의 행렬 곱으로 합칩니다. GPU들은 NVLink을 통해 결과를 교환합니다. 이로써 전문가 실행이 시작되기 전에 반복적인 계산, 가중치 읽기, 커널 실행이 줄어듭니다.
공유 전문가는 별도의 스트림에서 실행됩니다. 그 작업은 설정에 따라 라우팅 또는 라우트드-전문가 계산과 겹쳐집니다. 스케줄은 각 작업이 사용하는 GPU 리소스 수를 제어하며, 경쟁 없이 균형 잡힌 병렬 처리를 보장하기 위해 신중하게 조정됩니다. 자세한 내용은 experts_runtime에 있습니다.
4. 예상되는 무게 값을 캐시에 미리 로드하기
소규모 인출 인식에서는 종종 메모리 제한을 겪습니다. 메모리에서 가중치를 로드하는 속도에 의해 제한됩니다. 통신과 같은 일부 단계에서는 사용 가능한 메모리 대역폭을 완전히 활용할 수 없습니다. 이 작업이 진행되는 동안 별도의 커널을 실행하여, 통신이 완료된 후 다음 연산에 대한 가중치가 더 높은 캐시 일치율을 갖도록 할 수 있습니다.
2부: 빠르고 책임감 있게 움직이기
Kimi K3는 첫 번째 예시 중 하나에 불과합니다. 우리는 커뮤니티가 함께 노력한다면 더 많은 모델, GPU, 워크로드를 빛의 속도로 가져올 수 있을 것이라고 믿습니다.
다른 기여자/ 에이전트들은 각기 다른 기회를 찾을 수 있습니다: 더 나은 커뮤니케이션 일정이거나, 특정 배포에 도움이 되는 통합이 될 수 있습니다. 하지만 모든 기여가 서로 다른 가정과 불완전한 테스트, 그리고 재현하기 어려운 벤치마크를 포함한다면, 유효성 검사와 유지보수 작업이 빠르게 병목이 되거나, 결국 깨진 코드를 배포하는 위험이 생깁니다. 사용자들이 장기적인 생산 환경에서 의존할 수 있는 개선 사항으로 이러한 아이디어들을 전환할 수 있는 공통된 방법이 필요합니다.
이로 인해 에이전트에게 전달해야 할 내용이 변합니다. 코드 에이전트가 생성하는 테스트, 유효성 검사 및 요구사항에 대해 명확한 기대치를 설정해야 합니다. 에이전트는 테스트를 만들고, 포괄적인 평가와 벤치마크를 수행하며, 실패를 조사하고, 최적화가 작동하는 조건을 문서화합니다. 인간 리뷰어는 여전히 설계와 증거를 판단하지만, 줄줄이 코드 리뷰하는 방식이 아닌 고급 수준의 추상화부터 시작할 수 있습니다.
제안된 신속 처리 RFC를 바탕으로, 우리는 네 가지 원칙에 따라 이 작업을 조직합니다.
1. 변경 사항을 분리하세요
모델별 최적화를 모델의 코드 내에 유지하세요. 이렇게 하면 영향을 받는 경로를 쉽게 식별할 수 있고, 검토자가 고려해야 할 범위를 줄일 수 있습니다.
절연도 실행 중에도 유지되어야 합니다. 검토자들은 최적화된 경로가 선택된 시점, 그 상태가 어떻게 변하는지, 그리고 실행이 표준 경로로 돌아가는 방식을 추적할 수 있어야 합니다.
이 제약 조건 하는가 일부 최적화를 제외하세요: 입력 준비, 샘플링, KV 캐시 관리 등은 격리 기능에서 제외되는 오버헤드를 초래할 수 있습니다. 이는 설계의 결과이며, 대체로 의도적인 것입니다. 이러한 구성 요소들은 대부분 vLLM 배포 환경에서 공유되며, 특정 작업 부하에 맞게 변경하면 수십 개의 다른 안정적인 vLLM 구성이 손상될 위험이 있습니다. 이러한 구성 요소에 대한 작업은 중요하며, 신속한 처리 방식으로는 허용되지 않는 것보다 코어 유지보수자들과 더 밀접하게 관련되어야 합니다.
2. 범위를 제한하지만 사용자의 기능은 유지합니다.
최적화는 모든 배포를 개선해야만 유용해질 필요가 없습니다. 특정 GPU, 병렬 처리 설정 또는 배치 크기 범위를 대상으로 할 수 있습니다. 명확한 경계를 정하면 작동 방식을 조정하기 쉬워지고 검증할 수 있는 정해진 설정 집합을 제공합니다.
K3의 경우, 초기 하드웨어 검증은 GB300을 대상으로 TP8 및 TP16을 사용하며, 64개까지의 배치를 디코딩하고, 다양한 초안 길이로 추측적 디코딩을 수행하며, 하나의 NVLink 도메인 내에서 컨텍스트-병렬 구성도 디코딩합니다.
이 경계는 최적화가 적용되는 영역을 설명하지만, ‘기능 커버리지’를 제거하는 것은 아닙니다. 생산 배포에는 엔드포인트를 유용하게 만드는 기본적인 기능들이 필요합니다. 전체 컨텍스트 제공, 온도 샘플링, 구조화된 출력과 같은 기능들은 ‘최적화하여 제거’되거나 ‘옵트아웃’될 수 없습니다. 이들은 일류 서빙 기능이며, 커널 구조와 수치 검사와 함께 유효성 검증 계획에 포함됩니다.
3. 정확성 검증
커널 테스트와 모델 평가는 서로 다른 질문에 답합니다. 커널 테스트는 다양한 형태와 입력 값에 대한 수치적 결과를 확인합니다. 모델 평가는 전체 실행 경로가 모델의 답을 유지하는지 검사합니다. 우리는 두 가지 모두가 필요합니다.
테스트는 실제로 변경된 코드를 테스트해야 합니다. 소규모 배치 최적화는 소규모 배치에서 평가되어야 합니다. 주의가 필요한 커널 변경은 긴 �텍트에 대한 커버리지가 필요합니다. 표준 경로를 무시하고 작동하는 테스트는 최적화에 대한 정보를 거의 제공하지 않으며, 일반적인 함정이 됩니다.
K3 개발은 이것이 왜 중요한지 보여줍니다. 우리의 감사 결과에 따르면 컴파일러가 동기화 대기 시간보다 먼저 활성화 읽기를 수행하고 있었습니다. 해결 방법으로 그 로드 유형을 정적 무게로 제한했습니다. 이러한 오류는 간단한 기능 검사를 통해 지나치게 보이지 않을 수 있으며, 특별한 조사가 필요합니다.
또한, MRCR 및 AIME25와 같은 긴 컨텍스트와 긴 세대 평가 결과에서는 주의와 통신 커널에서 민감한 수치적 문제가 나타났으며, 이는 모의 입력과/또는 일관된 실행 타이밍을 사용한 독립적인 커널 테스트에서는 재현되지 않았습니다.
4. 전반적인 성능을 확인하세요
헤드라인 속도 향상은 시작점입니다. 또한 영향을 받는 워크로드 전반에서 이러한 변화가 어떻게 나타나는지도 알아야 합니다. 이는 광범위한 배치 크기, 컨텍스트 길이, 지원되는 병렬 처리 구성 등을 의미합니다. MoE 측정값에는 실제 프롬프트가 포함되어야 합니다. 왜냐하면 전문가 선택이 어떤 가중치가 읽히는지와 얼마나 많은 작업이 재사용될 수 있는지에 영향을 미치기 때문입니다. 순수한 디코드 결과도 사전 입력과 디코드를 혼합하는 워크로드와 구별되어야 합니다.
신뢰할 수 있는 검증에도 GPU 시간이 필요합니다. 관련된 자신의 GPU를 사용한 평가 RFC는 기여자들이 자체 하드웨어에서 실행할 수 있는 표준 평가 이미지를 제안합니다. 재현 가능한 결과 파일과 GitHub PR에 연결된 제출물은 증거를 훨씬 더 쉽게 접근할 수 있게 할 것입니다. 다양한 평가 단계와 공유된 커뮤니티 컴퓨팅은 범위를 확대하는 데 도움이 되며, GPU 요구량을 관리하고 프로젝트에서 자금을 지원하는 CI에 대한 압력을 줄일 수 있습니다.
제3부: 성능 심층 분석
DSpark을 이용한 디코딩 성능
DSpark를 사용하면 Kimi K3는 16개의 NVIDIA GB300 GPU를 통해 1초에 842토큰의 속도로 AL=6 벤치마크에서 성능을 발휘합니다. 이는 동일한 추측적 디코딩 설정 하에서 스탠다드 vLLM보다 1.73배 더 빠른 속도입니다. 전체 결과표는 PR을 참조하세요.
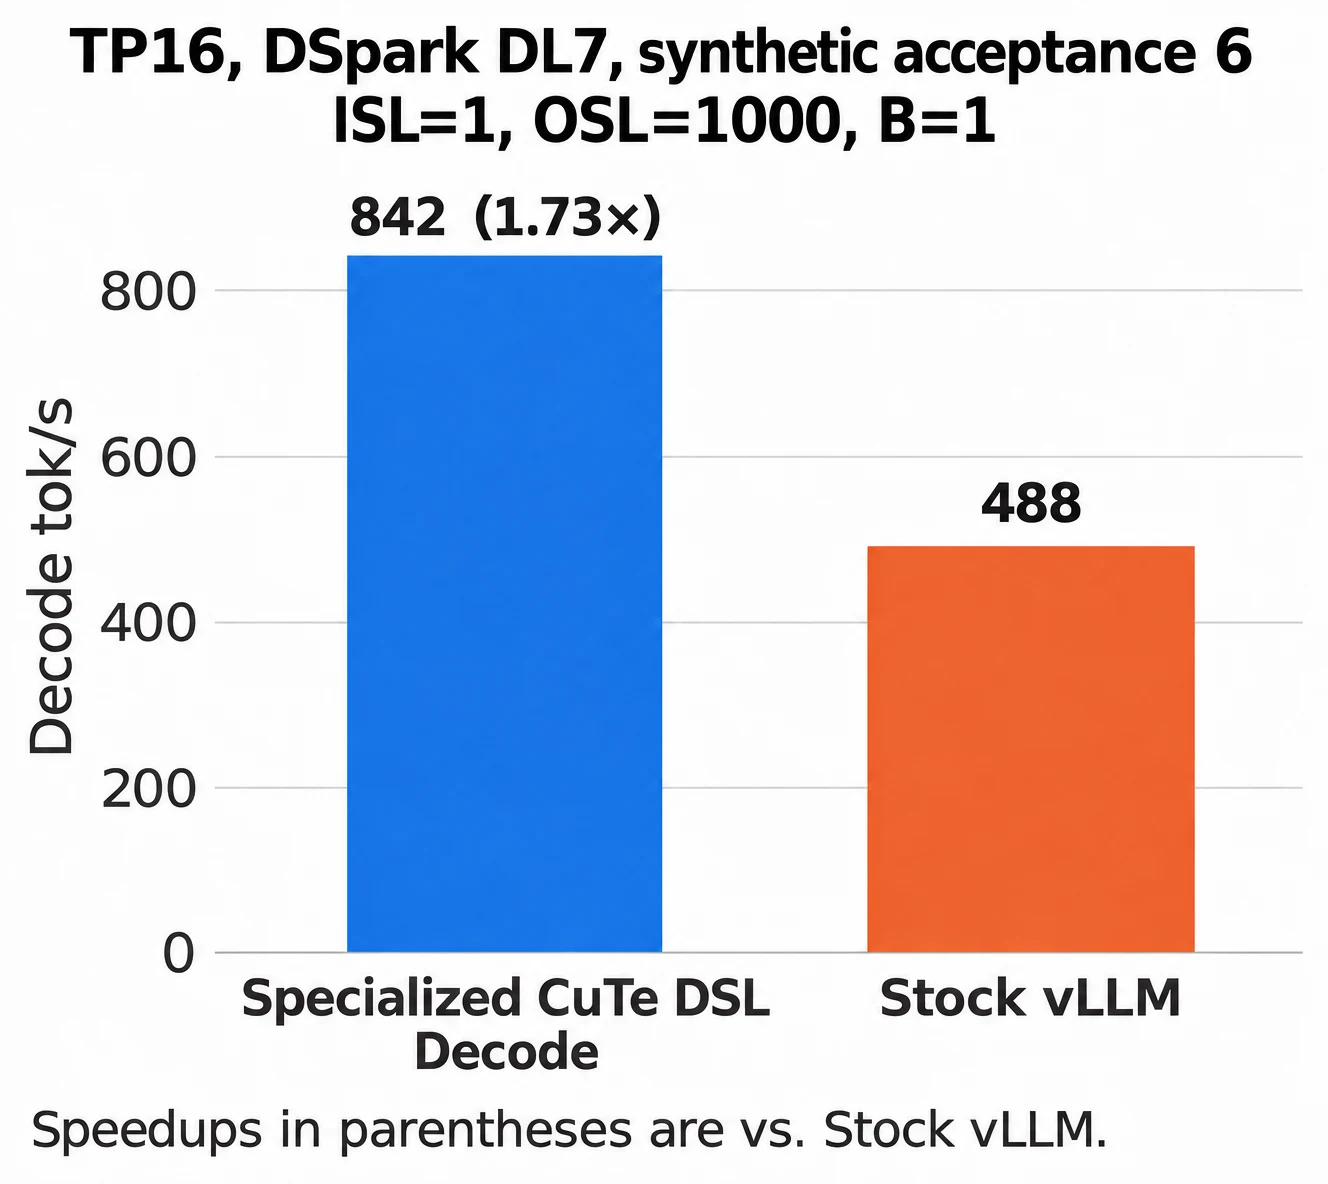
설정: TP16, DSpark로 7개의 드래프트 토큰을 사용하며, 합성 수용 길이는 6, DL=7, ISL=1, OSL=1k, 배치 크기 1입니다. TPS는 전체 디코드 처리량을 측정하며 프리필은 제외됩니다.
추측 없이 해독 성능을 구현하기
개선 효과는 테스트된 배치 범위 전체에 걸쳐 나타납니다. TP16은 16~64번째 배치에서 1.62–1.71배의 성능 향상을 유지하는 반면, TP8은 같은 범위 내에서 1.31–1.43배의 성능 향상을 보입니다.
| 배치 크기 | TP8 토큰/초 | TP8 속도 향상 | TP16 토큰/초 | TP16 속도 향상 |
|---|---|---|---|---|
| 1 | 193.3 | 1.58× | 256.4 | 1.88× |
| 2 | 317.8 | 1.50× | 436.7 | 1.92× |
| 4 | 540.6 | 1.55× | 702.5 | 1.81× |
| 8 | 820.1 | 1.45× | 1,157.9 | 1.79× |
| 16 | 1,274.8 | 1.43× | 1,758.3 | 1.71× |
| 32 | 1,702.6 | 1.33× | 2,550.9 | 1.64× |
| 64 | 2,375.9 | 1.31× | 3,606.1 | 1.62× |
추측적인 디코딩은 없음. 처리량은 전체 TP 그룹에 대한 것임.
AgentX의 개선
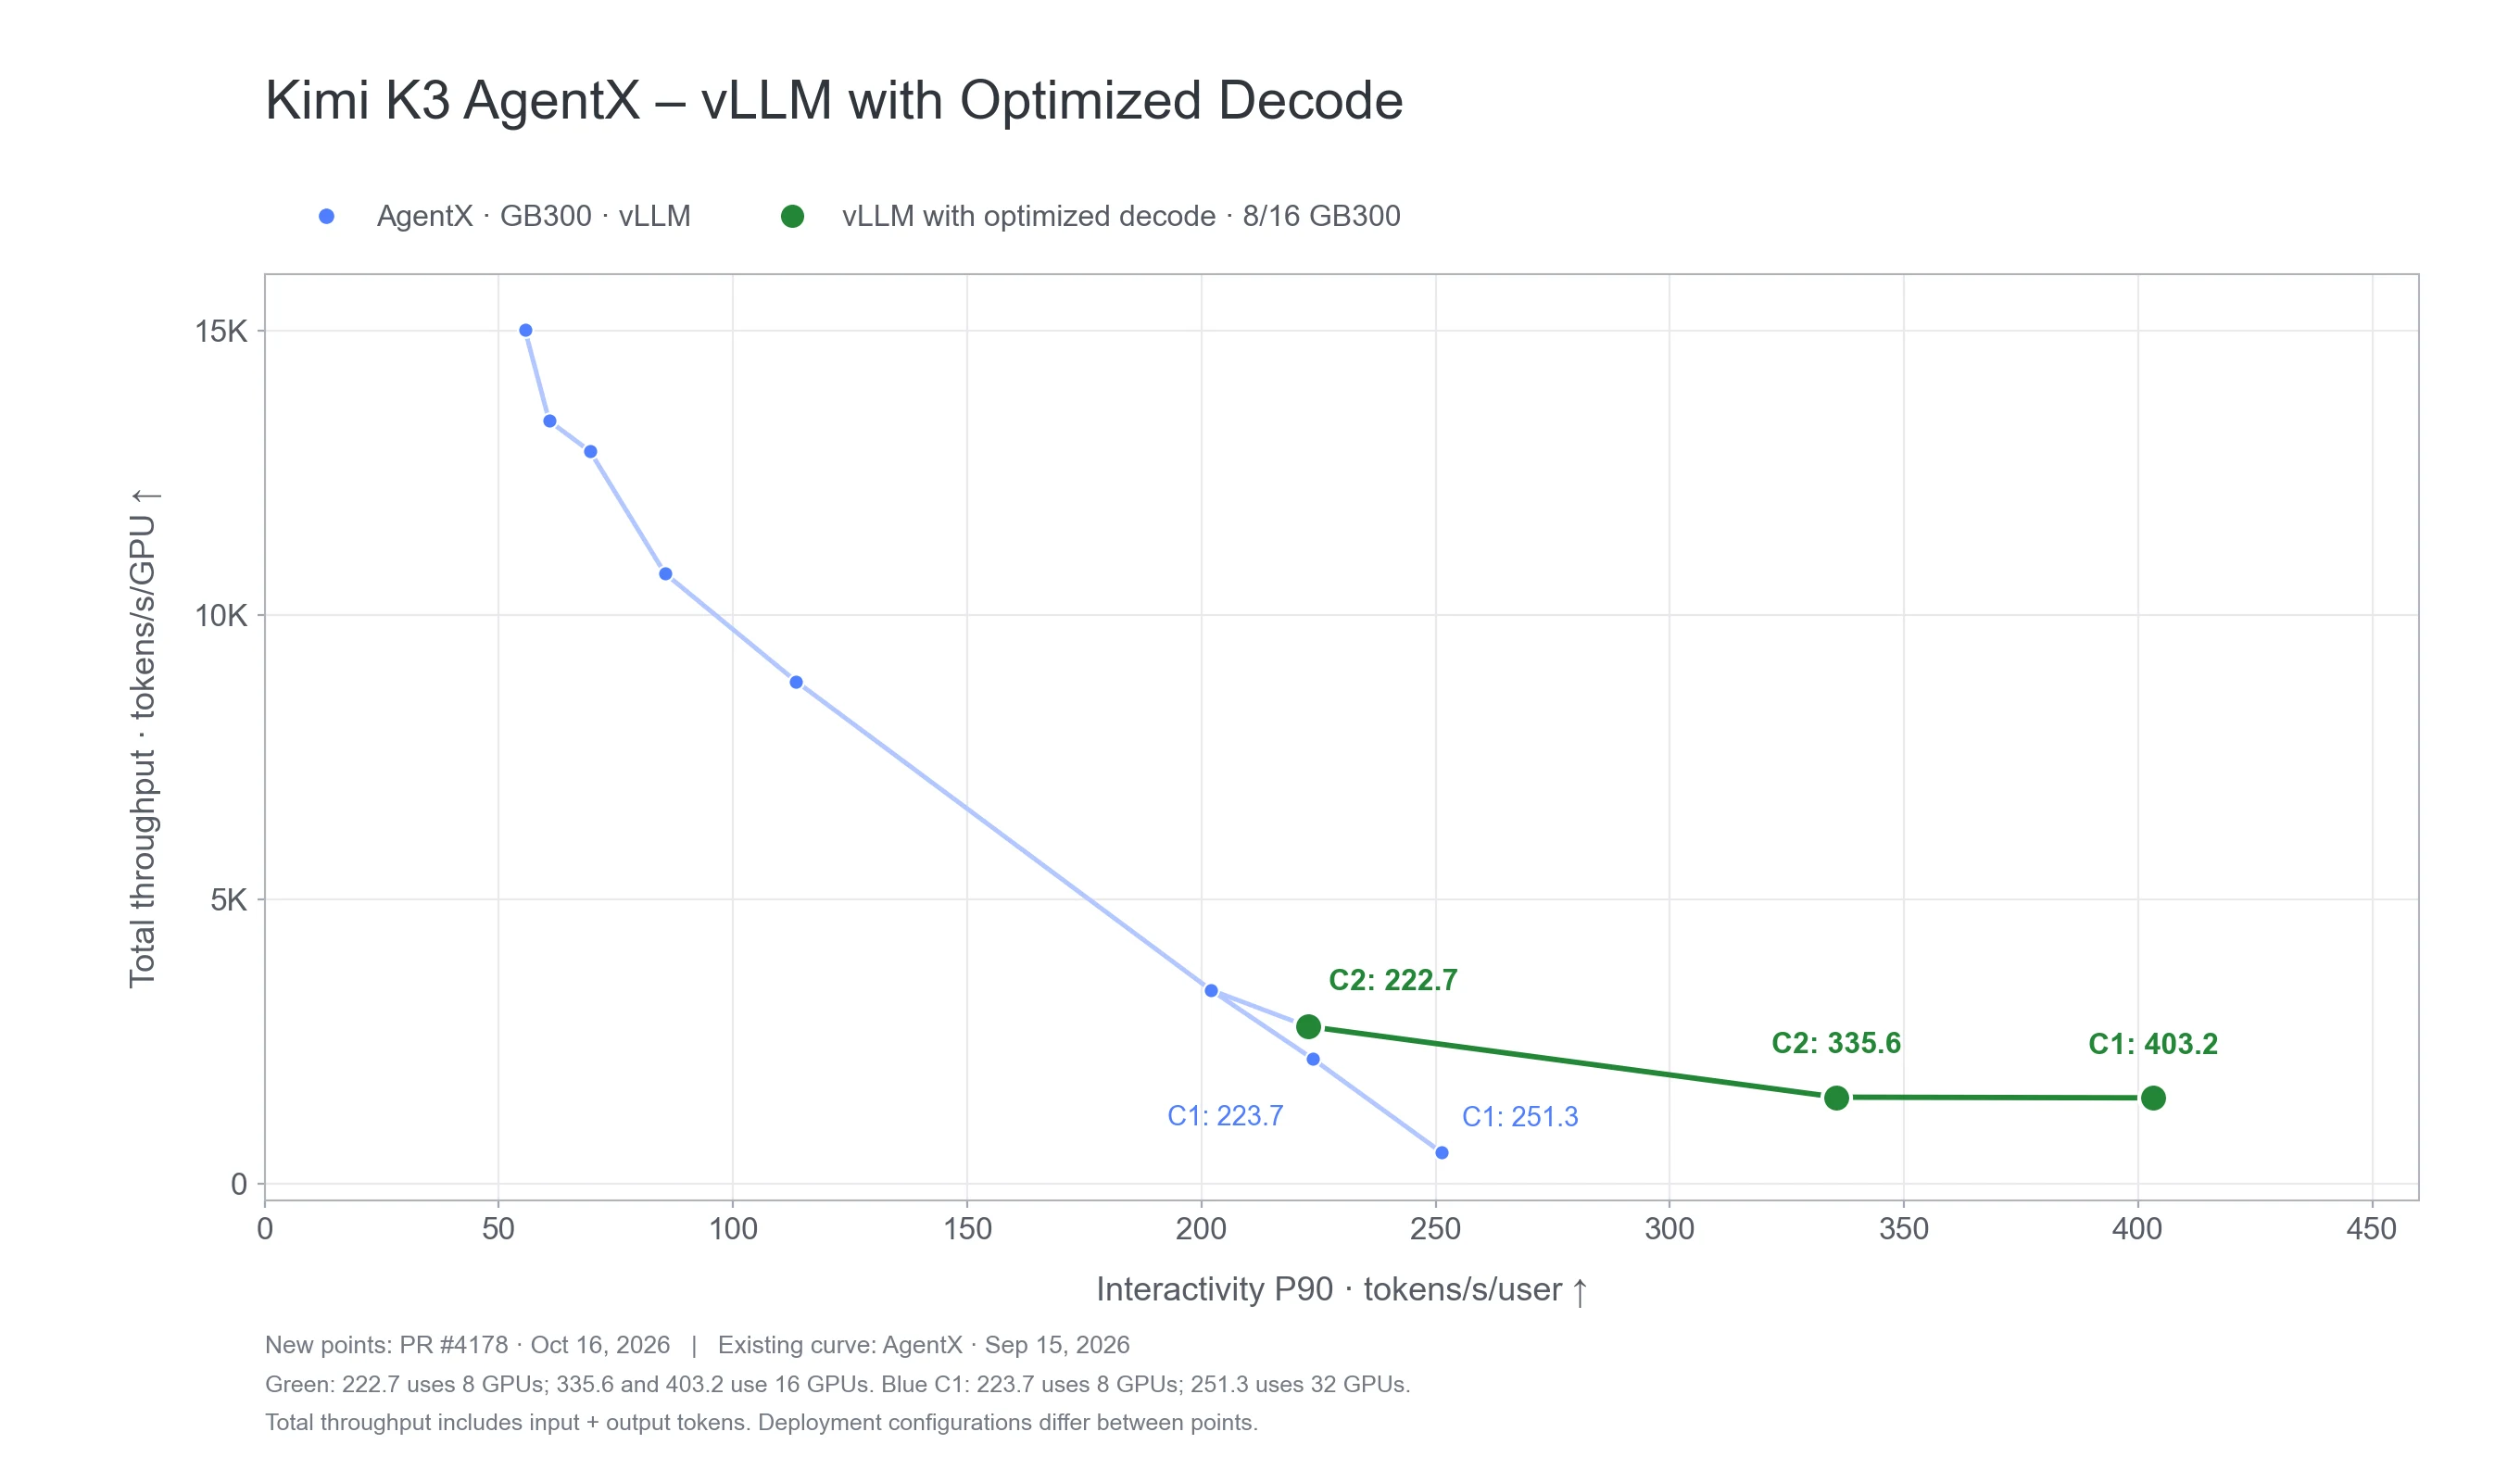
우리가 최적화한 Kimi K3 구현은 AgentX에서 동시성 수가 1일 때 1.8배 더 높은 P90 상호작용성을 제공합니다: 403.2 대비 223.7 토큰/초/사용자. 이는 16 GB300 GPU에서 이루어진 최적화된 실행 결과와 8 GB300 GPU에서 이전 vLLM 결과를 비교한 것입니다.
AgentX는 실제 코딩 에이전트 세션의 트래픽 패턴을 재생산합니다. 여기에는 긴 컨텍스트, 여러 대화 턴, 도구 정지, 병렬 하위 에이전트, KV 캐시 재사용 등이 포함됩니다. AgentX는 이러한 작업 부하 패턴을 보존하면서 사적인 내용을 합성 텍스트로 대체하여, 현실적인 에이전트 트래픽 하에서 서비스 시스템을 테스트합니다. AgentX 방법론.
다음은 무엇인가요?
DeepSeek-V4.1-Flash의 경우, #61868는 K3 디자인 패턴을 따릅니다: 동일한 opt-in decode_backend: latency_specialized 스위치 뒤에 구현은 최대 64개의 동시 요청을 지원하며, 프리필과 혼합 배치에 대한 원활한 대체 기능 및 추측적 디코딩도 제공합니다. 단일 핫스팟을 추적하는 대신, 이 실행기는 커널과 호스트 작업을 분리합니다: 모든 서브레이어 경계에서 all-reduce + mHC를 결합하고, 대규모 배치 MoE 및 GEMMs를 저지연을 위해 구축된 CuTe DSL 커널로 교체하며, 인덱서의 작업을 중복 제거하고 샤드화하고, vLLM이 CPU에서 즉시 실행하는 단계별 작업을 CUDA 그래프 형태로 재생성합니다.
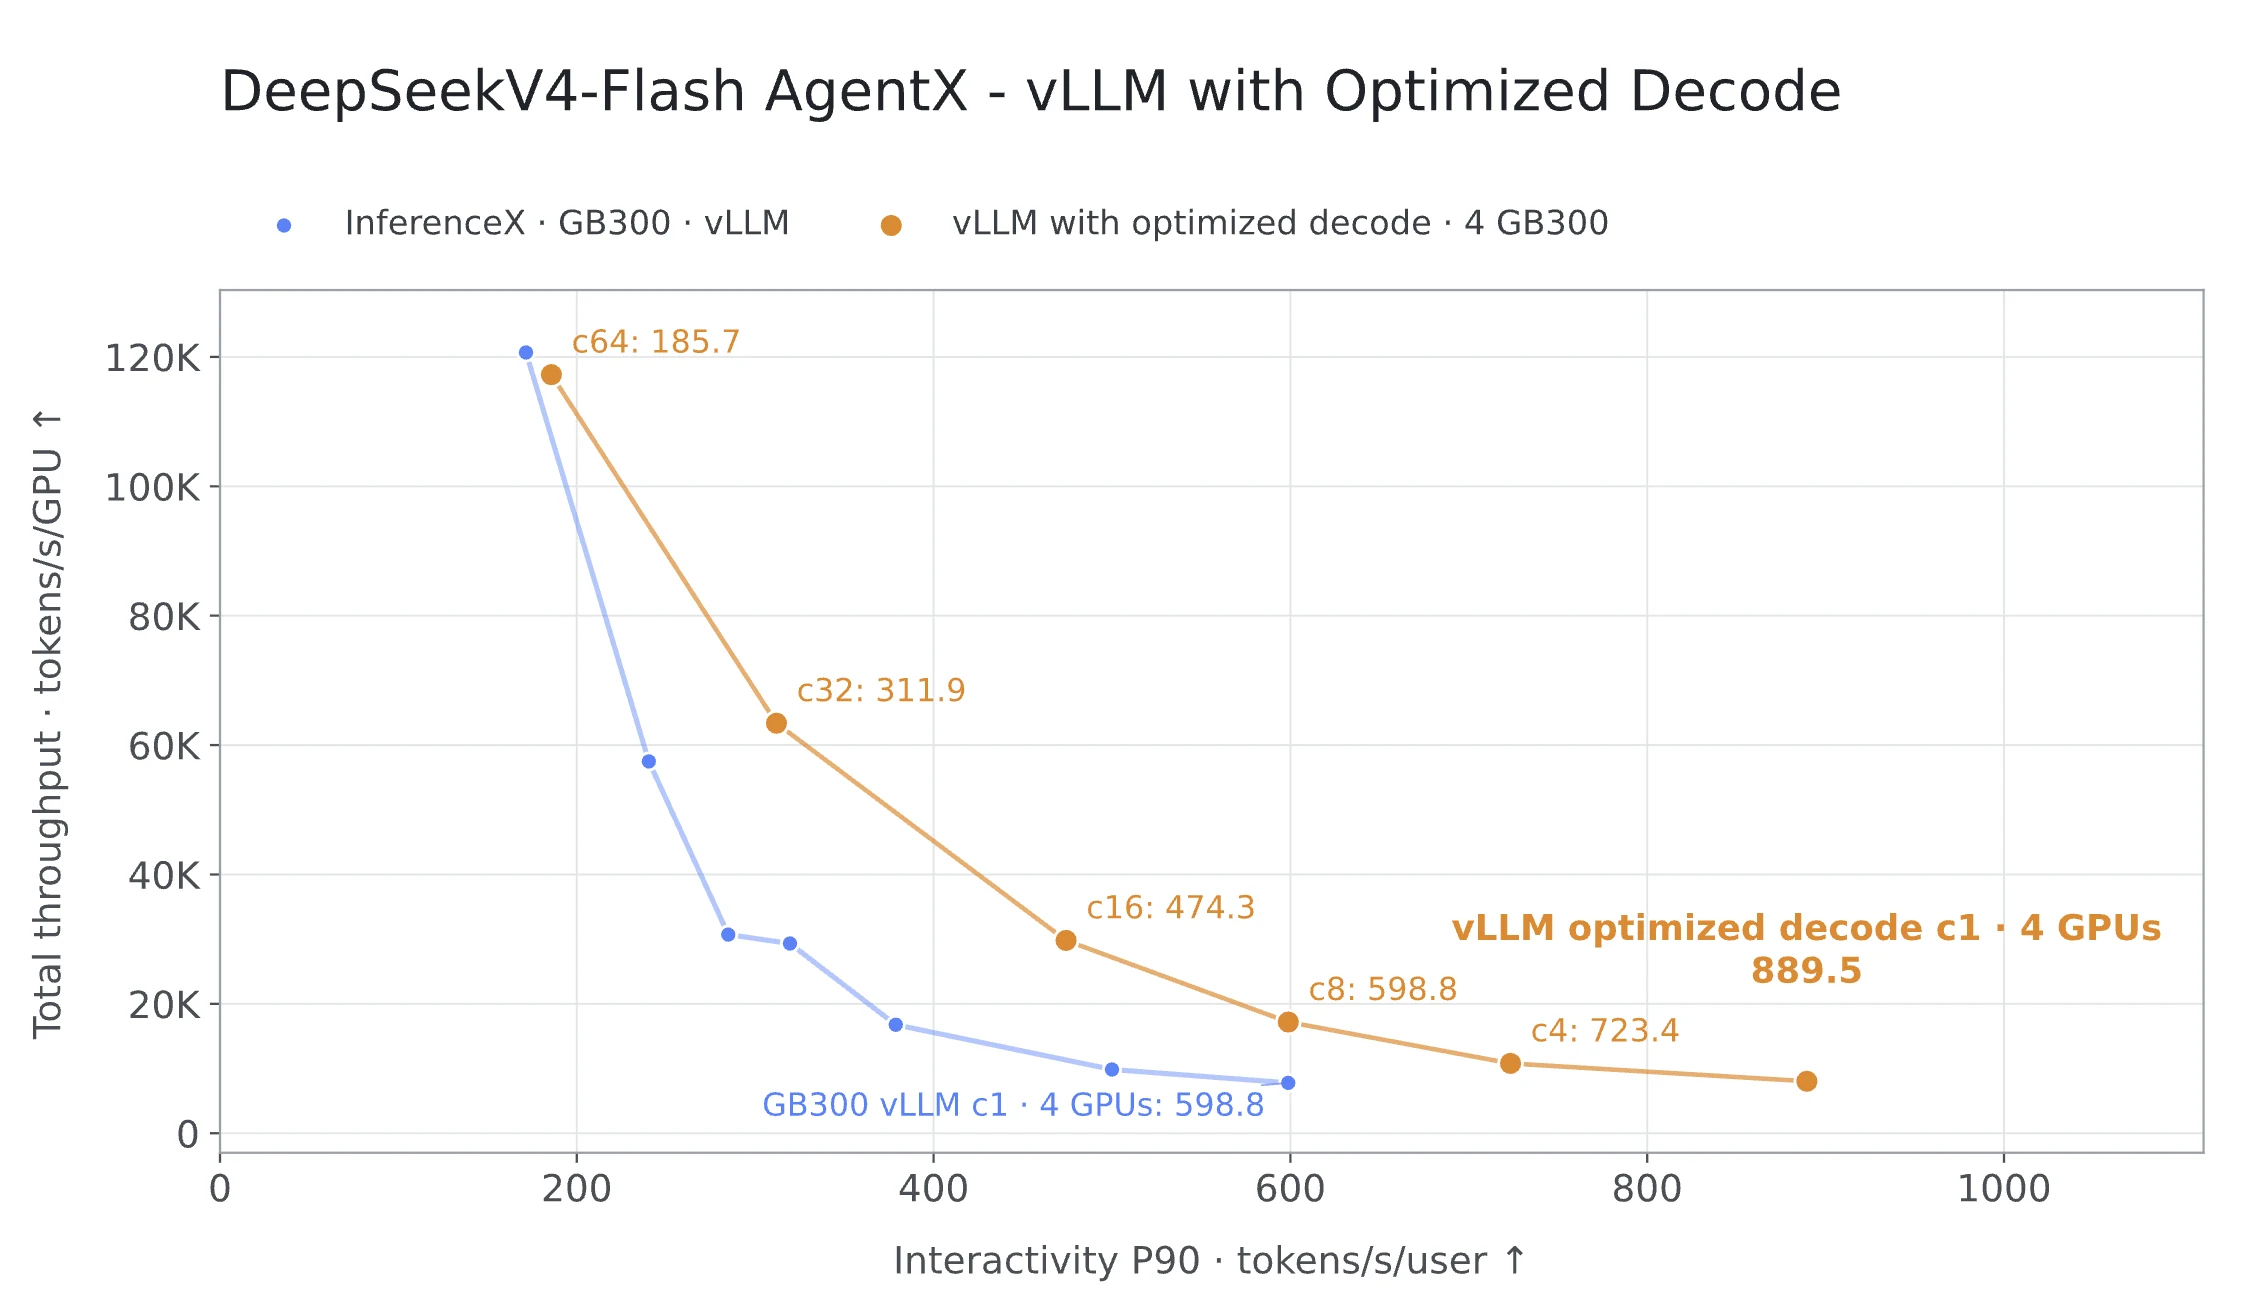
Meta의 Muse Spark Open 출시 후 이틀 만에, 우리의 초기 결과는 1명당 초당 950토큰를 넘겼으며, 드래프트 토큰은 7개이고 수락 길이는 6개입니다. 더 많은 최적화 작업이 진행 중입니다.
저희는 낮은 동시 접속 상황에서 GLM5.3의 디코드 지연 시간을 최적화하기 위한 유사한 메커니즘도 발표합니다. 그 최적화 세부 사항과 성능 결과는 후속 보고서에서 공유할 예정입니다.
각 기여에 대해, 우리는 구체적인 성능 향상, 생산 기능 지원, 그리고 재현 가능한 정확성 및 성능 검사에 계속 집중할 것입니다.
감사의 말
이 연구에 기여해 주신 로한 바르마(NVIDIA)와 알렉스 스타인er(NVIDIA)에게 감사드립니다.
We would also like to thank Woosuk Kwon (Inferact), 그리고 Michael Goin과 Lucas Wilkinson (Red Hat)에게 모델 리팩토링과 귀중한 피드백 및 지원에 대해 감사드립니다.