
IT之家 10월 17일 소식, 외국 매체 Wccftech에 따르면 개발자 abhi245y는 베테랑 AI 엔지니어 Mert Cobanov의 PS5LM(llama.cpp 포팅 프로젝트)을 기반으로 네이티브 GPU 앱 PS5LM Plus를 개발하여, 탈옥된 PS5 콘솔이 Qwen3.8-27B 등 대형 언어 모델을 로컬에서 실행할 수 있도록 했습니다.
IT之家가 확인한 바에 따르면, PS5LM의 초기 버전은 주로 CPU로 모델을 실행했으며, 27B 파라미터 모델을 실행할 때 평균 분당 약 1개의 token만 생성할 수 있었습니다. 성능을 개선하기 위해 개발자 abhi245y는 Mesa 오픈소스 프로젝트의 AMD RADV 드라이버를 포팅하고, Vulkan 컴퓨트 인터페이스를 통해 llama.cpp가 네이티브 앱으로 PS5에서 실행될 수 있도록 했습니다. 이 변경으로 사용 가능한 메모리가 약 6GB에서 11.4GB로 늘어나, 콘솔이 고도로 양자화된 Qwen3.8-27B 모델을 실행할 수 있게 되었습니다.
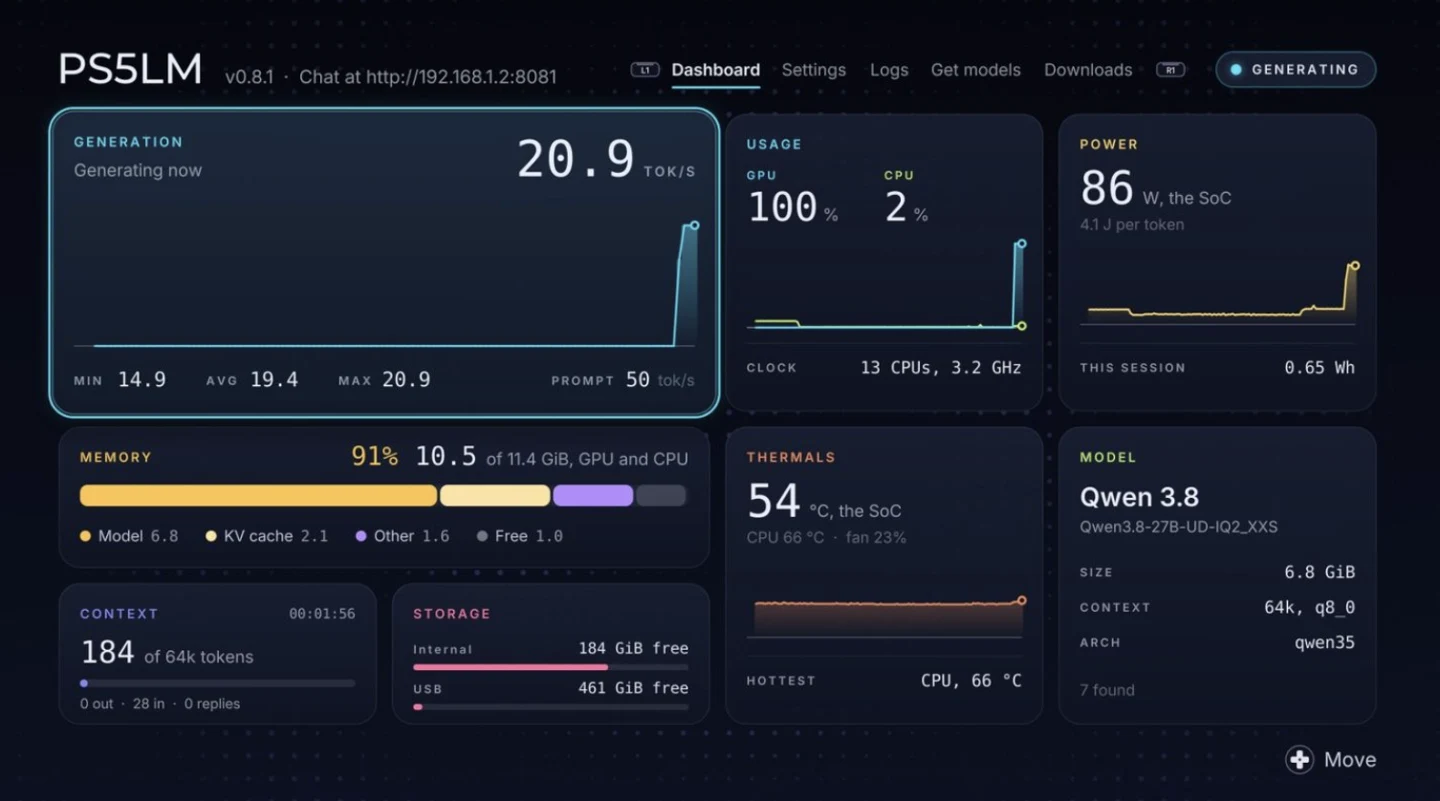
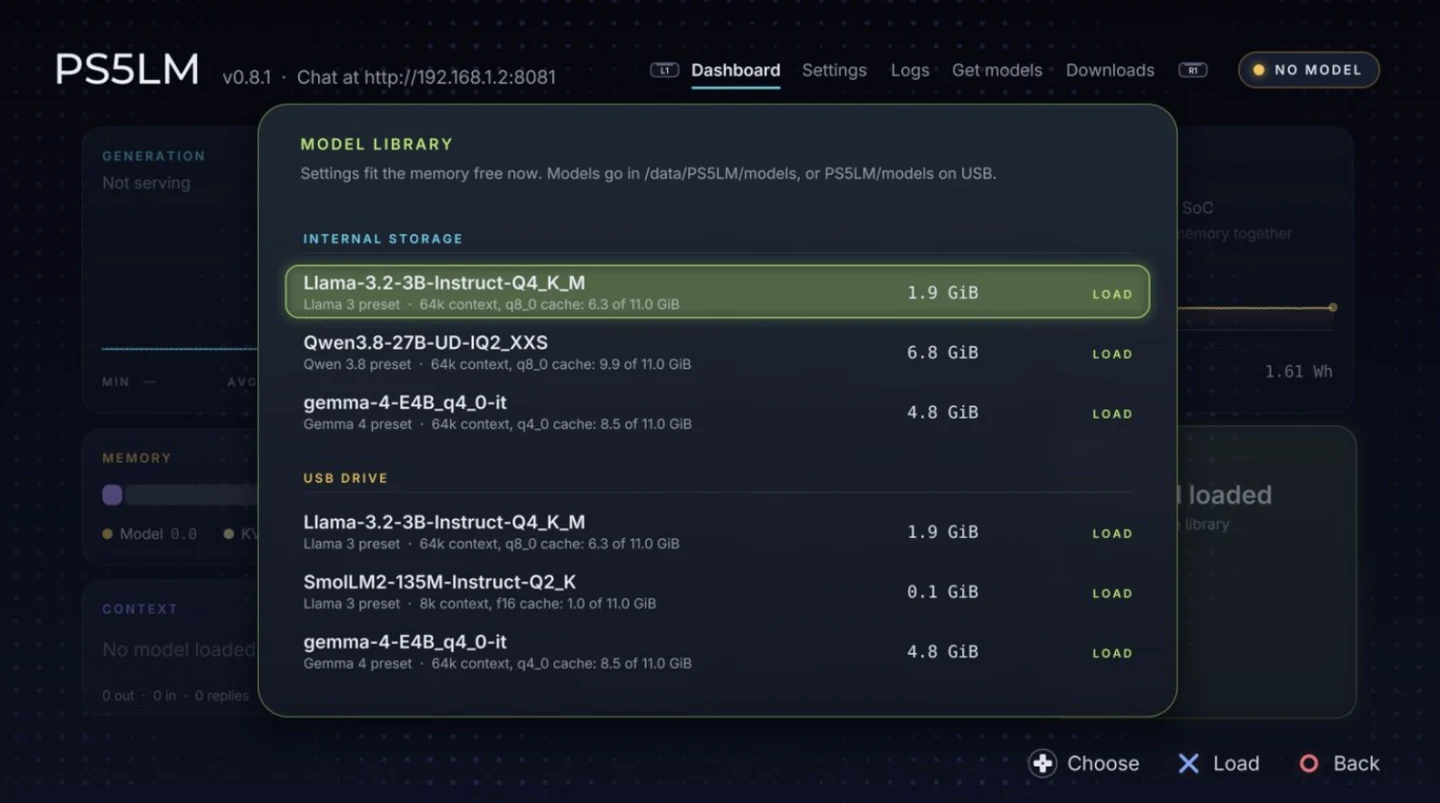
PS5의 높은 메모리 대역폭(448GB/s) 덕분에 Qwen3.8-27B의 생성 속도는 초당 20.9 token에 달할 수 있습니다. 테스트 중 GPU 사용률은 100%에 도달한 반면 CPU 사용률은 2%에 불과했습니다. 더 작은 규모의 모델의 경우 PS5는 더 높은 생성 속도를 달성할 수 있으며, 예를 들어 Gemma 4 E4B는 초당 약 61 token, Llama 3.2 3B는 초당 124 token에 도달했습니다.
PS5의 GPU로 모델 추론을 가속하는 것 외에도, PS5LM Plus는 웹 채팅 인터페이스를 내장하고 있으며, 로컬 네트워크의 8081 포트를 통해 API 서비스를 제공하여 사용자가 같은 네트워크의 다른 기기로 페이지에 접속해 로컬에서 실행 중인 모델과 대화할 수 있습니다. 이 프로젝트는 OpenAI 및 Anthropic API와도 호환되어, opencode, Codex, Claude Code 등의 도구가 PS5에서 실행 중인 모델을 호출하기 편리합니다.
주로 게임용으로 설계된 콘솔인 PS5가 로컬 AI 서버 역할을 하며 대형 모델 추론에 GPU 가속을 제공할 수 있다는 점은 게임 외 분야에서의 하드웨어 활용 가능성을 보여줍니다. 다만 이 기기에 탑재된 16GB RAM 통합 메모리는 여전히 모델 선택과 실행 품질을 제한합니다. 또한 네이티브版 llama.cpp를 실행하려면 먼저 PS5를 탈옥해야 하며, 게임기 및 PSN 계정이 정지되는 등의 위험이 발생할 수 있습니다.