Ultrafast 모드 미리보기: 최대 14배 속도의 GPT-5.6 Sol
GPT-5.6 Sol을 최대 14배 빠르게 실행하는 새로운 OpenAI API 서비스 등급인 Preview Ultrafast를 미리 만나보세요. Cerebras로 구동되며 초당 최대 750개의 출력 토큰을 제공합니다.
AI 소식의 출처와 시점을 한곳에서 확인하세요.
GPT-5.6 Sol을 최대 14배 빠르게 실행하는 새로운 OpenAI API 서비스 등급인 Preview Ultrafast를 미리 만나보세요. Cerebras로 구동되며 초당 최대 750개의 출력 토큰을 제공합니다.
OpenAI가 Dali Rajic를 최고 매출 책임자(CRO)로 임명하고, 그가 글로벌 매출 조직을 이끌며 기업들이 AI의 전체 가치를 실현하도록 지원하게 됩니다.
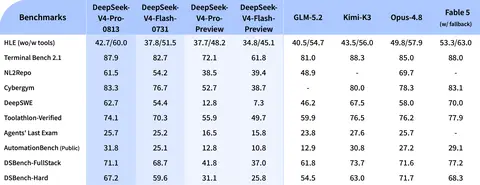
DeepSeek-V4-Pro의 GA 릴리스가 APP, Web, API에 배포되었습니다. API 호출 방식은 변경되지 않았습니다 — 모델 이름을 deepseek-v4-pro로 설정하기만 하면 최신 버전을 사용할 수 있습니다. DeepSeek V4 Pro의 GA 버전은 에이전트 기능을 크게 향상시켰으며, 특히 프로덕션 환경에서 성능 개선이 두드러집니다. DeepSeek API는 이제 OpenAI Responses API 형식을 기본 지원하며 Codex에 특별히 최적화되어 있습니다. 사용자는 공식 문서를 참고하고 원클릭 구성 스크립트로 Codex 구성을 완료할 수 있습니다. V4-Pro와 V4-Flash의 사고 모드는 이제 low / high / max의 세 가지 사고 노력 수준을 지원합니다. 실제 사용에서 사용자는 작업 복잡도에 따라 유연하게 선택할 수 있습니다: 간단한 작업에는 low를, 일상적인 Agent 작업에는 high를, 더 복잡한 시나리오에는 max를 사용하십시오. 설정 방법은 공식 API 문서인 Thinking Mode를 참고하십시오. DeepSeek V4 모델 패밀리의 공식 출시와 함께 API 가격을 업데이트하고 조정할 예정입니다. 자원을 보다 합리적으로 배분하기 위해 피크/오프피크 가격제를 도입하며, 오프피크 가격은 피크 시간 가격의 절반으로 설정하여 사용자가 일정을 조정하도록 장려합니다
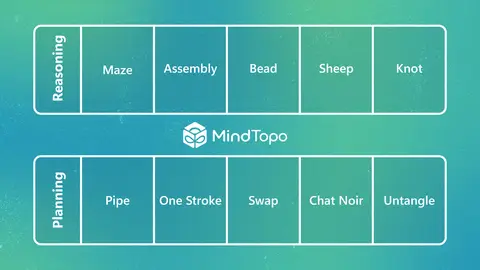
경로, 울타리, 매듭. MindTopo는 AI가 위상적 관계를 어떻게 이해하는지 테스트하기 위한 새로운 벤치마크를 제시하고 공간 추론과 계획을 강화할 새로운 기회를 부각합니다. 이 글 MindTopo는 VLM의 공간 추론 능력을 드러냅니다은(는) Microsoft Research에서 처음 게시되었습니다.
수어-텍스트 변환(SL2T)을 소개합니다. 청각장애인과 난청 사용자를 위한 새로운 수어 기능을 구동하는 우리의 획기적인 모델입니다.
Health & Bioscience
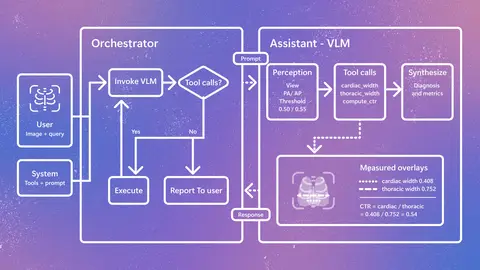
방사선 AI는 보고서 생성을 넘어 진화하고 있습니다. CARE-X는 유연한 추론, 보정된 예측, 측정 기반 도구를 결합한 통합적 접근 방식을 통해 흉부 X-ray 판독을 탐구합니다. Introducing CARE-X: Towards Clinically Useful Radiology VLMs with Auxiliary Supervision, Reward-Aligned Learning, and Tool-Augmented Measurement라는 글은 Microsoft Research에서 처음 게시되었습니다.
Mistral은 유럽이 자신의 AI 미래를 통제하는 데 필요한 추론 인프라, 오픈 모델, 장기적 약속을 결집하고, 세계를 위한 로드맵을 제시합니다.
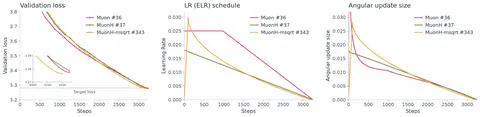
대규모 언어 모델(Large Language Models, LLM) 사전 학습에서 하이퍼파라미터는 성능의 좋고 나쁨과 모델 학습 역학을 제어하는 핵심 요소입니다. 그중 학습률(Learning Rate, LR)은 사전 학습에서 가장 중요한 하이퍼파라미터 중 하나이지만, 모델 파라미터의 진화 속도를 정밀하게 제어할 수 없으며, 그 최적값은 모델과 데이터 규모가 확대됨에 따라 자주 바뀝니다. 본 논문은 모델 가중치의 방향 변화를 제어하기 위해 유효 학습률(Effective Learning Rate, ELR)을 도입합니다. 조정 가능한 하이퍼파라미터로서 ELR은 LR보다 학습의 내재적 역학에 더 가까우므로 더 적합한 튜닝 기준입니다: 다중 멱법칙(Multi-Power Law, MPL) 모델에서 ELR을 기준으로 삼으면 손실을 더 정확하게 예측할 수 있고, 최적 ELR도 서로 다른 규모의 모델로 더 안정적으로 전이될 수 있습니다. 나아가 ELR이라는 관점은 더 적합한 LR 스케줄링 전략을 설계하도록 안내할 수 있으며, 실험에서 일반적인 LR 스케줄링 전략 기준선보다 우수합니다.
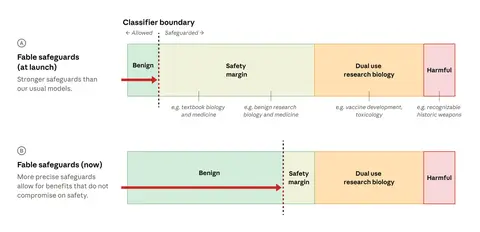
우리는 Claude Fable 5의 생물학 안전장치를 업데이트하여 오탐(false positives)을 크게 줄이고 있습니다. 이제 Fable 5 사용자는 생물학 관련 질문을 한 후 시스템이 더 낮은 성능의 모델로 전환되는 '폴백(fallback)'을 훨씬 적게 경험하게 됩니다.
네이티브 음성·영상 전이중 대규모 모델로서 소리, 화면과 시간 순서 정보를 함께 이해하여 보면서, 들으면서, 말하는 자연스러운 상호작용 경험을 선사합니다
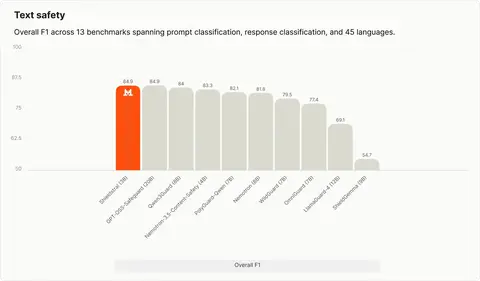
Shieldstral은 콘텐츠 모더레이션을 정책 적응형 질의응답 작업으로 프레이밍하여 최대 7배 큰 모델들을 능가하는 3B 오픈 웨이트 멀티모달 안전 분류기를 소개합니다.
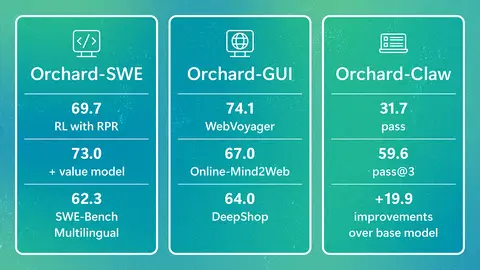
Orchard는 연구 커뮤니티가 다양한 작업 유형 전반에서 AI 에이전트를 훈련하고 평가할 수 있도록 하는 오픈소스 프레임워크입니다. 이는 연구자들이 동일한 인프라를 재사용할 수 있게 함으로써 복잡성을 줄이면서도 더 작은 모델에서 강력한 성능을 지원합니다. Orchard: 확장 가능한 에이전트형 AI를 위한 오픈 프레임워크라는 글은 Microsoft Research에 처음 게시되었습니다.
오늘 우리는 Qwen 3.8-Max를 공식 발표했습니다. 이는 현재 Qwen 패밀리에서 가장 강력한 모델입니다. 이는 또한 Qwen-Max급 모델의 가중치가 처음으로 오픈소스화된다는 것을 의미합니다——가중치는 다음 주에 오픈소스로 공개될 예정이니 기대해 주세요. Qwen 3.8-Max는 Qwen 3.5의 아키텍처 기반 위에 구축되었으며, 파라미터 규모가 2.4조로 확장되어 프로그래밍, 사무, 과학 연구 및 장기 주기 작업 등에서 전면적인 향상을 이루었습니다. 이는 더 도전적인 문제에 대응할 수 있을 뿐만 아니라, 더 안정적으로 엔드투엔드 복잡한 작업을 완수하고 신뢰할 수 있는 성과를 출력합니다.
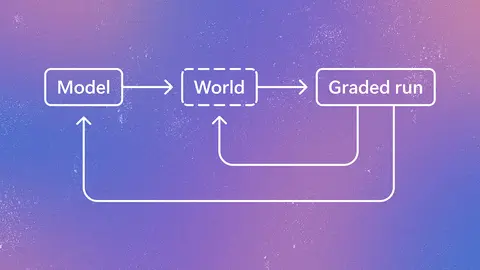
컴퓨터 사용 AI 에이전트는 이메일과 고객 지원 같은 다단계 워크플로에 어려움을 겪습니다. Echoverse는 단순히 더 많은 훈련 과제를 제공하는 대신 현실적인 환경에서 에이전트를 훈련시켜, 과제와 테스트, 환경이 진화함에 따라 에이전트가 함께 향상되도록 돕습니다. 이 글 'Echoverse: 컴퓨터 사용 에이전트를 위한 깊고 진화하는 환경'은 Microsoft Research 에 처음 게시되었습니다.