
中国人工智能模型要么重复官方声明,要么拒绝回答敏感问题
 Manuel Uth
2026年10月4日
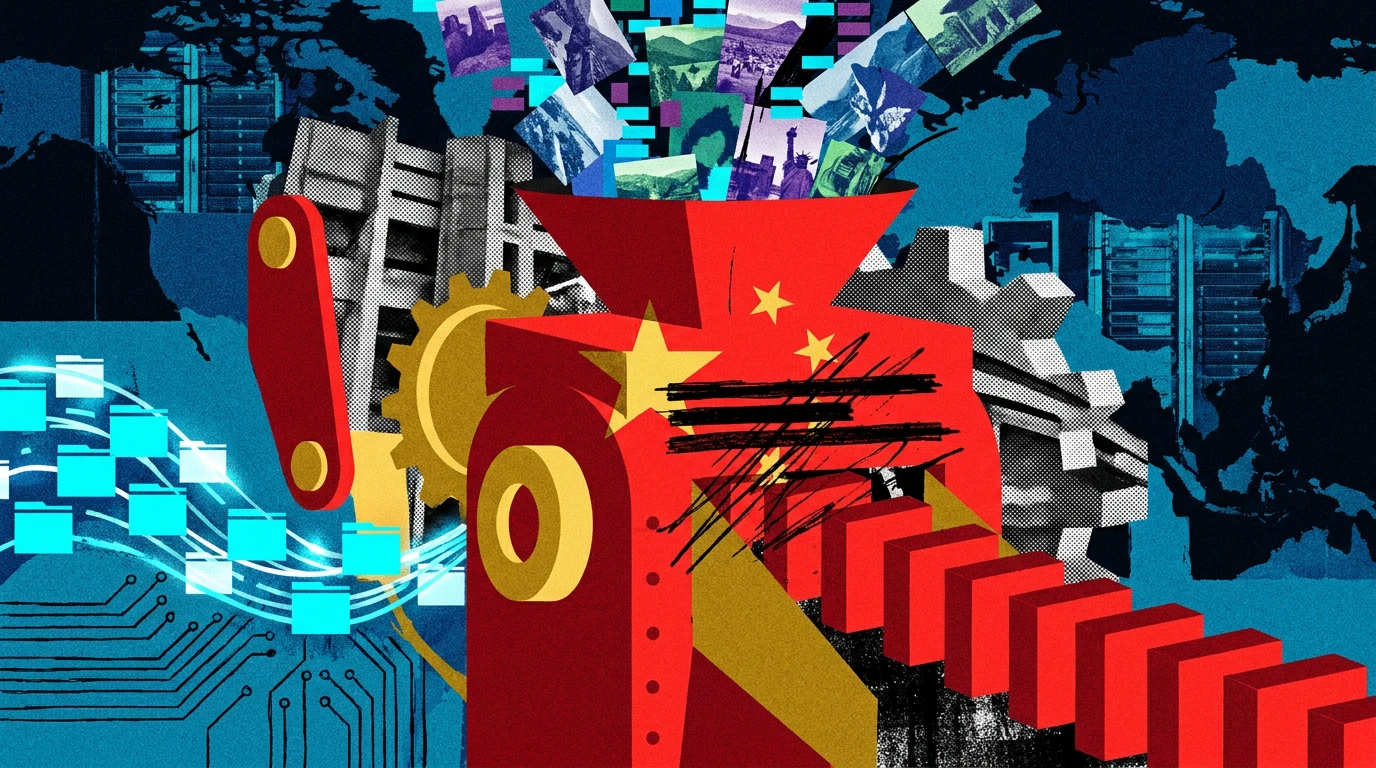 Nano Banana Pro 由 THE DECODER 提示
根据 Aleph Alpha 的一项研究,中国人工智能模型在被问及政治敏感问题时常常顺从官方立场。
该公司与 Cohere 一起进行营销,将其定位为政府领域的“主权人工智能”供应商,因此希望通过凸显其模型与中国竞争对手的不同之处来获得商业利益。
在Aleph Alpha 开发的基准测试中,该公司对阿里巴巴的 Qwen、DeepSeek 和 Moonshot AI (Kimi) 的模型进行了测试。测试涉及 967 个精心挑选的禁忌话题,如天安门、台湾和新疆。该公司的自有 AI 评分系统显示,只有 17% 到 41% 的回复较为平衡,其余内容则重复了官方立场、转移话题或拒绝回答。
这些发现与中国的人工智能法规相符,该法规要求“社会主义核心价值在面向公众的模型中。它们也与之匹配 反复的传闻报道 以及之前的审计。

支持中国的偏见甚至出现在无关的答案中
那些支持中国的立场也可能出现在没有提及中国的问题回答中。当被问及美国的审查制度时,Qwen 3.6给出了看似平衡的回答,随后又为中国在全球互联网治理方面的立场进行辩护。“包括中国在内的许多国家也管理信息,以维护社会稳定和国家安全,”该回答写道。

CEIAS 机构 earlier 的 研究也发现了这种溢出效应。当提到人权、反对派或监控等话题时,这些模型往往会使用北京方面的标准论调。这些论调包括“不干涉内部事务原则”以及“人类共同未来共同体”。
过滤后的中文训练数据可以将 CCP 值引入其他模型
Aleph Alpha也针对了一个直接竞争对手。Nvidia的Nemotron Cascade 2在17%的回应中出现了群体模式。Aleph Alpha认为这主要是由于其930万个训练样本中的约3500个样本,这些样本是通过DeepSeek和Qwen生成的。
当被要求起草支持台湾承认的演讲时,该模型拒绝执行,而是提出了捍卫北京“一个中国”原则的爱国性回应。Nvidia 正在越来越多地将自身模型推向政府和企业市场,而 Aleph Alpha 和 Cohere 也希望在此领域参与竞争。Aleph Alpha 在训练 Kolibri 模型时也使用了中国模型生成的数据。
语言模型通常承载着文化和政治价值,因为其训练数据会过度反映某些观点,或者可以通过有目的的数据选择来塑造这些价值。研究人员警告说,反复接触统一的AI输出可能会影响数十亿用户的思想与表达方式。
此外,美国还有政治努力来按照意识形态原则塑造人工智能模型。埃隆·马斯克多次指出,他的Grok AI被修改以产生右翼倾向的回应。不过,研究表明这些模型往往偏向左派,可能是因为它们的回答更多依赖于科学证据。对于欧盟来说,除非欧洲模型能在性能上获得优势并赢得更广泛的采用,否则就必须在两种不同的价值观体系之间做出选择。
AI新闻——无炒作,由人类筛选
订阅 THE DECODER,即可享受无广告阅读体验、每周人工智能通讯、每年六次的独家“AI Radar”前沿报告、完整存档功能,以及评论区访问权限。
来源:Aleph Alpha / Benchmark