
当多智能体系统从实验走向生产时,一个关键的挑战是确保这些系统在真实世界场景中始终做到有帮助、准确且可解释。企业正越来越多地采用多智能体系统来解决复杂的现实问题,这些问题需要在数据源、工具和业务约束之间进行推理。从供应链规划到财务分析和客户运营,这些系统的作用已超越简单的问答。它们协调多个专门的智能体来制定决策、执行工作流程并生成可操作的建议。
虽然大型语言模型能够生成流畅的回应,但企业应用需要更深入的保障,即智能体必须可靠地遵循指令、选择正确的工具、遵守约束条件,并为其输出提供清晰的推理依据。
Amazon Bedrock AgentCore 是一个平台,用于使用任何框架或模型大规模构建、连接和优化智能体。 Amazon Bedrock AgentCore Evaluations是 Amazon Bedrock AgentCore 的一项功能,旨在通过完全托管的能力评估智能体在开发和生产全过程中的表现,从而应对这一挑战,让团队能够在多个质量维度上衡量准确性、任务成功率和行为。仅关注模型响应质量的传统评估方法对于智能体系统而言是不够的,因为智能体系统的正确性取决于工具选择、工作流执行以及对业务约束的遵守。除评估之外,智能体系统的生产部署还需要负责任的 AI 控制。 Amazon Bedrock Guardrails 提供可配置的防护措施,例如内容过滤、拒绝主题检测和接地验证,与评估框架相辅相成。评估是在执行之后评估智能体质量,而 Guardrails 则在执行期间强制执行安全约束。在这篇文章中,我们重点介绍如何通过 Amazon Bedrock AgentCore Evaluations 对内置评估器和自定义评估器的支持来运营这一评估框架。内置评估器为常见质量维度(如有用性、任务成功率和指令遵循)提供预定义评估,使团队无需额外设置即可快速为智能体性能建立基线。然而,企业用例需要更深入的、针对特定领域的验证。自定义评估器解决了这一问题,让您可以定义具备业务感知的检查。
我们还特别关注可解释性这一一等评估维度。我们演示内置评估器如何评估一般的响应清晰度。我们展示如何使用自定义评估器来验证智能体是否明确阐述决策理由、引用支持数据或工具输出,并解释诸如成本与服务水平之间的权衡。通过组合这些评估器,我们展示了 AgentCore Evaluations 如何超越表层的响应质量,为智能体如何以及为何做出决策提供结构化、可衡量的洞察。
为了使这些概念更加具体,以下各节将介绍一个参考架构和实现,展示这些组件在实践中如何协同工作。
解决方案概览
在这篇文章中,我们使用一家名为 AnyCompany Retail 的虚构全球零售公司,这是一家跨国零售商,运营电商渠道、区域履约中心、配送中心以及数千家实体店。AnyCompany 频繁面临库存失衡问题:一些地区在促销期间出现缺货,而另一些地区则库存过剩。运输团队还必须平衡交付速度、承运商运力和成本。该公司希望拥有一个智能体助手,能够帮助规划人员优化库存分配、推荐配送调整、分析库存健康状况,并模拟路由或履约场景。
您将使用 Strands Agents SDK, Amazon Bedrock AgentCore MCP Server 以及 Amazon Bedrock AgentCore Evaluations 构建并评估一个多智能体供应链决策系统。该解决方案使用 Strands Agents,包含一个编排智能体和四个专用子智能体:优化智能体、配送智能体、路由智能体和分析智能体。每个智能体都在 Amazon Bedrock AgentCore runtime 上运行,并启用了 Amazon Bedrock AgentCore memory 和 Amazon Bedrock AgentCore Observability 。
编排器(orchestrator)智能体接收规划器的请求,并将工作委派给以工具形式暴露的专用智能体。优化智能体调用由模拟 Amazon API Gateway REST 接口支持的 MCP 工具,这些接口返回优化决策。分发智能体调用推荐 API,以建议在履约中心、门店和数字渠道之间进行库存重新平衡。路由智能体调用物流 API 来推荐承运商和路线选项,分析智能体则回答供应链诊断问题。该解决方案在智能体循环中使用 Amazon Bedrock 上的基础模型。有关按区域提供的模型,请参阅 Amazon Bedrock 按 AWS 区域支持的模型。
该解决方案使用内置评估器来评估一般质量维度,例如有用性和任务完成度。它还提供自定义评估器,用于评估供应链特定行为,例如约束满足、路线可行性、SQL 正确性、库存依据(inventory grounding)和解释质量。AnyCompany 可以同时评估响应的语言质量和智能体决策的业务有效性。
该解决方案通过 Amazon Bedrock AgentCore Evaluations 支持按需(on-demand)和在线(online)两种模式。按需模式用于开发基准测试、回归测试以及持续集成和持续交付(CI/CD)门禁。在线模式用于持续的生产监控和告警。这两种模式都能帮助您闭环并根据用户反馈采取行动。用于按需评估的同一批自定义评估器(例如供应链解决方案中的约束满足、路线可行性、SQL 正确性和可解释性评估器)被重新用于 OnlineEvaluationConfig 对象,该对象引用评估器的 Amazon Resource Names(ARN)并指定采样率(例如,生产追踪的 1–10%),以及可选的会话过滤器。该服务随后自动从 AgentCore Observability 读取追踪数据,对其进行评分,并将结果流式传输到 Amazon CloudWatch 仪表板和告警。在这篇文章中,您将使用按需模式来测试该解决方案。
以下架构图展示了我们解决方案的各个组件。
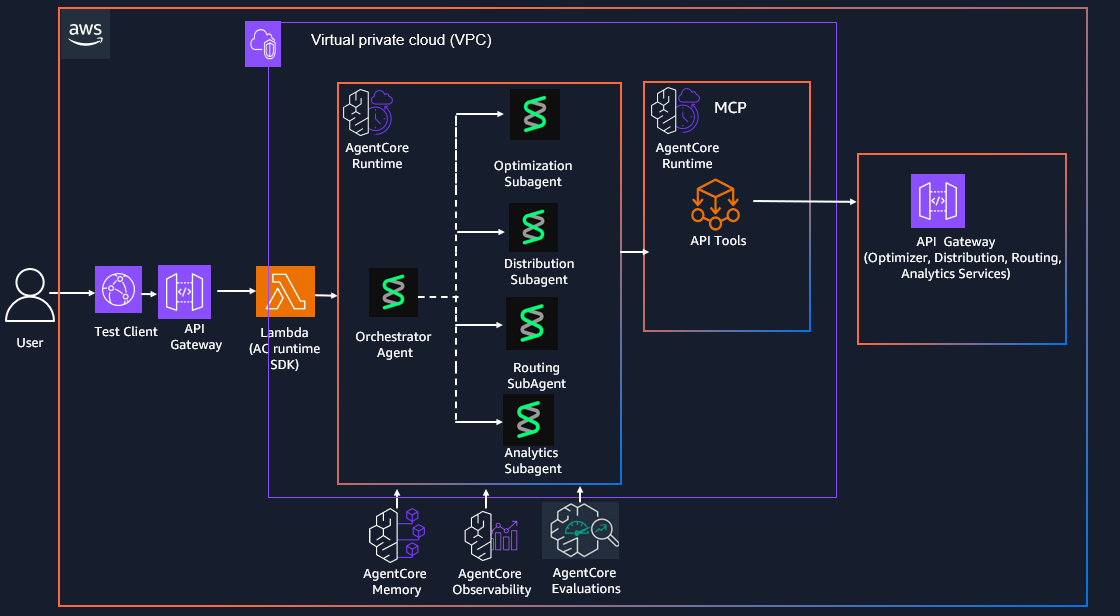
图 1:多智能体供应链决策解决方案的架构
评估框架
在这篇文章中,您将针对多智能体系统使用一种逐步建立企业信任的三层评估方法。该方法遵循清晰的递进结构:首先使用内置评估器评估一般质量,然后添加自定义评估器评估业务准确性,最后叠加可解释性评估器以实现信任和可审计性。
第一层使用无需任何设置的内置评估器。我们将 Helpfulness(有用性)作为通用基线,并针对每个智能体的主要失败模式添加第二个特定于智能体的评估器:编排器使用 Tool Selection Accuracy(工具选择准确性),优化和分发使用 Response Relevance(响应相关性),路由使用 Instruction Following(指令遵循),分析使用 Faithfulness(忠实性)。
第二层添加了编码领域特定业务规则的自定义评估器:优化使用约束满足,分发使用数据依据,路由使用路线可行性,分析使用 SQL 正确性,编排使用计划一致性。这些评估器验证业务有效性:推荐是否遵守预算限制、是否使用真实库存数据、是否产生了运营上正确的输出?
下表列出了您将在此处实现的、为每个智能体选定的两个内置评估器和一个自定义评估器。第二个内置评估器针对每个智能体的主要失败模式,而自定义评估器编码了验证运营正确性的领域特定业务规则。
| 智能体 | 内置评估器 | 自定义评估器 |
| 编排器智能体 | Helpfulness;Tool Selection Accuracy | 计划一致性评估器:它是否将子智能体的输出组合成一个有效且无矛盾的建议?工具轨迹评估器:它是否路由到了正确的子智能体? |
| 优化智能体 | Helpfulness;Response Relevance | 约束满足评估器:预算、库存覆盖(demand ≤ qty ≤ 2× demand)和仓库容量约束。关键绩效指标(KPI)达成评估器:是否达到履约率/收入提升目标。 |
| 分发智能体 | Helpfulness;Response Relevance | 推荐依据评估器:建议是否基于当前库存/需求数据。风险影响评估器:建议是否降低了缺货/积压风险。 |
| 路由智能体 | Helpfulness;Instruction Following | 路线可行性评估器:路线是否遵守交付窗口、成本、承运商容量和区域约束。服务水平协议(SLA)评估器:预期交付是否达到目标服务水平。 |
| 分析智能体 | Helpfulness;Faithfulness | SQL正确性评估器:查询符合用户意图。数据依据评估器:响应由Amazon Relational Database Service(Amazon RDS)查询结果支持。无未支持论断评估器。 |
可解释性
我们评估方法的第三层将可解释性评估器作为独立的、横切的检查应用于各个代理。这些评估器独立评估代理是否阐明决策依据、引用来自工具输出的支持性证据、解释哪些约束塑造了响应、阐明相互冲突目标之间的权衡、说明为何调用特定子代理,并在数据不完整时披露假设。通过将可解释性分离为独立的评估层,我们可以独立衡量透明度。一条建议可能准确但无法解释(通过自定义评估器但未通过可解释性),从而为团队提供可操作的信号,表明代理需要更好的推理表述而不是更好的决策逻辑。
下表定义了您在此实现的六个独立可解释性评估器,它们作为横切层应用于各个代理。这些评估器评估代理是否阐明推理、引用证据、解释约束与权衡,并披露假设。它们与准确性分开衡量,以便团队能够区分“无法解释但正确”的响应与“解释充分但错误”的响应。
| 评估器 | 代理 | 检查内容 |
| 决策依据质量 | 全部 | 代理是否解释了它为何给出该建议? |
| 证据归属 | Analytics、Distribution、Routing | 它是否引用了所使用的数据字段、API 响应或 SQL 结果? |
| 约束推理 | Optimization、Routing | 它是否解释了哪些约束塑造了最终响应? |
| 权衡解释 | Optimization、Distribution、Routing | 它是否解释了成本、服务水平和库存风险之间的权衡? |
| 工具使用可解释性 | Orchestrator | 它是否解释了为何调用每个子代理或 MCP 工具? |
| 假设披露 | 全部代理 | 当数据不完整时,它是否清楚地说明了假设? |
先决条件
在部署此解决方案之前,请使用以下工具设置您的开发环境。
- 安装 AWS Command Line Interface (AWS CLI)
- 安装 AWS Serverless Application Model (AWS SAM) CLI v1.100.0+
- 安装 Docker v20.x+
- 安装 Node.js v18.x+
- 安装 Python v3.11+
依赖项
Strands Agents 实现还需要以下依赖项,它们已打包在 DockerFile 中:
- strands-agents # Strands Agents 多智能体框架
- strands-agents-tools # Strands 智能体工具和实用程序
- requests # 用于 API 调用的 HTTP 库
- bedrock-agentcore # Amazon Bedrock 智能体核心功能
- boto3 # 适用于 Python 的 AWS SDK (Boto3)
部署并运行该解决方案
该解决方案可从我们的 GitHub 仓库 下载,并提供单步部署,以便在您的 AWS 环境中部署和访问该解决方案:
# Edit terraform.tfvars: set vpc_id and runtime_subnet_azs
cd terraform
cp terraform.tfvars.example terraform.tfvars
terraform init
terraform apply
输出内容包括运行时 ARN、AnyCompany Retail API URL、评估器 API URL 和内存 ARN。
运行该解决方案
按照以下步骤运行该解决方案:
test_client/ 文件夹包含一个 Python 脚本,该脚本使用 20 个示例查询(每个子智能体 5 个)调用已部署的供应链智能体,以验证端到端功能。每个类别都作为一个多轮会话运行,并在最后打印会话 ID,供评估器 API 使用。
cd test_client
pip install -r requirements.txt
cd terraform
terraform output supply_chain_arn
运行所有查询(共 20 个,4 个会话)
cd test_client
python test_agent.py --runtime-arn "<supply_chain_arn>" --region <your_region>
运行特定的子智能体类别
#Only optimization queries (1 session, 5 turns)
python test_agent.py --runtime-arn "<supply_chain_arn>" --category optimization
#Only routing and analytics (2 sessions, 5 turns each)
python test_agent.py --runtime-arn "<supply_chain_arn>" --category routing analytics
测试客户端会打印每个查询和完整的智能体响应。最后它会打印会话 ID,供评估器使用。
创建并运行评估
test_evaluators/ 文件夹包含针对智能体会话运行评估的脚本。这些评估是异步运行的,结果将以 markdown 文件的形式保存在 S3 中。
您必须首先按照前文所述调用供应链决策多智能体解决方案,以生成带有追踪的智能体会话,并记下测试客户端运行结束时打印的会话 ID。最后,在运行该解决方案后等待 3-5 分钟,以便追踪信息传播到 CloudWatch。
cd test_evaluators
pip install -r requirements.txt
cd terraform
terraform output evaluators_api_url
创建自定义评估器
python test_evaluator.py --api-url "https://<evaluators-api-url>" create此操作会注册自定义评估器并打印其 ID。请保存这些 ID,以便在 run 命令中使用。
运行评估
传入一个以逗号分隔的评估器 ID 列表(自定义或内置)。至少需要 1 个:
# Run custom + built-in evaluators
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<session-id-from-test-client>" \
--evaluators " sc_optimization_constraint-<id>,sc_distribution_groundedness-<id>,Builtin.Correctness,Builtin.GoalSuccessRate"
该 API 会立即返回 202。结果会异步保存到 S3 的以下位置:
s3://<amzn-s3-demo-agent-source-bucket>/evaluations/<session-id>/<timestamp>/EvaluationResults.md删除评估器
python test_evaluator.py --api-url "https://<evaluators-api-url>" delete \
--evaluator-ids "sc_optimization_constraint-<id>,sc_distribution_groundedness-<id>"
运行优化评估
既然您已经了解评估框架并部署了该解决方案,接下来让我们对优化智能体进行一次重点的端到端评估演练。本演练演示如何将自定义业务准确性评估器(第 2 层)与可解释性评估器(第 3 层)相结合,以评估优化决策的正确性和透明度。
步骤 1:运行优化查询
首先,仅针对优化类别调用测试客户端,以生成一个重点会话:
cd test_client
python test_agent.py --runtime-arn "<supply_chain_arn>" \
--category optimization \
--region <your_region>
这会以多轮会话的形式运行 5 个优化查询。智能体处理的请求例如“prod-001 在未来 30 天内的最优库存水平是多少?”每个查询都要求优化智能体调用 MCP 工具、检索需求预测,并在遵守预算、库存覆盖率和仓库容量约束的前提下产出备货建议。运行结束时,测试客户端会打印优化会话 ID。
步骤 2:运行约束满足评估器(第 2 层:业务准确性)
在生成优化会话后,运行自定义约束满足评估器,以验证智能体的备货建议是否遵守业务规则。该评估器同时检查以下三项约束:
- 预算:增量持有成本是否在剩余预算范围内(budget_limit − budget_used)?
- 库存覆盖:推荐水平是否 ≥ 需求预测(避免缺货)且 ≤ 2×需求(避免过剩)?
- 仓库容量:建议的水平是否能在可用的仓库空间内容纳?
将评估器与内置的 Helpfulness 和 Response Relevance 评估器一起运行:
cd test_evaluators
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<optimization-session-id>" \
--evaluators "sc_optimization_constraint-<id>,Builtin.Helpfulness,Builtin.ResponseRelevance"
该 API 会立即返回 HTTP 202。评估异步运行。结果将保存到 S3:
s3://<amzn-s3-demo-agent-source-bucket>/evaluations/<optimization-session-id>/<timestamp>/EvaluationResults.md步骤 3:运行可解释性评估器(第 3 层:信任与可审计性)
在确认优化智能体能够产生满足约束的建议之后,下一个问题是:它是否解释了其推理过程?一个建议可能是准确的但不透明的。这样的建议可以通过约束评估器,却未能阐明它为何选择某个特定的库存水平。
使用步骤 1 中相同的优化会话 ID,现在运行适用于该优化代理的两个可解释性评估器:
- 决策理由质量——智能体是否解释了其做出推荐的原因?(例如,“推荐1,500件,因为需求预测为1,200件,而我们的目标是1.25倍的安全系数”)?
- 约束推理——智能体是否解释了哪些约束影响了最终回复?(例如,“预算允许最多1,800个单位,但仓库容量将我们限制在1,600个,因此我们建议1,500个”)
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<optimization-session-id>" \
--evaluators "sc_decision_rationale-<id>,sc_constraint_reasoning-<id>"
这些评估者独立评估透明度。它们与准确性分开衡量。
解读综合结果
通过让全部三个评估器对同一个优化会话进行评估,你可以从两个维度全面了解智能体的质量:
| 维度 | 评估者 | 问题已解答 |
| 业务准确性(第2层) | 约束满足 | 这些建议在操作上是否正确? |
| 可解释性(第3层) | 裁决理由质量 | 为什么 这个智能体会做出这个建议吗? |
| 可解释性(Layer 3) | 约束推理 | 哪些约束 塑造了应对措施? |
表3:质量维度上的评估覆盖情况
这种分层方法能够实现有针对性的改进。如果约束满足得分很高,但可解释性得分很低,说明智能体的决策逻辑是合理的,但其沟通表达还需要改进。相反,如果可解释性很高但约束被违反了,则说明智能体能够很好地阐述推理过程,但应用了错误的逻辑。每种失败模式都有不同的改进路径,而评估框架使这种区分变得可衡量。
清理
为避免产生重复费用,请在试用该解决方案后,一步清理您的 AWS 账户。
terraform destroy结论
在这篇文章中,我们演示了如何使用 Amazon Bedrock AgentCore Evaluations 构建和评估一个多智能体供应链决策系统,重点在于验证智能体的行为不仅是功能正常的,而且是有帮助的、准确的和可解释的。通过 AnyCompany Retail Group 场景,我们展示了编排智能体和专门的子智能体如何协作解决复杂问题,例如库存分配、配送计划、路由优化和供应链诊断,同时与企业数据源和 API 进行集成。正如整个架构中所展示的,智能体系统的正确性不仅仅在于响应质量,它还取决于选择正确的工具、执行正确的工作流、遵守业务约束,以及将输出建立在数据基础之上。
通过将内置评估器与自定义评估器相结合,团队可以系统地验证通用响应质量和领域特定的决策准确性。引入以可解释性为核心的评估器还能进一步确保智能体清晰地阐述其推理过程、引用支持数据,并以业务用户可以信赖并据此行动的方式解释权衡取舍。这种以评估为驱动的方法能够利用真实执行数据实现持续改进,在生产上线之前建立质量关卡,并为交付一致、透明且与业务对齐的多智能体系统提供可扩展的框架。
要开始使用,请探索 Amazon Bedrock AgentCore Evaluations ,并将这些模式应用到您自己的多智能体应用程序中。完整的源代码可在 GitHub 上的 Amazon Bedrock AgentCore samples repository 中找到。 首先启用可观测性,为您的用例定义关键的评估维度,然后逐步引入内置评估器和自定义评估器,以衡量最重要的内容。
要了解更多信息,请访问 Amazon Bedrock AgentCore 服务页面,或直接在 Amazon Bedrock 控制台中开始使用.
相关文章:
- 使用 Amazon Bedrock AgentCore Evaluations 构建可靠的 AI 智能体
- 在 AWS 中使用 Amazon Bedrock AgentCore 构建高度可扩展的无服务器 LangGraph 多智能体系统
- 评估 AI 智能体:在 Amazon 构建智能体系统的实战经验