
当用户要求支持助手——一个使用 LangChain 构建的检索增强生成(RAG)应用程序——在三个维度上比较两个产品时,他们实际上是在同时提出六个问题。相似性搜索使用单个查询向量来封装所有意图。检索器随后生成这些意图平均值的最优近似。返回的答案很简洁。搜索执行没有错误。相关性得分看起来合理。然而,检索到的文本块虽然主题相关,却只覆盖了问题实际所问内容的一小部分。
在本文中,我们在 Amazon Bedrock 托管知识库上展示一个结合 LangChain的 RAG 应用程序。我们用标准检索和智能体检索运行同一个多部分问题,并阅读追踪事件以查看模型生成的计划。我们还会讨论两种检索路径的成本,以及何时较便宜的那一种是正确的选择。
智能体式检索已在 Amazon Bedrock 托管知识库上可用。Amazon Bedrock 托管知识库不是执行一次搜索,而是规划检索过程。它将问题拆分为子查询,运行它们,判断是否有足够的证据,如果不足则再次搜索。这个 langchain-aws 包同时暴露了智能体检索和标准检索,因此你可以在 LangChain 应用程序中使用任意一种。
解决方案概览
Amazon Bedrock 托管知识库,作为 Amazon Bedrock 中的全托管 RAG 能力,从 RAG 架构中移除了自行管理的向量存储、嵌入和重排序模型。你只需配置一个数据源,Amazon Bedrock 托管知识库即可处理分块、嵌入、存储和检索。本演练使用 Amazon Simple Storage Service (Amazon S3).
Amazon Bedrock 托管知识库提供两个 API。我们在本文中简要讨论它们的差异。 Retrieve API 运行一次混合搜索并返回带分数的文本块。 AgenticRetrieveStream API 运行一个规划循环,并将步骤作为追踪事件流式返回给你。在这个 langchain-aws 包中,第一个是一个标准的 LangChain 检索器,可以直接放入链中。第二个是直接从知识库进行检索的函数。
下图展示了解决方案架构。应用程序使用 Retrieve API(标准、单次执行)或 AgenticRetrieveStream API(多步规划循环)查询 Amazon Bedrock Knowledge Bases。两种路径都从知识库返回文档块,应用程序随后使用这些文档块生成有依据的响应。
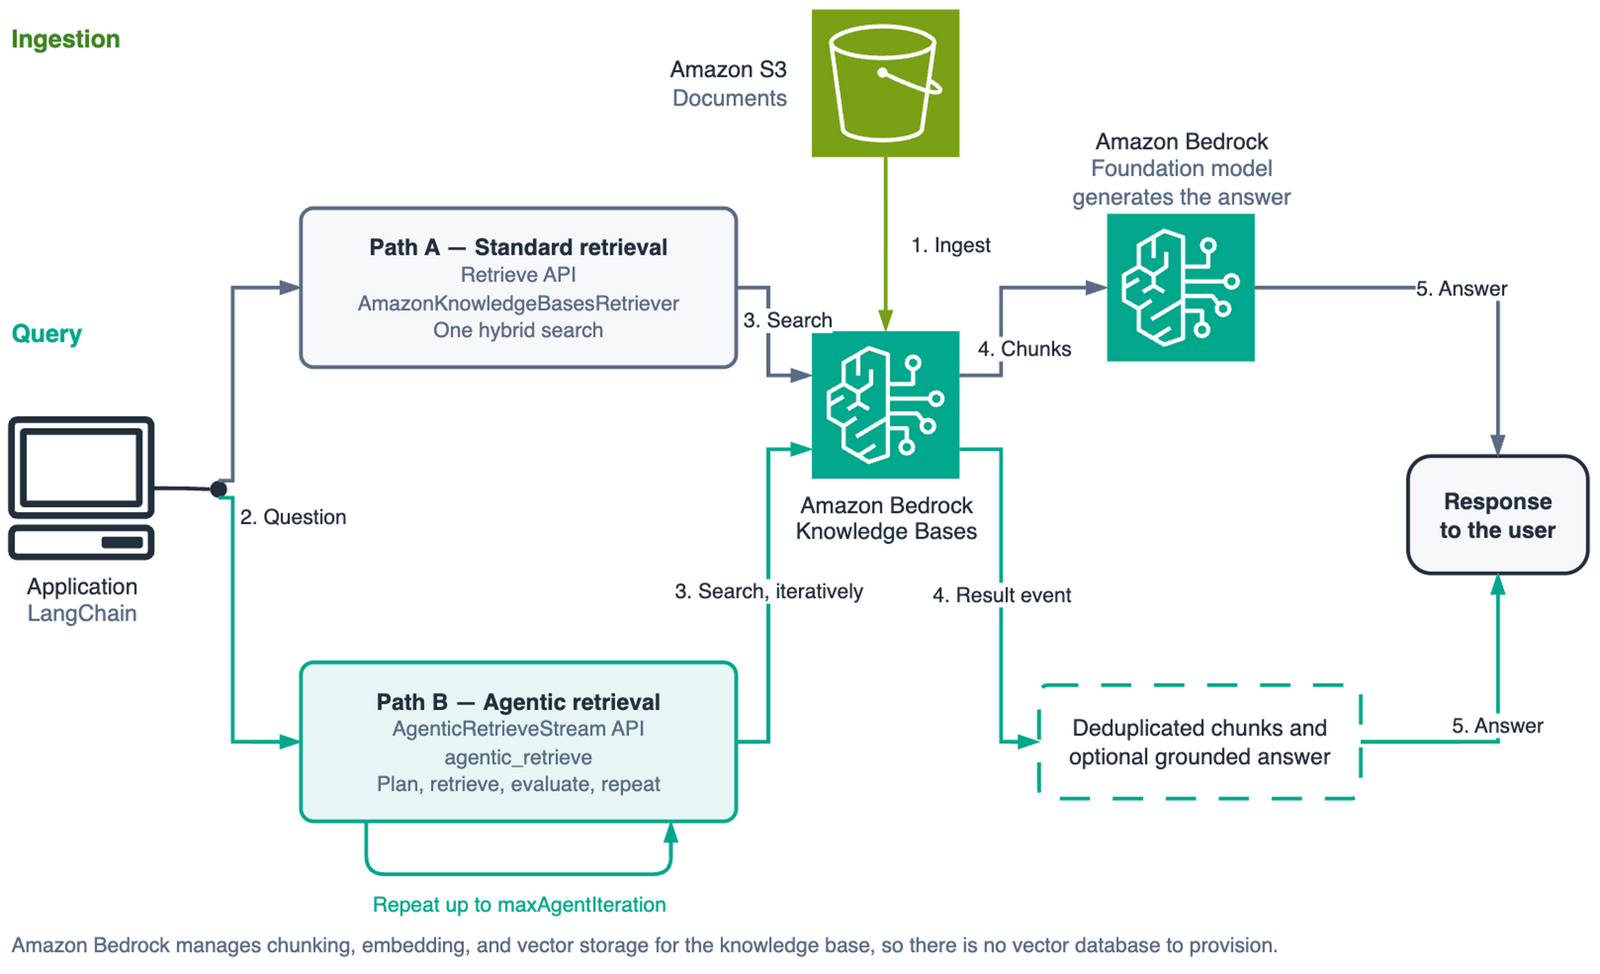
图 1:使用 Retrieve 和 AgenticRetrieveStream API 查询 Amazon Bedrock Knowledge Bases 的解决方案架构
实现演练
以下各节将带你逐步创建知识库、使用两种检索方法查询它,并阅读智能体规划器生成的追踪事件。
先决条件
要跟随本教程,你需要:
- 一个 AWS 账户,并且在 Amazon Bedrock 托管知识库和智能体式检索可用的某个区域拥有 Amazon Bedrock 访问权限。本演练使用美国东部(弗吉尼亚北部)区域(
us-east-1),并且代码全程基于此假设。请查看 AWS 文档 以了解其他区域的可用性和支持情况。 - 两个 AWS Identity and Access Management (IAM) 身份,将在下一节中描述:一个是知识库承担的服务角色,另一个是你调用 API 所用身份的权限。
- Python 3.12 或更高版本。
- 一个存放示例文档的 S3 存储桶。语料库需要若干覆盖相互重叠主题的文档,这样比较性的问题才有落脚之处。单个平铺文档无法展示查询规划。
安装软件包。 Boto3 版本很重要: agentic_retrieve_stream 在 1.43.32 之前并不存在。
langchain-aws>=1.6.3
langchain>=1.0
boto3>=1.43.32
权限
这里涉及两个身份,值得刻意地将它们分开。知识库使用一个服务角色来读取您的文档并调用嵌入模型。您的应用程序则使用 AWS Security Token Service (AWS STS) 的调用者身份来进行查询。两者都不需要对方的权限。
如果您允许,Amazon Bedrock 会为您创建服务角色。若要提供自己的角色,请为其指定一个信任策略,允许 Amazon Bedrock 担任该角色。使用以下方式限定其范围: aws:SourceAccount 和 aws:SourceArn 以免另一个账户将其用作“受迷惑的副手”(confused deputy):
{
    "Version": "2012-10-17",
    "Statement": [{
        "Effect": "Allow",
        "Principal": {"Service": "bedrock.amazonaws.com"},
        "Action": "sts:AssumeRole",
        "Condition": {
            "StringEquals": {"aws:SourceAccount": "111122223333"},
            "ArnLike": {
                "aws:SourceArn": "arn:aws:bedrock:us-east-1:111122223333:knowledge-base/*"
            }
        }
    }]
}
该服务角色还需要 s3:ListBucket 针对您的存储桶以及 s3:GetObject 其内容,两者均以……为条件, aws:ResourceAccount。范围界定为 knowledge-base/* 创建知识库 ID 之后,可以将通配符细化为具体的知识库 ID。
AWS STS 调用者身份需要一套不同的权限。 bedrock:AgenticRetrieveStream 和 bedrock:InvokeModelWithResponseStream 无法限定到某个知识库 Amazon Resource Name (ARN)。 bedrock:Retrieve 和 bedrock:GetDocumentContent 可以:
{
    "Version": "2012-10-17",
    "Statement": [
        {
            "Sid": "AgenticRetrievalAndPlannerModel",
            "Effect": "Allow",
            "Action": [
                "bedrock:AgenticRetrieveStream",
                "bedrock:InvokeModelWithResponseStream"
            ],
            "Resource": "*"
        },
        {
            "Sid": "RetrieveAndFullDocumentExpansion",
            "Effect": "Allow",
            "Action": ["bedrock:Retrieve", "bedrock:GetDocumentContent"],
            "Resource": "arn:aws:bedrock:<region>:111122223333:knowledge-base/<knowledge-base-id>"
        },
        {
            "Sid": "GenerateAnswersInTheChains",
            "Effect": "Allow",
            "Action": ["bedrock:InvokeModel", "bedrock:Converse", "bedrock:ConverseStream"],
            "Resource": "*"
        }
    ]
}
bedrock:GetDocumentContent 常常被忽视。Agentic retrieval 会在一个 FullDocumentExpansion 步骤判断某段落在回答问题时缺乏上下文。一条仅包含 bedrock:Retrieve 直到规划器需要获取整个文档时才能正常工作,随后在查询执行到一半时失败。
要创建和管理知识库本身,调用角色还需要 bedrock:CreateKnowledgeBase on *,以及 GetKnowledgeBase, UpdateKnowledgeBase, DeleteKnowledgeBase, StartIngestionJob, GetIngestionJob,以及 ListIngestionJobs 针对以下内容的操作 knowledge-base/*。如果你正在使用护栏(guardrails),请添加 bedrock:GetGuardrail 和 bedrock:ApplyGuardrail.
运行本演练可能会产生以下费用:知识库中的文档存储和摄取、检索调用以及基础模型(FM)推理。
有关定价的更多信息,请参阅 Knowledge Bases 部分: Amazon Bedrock 定价.
完成本实验后请删除相关资源。
创建并填充知识库
使用以下方式创建知识库: managedKnowledgeBaseConfiguration. 设置 embeddingModelType 至 MANAGED 使用服务管理的嵌入模型。
import boto3
import os

REGION = os.environ["AWS_REGION"]
bedrock_agent = boto3.client("bedrock-agent", region_name=REGION)

response = bedrock_agent.create_knowledge_base(
    name=KB_NAME,
    roleArn=KB_ROLE_ARN,
    knowledgeBaseConfiguration={
        "type": "MANAGED",
        "managedKnowledgeBaseConfiguration": {
            "embeddingModelType": "MANAGED",
        },
    },
)
KB_ID = response["knowledgeBase"]["knowledgeBaseId"]
目前还没有 storageConfiguration 在该请求中。对于自管理的知识库,您需要传入一个描述您的向量存储的配置。Amazon Bedrock 托管知识库不需要传入该配置,这是 API 中最明确的信号,表明存储层由 Amazon Bedrock 负责。
将S3存储桶附加为数据源,然后启动一个摄取作业。摄取是异步的,因此应轮询直到作业达到终态,而不是固定间隔休眠并寄希望于完成。
import time

SUCCESS_STATES = frozenset({"COMPLETE"})
FAILURE_STATES = frozenset({"FAILED", "STOPPED"})

def wait_for_ingestion(kb_id, ds_id, job_id, timeout_s=1800):
    """Poll an ingestion job until it reaches a terminal state."""
    deadline = time.time() + timeout_s
    while time.time() < deadline:
        job = bedrock_agent.get_ingestion_job(
            knowledgeBaseId=kb_id,
            dataSourceId=ds_id,
            ingestionJobId=job_id,
        )["ingestionJob"]
        status = job["status"]
        if status in SUCCESS_STATES:
            return job
        if status in FAILURE_STATES:
            reasons = job.get("failureReasons") or ["no reason reported"]
            raise RuntimeError(f"Ingestion job {job_id} finished as {status}: " + "; ".join(reasons))
        time.sleep(15)
    raise TimeoutError(f"Ingestion job {job_id} did not finish in {timeout_s}s")
完整的数据源配置和错误处理在 示例仓库.
使用 LangChain 检索器进行查询
AmazonKnowledgeBasesRetriever 包装了 Retrieve API,行为与其他任何 LangChain 检索器一样。对于 Amazon Bedrock Managed Knowledge Bases,传入 managedSearchConfiguration。这是最容易让人出错的部分: vectorSearchConfiguration 是知识库的先前路径,即运行您自己的向量存储。这是大多数现有示例所展示的方式。
from langchain_aws.retrievers import AmazonKnowledgeBasesRetriever

SIMPLE_QUERY = "What is the restore time objective for the checkout service?"

retriever = AmazonKnowledgeBasesRetriever(
    knowledge_base_id=KB_ID,
    region_name=REGION,
    retrieval_config={
        "managedSearchConfiguration": {
            "numberOfResults": 5,
        }
    },
)
docs = retriever.invoke(SIMPLE_QUERY)
每个结果都以一个LangChain Document。相关性评分在 metadata["score"], 且源文档自身的元数据位于 metadata["source_metadata"]之下,并已重命名以免冲突。如果你想丢弃低置信度的结果,请将 min_score_confidence 设置在检索器上,而不是在事后过滤。
对于只有一个明确意图的问题,这是正确的工具。它只需一次调用。延迟是两种选项中最低的,并且你可以完全控制答案的生成方式。生产环境助手收到的大多数查询都是这种形态,为它们动用规划循环只会浪费金钱和时间。
单次检索的失效之处
现在给同一个检索器一个包含多个部分的问题:
COMPLEX_QUERY = (
    "Compare the checkout and inventory services across on-call escalation, backup and "
    "restore targets, and deployment rollback procedure. Where do they differ?"
)

docs = retriever.invoke(COMPLEX_QUERY)
返回五个文本块,按与整个问题的单一嵌入的混合得分排序。
这个问题包含六个意图:两个服务,横跨三个维度。对检索到的文本逐一评估每个意图的证据,就能具体衡量单一嵌入能恢复什么。
| numberOfResults | 文本块数 | 语料占比 | 覆盖的子意图 | 缺失 |
| 5 | 5 | 10% | 6 个中的 4 个 | checkout on-call、inventory restore |
| 10 | 10 | 19% | 6 个中的 6 个 | 无 |
在返回五个结果时,用单一嵌入表示六个意图会漏掉其中两个。在返回十个时它覆盖了全部六个,但浪费明显:两个子意图被重复覆盖,而有一个文本块一个意图都不涉及。
检索器完成了它的工作。这个限制是结构性的:一个向量无法表示六个意图,而且流程中没有任何一步会询问返回的证据是否足以回答问题。
运行代理式检索
代理式检索不是 LangChain 检索器,而是 Amazon Bedrock Managed Knowledge Bases 的一项功能。该 langchain-aws 该包将其暴露为一个独立函数, agentic_retrieve,因为底层 API 以流的方式返回结果,不适合同步 BaseRetriever 界面上没有标志。 AmazonKnowledgeBasesRetriever 将其开启。
from langchain_aws.retrievers.bedrock import agentic_retrieve

result = agentic_retrieve(
    knowledge_base_id=KB_ID,
    query=COMPLEX_QUERY,
    region_name=REGION,
    generate_response=True,
    number_of_results=10,
)
print(result["generatedResponse"]["answer"])
随着 generate_response=True,该服务会返回有依据的答案和引用,并连同检索到的文本块一起提供,因此无需另行配置单独的模型调用即可获得答案。该函数仅适用于 Amazon Bedrock Managed Knowledge Base。
在内部,该服务会进行规划、检索、评估证据是否充分,并在不足时进行迭代。这个辅助方法隐藏了所有这些过程,直接返回最终的文本块,这很方便,但也意味着你无法看到规划过程。
读取跟踪事件
要观察模型分解该问题的过程,请调用 agentic_retrieve_stream 关于 bedrock-agent-runtime 客户端直接通信。这是本演练中唯一一处我们绕过 langchain-aws,因为该辅助工具会丢弃跟踪事件,并且不公开 maxAgentIteration 或自定义的计划模型。
runtime = boto3.client("bedrock-agent-runtime", region_name=REGION)

response = runtime.agentic_retrieve_stream(
    messages=[{"role": "user", "content": {"text": COMPLEX_QUERY}}],
    retrievers=[{
        "configuration": {
            "knowledgeBase": {
                "knowledgeBaseId": KB_ID,
                "retrievalOverrides": {"maxNumberOfResults": 10},
            }
        }
    }],
    agenticRetrieveConfiguration={
        "foundationModelType": "MANAGED",
        "rerankingModelType": "MANAGED",
        # 5 is the API default. Below 4 the planner stops decomposing entirely.
        "maxAgentIteration": 5,
    },
    generateResponse=False,
)

for event in response["stream"]:
    if "traceEvent" in event:
        attrs = event["traceEvent"]["attributes"]
        print(f"{attrs.get('step')}: {attrs.get('status')}")
        for action in attrs.get("actions", []) or []:
            if "retrieve" in action:
                query = action["retrieve"].get("inputQuery", {}).get("text", "")
                print(f" sub-query: {query}")
    elif "result" in event:
        for chunk in event["result"].get("results", []):
            print(chunk.get("content", {}).get("text", "")[:120])
设置 generateResponse 至 False 当你只需要检索行为时。该 API 默认会生成一个有依据的答案,这会产生一次额外的模型调用,而你在检查计划时可能并不需要它。
一个追踪事件的 step 告诉你 planner 在哪里。 SpeculativeRetrieval 在第一个计划之前运行以降低延迟,且不计入您的迭代预算。 Planning 是模型读取问题和先前结果并生成子查询的地方。 Retrieval 每个子查询触发一次。 FullDocumentExpansion 在模型判定某段文本缺乏回答所需上下文、转而拉取整个文档时出现。每种情况都带有一个状态 IN_PROGRESS, SUCCEEDED或 FAILED,外加一条人类可读的消息。
最终的分块会单独到达。 result 本身就是一种独立的事件类型,而非第五个步骤,它包含每次迭代中去重后的分块,以及在开启响应生成时的有据可依的答案。如前面的循环所示,应根据事件键进行分支,而不是期望某个终止步骤值。
值得记录的是子查询文本。它位于 attributes.actions[].retrieve.inputQuery.text中,而不是在顶层追踪字段中,所以只读取 step 的处理程序 status 会告诉你发生了规划,却不会告诉你规划做出了什么决定。
下图展示了代理式检索规划循环,包括投机检索、规划、子查询检索、评估以及可选的重新规划步骤。
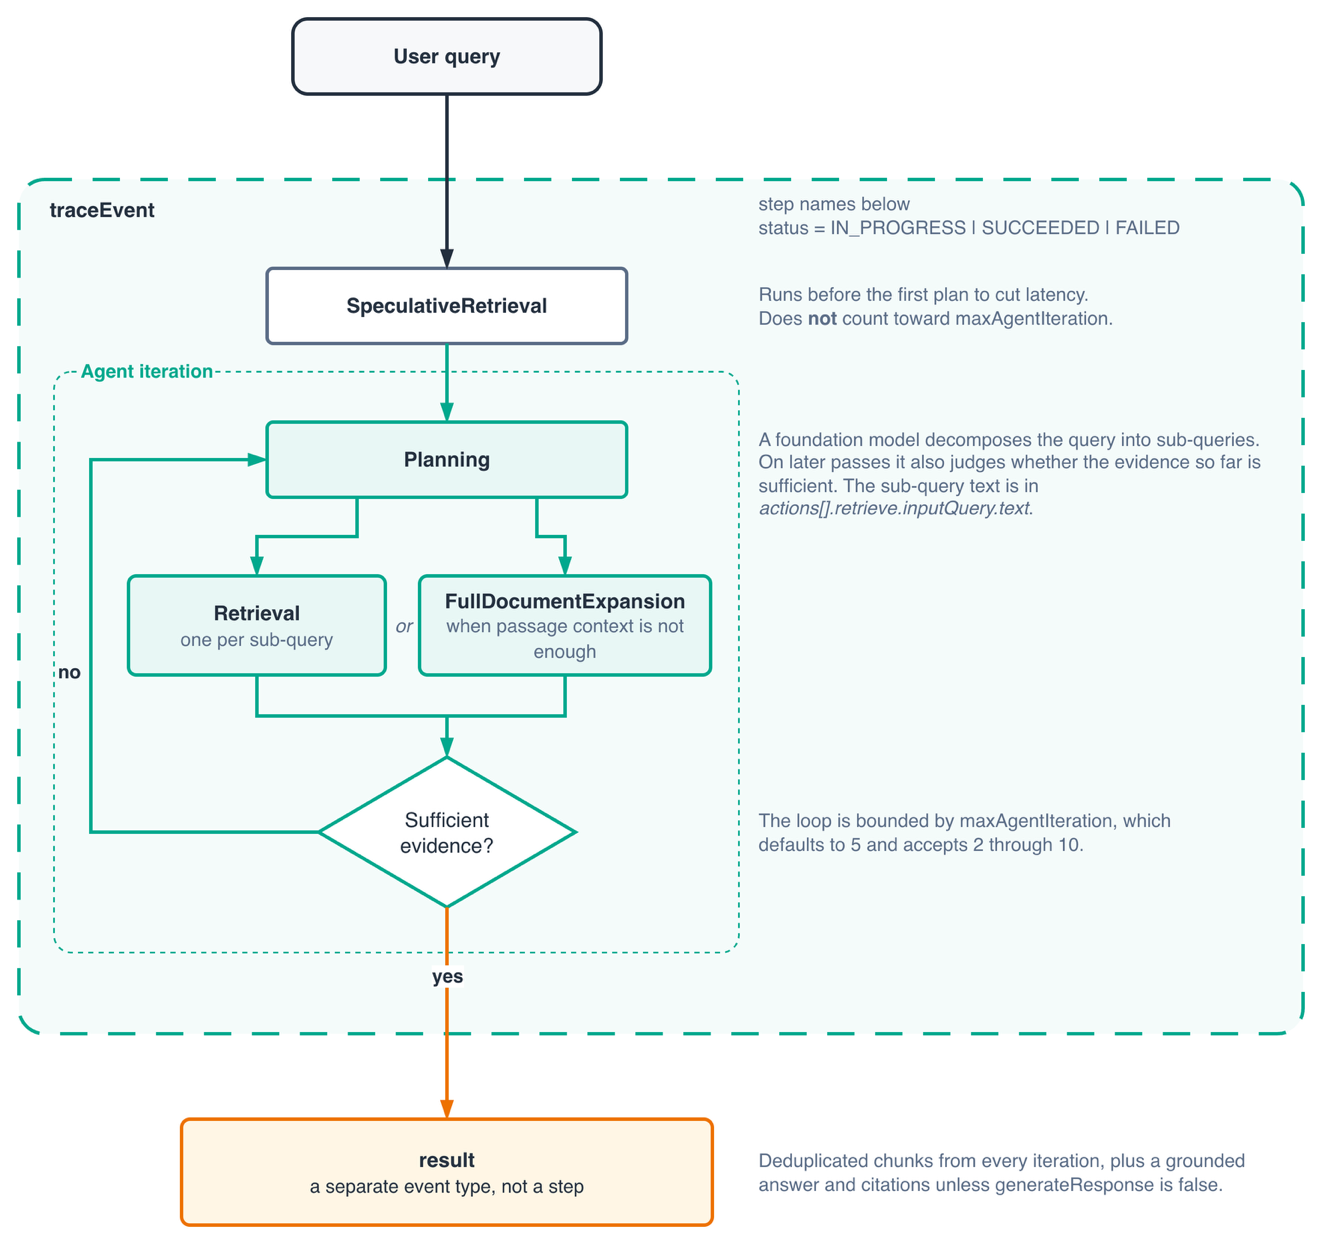
图 2:代理式检索规划循环中的步骤
在基于此构建之前,有两个细节值得了解。去重仅适用于 result 事件,因此由三个子查询检索到的同一个分块在最终结果中只出现一次,但在追踪记录中会出现三次。
第二个细节与分数有关。Retrieve 响应为每个分块提供一个类型化的 score 字段,表示其与查询的相关性。代理式检索结果携带 content, metadata和 sourceRetriever,没有等价的类型化字段。在切换 API 后读取 result["score"] 的代码将得不到任何内容。如果你需要根据相关性进行排序或过滤,请为这一差异做好准备。
在生产环境中,使用 Amazon Bedrock Guardrails 对生成的响应强制执行内容策略和接地检查。两条检索路径都支持 guardrails。代理式检索通过 policyConfiguration.bedrockGuardrailConfiguration (而非 LangChain 检索器所接受的 guardrail_config 参数)支持 guardrails,并且仅支持 BLOCK 模式。如果你依赖 MASK 模式,这就是继续使用 Retrieve API 的一个理由。
maxAgentIteration 接受 2 到 10 的值,默认值为 5。请保持默认值。设为 2 或 3 时,规划器只运行一个周期,不生成子查询,并返回投机检索步骤已经找到的内容。这是以代理式价格获得的单次执行行为。分解从 4 开始。当规划器判断证据已足够时,往往会提前停止,因此这个上限只是一个约束而非目标。
比较两种检索路径
关于其在规模上的表现,AWS 在 MuSiQue(一个公开的多跳基准测试)上评估了代理式检索。评估显示,其召回率优于单次检索,在最难的问题上提升最大。单跳问题的提升不足五分。最后一个数字正体现了这种权衡的形态:只有存在可分解的内容时,分解才有帮助。
构建 RAG 链
对于标准检索器,通常的 LangChain Expression Language (LCEL) 组合方式可以直接使用:
from langchain_aws import ChatBedrockConverse
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

def format_docs(docs):
    return "\n\n".join(doc.page_content for doc in docs)

llm = ChatBedrockConverse(model=MODEL_ID, region_name=REGION)
prompt = ChatPromptTemplate.from_template(PROMPT_TEMPLATE)

chain = (
    {"context": retriever | format_docs, "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
format_docs 比看起来更重要。将 Document 对象直接传入提示词会使其 repr,并且模型会将元数据噪音混入上下文中。
为了将 agentic retrieval 置于相同的位置,请将其包装在一个 RunnableLambda中,因为它是一个函数而不是一个 retriever:
from langchain_core.runnables import RunnableLambda

def agentic_context(question: str) -> str:
    result = agentic_retrieve(
        knowledge_base_id=KB_ID,
        query=question,
        region_name=REGION,
        number_of_results=10,
    )
    return "\n\n".join(
        item.get("content", {}).get("text", "")
        for item in result.get("results", [])
    )

agentic_chain = (
    {"context": RunnableLambda(agentic_context), "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
请注意,此处 generate_response 是关闭的。该服务可以自行生成答案,但在链中你通常需要使用自己的提示词和模型,因此你需要获取这些片段并在下游进行生成。当你希望只需一次调用且代码更少时,可使用该服务的生成功能;当提示词由你控制时,请使用包装后的版本。
在标准检索与 agentic retrieval 之间做出选择
对于简短、范围明确的问题,请使用 Retrieve。它更便宜、更快,可作用于自管理的知识库,并在结果中返回分数。大多数生产流量都属于这种类型。
当问题是多部分的、比较性的或探索性的,或者证据跨越多个知识库时,请使用 AgenticRetrieveStream。它可以在一次请求中注册最多 3 个……
根据查询形态进行路由,而不是为所有情况都选同一个,这是我们推荐的模式。可以针对问题使用分类器或启发式方法,将大部分流量引导到便宜的路径,并将规划器保留给需要它的问题。
清理资源
删除知识库、其数据源、S3 对象和存储桶,以及你创建的 IAM 角色。包含文档的知识库将继续产生存储费用。
bedrock_agent.delete_data_source(knowledgeBaseId=KB_ID, dataSourceId=DS_ID)
bedrock_agent.delete_knowledge_base(knowledgeBaseId=KB_ID)
该 存储库 包含一个清理脚本,它还会清空存储桶并移除该角色。
结论
我们展示了如何在 Amazon Bedrock Knowledge Bages 上结合 LangChain 构建一个 RAG 应用,以及 agentic retrieval 如何处理单次检索难以妥善回答的多部分问题。我们还展示了当前集成中的摩擦点。Agentic retrieval 是一个函数而非 LangChain retriever,因此它需要一个 RunnableLambda 才能在链中运行。显示查询计划的跟踪事件需要直接的 boto3 调用。
Agentic retrieval 以更高的单次调用成本换取多跳问题上的更好召回率,并使用内置模型进行查询规划。下一步有用的做法是,在将所有请求都通过规划器路由之前,先测量你自己的查询构成。
要开始使用,请参阅 Amazon Bedrock Knowledge Bases 文档 以及随附的示例代码。如需在您自己的工作负载中应用此方案,请联系您的 AWS 客户团队。