
编码和代理式工作负载对 AI 模型的要求比以往任何时候都更高:需要重构包含数百个文件的存储库,在保持上下文完整的情况下维持多小时长的代理式工作流程,并在每个步骤中借助工具来解决复杂的系统问题。历史上,要满足这些要求,就必须自行构建并运营自己的推理基础设施。
Z.ai 提供的 GLM 5.3(Zhipu AI)现已在 Amazon Bedrock 上可用。GLM 5.3 最初发布于 Hugging Face Hub,这是一个拥有 753B 参数、采用专家混合架构的模型,专为编码和长期规划代理任务设计。Z.ai 表示,该模型具有出色的网络安全能力。在 Amazon Bedrock 上,您可以通过完全管理的 API 使用它,支持跨区域推理、提示缓存和服务层级功能,无需管理任何基础设施。符合条件的企业客户可以访问 Bedrock 上的 GLM 5.3。
在本文中,我们将展示如何使用与 OpenAI 兼容的 API 在 Amazon Bedrock 上调用 GLM 5.3,并通过提示缓存来降低成本与延迟。随后,我们让该模型参与真实的代理式工作流程:使用 Strix 这个开源 AI 渗透测试代理,对您的应用程序进行合法的安全测试。
与 GLM 5 相比有什么新变化
GLM 5 于今年早些时候登陆 Amazon Bedrock。GLM 5.3 基于相同的开发脉络,带来了一系列重要的改进。
- 更强大的编码能力: Z.ai声称在包括 DeepSWE、Terminal Bench 3.0 和 FrontierSWE 在内的多种编码基准测试中都能获得竞争优势。他们在自己的内部编码基准测试中也报告称,性能提升了 50%,相比 GLM 5.2 有显著提升。由于提升幅度较大,导致需要更新基准测试本身,因此没有对 GLM 5 进行直接比较,因为GLM 5.1 的发布通知中已对此作出说明。
- 新兴网络安全能力: 在安全任务上的基准性能表现非常出色,这使得该模型非常适合防御性安全工作流程。例如,Z.ai 测量 发布时,CyberGym基准测试的领先得分为 84.5。
- 更广泛的 Amazon Bedrock 集成:跨区域推理配置、隐式与显式提示缓存,以及与 Invoke 和 Converse 并存的、兼容 OpenAI 的 Responses 和 Chat Completions API 的功能一致性提升。
关键功能
- 边界编码与智能体性能。 GLM 5.3 专为复杂系统工程和长期智能体任务而设计。这些任务包括多步骤推理、工具增强的工作流,以及大代码库中的持续上下文处理。
- 灵活的 API 访问方式。 您可以通过与 OpenAI 兼容的 Responses 和 Chat Completions API,或 Amazon Bedrock Invoke 和 Converse API 来调用 GLM 5.3。
- 提示词缓存。 GLM 5.3 默认支持隐式(自动)提示词缓存功能,在 Responses 和 Chat Completions API 上则提供显式缓存控制选项(推荐)。对于每次对话都需要重新发送大量系统提示词或仓库上下文的代理式工作负载而言,缓存可以降低延迟并减少输入成本。
- 跨区域推理。 GLM 5.3可通过美国跨区域推理(
us.zai.glm-5.3)和全球跨区域推理(global.zai.glm-5.3)配置使用。您向所选的 AWS 区域发送请求,Amazon Bedrock 会安全地将每个请求路由以进行处理。更多详情请参考Amazon Bedrock 用户指南。 - 服务等级。 选择 Flex,以优化对时间敏感性较低的工作负载的成本;选择 Priority,以优先处理延迟敏感的请求,但需支付更高的价格;选择 Standard,以获得价格与速度之间的平衡。
先决条件
对于以下使用示例,您需要:
- 拥有 Amazon Bedrock 访问权限的 AWS 账户
- AWS Identity and Access Management (IAM) 权限,用于调用基础模型和目标推理配置文件:
bedrock:InvokeModel、bedrock:InvokeModelWithResponseStream和bedrock:CallWithBearerToken。 - (对于基于代码的演示)Python 3.10 或更高版本。
- (仅用于可选的安全测试演示)安装 Docker 和 包含 bedrock 附加功能的 Strix。
在 Amazon Bedrock 控制台尝试 GLM 5.3
您可以在 AWS 管理控制台中直接向 GLM 5.3 发送提示信息,无需编写代码或安装开发工具。开始操作的方法如下:导航至 Amazon Bedrock,然后从左侧边栏菜单中选择 Test > Playground。
在这个游戏界面中,你可以从模型列表中选择 GLM 5.3,然后通过聊天界面发送你的第一个提示词,如以下截图所示:
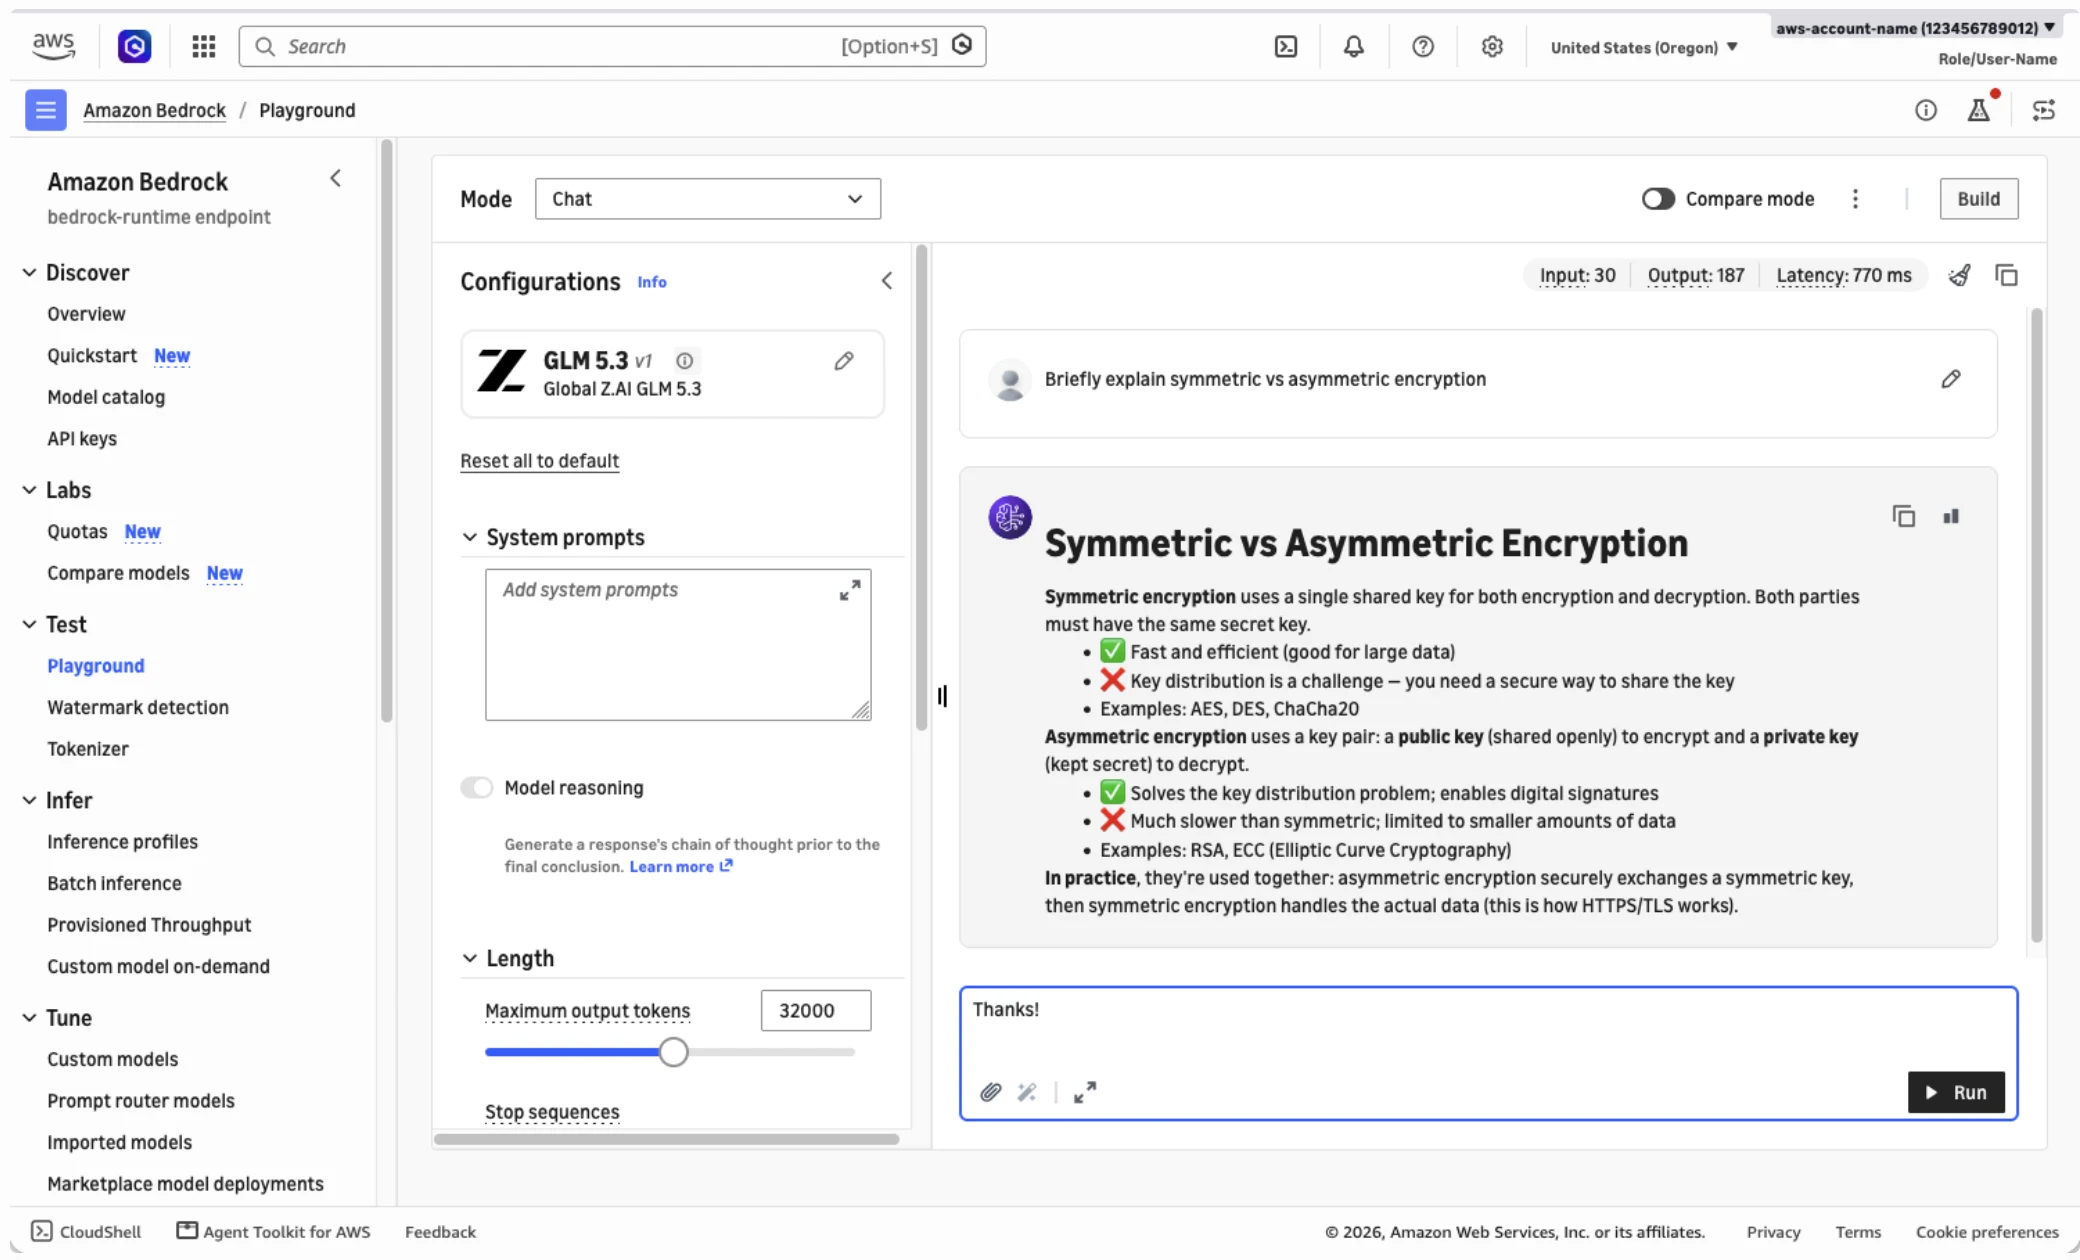
图 1:在 Amazon Bedrock 控制台与 GLM 5.3 聊天
开始使用 Responses API
通过编程方式,可以通过 bedrock-runtime 端点调用该模型。这支持与 OpenAI 兼容的 Responses 和 Chat Completions API,以及 Amazon Bedrock 的 Invoke 和 Converse API,用于 GLM 5.3。对于新应用,建议使用与 OpenAI 兼容的 API,因为它们支持更完整的功能集。
Amazon Bedrock 确实支持为需要这些密钥的 OpenAI 兼容集成生成 API 密钥。不过,在可能的情况下,我们强烈建议使用短期凭证而非长期 API 密钥。
在以下示例中,我们将使用 OpenAI Python SDK 从 Python 调用 Responses API,并使用 aws-bedrock-token-generator 库,根据您的标准 AWS 命令行界面 (AWS CLI) 凭据生成短期令牌。
- 安装所需的包。
pip install -U openai aws-bedrock-token-generator - 将以下代码保存为
bedrock-request.py。from aws_bedrock_token_generator import provide_token from openai import OpenAI region = "us-west-2" # Your source AWS Region client = OpenAI( api_key=provide_token(region=region), base_url=f"https://bedrock-runtime.{region}.amazonaws.com/openai/v1", ) resp = client.responses.create( input="Refactor this Python function to be iterative instead of recursive: ...", model="global.zai.glm-5.3", ) print(resp.output_text) - 运行该脚本,即可显示模型的输出结果。
python bedrock-request.py
通过显式提示词缓存优化推理过程
长时间运行的编码和知识工作流通常会在多个对话轮次中重新发送稳定的上下文信息,例如系统提示、工具定义或存储库文件。
Amazon Bedrock 的 GLM 5.3 默认支持隐式提示缓存功能,这有助于降低响应延迟并减少重复调用时输入令牌的成本,这些调用都使用相同的初始提示前缀。
通过 显式提示缓存 模式,您可以明确指定可重复使用的提示前缀,这能够进一步提高缓存命中率(进而降低延迟并节省成本),比隐式缓存更好。
如以下示例所示,在 GLM 5.3 中可以使用显式提示缓存:
- 通过
prompt_cache_options选择明确的缓存模式。 - 在输入内容块上添加一个或多个
prompt_cache_breakpoint标记,以表示可重用提示前缀的结束位置(包含)。每个断点必须至少包含 1,024 个标记符,才有资格进行缓存。
resp = client.responses.create(
    model="global.zai.glm-5.3",
    # Enable explicit caching mode:
    extra_body={"prompt_cache_options": {"mode": "explicit"}},
    input=[
        {
            "type": "message",
            "role": "system",
            "content": [
                {
                    "type": "input_text",
                    "text": SYSTEM_PROMPT,
                    # A long, static system prompt is a great target for caching:
                    "prompt_cache_breakpoint": {"mode": "explicit"},
                },
            ]
        },
        {
            "type": "message",
            "role": "user",
            "content": [
                {
                    "type": "input_text",
                    "text": USER_INPUT,
                    # Multiple breakpoints can also be defined, for layered cache:
                    "prompt_cache_breakpoint": {"mode": "explicit"},
                },
            ],
        },
    ],
)

if resp.usage.input_tokens_details.cached_tokens:
    print("Hit cache!")
如需更多信息,请参考 Amazon Bedrock 用户指南中的 提示缓存部分。
示例式代理工作负载:经授权的 Strix 安全测试
一种直接受益于 GLM 5.3优势的工作负载,就是对自己应用程序的自动化安全测试。Strix是一个开源的 AI渗透测试代理,它能够动态运行代码、发现漏洞,并通过概念验证测试对漏洞进行验证。目前,Strix的文档将GLM 5.3作为默认模型使用。你可以配置Strix在Amazon Bedrock上使用GLM 5.3进行推理,而非依赖第三方推理服务,因此模型推理操作可以在你的AWS账户控制下完成。
仅测试您拥有或获得明确书面许可的应用程序。 对非您所有的系统进行未经授权的安全测试在大多数司法管辖区属于违法行为,且违反 AWS 可接受使用政策。在本演示中,目标为 OWASP Juice Shop,这是一个故意设计成易受攻击的本地运行示例应用程序。
如果您希望获得全面管理的持续安全测试服务,而不仅仅是自行运行开源代理,AWS Continuum 可提供按需渗透测试及其他安全分析服务,作为管理式服务提供。这两种方式相互补充:像 Strix 这样的开源代理能够让您进行由开发者主导、实时且可深度自定义的对本地构建环境的测试,而 AWS Continuum 则能够大规模执行管理式评估。
执行授权安全测试
- 在本地启动示例中的 Juice Shop 目标应用程序。
docker run --rm -p 3000:3000 bkimminich/juice-shop - 在 Amazon Bedrock 上配置 Strix 使用 GLM 5.3。Strix 实际上使用的是 LiteLLM,因此(如 Strix 针对 Amazon Bedrock 的文档中所述)您的 AWS CLI 凭据将自动获取。这意味着不需要 API 密钥,但您可能希望设置环境变量,如
AWS_PROFILE和AWS_REGION,以配置连接。在撰写本文时,LiteLLM 尚未解析bedrock/global.zai.glm-5.3。在这一问题得到解决之前,您可以像以下示例那样明确指定 Converse API 路径和推理配置文件 Amazon Resource Name (ARN):# Fill in the REGION and ACCOUNT_ID placeholders below before running! export STRIX_LLM="bedrock/converse/arn:aws:bedrock:{AWS_REGION}:{AWS_ACCOUNT_ID}:inference-profile/global.zai.glm-5.3" - 在本地目标上运行 Strix。
strix --target http://localhost:3000 - 等待根 Strix 代理完成工作后,再查看结果。
Strix 会组建一个子代理团队,用于绘制威胁分布图,探索各种潜在的漏洞类别,并通过实际概念验证来确认每个发现。这样就能减少处理误报所花费的时间。如果运行成功,就会生成一份报告,其中包含每个发现的严重程度、相关证据以及修复建议。
以下视频展示了在示例应用程序上设置并运行 Strix 的全程过程,以及对结果的探索情况:
图 2:使用 GLM 5.3 和 Strix 进行示例安全测试
清理
停止 Juice Shop 容器 Ctrl+C 在运行时的终端中,或运行 docker ps 找到容器 ID 并停止它 docker stop <container-id>Amazon Bedrock 推理服务是按令牌付费的服务,不会保留任何持久资源,因此请求完成后不会产生额外费用。如果您在本次操作过程中生成了 Amazon Bedrock API 密钥但不再需要,请在 Amazon Bedrock 控制台中将其删除。
可获取性
请尝试使用 GLM 5.3。 Amazon Bedrock 控制台,可以通过像 OpenCode 这样的编码助手来使用,如我们所展示的那样 最近关于 Kimi K3 的帖子或者通过支持的 API 连接您的自定义应用程序。
对 Amazon Bedrock 如何支持您的团队感兴趣吗? 与我们联系 以开启对话。