
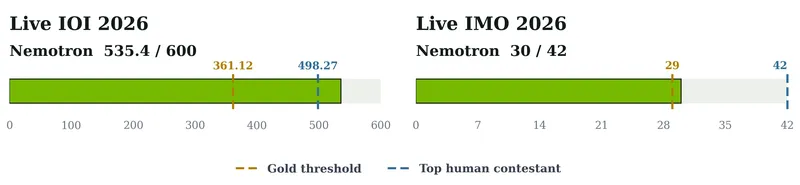
国际信息学奥林匹克竞赛(IOI)与国际数学奥林匹克竞赛(IMO)考查不同的技能。IOI要求提交算法和代码,这些作品必须在严格的时间和提交限制下通过隐藏测试。IMO则要求提供严谨的自然语言证明。在任一竞赛中取得成功都很困难。而在两项竞赛中都取得成功则意味着更广阔的能力。
我们的最新结果表明,Nemotron是一种强大且可适应的基础框架,可用于构建世界级的专业模型。从 Nemotron 3 开始,我们的团队采用监督微调(SFT)、强化学习(RL)和反馈驱动推理技术,打造出在 IMO 2026 和 IOI 2026 上达到金牌水平的系统。

| 比赛 | Nemotron 专业版 | 结果 |
|---|---|---|
| IOI 2026 | Nemotron-3-Ultra-CC 配备 SFT 和 GenCorrect | 535.4/600,超过 361.12 黄金阈值,且最高人类得分为 498.27 |
| 在我看来 2026 | Nemotron 3 Ultra 通用、SFT 和 RL 检查点在生成-验证-优化系统中 | 30/42,超过官方29的黄金阈值 |
IOI结果来自一次实时、前瞻性测试,其时间、网络访问和提交条件与人类参赛者相同。这是一项非官方、无监督的基准测试,未被纳入官方IOI排名中。IMO系统提交的证明由官方IMO评分员进行评判。
> 可复用的专业化配方
“易于微调”意味着不仅仅是让检查点可训练,还意味着一个强大的基础模型可以通过清晰、可复用的方法适应高要求的领域。
在这两个项目上,该方案由四部分组成:
- 以强大的 Nemotron 基础模型为起点。
- 筛选特定领域的题目和高质量推理过程。
- 采用标准训练后方法,如 SFT,在必要时也使用 RL。
- 将专业模型与能够生成、评估并改进候选答案的推理循环相结合。
训练和推理过程非常耗时,但底层方法却很熟悉且可复现。我们无需针对每个挑战构建新的基础模型,而是针对该任务对 Nemotron 进行了专门优化。
从一般的编程能力到 IOI 金牌
对于竞赛编程,我们筛选了 22,000 道题目,并生成了合成推理轨迹以训练两名专家。Nemotron-3-Nano-CC 拥有 300 亿个总参数和 30 亿个活跃参数,接受了 SFT 和 RL 训练。Nemotron-3-Ultra-CC 拥有 5500 亿个总参数和 550 亿个活跃参数,接受了 SFT 训练。
IOI 2025比赛中的表现变化,使得专业水平的值清晰可见。Nano在训练前的130分,经过SFT后提升到了280分,再通过RL后达到了291分。借助GenCorrect这一迭代生成-评估-优化策略,其得分达到了468分,并超过了438.3分的黄金分数线。Ultra-CC使用相同的测试时间策略,获得了502分。

这些实验还表明,适应过程在不同规模下并不都呈现相同的表现。SFT带来了Nano模型的大部分性能提升,而RL则带来了较小但稳定的改进。对于更强的Ultra模型而言,一个SFT训练周期就足以在IOI、ICPCHand LiveCodeBench Pro测试中超越完全经过训练的Nano模型。这一发现为2026年IOI比赛所使用的特定竞赛型Ultra-CC系统提供了指导,该系统的得分达到了600分中的535.4分。
教授 Nemotron 进行证明、检查与修改
IMO项目将同样的理念应用到了奥林匹克数学中。从 Nemotron 3 Ultra开始,我们让一名专家使用 SFT 进行训练,另一名专家则使用 RL 进行训练。
SFT语料库中包含 414,890 个经过质量筛选的示例,涉及 15,818 个独特的证明问题。它不仅仅用于教授最终答案。这些数据涵盖了证明的生成、完善、验证以及元验证过程,因此模型学会了构建论证、识别漏洞、回应批评,并判断一个证明是否完整。RL 模型是在 9,597 个接近模型能力边界的证明问题上进行训练的。
在开发实验中,两种后训练过的检查点均优于通用可用模型。SFT检查点在第一次搜索轮次中表现最突出,而RL检查点则取得了最佳的单个检查点结果。它们的优势相互补充,因此最终系统同时使用了这两种专家模型与通用模型。
对于每个 IMO 问题,模型会生成候选证明,进行评分,提出批评意见,并优化最有潜力的方案。一个高计算强度的阶段会选出最终提交作品。整个系统使用自然语言运行,没有正式的证明器、外部工具或互联网访问能力。该系统获得了42分中的30分,其中六个问题中四个获得了满分,并且超过了官方金牌门槛。

>Fine-tuning 和测试时计算协同工作
我们之前的 IOI 2025 Hugging Face 文章展示了测试阶段的计算能力如何使开放权重模型达到黄金级性能。新的结果又增加了重要内容:更好的专业化特性能够为推理系统提供更好的候选样本、更好的评估器以及更好的优化机会。
在 IOI 项目中,GenCorrect 将微调带来的改进效果在多次反馈迭代中进一步提升。在 IMO 项目中,使用互补的 SFT 和 RL 检查点比仅从单个检查点获取更多样本更有价值。在这两种情况下,最佳结果都是通过结合具备能力的专家与能够搜索、验证和改进的系统来实现的。
这种区别非常重要。这些奖牌并非仅通过精细调整产生,也并非仅通过暴力采样产生。它们是通过共同设计模型、数据以及推理循环而得出的。
在 Hugging Face 上公开模型、数据和配方
我们希望这些成果能够在竞赛之外也有用。Nemotron Labs IMO 2026 集合包含了 SFT 和 RL 检查点以及训练数据集,还有 Nemotron-IMO-Bench——一个包含 200 个奥林匹克水平问题的新基准测试。IMO 论文介绍了训练方法和生成-验证-优化系统,而 NeMo-Skills 仓库则包含 IMO 推理管道、提示词、提交的证明以及可复现的快速启动方案。对于竞赛编程,Nemotron-3-Ultra-CC 模型可在 Hugging Face 上获取,IOI 论文提供了训练方案和 GenCorrect 方法。IOI 评估和推理管道也可在 NeMo-Skills 中找到。
结合起来看,IMO和IOI为这个简单的想法提供了非常严格的验证标准:Nemotron可以被优化为一流的领域专家,再通过透明的推理工作流进行整合,从而解决人类竞争前沿的问题。
我们很期待看到 Hugging Face 社区接下来会创造什么。