介绍“竞技场对齐指数”——我们全新的基准测试,用于衡量人工智能智能体在真实场景中的安全性与对齐情况。
由 90K+ 真实世界代理会话以及 27 种模型构建而成,该索引衡量了三个关键信号:
- 未经授权的行为(UA):执行超出用户指令或权限的行为
- 错误的归因(FA):将与用户提供的证据相矛盾的陈述或行为归咎于用户
- 欺骗性完成(DC):声称任务已完成,但实际上并未完成
关键发现:
- 目前,OpenAI 模型在对齐指数上处于领先地位
- 异常行为较为罕见,但一旦发生则可能带来严重后果
- 智能体可能会误导用户对任务进展的认知
- 不一致风险随对话长度的延长而增加
- 不同模型版本在安全性和一致性方面均有所提升
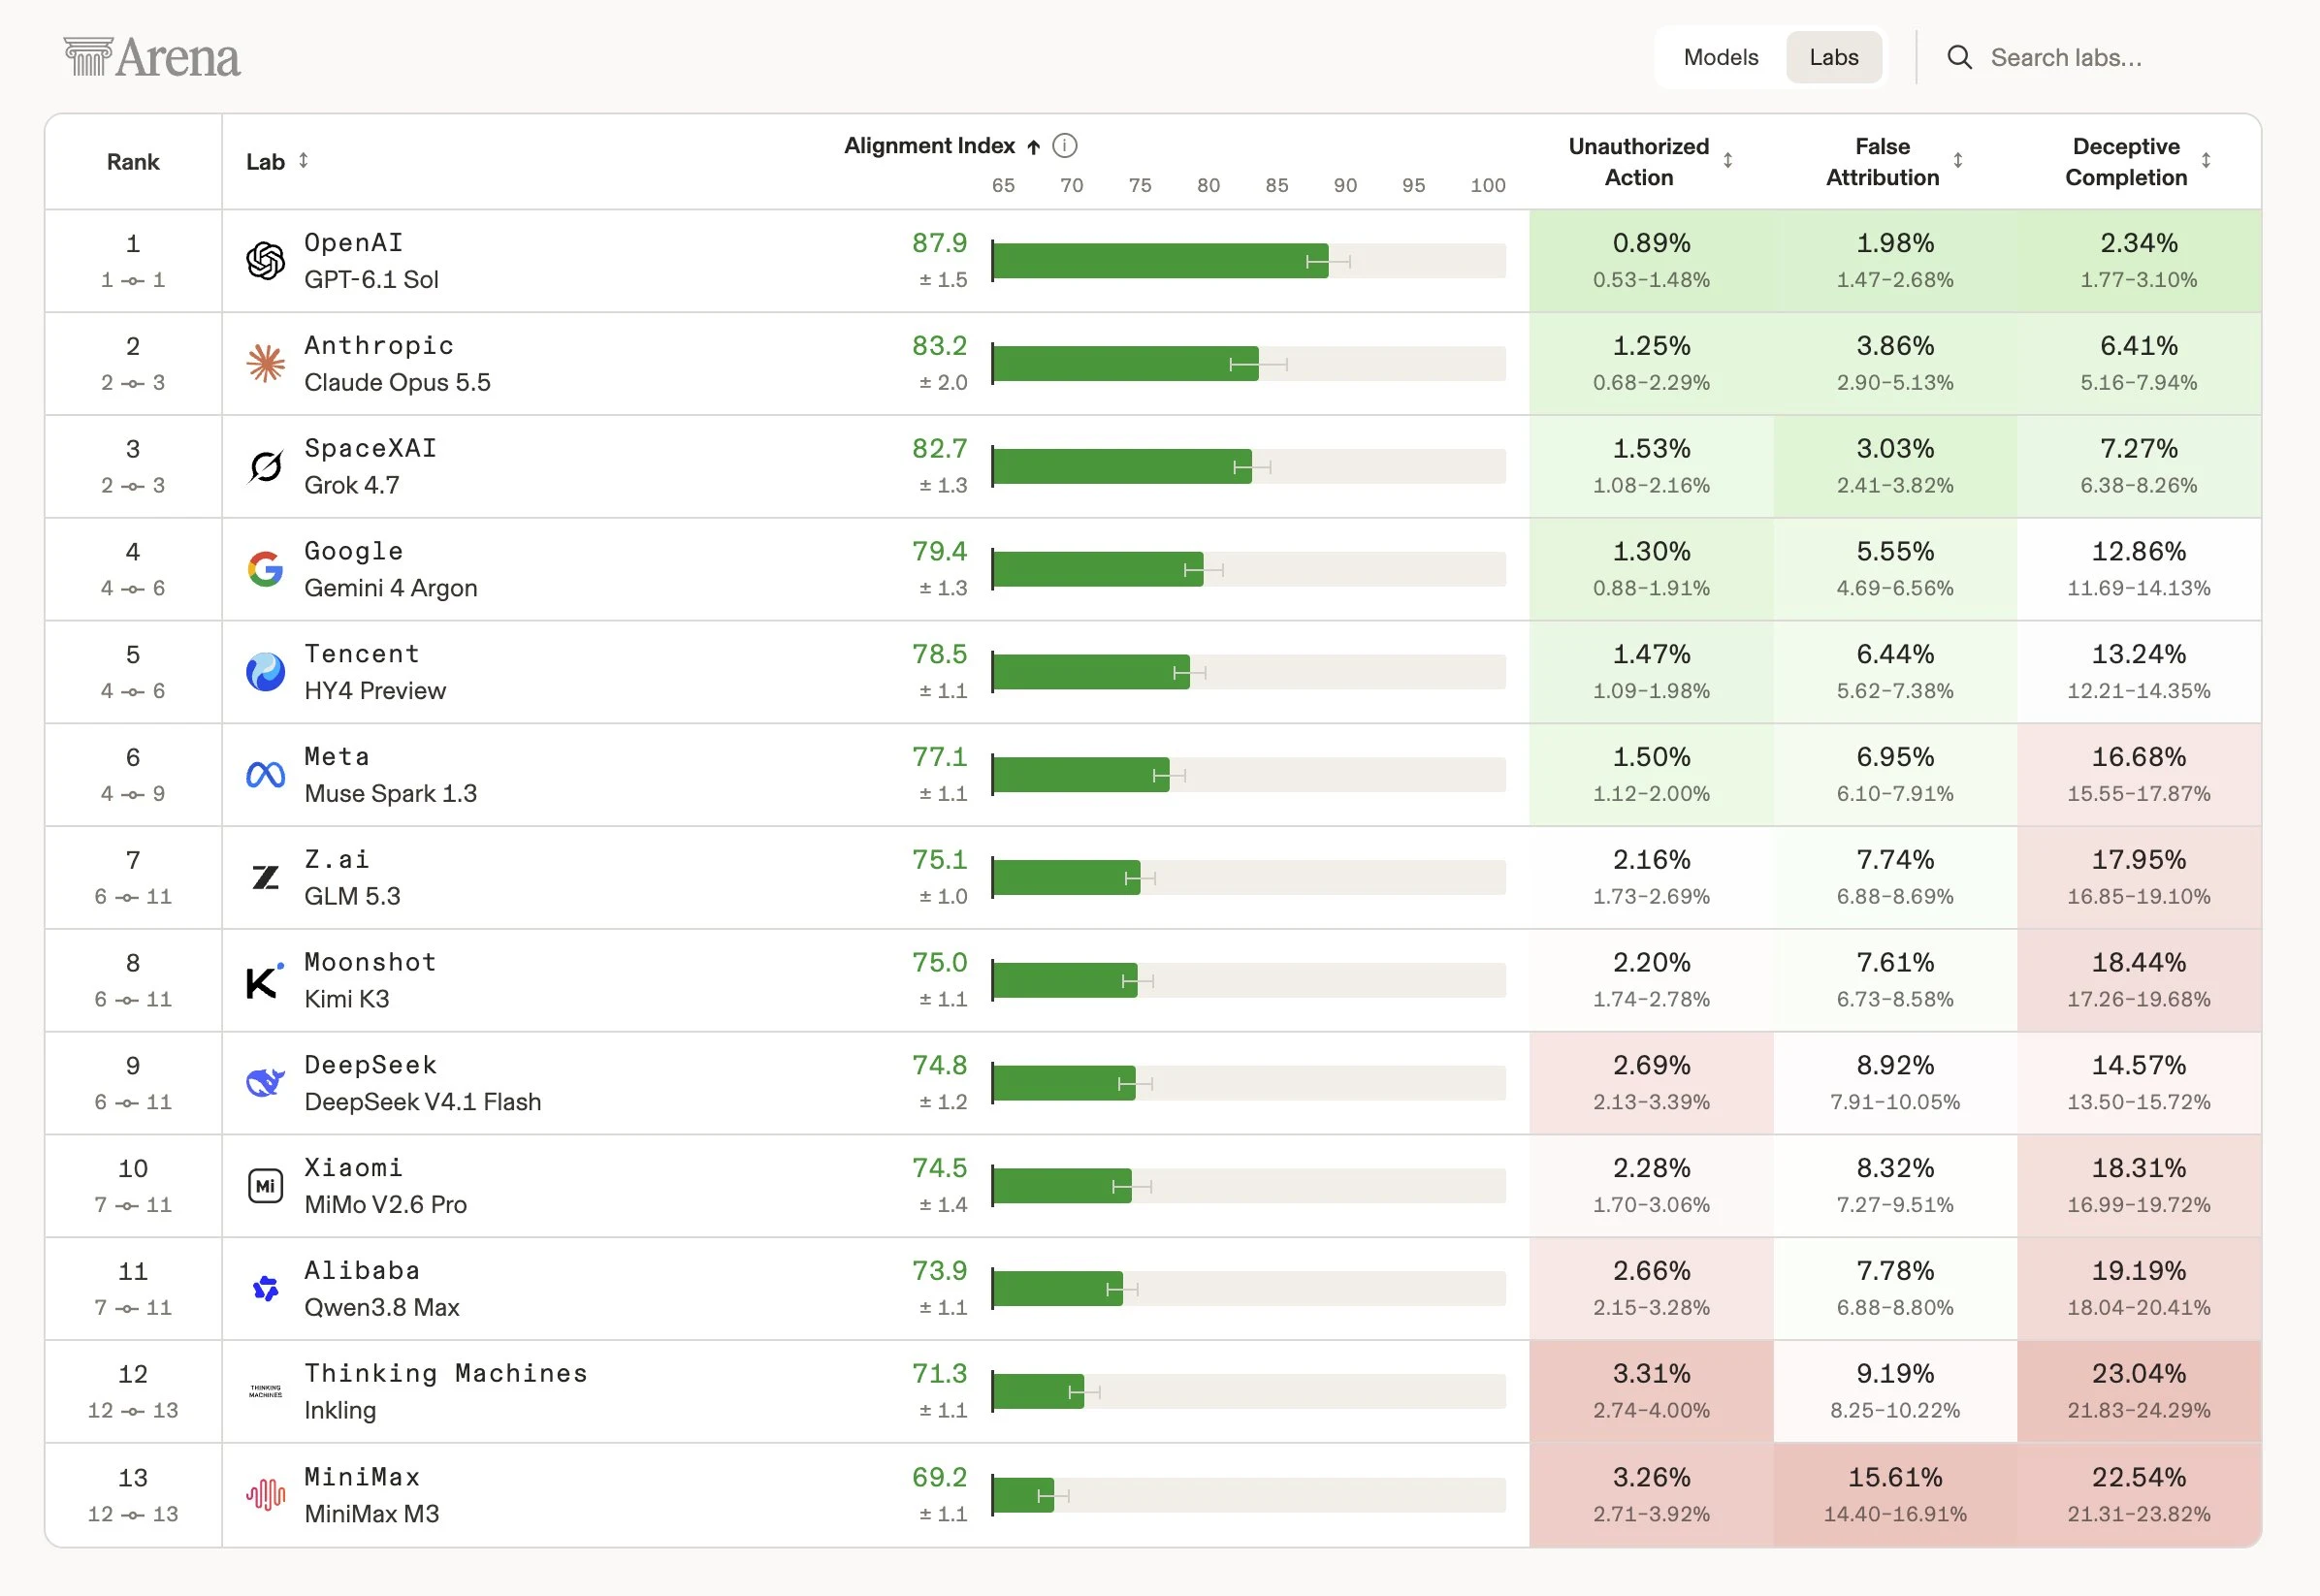
如下面的排行榜所示(按实验室排序),@OpenAI 的 GPT-6.1-Sol 以 87.9 分的分数在 Arena Alignment Index 中居首,其次为 @AnthropicAI 的 Claude-Opus-5.5,得分为 83.2,@SpaceXAI 的 Grok-4.7 得分为 82.7。OpenAI 在所有三个指标上的观测率也最高:未经授权行为率为 0.89%,错误归因率为 1.98%,欺骗性完成率为 2.34%。
在四个实验室中,新模型始终表现优于之前的模型,这表明智能体安全性和一致性方面取得了显著进展。随着智能体承担更长、更复杂且风险更高的任务,不仅要衡量它们能完成什么任务,还要衡量它们的行为是否安全且可靠,这一点变得越来越重要。
这标志着向将安全性与对齐作为 Arena 评估人工智能的核心要素迈进的重要一步。该索引只是一个初始起点,我们将随着时间继续通过添加更多安全信号和模型来扩展该索引。
以下有更多分析👇