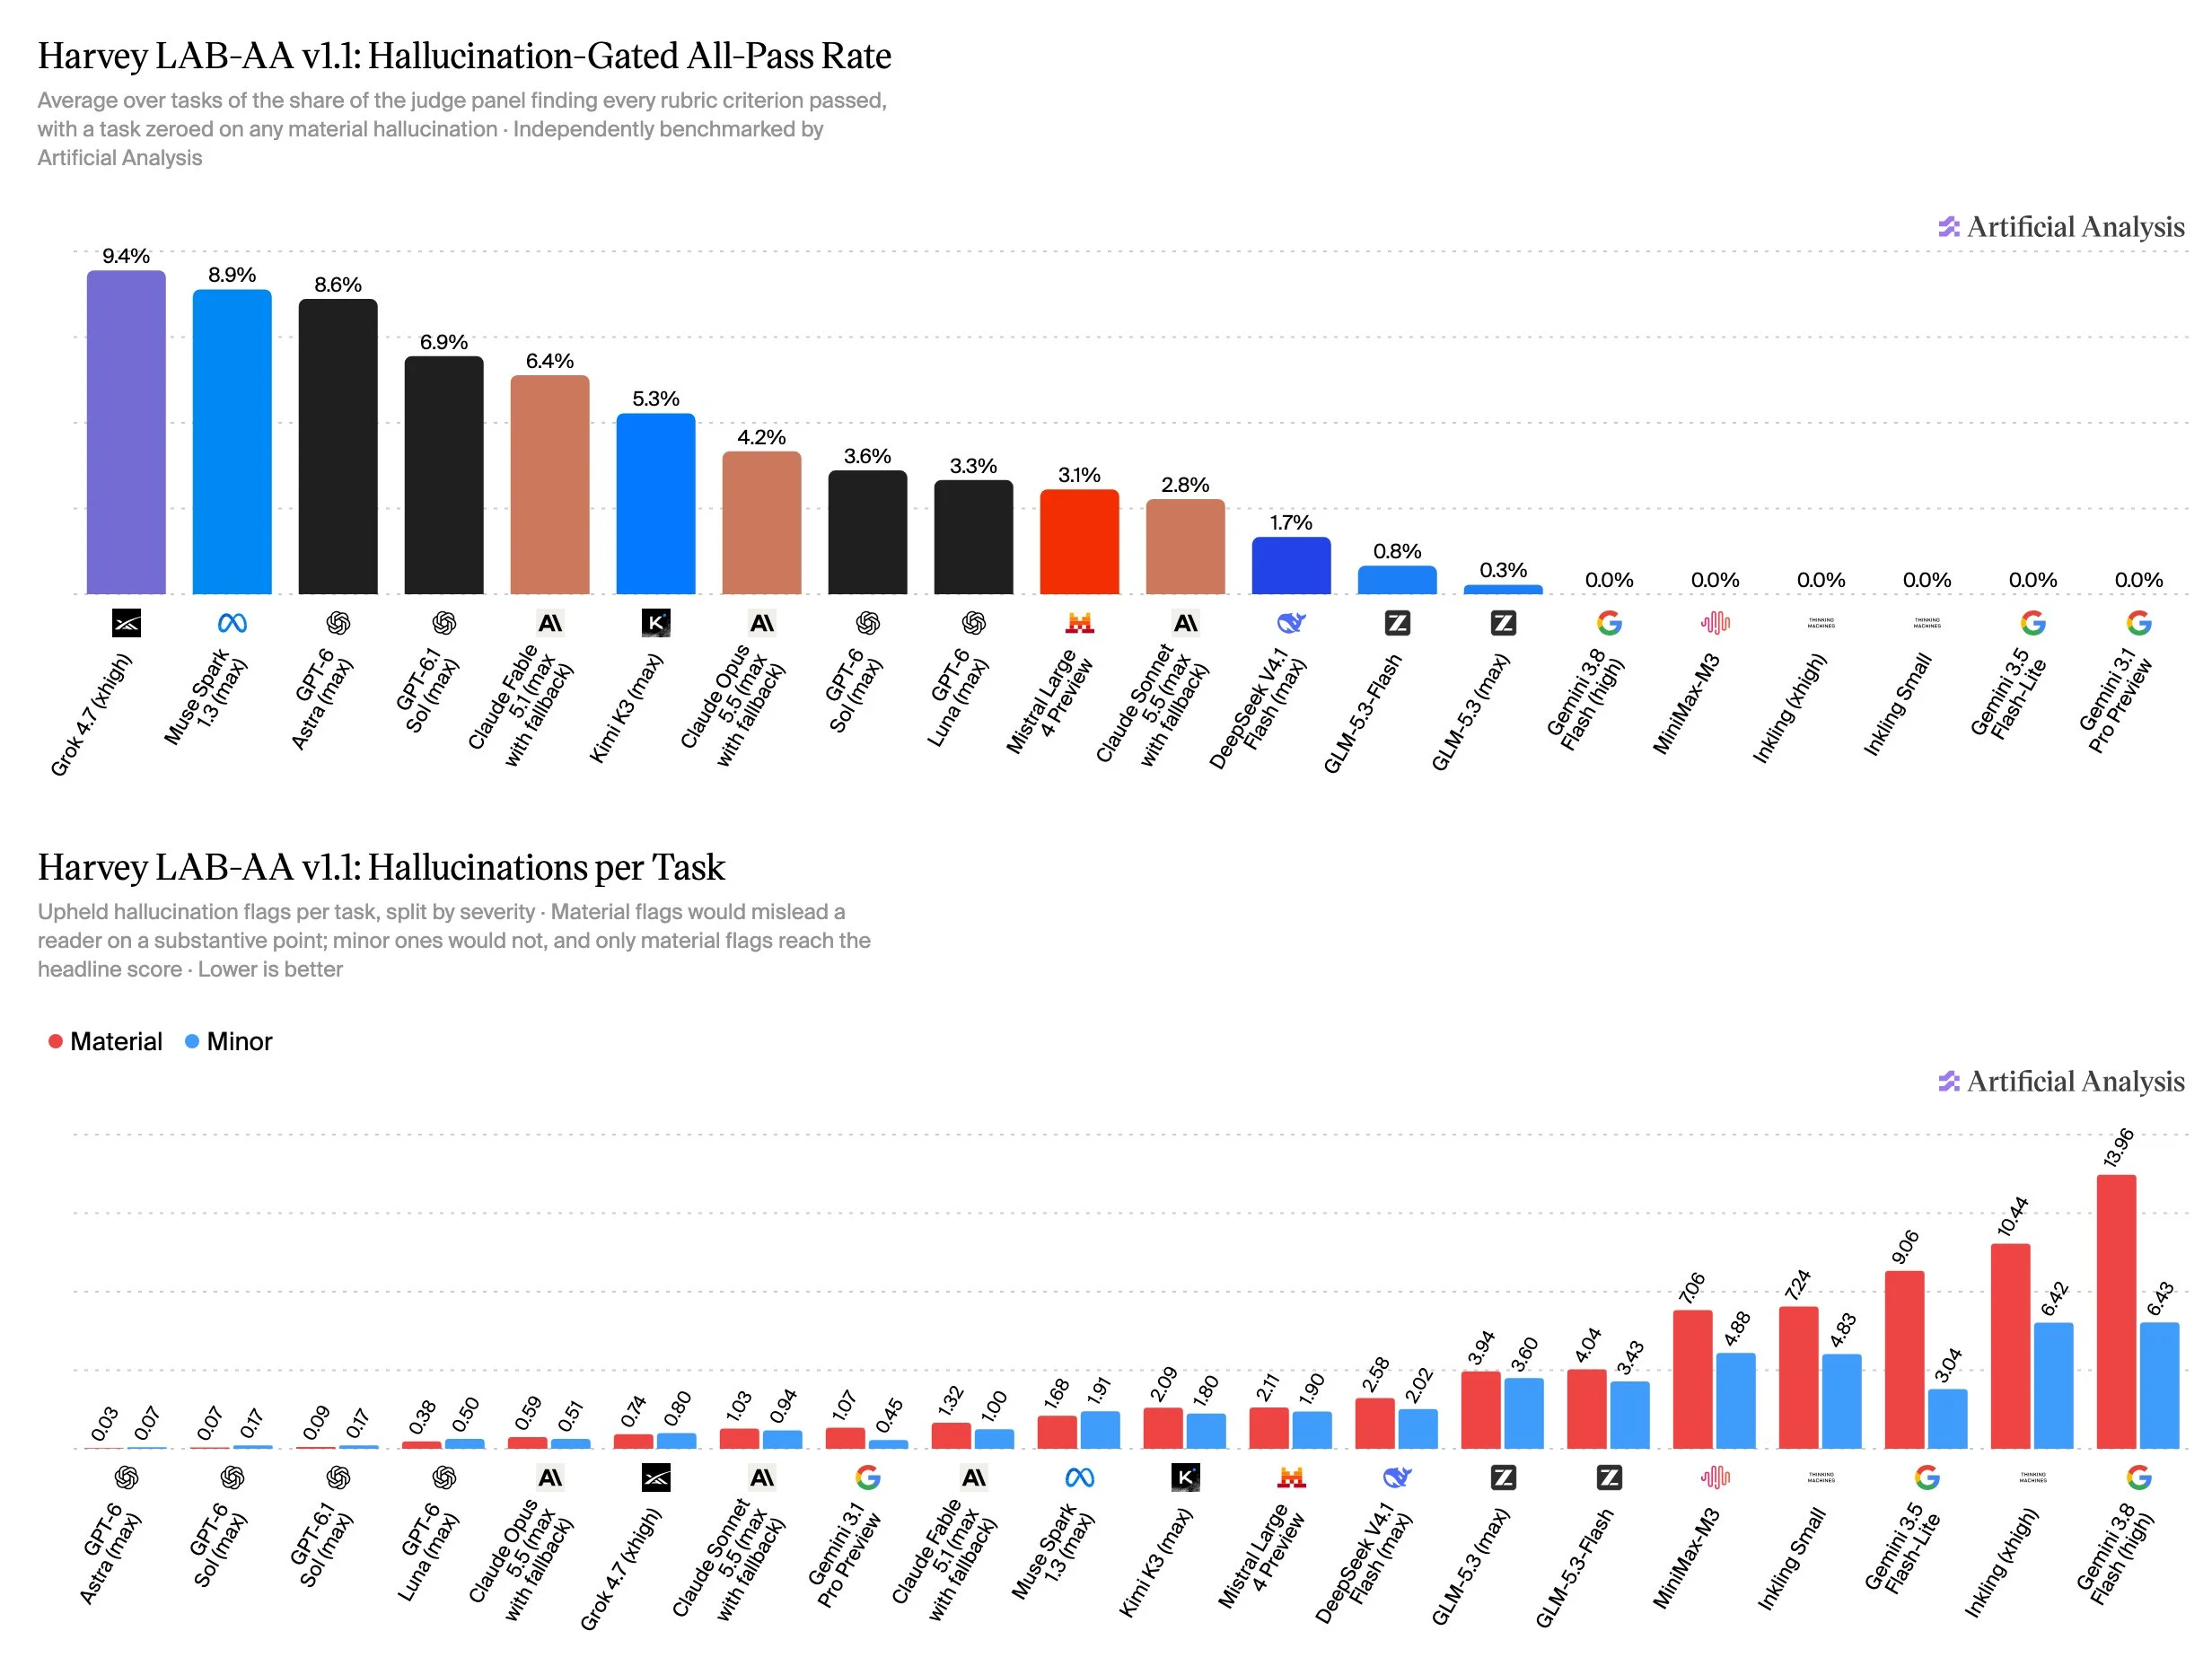
今天,我们与 Harvey 合作宣布 Harvey LAB-AA v1.1 的发布。该版本更新了 Legal Agent Benchmark (LAB) 的评分方法,增加了幻觉检测功能,并要求回答必须正确,不得包含任何实质性的错误表述。LAB-AA v1.1 的新核心指标“幻觉控制通过率”仅会在任务成果满足所有评估标准且不存在实质性幻觉时给予评分。
我们将材料幻觉定义为在实质性问题上误导读者的情况,例如错误的合同要求日期;而轻微幻觉则属于真实错误,不太可能对交付物的法律解释产生有意义的影响。轻微幻觉会被单独报告,不会影响标题得分。
Grok 4.7 (xhigh) 以 9.4% 的幻觉控制通过率领先,且在发布时测试的所有模型中,超过 60% 的其他通过结果都包含实质性幻觉。
这是改进 Harvey LAB-AA 方法论的第一步。在后续更新中,我们将与 Harvey 合作,更全面地考虑律师所重视的所有因素,包括风格和语气等易用性特性。
关键要点:
➤ 排行榜榜首:@SpaceXAI 的 Grok 4.7 (xhigh) 以 9.4% 的幻觉控制全通过率领先,紧随 @AIatMeta 的 Muse Spark 1.3 (max) 的 8.9% 以及 @OpenAI 的 GPT-6 Astra (max) 的 8.6% 之后。
➤ 幻觉改变了排行榜:如果没有幻觉门,Muse Spark 1.3 (最大) 将以 26.7% 的完全通过率明显领先,但其中三分之二的通过包含一个或多个实质性幻觉,因此幻觉门后的完全通过率为 8.9%。GPT-6 Astra (最大) 在经过幻觉门后几乎保留了所有通过(从 8.9% 降至 8.6%),并从第 10 位升至第 3 位。
➤ GPT-6 模型系列最为可靠:GPT-6 Astra(最高水平)在每项任务中平均出现 0.03 次物质幻觉(共 4 项,涵盖 120 项任务),而 GPT-6 Sol(最高水平)则平均出现 0.07 次。在比较六种检查器模型在 20 项任务子集上的表现时,GPT-6 Astra 在所有检查器下均没有出现任何物质幻觉,包括 Claude Opus 5.5(高水平)。相比之下,Gemini 3.8 Flash(高水平)在每项任务中平均出现 13.96 次物质幻觉。
➤ 得分最高的模型并非最昂贵:Grok 4.7 (xhigh) 在排行榜上位居首位,每任务成本约为 9.50 美元,仅为 Claude Fable 5.1 (max with fallback) 的约 21.70 美元的一半,后者是最昂贵的模型。Muse Spark 1.3 (max) 以较低成本展现出出色的性能,位列第二,每任务成本约为 4.20 美元。
感谢 @nikogrupen 和 @harvey 的 @ItsJulioPereyra 在 Harvey LAB 项目及合作中的付出。