
上周,我想要一个随 Qwen-Image 2.1 一起发布的提示词重写器 随 Qwen-Image 2.1 一起发布的那个。官方版本是一个 9B 模型,需要大约 20 GB 内存,并且在写下一段文字之前要用数千个 token 进行思考。在 Hub 上,我只找到了同一个 9B 模型的压缩副本。于是我把想要的东西描述给 ML Intern,第二天我就有了一个 可以在 CPU 上运行的 0.8B 版本 。它有 99.7% 的时间能返回有效输出,并且使用的 token 大约只有教师模型的四分之一。整个项目的算力开销,包括让 9B 模型标注 8,797 条示例请求,总计 16 美元。
在接下来的几天里,我用同样的方法又做了五个模型。每一个都始于在 HuggingChat 中开启 ML-intern 后发出的一条消息,每一个都终于 Hub 上的一个公开模型,模型卡中附有评估结果。ML-intern 规划工作,在花任何钱之前先向我要预算,在正式任务之前先运行一个小测试,然后训练、评估并在 Hugging Face 的硬件上发布。
我如何给 ML Intern 写提示词
第一条消息是我花心思最多的地方。我的第一个提示词,也就是下面分享的 citrus 模型的提示词,大约 450 个词。到我的第 6 个项目时,它接近 2,000 个词,因为每个项目都教会了我一些想在下一个项目中加入的东西。所有七个提示词都在 GitHub 上: yvrjsharma/ml-intern-prompts,与我当初所写的完全一致。
提示词先用一行说明想法以及我为什么想要它。然后它列出确切的部分:数据集、基础模型、训练脚本。任何我已经验证过的内容都放在一个标题字面写着“Verified facts, do not re-derive(已验证事实,不要重新推导)”的章节下,这样智能体就把预算花在正事上,而不是重新发现我已经知道的东西。对于相机角度 LoRA,该章节列出了哪个训练器刚刚添加了对透明图像的支持,以及哪些开放的 GitHub issue 使得备用训练器存在风险。
提示词中有两行至关重要。 第一行 要求在任何训练之前先给出基线。例如, citrus 提示词 说:“Also report the base model's zero-shot score on the same metric before training so we can see the gain.(还要报告基础模型在同一指标上训练前的零样本得分,以便我们看到提升。)”没有它,你会得到一个训练好的模型,却不知道它是否比起点更好。 第二行 是一个附带检查的冒烟测试。对于图像 LoRA,我要求先运行 50 个训练步骤,然后检查保存的权重是否真的发生了变化,之后再为完整运行付费。
在提示词的最后,我会列出预期的交付物并限制成本。我定义模型卡中应包含的内容,并加入一条指令,比如:“Cap total spend at USD 12 and ask me before exceeding it.(将总支出限制在 12 美元以内,超出前先问我。)”因为 ML-intern 以零预算开始每个任务,并且在执行付费任务前需要许可,所以这条支出限制会被严格执行。当你没有给出预算时,智能体会根据项目规模提出几种方案,并询问你偏好哪一种。
第一次尝试时你不一定需要所有这些内容。例如,我在 citrus 简报中没有 已验证事实 章节,ML Intern 仍然产出了一个准确率 提升超过三倍的模型 的 Qwen3.5-2B 模型。让我带你了解我在短短几天内用 ML-Intern 构建的 6 个项目。
1. 一个了解你所在领域的模型
通用视觉模型可以描述一片发黄的柑橘叶子。然而,要告诉你这是螨虫问题还是缺镁,以及治疗该植物的生物和非生物方法,就非常困难了。我使用 Claude 整合了一个训练数据集,合并了 Hub 上 Project-AgML 组织托管的三个来源。最终得到的 citrus-disease-vlm-instruct 是一个数据集,包含 3,017 张标注图像,涵盖 21 种不同的害虫、疾病、营养缺乏和治疗方法。ML-Intern 使用这些示例对 Qwen3.5-2B 进行了微调,并事先对基础模型做了基准测试。
在 335 张测试照片上,基础模型有 14.9% 的时间能说出正确的问题。在一块 A10G 上训练两个 epoch 后,微调后的模型达到了 52.8%。计算成本约为 1.90 美元。
2. 一个绘制你的角色的模型
图像模型认识很多角色。Huggy——以 Hugging Face 品牌素材的扁平风格绘制——并不在其中。我让 ML-Intern 训练一个 LoRA,基于 FLUX.2 klein base 4B,该模型使用了来自以下来源的84幅带说明文字的绘画进行训练 Chunte/huggy_for_training 数据集的 84 张带说明的画作。
该智能体每 100 步保存一个检查点,并用同一组提示词对每个检查点进行绘图,这让选择变得容易。第 200 步是 Huggy 第一次完全 on-model。从第 500 步开始,Huggy 的风格开始渗入与 Huggy 毫无关系的提示词中!训练出的 LoRA 也能在 4 步的蒸馏 klein 模型上工作。计算成本约为 7.60 美元。
看看: 模型 · 数据集 · Huggy 生成器应用
3. 一个会新把戏的模型
- 机位 LoRA 是早期 Qwen-Image 模型中最受欢迎的社区附加组件之一。你可以给模型一张物体的图片,并要求从左侧 45 度查看它。在 Qwen-Image 2.1 模型发布几天后我检查时,还没有人做过一个,于是我让 ML-intern 来构建它。
ML-intern 渲染了来自以下来源的1,030件扫描家居物品 Google Scanned Objects 的 1,030 个扫描家用物品,每个 24 个角度,共 24,722 张透明图像,这是一个成本仅几美分的 CPU 任务。它后来最终确定 461 个物品用于训练、40 个留作测试,以及 1,844 对训练前后的配对,均匀分布在 23 条相机指令上。
训练在一块 A100 上运行了 2,000 步,耗时约 90 分钟(约 3.75 美元)。整个项目耗时约半天、48 个任务,其中包括那些因缺少软件包或路径错误而失败、不得不由 ML-Intern 重新提交的任务。总计算成本约为 16 美元。
- 涂鸦植入 LoRA 是另一个很棒的点子。上传一张带有洋红色涂鸦的照片,并添加一个命名某物体的简短提示词。该 LoRA 会用那个物体替换涂鸦,同时保持原始光照和构图一致。
没有现成的数据集,所以我的提示词描述了如何制作一个。从 Open Images 中的一张真实照片开始,用 LaMa 修复模型移除一个物体,并在物体原来的位置画一个涂鸦。未修改的照片就是目标。ML-intern 在 CPU 沙箱中编写并测试了配对构建脚本,然后作为 GPU 任务运行它们,并在此过程中记录了每张源照片的作者和许可证。它构建了 6,042 个训练配对和一个 160 对的测试集,其中 40 个测试配对来自完全未纳入训练的 23 个物体类别。
训练前,它测量了基础模型自身的表现以及配合 Viggle turbo LoRA 的表现,并验证了批量运行编辑会产生相同的图像,这使评估更便宜。训练在一块 A100 上运行了 2,000 步,耗时 1 小时 38 分钟(约 4 美元),对保存的检查点在 48 个测试配对上的比较选择了第 500 步。
与 Viggle turbo LoRA 配合、在 6 步时,该 LoRA 表现非常出色。 67.5% 的对象在绘制处被检测到,每次编辑耗时 4.7 秒。来自 23 个未见类别的物体和其他物体一样可靠地落位(65.0% 对 64.2%)。该项目耗时一天多一点、59 个任务。总计算成本约为 24 美元。
看看: 模型 · 数据集 · Doodle-in 应用
4. 一个适合你设备的模型
- 这篇 Pocket Rewriter 文章开头提到的是第一个。ML-intern 首先通过 Inference Providers 用一个小型 instruct 模型生成了 8,797 条短图像请求,遵循我在提示词中设定的混合要求:照片、海报、徽标、信息图等,其中约三分之一要求引号中包含精确文本,且许多使用英语以外的语言。随后 9B 教师模型在一块 A100 上用 2 小时 37 分钟(约 USD 6.50)重写了全部请求。经过质量筛选后,选出了 1,840 个示例用于训练数据集。
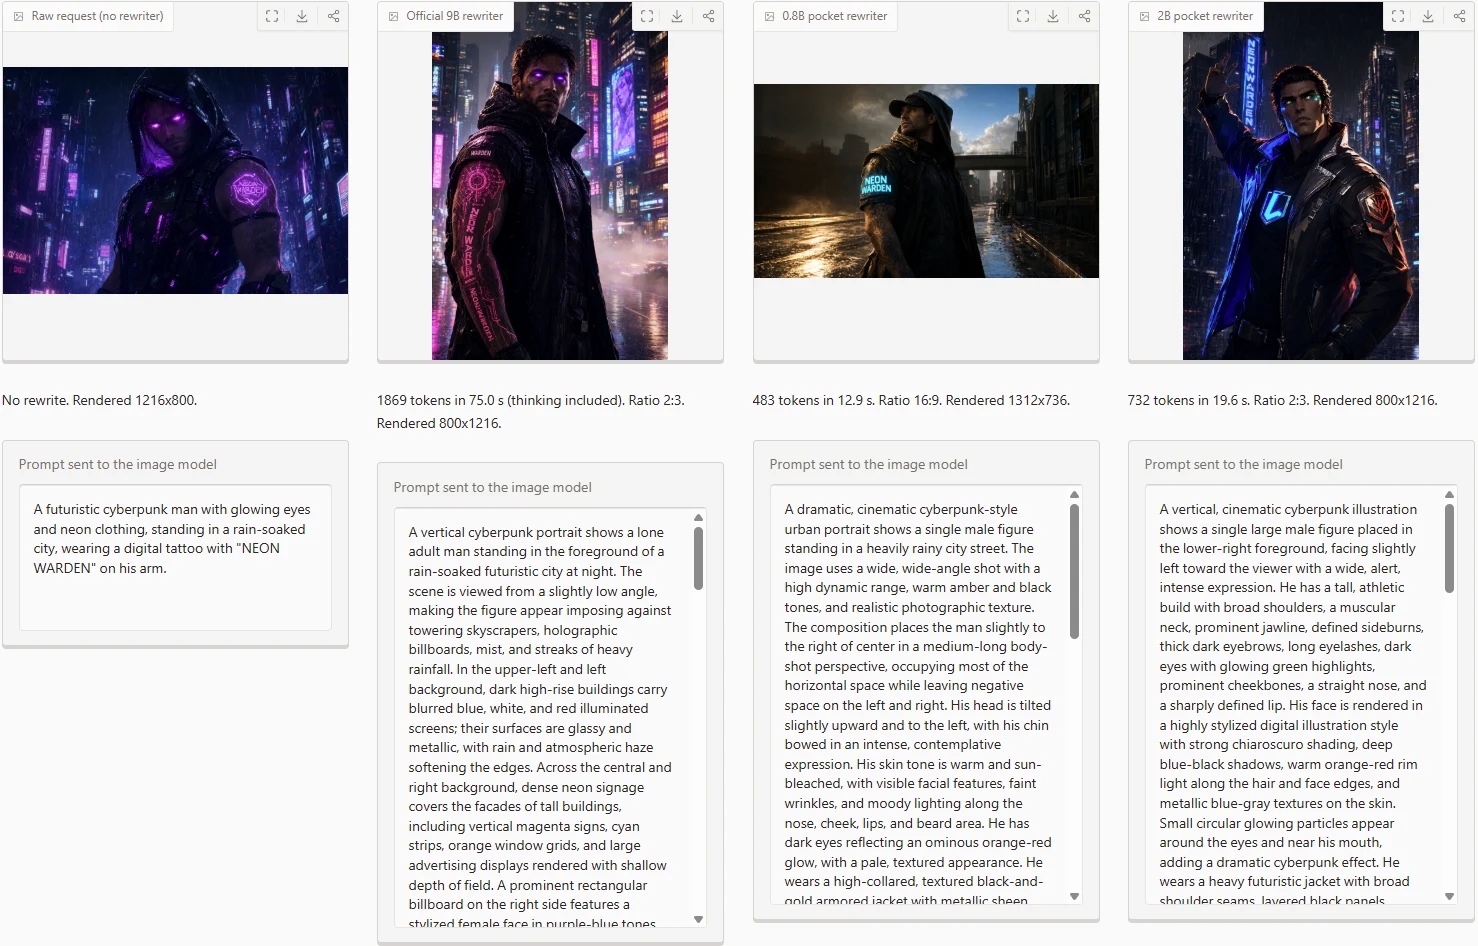
训练 0.8B 和 2B 学生模型在 A10G 上分别花了 12 分钟和 18 分钟(两者共 USD 0.75)。0.8B 模型还以 812 MB 的 GGUF 文件形式发布,可在 CPU 上运行。该项目总共耗时约 11 小时、24 个任务。总计算成本约 USD 16。
请查看: Pocket rewriter 0.8B Student · 2B Student · 数据集 · Pocket Studio App · 在 Rewriter Arena 中比较师生模型
- Agate-Preview-002-4step 是第二个。 Logolabs' Agate Preview 002 是一个 260M 参数的文本到图像模型,小到可以在浏览器中运行,但它需要 50 步并带引导(guidance),即每张图像 100 次网络前向。我让 ML-intern 把它蒸馏到只需 4 次前向!
这花了两次运行。第一次运行将 155,000 张训练图像缓存为潜变量(latents),把引导烘焙进模型,然后分阶段把步数从 16 减到 8 再到 4,全部在 A100 上完成。这个 4 步的学生模型在 GenEval 和 FID 上胜过了在同一 4 步设置下运行的教师模型,之后 ML-intern 将其导出为 ONNX 以便在浏览器中使用。这次运行耗时约 13 小时,花费 22 美元。
我进行了第二次训练,让 ML-Intern 进一步改进这个 4 步学生模型。它随后用教师模型以 16 步生成了另外 24,000 对图像,并用大约一小时对 4 步学生模型进行微调。GenEval 从 0.509 提升到 0.536,而教师模型在 50 步时为 0.563,而它只用 4 步(四分之一的计算量)。ML-intern 重新导出了浏览器版本。第二次运行耗时约 8 小时。两次运行的总计算成本约为 37 美元。
请查看: Agate 4-step model · 数据集 · 在浏览器中运行 Agate · Agate 4-step LIVE
成本
| 模型 | 基础模型 | 计算 |
|---|---|---|
| Citrus Doctor | Qwen3.5-2B | 1.90 美元 |
| Huggy LoRA | FLUX.2 klein base 4B | 7.60 美元 |
| Pocket rewriter (0.8B 和 2B) | Qwen3.5-0.8B 和 2B | 16.05 美元 |
| Viewpoint Orbit LoRA | Qwen-Image 2.1 | 16美元 |
| Doodle-in LoRA | Qwen-Image 2.1 | 24.30美元 |
| Agate 4步(两次运行) | Agate Preview 002 | 37美元 |
| 总计 | 约103美元 |
这些是每次会话所报告的 GPU 和 CPU 任务费用。
制作你自己的
ML-intern 已在 HuggingChat上线。开启 ML-intern 模式并粘贴一个提示词。如果你想要一个起点, 我的示例提示词 可以免费复制。从一个你希望存在的模型和一个你拥有的(或能够描述的)数据集开始。给它一个小预算,要求一个基线和一个冒烟测试,并在提高上限之前先阅读返回的结果。
如果你用它做了什么作品,请在 X 上分享并标记 @Gradio 和 @HuggingFace。我们很想看到你做出的、别人想不到要为你构建的模型。