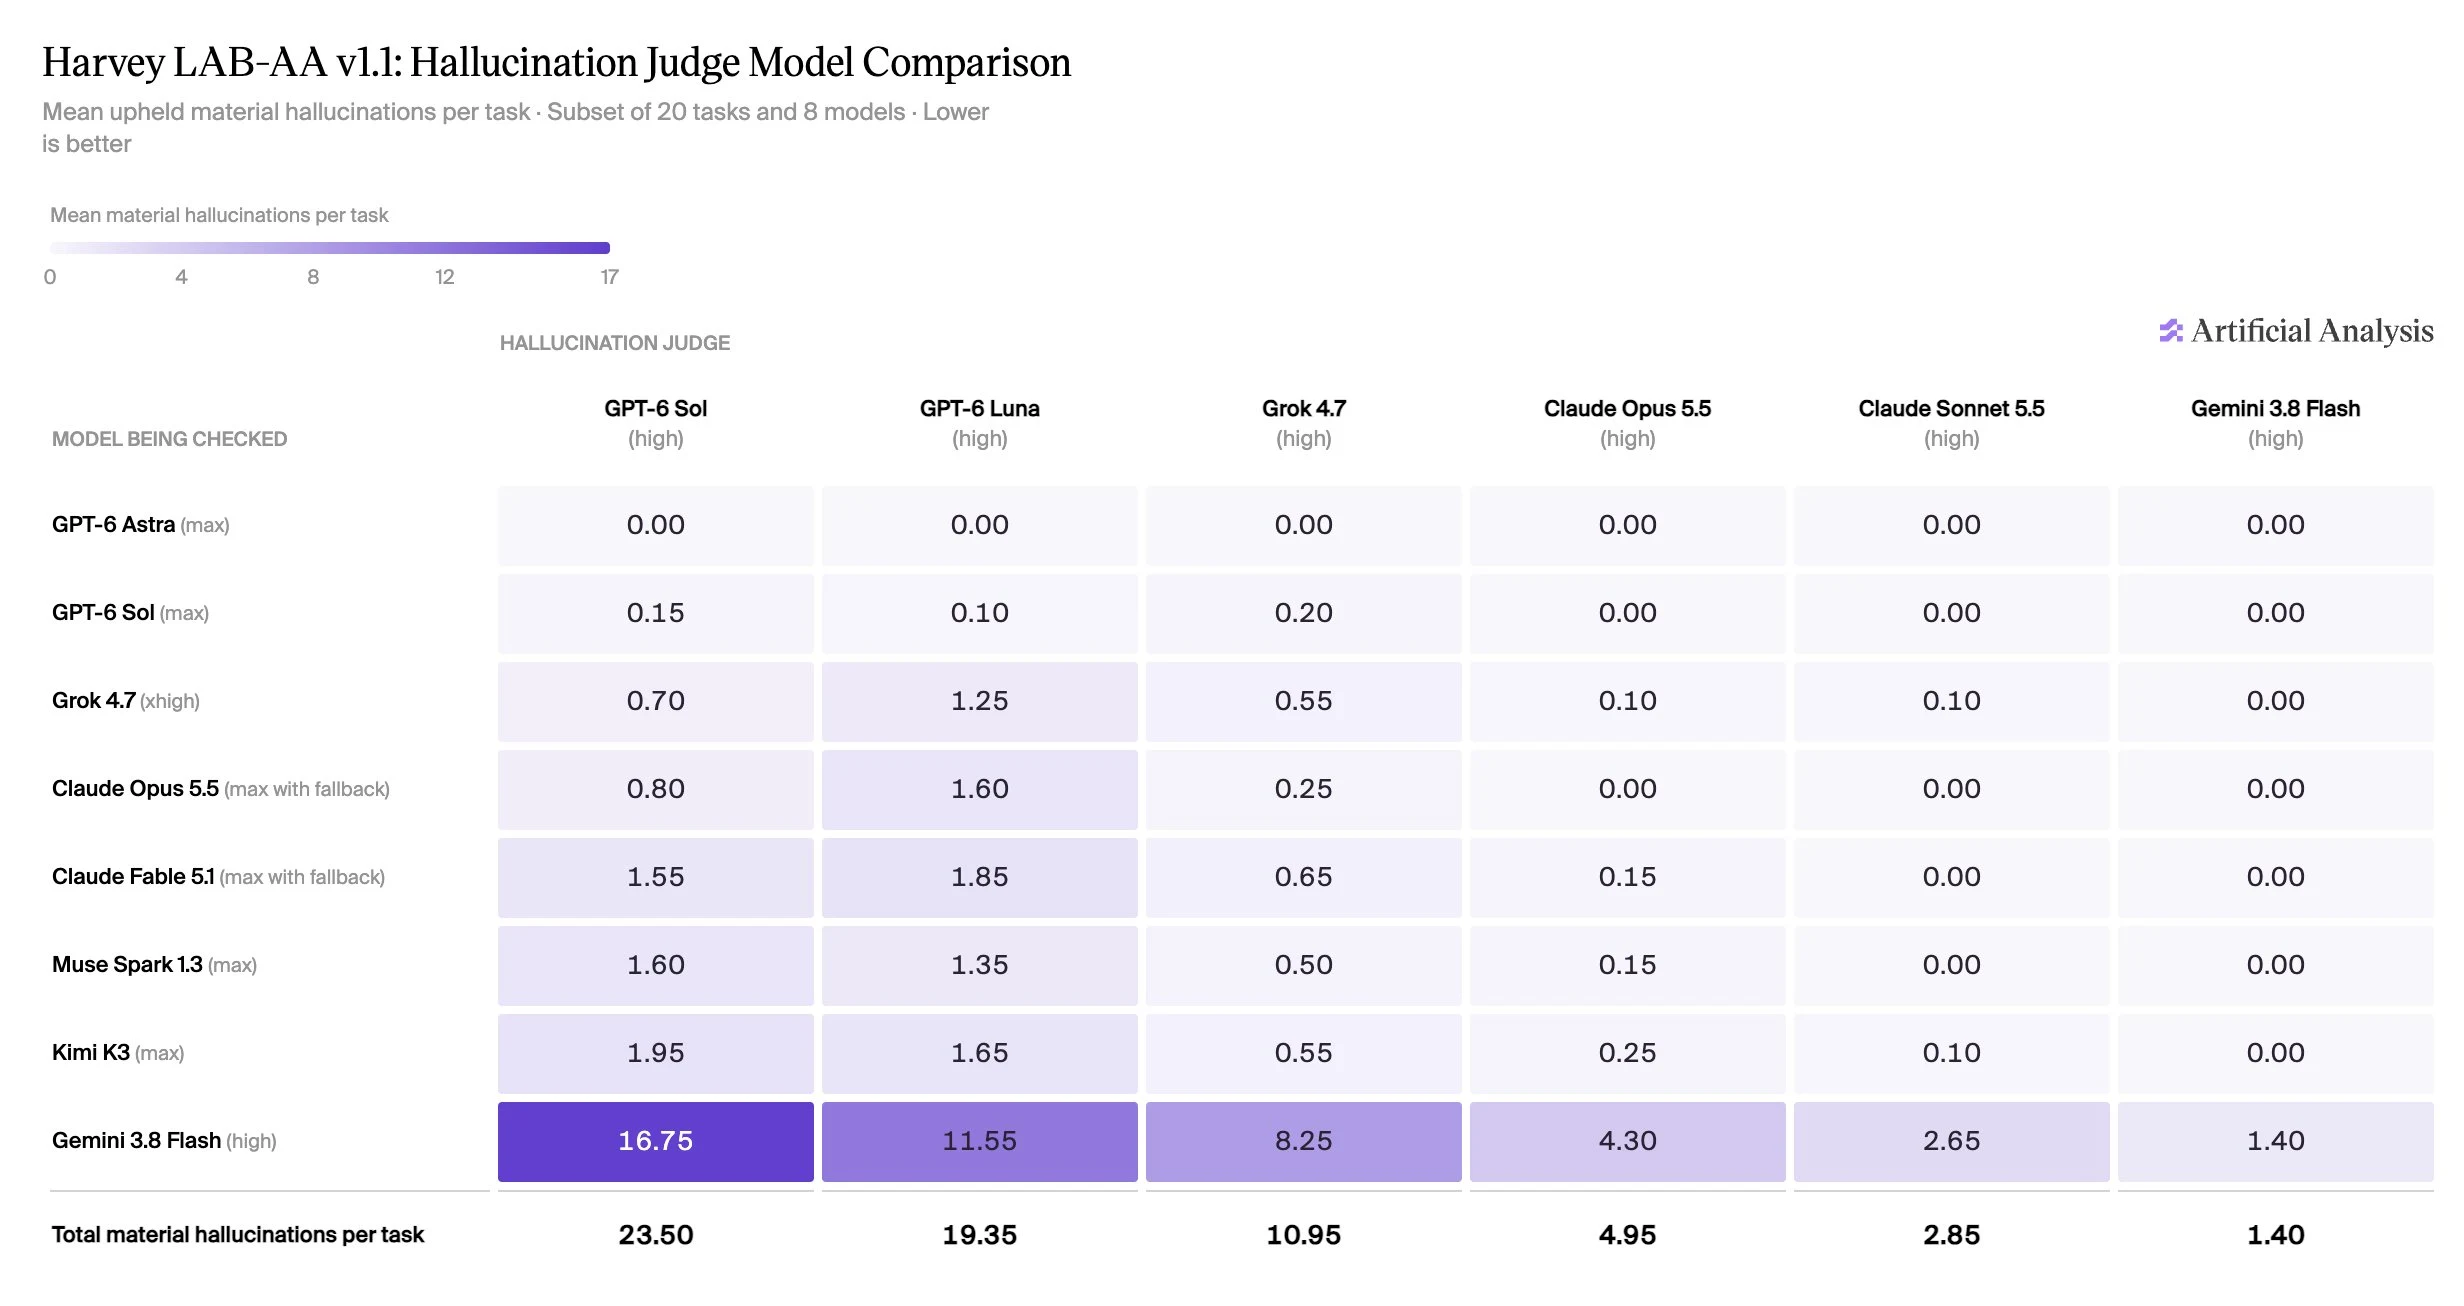
我们在来自 20 个任务和八个模型的固定子集的相同交付成果上比较了六种幻觉检查器。我们使用 GPT-6 Sol (high)、GPT-6 Luna (high)、Grok 4.7 (high)、Claude Opus 5.5 (high)、Claude Sonnet 5.5 (high) 和 Gemini 3.8 Flash (high) 运行了我们的两阶段检查,并选择了 GPT-6 Sol (high) 用于生产使用。
在这个 20 任务子集中,GPT-6 Sol 和 GPT-6 Luna 总体上识别出更多实质性幻觉,而 Claude Sonnet 5.5 和 Gemini 3.8 Flash 识别出的要少得多。Claude Opus 5.5 在每个模型行中都介于 Grok 4.7 和 Claude Sonnet 5.5 之间。总计,Opus 确认了 99 个实质性幻觉,而 Grok 为 219 个,Sonnet 为 57 个,GPT-6 Sol 为 470 个。尽管该检查在标记错误时采取保守方法——排除源文档中不包含的一般法律知识——GPT-6 Sol 仍识别出更多实质性幻觉。
所有六种检查器都在 GPT-6 Astra 的输出中未发现实质性幻觉,而 GPT-6 Sol 在每个任务中介于 0 到 0.20 之间。在每种检查器下,两者都是实质性幻觉最少的模型之一。这一比较显示了检查器行为的差异;仅凭这些数字并不能确定准确性或排除自我偏好。