
vLLM 现已支持 Vera Rubin NVL72!
NVIDIA Vera Rubin 是专为代理式推理打造的下一代平台。自 Vera Rubin 公布以来,Inferact、NVIDIA、Red Hat 和 vLLM 社区一直在 Vera Rubin NVL72 上移植 vLLM。如今 vLLM 已可在 Vera Rubin NVL72 上运行,提供每日容器构建,并支持来自 DeepSeek、Moonshot AI、Z.ai 和 MiniMax 的模型。
本文是当前进展的初步概览,以下是迄今工作的一些亮点:
- Vera Rubin NVL72 硬件: 相比 GB200 NVL72,NVFP4 FLOPS 提升 5 倍,HBM 带宽提升约 2.4 倍,双向 NVLink 带宽提升 1.7 倍,softmax 所需的指数运算速度提升 2-4 倍。
- 第0天支持: Rubin 建立在 Blackwell 架构系列之上,因此 vLLM 的 Blackwell 内核与 Rubin 兼容。得益于此,vLLM 已在 Rubin 上支持 DeepSeek、Kimi、GLM 和 MiniMax 等多种模型。
- 针对 Rubin 调优的内核: 通过 FlashInfer 0.7.0,vLLM 获得了针对 Rubin 调优的注意力、GEMM 和 MoE 内核。我们还为 Rubin 调优了 MiniMax Sparse Attention (MSA) 预填充内核。
- 局部性感知的 MoE: 为了充分利用 Rubin 提升的 HBM 带宽,我们利用 CUDA 13.4 的局部性域来拆分 MoE 权重。这使 SM 只能从离它们最近的内存读取权重。
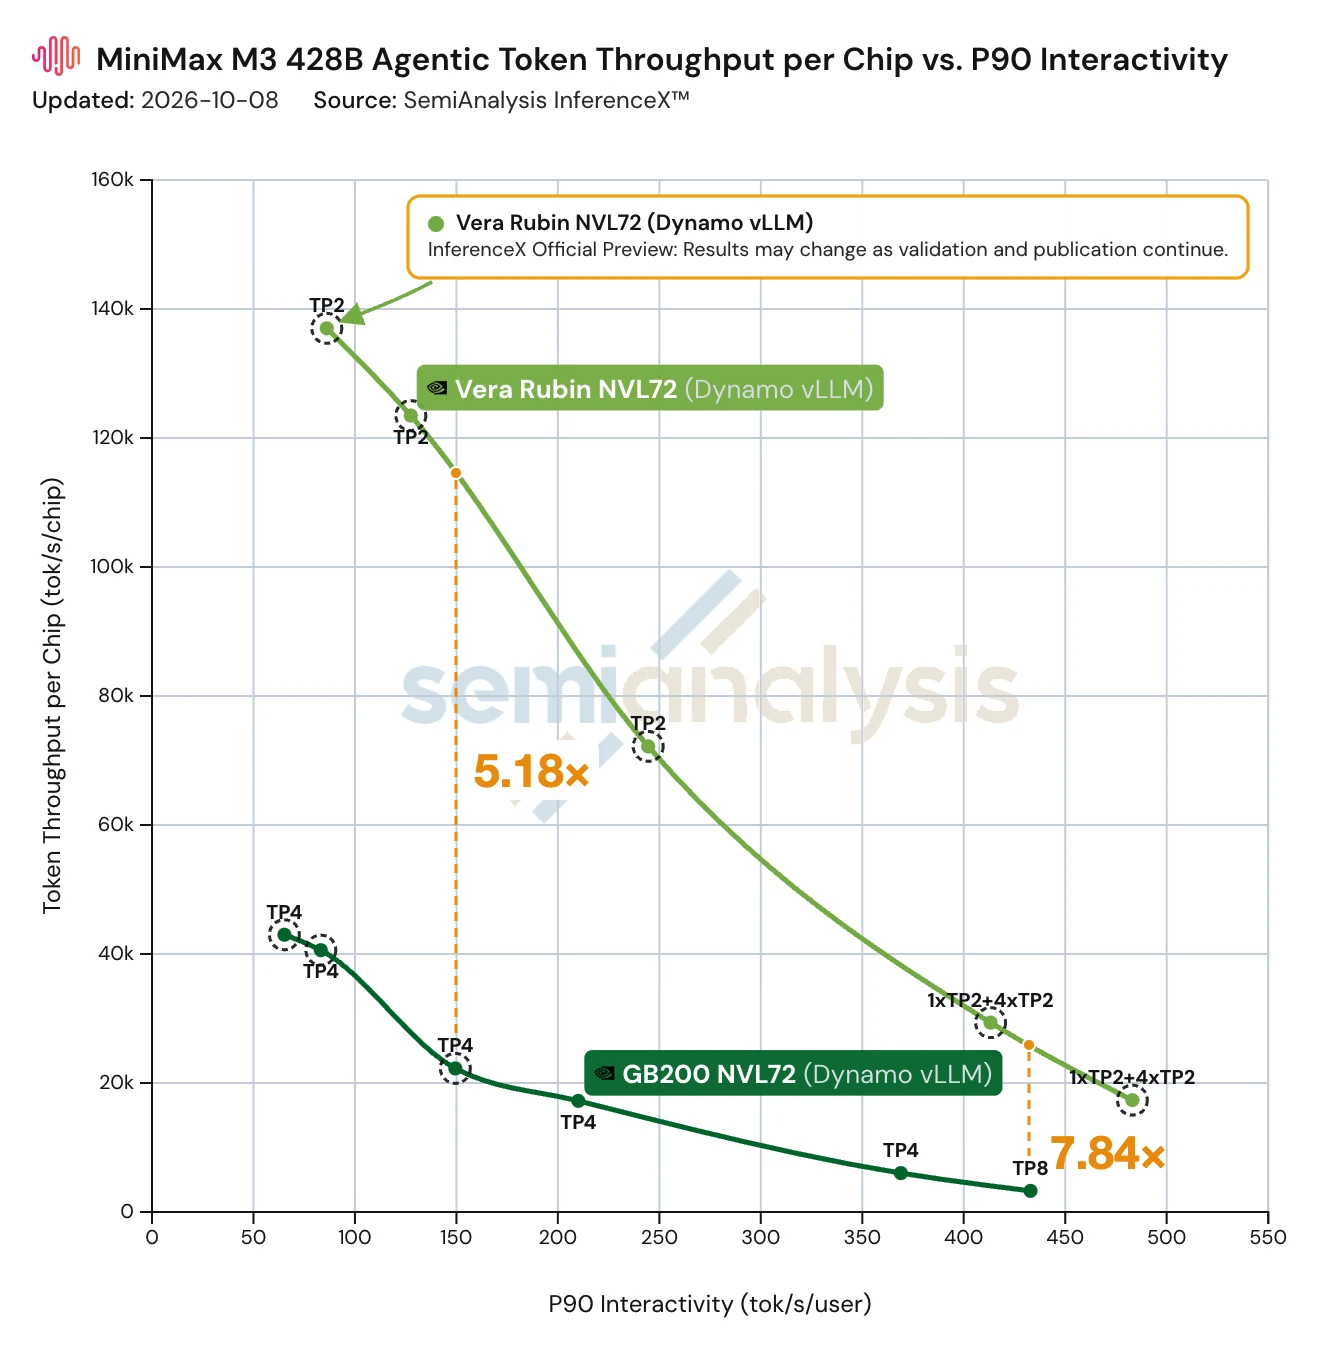
- 早期性能: 早期结果已经显示出 vLLM 的显著提升: 在相同交互性下,AgentX 上每 GPU 吞吐量相比 GB200 NVL72 提升 7.8 倍 ,以及在 MLPerf 中 VLM 吞吐量相比 GB300 NVL72 最高提升 3.7 倍 。这只是开始;随着优化的持续,我们预计会看到更多性能提升。
Rubin 为推理带来了哪些改变
点击展开图 1. NVIDIA Vera Rubin NVL72 与 GB200 NVL72 的每 GPU 对比。将鼠标悬停在某个指标上可高亮其在 GPU 中的对应部分;“显示表格”可列出每个数值。来源:NVIDIA Vera Rubin NVL72 和 GB200 NVL72 规格页面,以及 NVIDIA Rubin 开发者博客。
Vera Rubin 平台
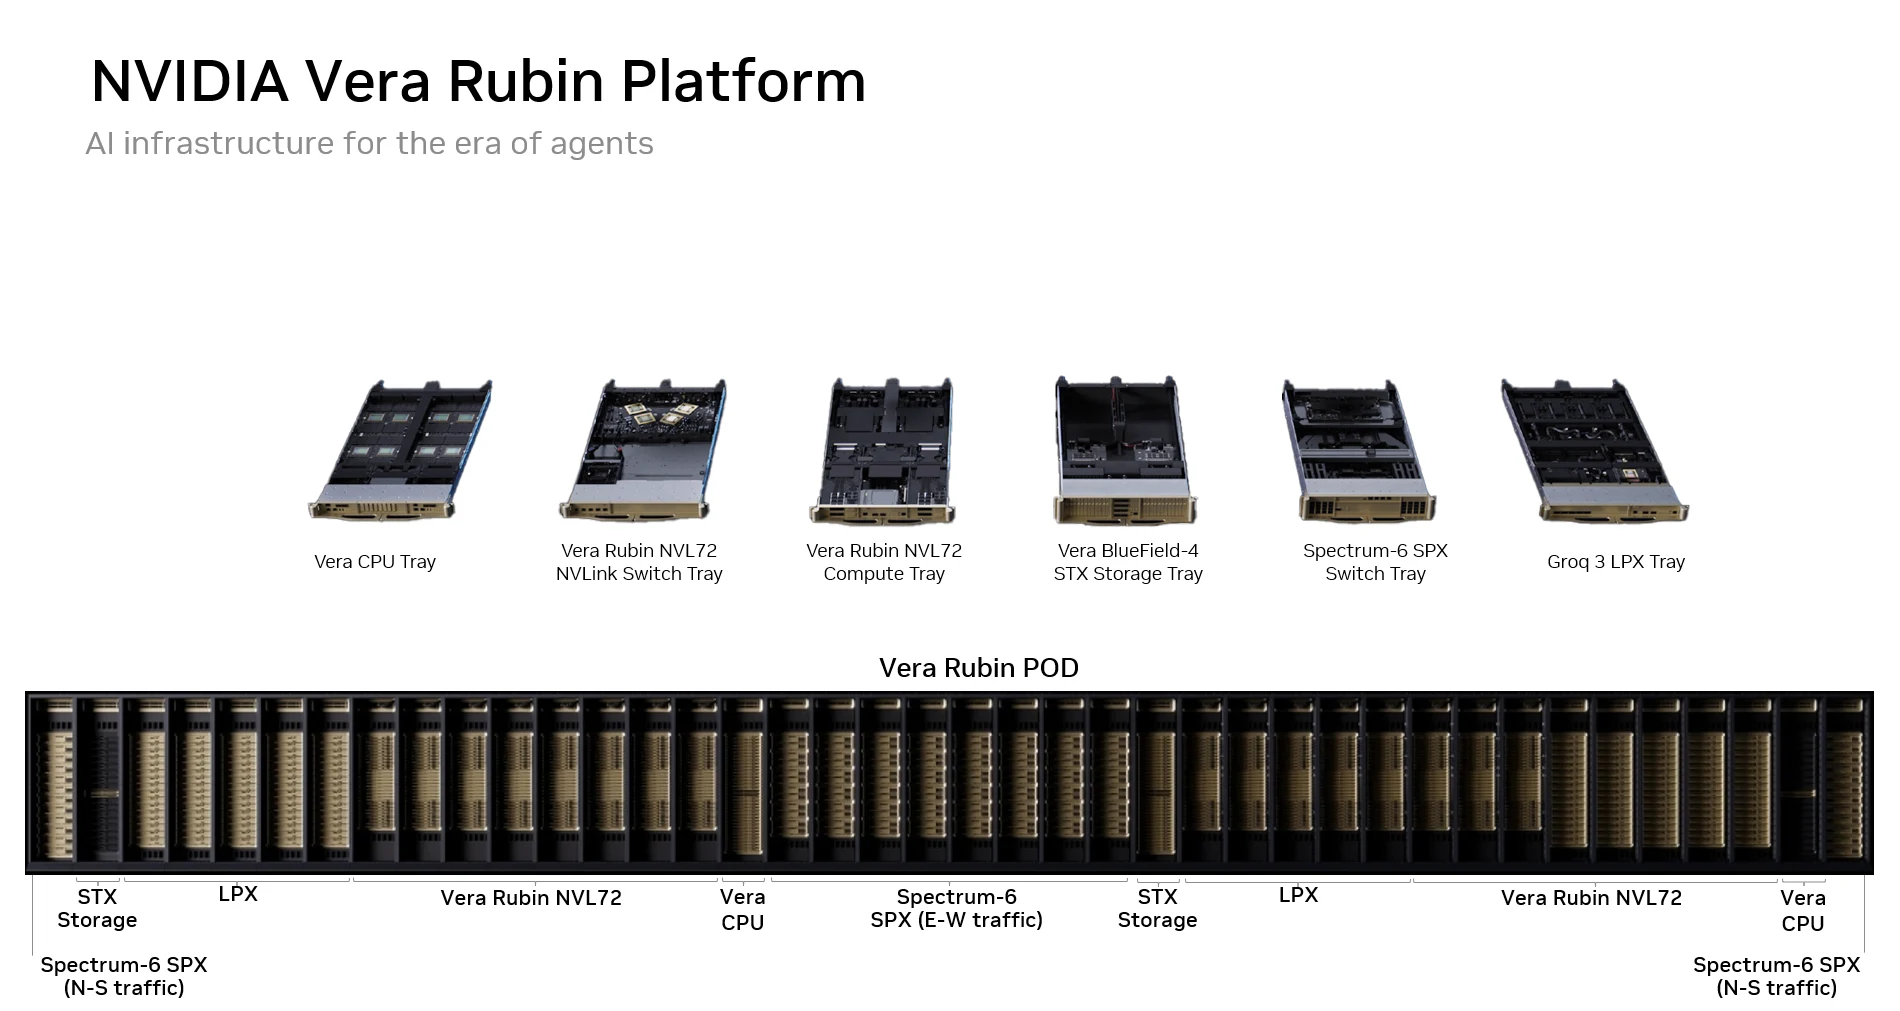
Vera Rubin 平台通过对其机架组件的极致协同设计实现了卓越性能——它配备五个全新的、各具特色的、专为代理式 AI 工作负载打造的机架级系统:Vera Rubin NVL72、Vera CPU 机架、Groq 3 LPX、Spectrum-6 SPX 和 BlueField-4 STX 存储。
单个 Vera Rubin NVL72 提供的 NVFP4 推理 FLOPS 是 GB200 NVL72 的 5 倍,内存带宽提升 2.4 倍。在纵向扩展网络方面,第六代 NVLink 提供高达 Blackwell 的 1.7 倍带宽,在生产环境代理式服务场景中带来显著更好的用户体验。
Softmax。 值得注意的是,Rubin 还提升了 softmax 性能,这是 LLM 注意力机制中的核心操作。相比 NVIDIA GB200,Rubin 将指数运算吞吐量提升了,包括 FP32 提升 2 倍、BF16/FP16 提升 4 倍,帮助 softmax 跟上更快的矩阵运算。
内存。 Rubin 中的 HBM 已从 HBM3e 升级到 HBM4,相比 GB200 NVL72 提供高达 2.4 倍的带宽。结合其更强大的计算能力,Rubin GPU 加速了关键的 LLM 推理操作,如 GEMM、MoE(专家混合)和注意力机制,并提供更高的整体吞吐量和更低的解码延迟(详情见下文).
网络。 Rubin 平台上的 GPU 间网络也得到了极大改进。第六代 NVLink 提供比上一代高 1.7 倍的网络带宽。这将加速集合通信操作(例如 AllReduce 和 All2all)以及其他通信操作,从而提升大规模 LLM 推理的速度和可扩展性(例如 prefill/decode 分离、大范围专家并行)。
vLLM 对 Rubin 的支持现状
在 Rubin 公开发布后,vLLM 社区立即开始了 Rubin 的适配工作。作为 vLLM 社区的重要成员,来自 NVIDIA、Inferact 和 Red Hat 的工程师们通力合作并作出贡献,确保所有用户都能轻松地在 Rubin 平台上部署任意模型。
在本节中,我们重点介绍 vLLM 正在进行的 Rubin 专项支持,即利用本地性域(locality domains),以及我们在 Rubin 硬件上开箱即用方面的易用性改进。
本地性域支持
自 Ampere 以来,NVIDIA GPU 就具有非一致的全局内存访问。NVIDIA CUDA 13.4 中的 locality domain(局部性域)特性 在 NVIDIA CUDA 13.4 中,应用程序可以通过将计算和数据放置在同一局部性域内,来充分利用非一致的全局内存访问。SM 访问其自身局部性域内的全局内存时,比访问其他域中的 HBM 具有更高的带宽和更低的延迟。借助 Green Contexts 和 CUDA streams,我们可以在每个局部性域中各启动一个 kernel,使每个 kernel 都能访问本地内存。该特性主要加速内存受限的工作负载,例如 MoE decode。局部性域目前仍在积极设计和开发中。在本节中,我们以 MoE decode 为例进行深入探讨。
点击展开图 3:两个局部性域上 MoE 前向计算中的 Split-N。权重 W 在 N/2 处按列切分,每个域的 SM 只读取自己 HBM 中的一半 W,因此每个域使用其本地内存带宽。输入 X 和输出 C 跨越两个域。使用 Pause、Prev/Next 或步骤芯片来逐步查看。
MoE decode 受限于从 HBM 读取权重,因此我们的目标是优化跨局部性域的内存吞吐量。作为对 Rubin 新的局部性域特性的初步探索,我们在 FC1 和 FC2 中都采用了 split-N 策略,如图 3 所示。我们按列对权重进行分片,将每个分片放入每个局部性域的全局内存中,并限制每个域的 SM 只访问其本地分片。这消除了大部分跨域内存访问,从而提升 kernel 性能并节省功耗。由于 decode 期间激活内存相对较小,将其在两个内存域之间保持非本地化只会带来极小的开销。
SM 并不总能被划分为相等的域。默认情况下,局部性域的创建在尝试创建等分分区时不会包含那些 SM。为了使两个分区拥有相等的 SM 数量,我们需要在创建域时启用 cudaDevSmResourceGroupBackfill (backfill 模式)(更多细节请参阅官方局部性域文档)。在我们的性能研究中,我们同时包含了默认模式(两个域总共只使用 200 个 SM)和 backfill 模式(使用全部 212 个 SM)。
图 4 比较了不同并行策略下开启与关闭局部性域时的初步 MoE 层前向时间(FC1 + FC2)。我们以 MiniMax M3 MoE 的形状为例。启用局部性域后,在小 token 前向设置中我们能够稳定获得平均 1.2 倍的加速。对于其他 TP 和 EP 服务策略,这一趋势大致保持不变。即使在默认模式下(212 个 SM 中只使用 200 个),启用局部性域也能带来类似的收益。主要原因是,在小 token decode 中,前向计算由权重加载主导,而局部性域能够提供更高的 HBM 吞吐量。这些早期结果只是一个起点,仍有进一步调优和优化的空间,以最大化局部性域在 Rubin 上的性能收益。
点击展开图 4:Rubin 上 MiniMax M3 MoE 层每 rank 的初步 FC1 + FC2 延迟,非本地化 vs 本地化(越低越好),每组柱子上方标注加速比(非本地化延迟 ÷ 本地化延迟)。选项卡切换并行策略(TP2、TP4、EP2、EP4);开关在 backfill 模式(全部 212 个 SM)和默认模式(212 个 SM 中的 200 个)之间切换。均衡路由;不包含通信时间。
Day-0 可用性
易用性始终是 vLLM 的首要任务。从今天起,用户可以从 vLLM 的 Docker Hub 拉取并使用以 CUDA 13.4 和 PyTorch 2.15 构建的 nightly 镜像,即 vllm/vllm-openai:cu134-nightly,用于 Rubin 硬件。
Blackwell 软件栈兼容性。 Rubin 构建在 Blackwell 架构家族之上,并扩展了 tcgen05 张量核心指令。它是一个新的 GPU 编译目标(sm107),但为 Blackwell 家族目标(sm100f)构建的 kernel 也可以在其上运行。在实践中,vLLM 的 Blackwell kernel,尤其是 GEMM 密集型的 kernel,例如 attention 和 MoE,已经无需任何修改即可在 Rubin 上运行。
每日容器构建。 Rubin 的每日容器构建已经可用(#55953),这得益于 #53443 和 #54640 为 CUDA 13.4 上的 Rubin 构建路径,以及 #56545 和 #59288 用于 Rubin 依赖项更新。
模型覆盖。 凭借这些组成部分,vLLM 现在可以在 Rubin 上服务多种模型,包括 DeepSeek、Kimi、GLM 和 MiniMax。
Rubin 调优的 kernel
渐渐地,利用 Rubin 特定硬件能力和特性的内核正在被发布并上游到 FlashInfer、vLLM 的 MSA 分支(等内核库中(vllm-project/MSA),哼唱(vllm-project/humming)、等等。截至今天,vLLM 已集成了若干重要内核以实现最大化的 Rubin 性能,包括 dense NVFP4 或 MXFP4 GEMM、NVFP4 MoE、FP8 attention、FP8 MSA prefill 等等。
性能
我们在Vera Rubin NVL72 GPU上运行两个代表性基准测试来评估vLLM性能:SemiAnalysis AgentX(详见我们的 上一篇),以及 MLPerf Inference v6.1.
在 AgentX 上,vLLM 运行 MiniMax M3 于 Vera Rubin NVL72 上,在匹配交互性的情况下,每块 NVIDIA GB200 的吞吐量最高可达其 7.84 倍;在 150 TPS 约束下,吞吐量高出 5.18 倍。这只是对该平台推理能力的初步窥探。随着我们获得更多 Vera Rubin NVL72 节点的访问权限,我们将扩大测试范围并加速优化,随着相关工作推进,预计性能还将进一步提升。
MLPerf Inference v6.1 这一轮是首次将 vLLM 移植到 NVIDIA Vera Rubin NVL72 平台的测试场。在视觉语言模型(VLM)基准上,通过 vLLM 作为后端推理引擎、Dynamo 作为前端路由来部署 Qwen3-VL-235B-A22B 模型,Vera Rubin NVL72 的吞吐量最高可达 3.7倍 高于 GB300 NVL72,涵盖离线、服务器和交互场景。有关已发布的 MLPerf Inference v6.1 结果的更多细节请见 NVIDIA 的博客文章.
后续步骤
"罗马不是一天建成的",打磨 Vera Rubin NVL72 GPU 的可用性和性能将是一段充满激情的持续旅程。在不久的将来,作为社区共同努力,我们计划为 Rubin GPU 启用更多新功能,包括但不限于:
- 通过 FlashInfer 将 sm107 FlashInfer MegaMoE 集成到 vLLM 中。
- 为 MoE 层完全启用局部性域。
- 通过 PDL 和 Lamport Sync 发现并利用更多不同层或内核之间的重叠机会。
- 探索面向延迟敏感用例的 mega kernel。
- 在 Rubin 上优化用于 Kimi K3 的 KDA 和 MLA 内核。
- 为 DeepSeek-V4.1-Flash 集成 Rubin CSA 和 HCA 内核。
- 完成并集成 Rubin MSA 解码内核。
- 通过 FlashInfer 将 CFT 计数写入 MoE all-to-all 内核集成到 vLLM 中。
致谢
这项工作是 Inferact、NVIDIA、Red Hat 以及更广泛的 vLLM 社区共同努力的成果。我们特别感谢:
- NVIDIA,为我们提供了 Vera Rubin NVL72 的早期访问权限,并在整个开发过程中密切合作。
- Inferact 和 NVIDIA,主导 Rubin 合作、推动性能调优、集成 MSA 内核,并剖析了局部性感知 MoE 的性能。
- NVIDIA 和 Red Hat,为 Rubin 搭建并启用了每日 Docker 构建。
- vLLM 社区,在整个过程中提供的持续支持和贡献。
附录:在 Vera Rubin NVL72 上运行 vLLM
显示 Rubin 的内核配置vLLM 已经为 Rubin 集成了几个高度优化的内核。本节介绍启用这些内核所需的相应配置,以在 Rubin GPU 上实现最大化性能。
- CuTe-DSL dense NVFP4 或 MXFP4 GEMM。对于 NVFP4/MXFP4 模型检查点默认开启,但你可以设置
--linear-backend flashinfer_cutedsl适用于NVFP4或--linear-backend flashinfer_cutlass针对 MXFP4 以确保其已启用。 - CuTe-DSL NVFP4 MoE。你可以通过以下方式开启
--moe-backend flashinfer_cutedsl. - 用于“batched”专家格式的 NVFP4 W4A4 MoE 的 CuTe-DSL masked grouped GEMM。这适用于具有如下形式的部署
--enable-expert-parallel --data-parallel-size N --all2all-backend deepep_low_latency|nixl_ep其中N>1。在这种情况下,--moe-backend auto|flashinfer_cutedsl两者都会解析到这个内核。 - 用于静态 per-tensor FP8 W8A8 线性层的 CuTe-DSL FP8 BMM。默认开启,并且可以被 FlashInfer autotuner 选用。
- Trtllm-gen FP8 attention。要开启,你需要通过以下方式使用 FP8 KV cache
--kv-cache-dtype fp8或使用指定了 FP8 KV cache 的 checkpoint,并设置--attention-backend FLASHINFER|FLASHINFER_MLA。对于 DeepSeek 风格的 MLA prefill,请另外添加-ac.mla_prefill_backend=TRTLLM_RAGGED -ac.use_prefill_query_quantization=true. - CuTe-DSL FP8 MSA prefill。要开启,你需要通过以下方式使用 FP8 KV cache
--kv-cache-dtype fp8或使用指定了 FP8 KV cache 的 checkpoint,并设置--attention-config.minimax_m3_msa_decode_backend=cutlass.