
研究表明,AI代理团队浪费了大量标记,而实际的质量提升却几乎无法衡量
 Matthias Bastian
查看 Matthias Bastian 的 LinkedIn 个人资料
2026年10月11日
研究表明,AI 代理团队的结果几乎与单个代理没有差异。
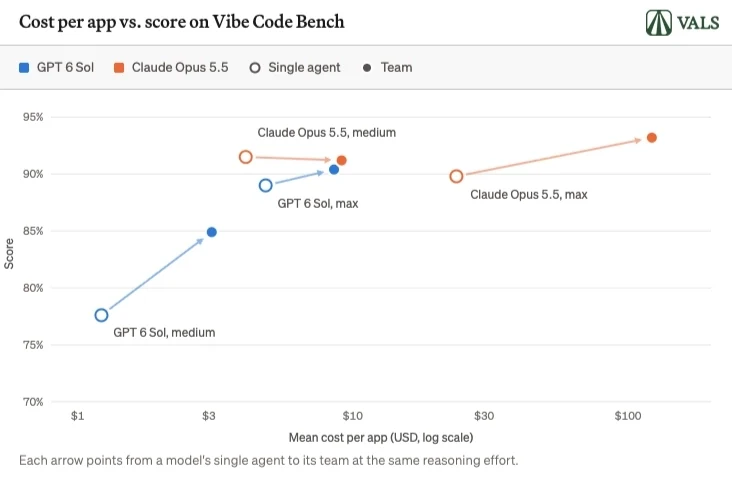
Evals公司Vals AI在“Vibe Code Bench”平台上,对GPT-6 Sol和Claude Opus 5.5进行了测试,测试内容包括单独运行和团队协作两种情况,以及两种推理水平:中等和最高推理强度。这些团队的成本是单个智能体的1.8倍到5.1倍。
在四项比较中,只有一项显示出统计上显著的改进:GPT-6 Sol在中等推理能力方面表现更好,团队得分高出7.3分。在最高推理能力方面,团队设置对 Sol 和 Opus 都没有带来5.5分的实际优势。结果表明,在大多数情况下,代理团队的额外成本并不值得,尤其是当模型已经处于全计算状态时。
| Opus 5.5 任务 | 1 代理 | 10 个代理 | 30 个代理 | 100 个代理 |
|---|---|---|---|---|
| 知识库 | 0.53 | 0.70 | 0.71 | 0.74 |
| 精益定理证明 | 0.39 | 0.66 | 0.66 | 0.68 |
Fable 5.1在超过十个智能体的Lean定理证明任务中获得了更显著的性能提升,但在所有测试中仍低于Opus 5.5。在知识库任务中,当智能体数量从30个增加到100个时,Fable的得分实际上略有下降。
更多代理购买速度,但不会获得更好的输出
OpenAI 研究人员诺姆·布朗在 Dwarkesh Podcast 中证实,多智能体系统主要追求速度,而非更高的质量。4 个智能体可以 twice 更快地完成任务,但成本也相应增加两倍。当智能体数量达到 16 个时,这一趋势依然成立,但效率略有下降。
效果很大程度上取决于任务类型。网络研究和数学工作可以很好地并行处理,但写小说则不行,他说。向小说中投入10,000个智能体,就跟投入10,000个人去处理它一样毫无意义。布朗指出,将智能体数量扩大到非常巨大的规模仍然尚未被充分探索,因为成本实在太高。
OpenAI 开发者 Eric Provencher 最近警告说,正是出于这个原因,不应使用 智能体群。他认为这很可能是浪费钱,因为智能体之间的协调会失效。他将其称为“协调税”。
AI新闻——无炒作,由人类整理
订阅 THE DECODER,即可享受无广告阅读体验、每周人工智能通讯、每年六次的独家“AI Radar”前沿报告、完整的存档权限,以及评论区访问权。
继续阅读以了解完整情况。
订阅以获得无炒作的报道。
- 完全访问 THE DECODER 上的所有文章
- 无广告
- 参与评论和社区讨论
- 每周通过邮件发送的人工智能新闻汇总
- 每年 6 次: “AI Radar” —— 深入探讨最重要的 AI 主题
- 每日人工智能新闻,随时更新
- 我们的完整十年档案
- 由拥有10年以上AI经验的团队负责