
要点
- 构建长期运行的智能体需要持续的上下文管理,而使用前沿大语言模型来做出这些决策既缓慢又昂贵。ScaleDown 的受限解码模型(CDM)使其变得更快、更便宜。
langchain-scaledown使其可以轻松地在你的 agent 中使用 ScaleDown 模型,并附带用于摘要、工具结果压缩和提取的中间件。- ScaleDown 现已在 LangSmith LLM Gateway 中受支持,因此其调用会被追踪,并计入您的消费额度和速率限制。
构建长时间运行的智能体归结为上下文管理的艺术:决定哪些信息进入上下文窗口,以及何时进入。这意味着要总结旧的历史记录、压缩大型工具结果,并从长输入中提取正确的数据。每一步都是一个决策。过去我们是用 LLM 来做这些决策的,但按照长时间运行智能体所需的规模,这样做既缓慢又昂贵。
为了让这些决策更快、更便宜,我们现在有一个 langchain-scaledown 集成与 LangSmith LLM 网关中的支持 为 ScaleDown的受限解码模型(CDM)。通用大语言模型逐个token生成任意字符串,而CDM只为单一任务训练,并且只返回该任务允许的答案,比如你列表中的标签或输入文本的片段。这使得它更小、更快、更便宜:ScaleDown报告称,在这些狭窄任务上,其模型比前沿模型快200倍、便宜467倍。
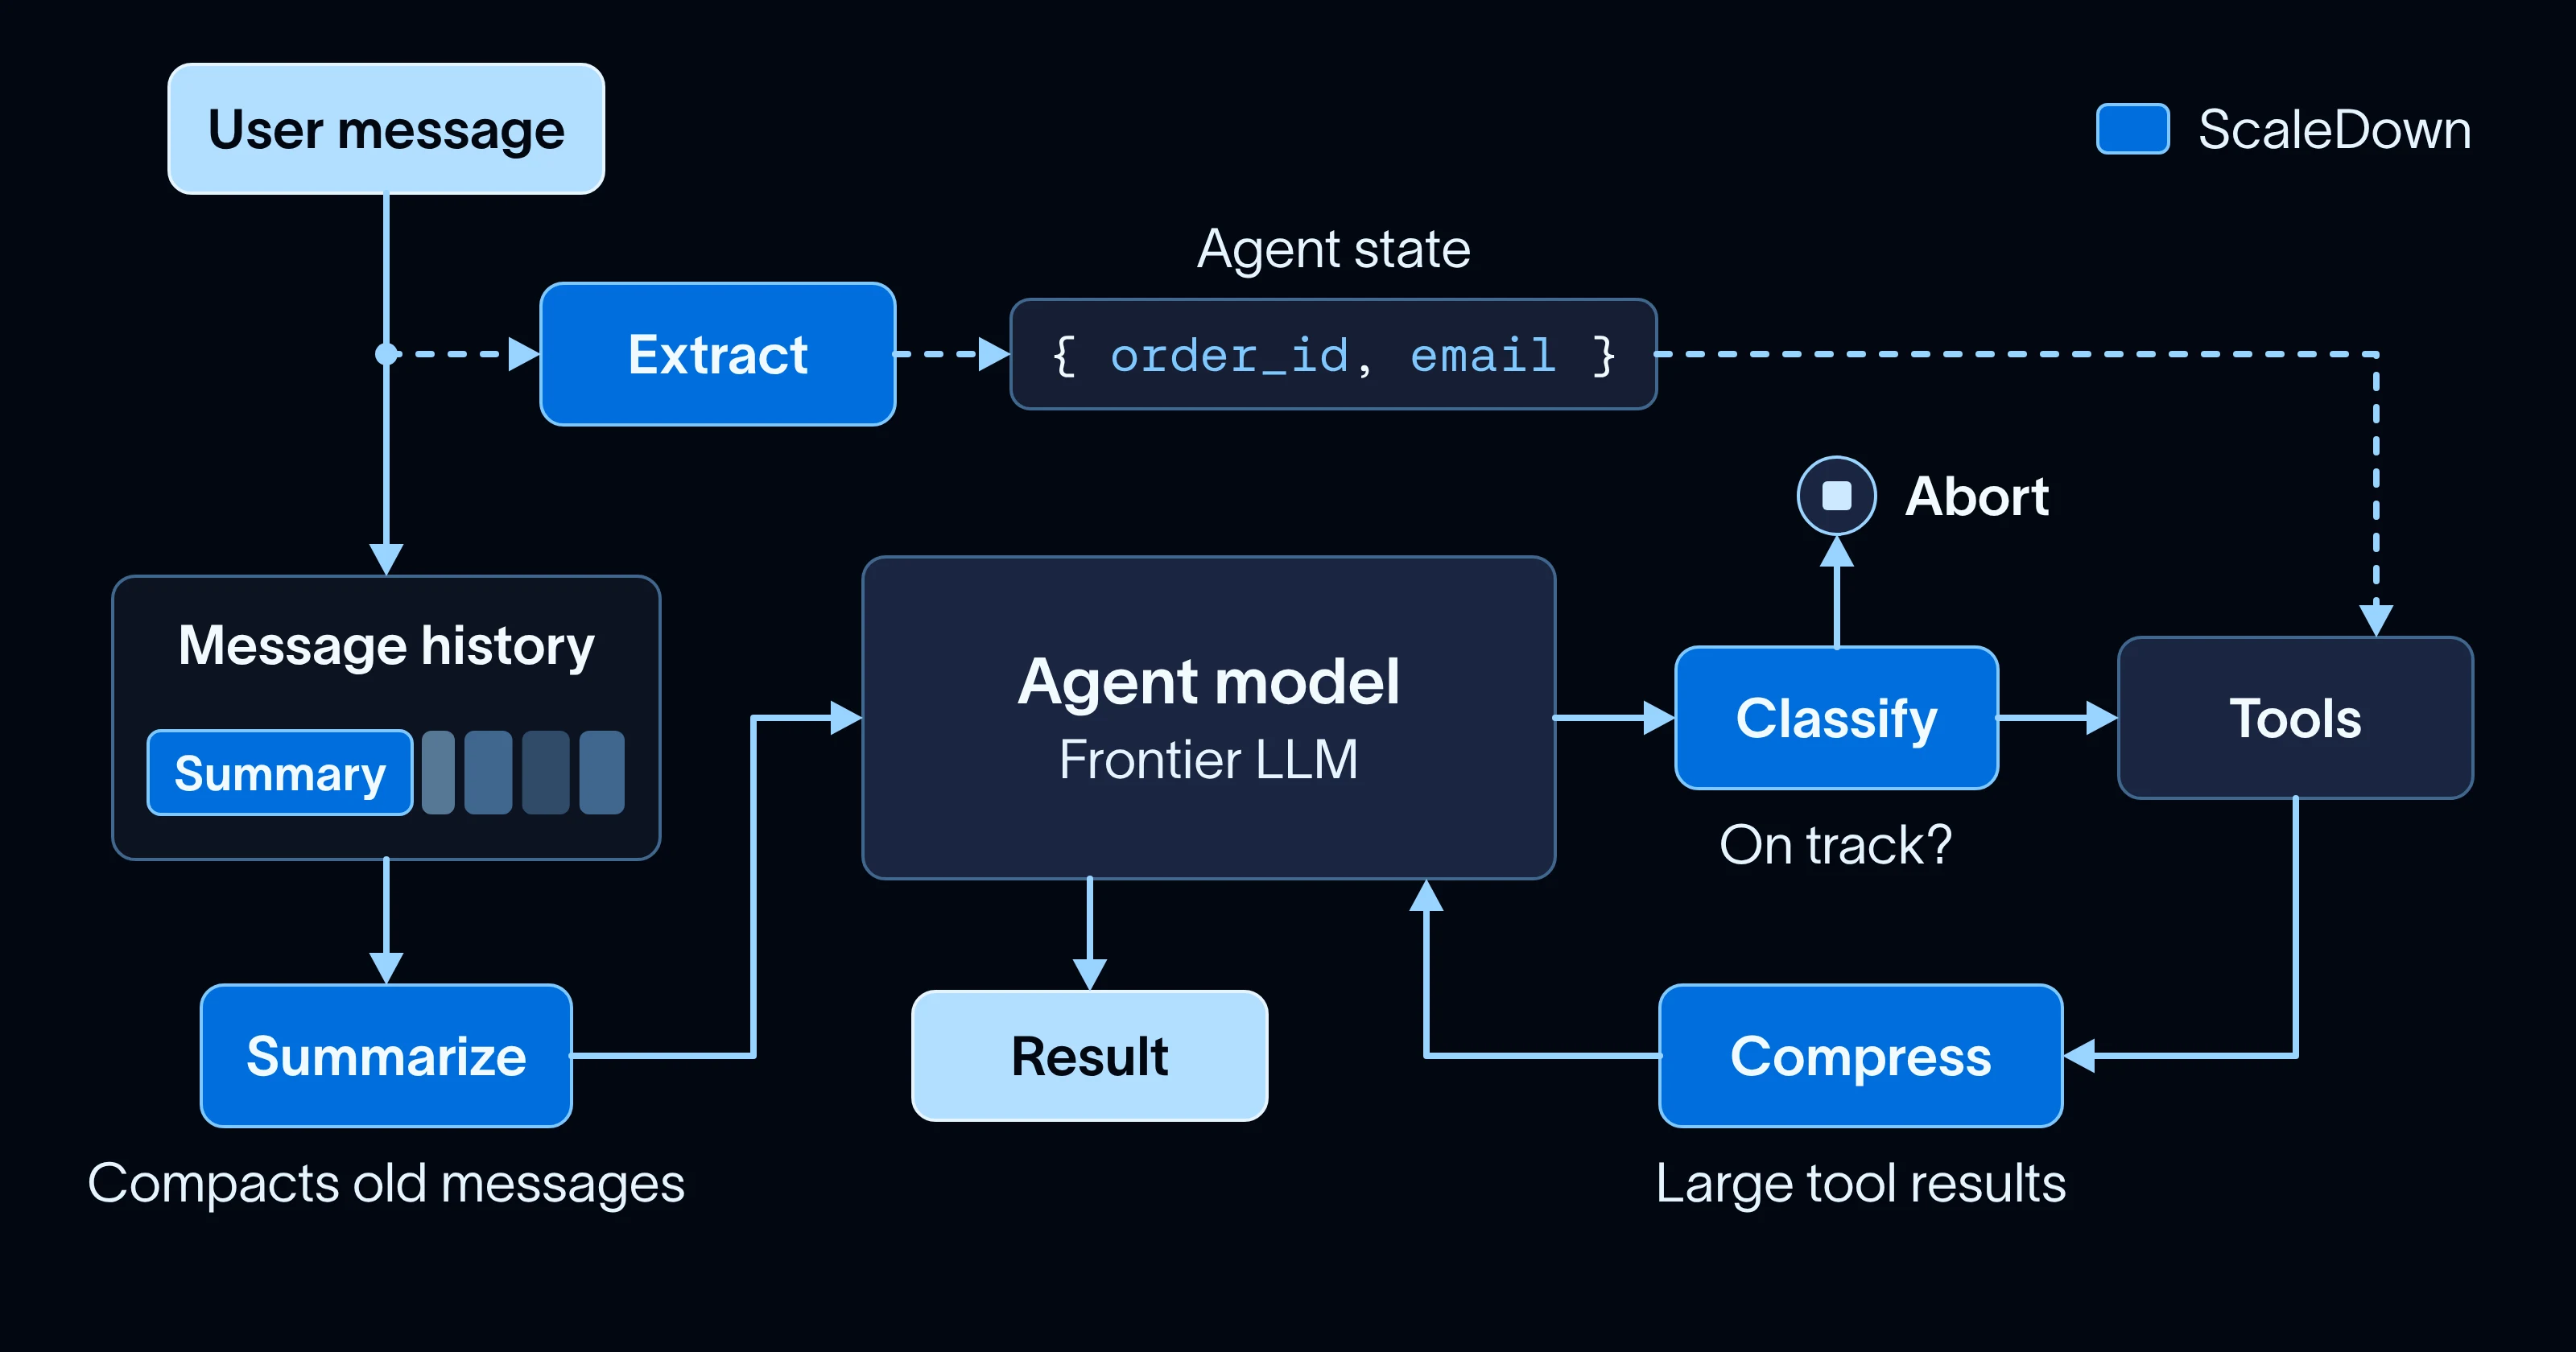
该集成自带三个 中间件 适用于 LangChain 和 Deep Agents:一个用于总结旧历史记录,一个用于压缩大型工具结果,还有一个用于从对话中提取结构化数据。在本文中,我们将介绍 ScaleDown 的模型是什么,以及如何使用它们来 缩减 你的代理的上下文。
ScaleDown 提供哪些模型?
ScaleDown 有四个模型,每个模型都针对单一任务进行训练,因此每个模型都比通用 LLM 高效得多:
- Summarize 为长文本撰写简短摘要。
- Compress 将一段上下文裁剪为与问题相关的部分。
- Extract 从文本中提取你所描述的字段,每个字段都带有置信度分数及其在源文本中的位置。
- Classify 将文本与你定义的标签进行比对打分,并为每个标签返回一个概率。你可以选择是否返回做出该分类的自然语言原因。
每个模型最多可接受 1M tokens 的输入,因此一份完整合同、一个长政策页面或一小时的智能体历史记录都能在一次调用中容纳,无需分块。它们还是 多模态的:Extract、Summarize 和 Classify 除了非结构化文本外,还能直接接收图像和扫描的 PDF,因此截图或扫描的发票都可以作为输入。
在 ScaleDown 自己的基准测试中,与 GPT-5.5、GPT-5.4 Mini 和 GPT-5.4 Nano 的平均水平相比,在 公开数据集上测量,Summarize 便宜 41 倍、快 2.7 倍,Compress 便宜 138 倍、快 1.8 倍,同时两者在准确率上得分更高。
如果你用过像 Jev这样的决策模型,ScaleDown Classify 会让你感到熟悉:两者都返回带概率的类型化答案。Jev 每个问题仅接受 纯文本,最多 32K tokens 的状态。Classify 最多接受 1M tokens,包括图像,并且 为每个决策添加一句话的原因 。当智能体根据标签路由工单或停止运行时,这个原因能告诉你为什么,使智能体更易于调试。
摘要化 消息历史
长时间运行的智能体需要摘要,因为它们的历史最终会超出上下文窗口。一个已经运行了一小时的编码智能体,其历史中包含数十次文件读取和工具输出,其中大部分已不再需要逐字保留。每当历史填满时,用另一个前沿模型调用来摘要它们都会增加成本和延迟。
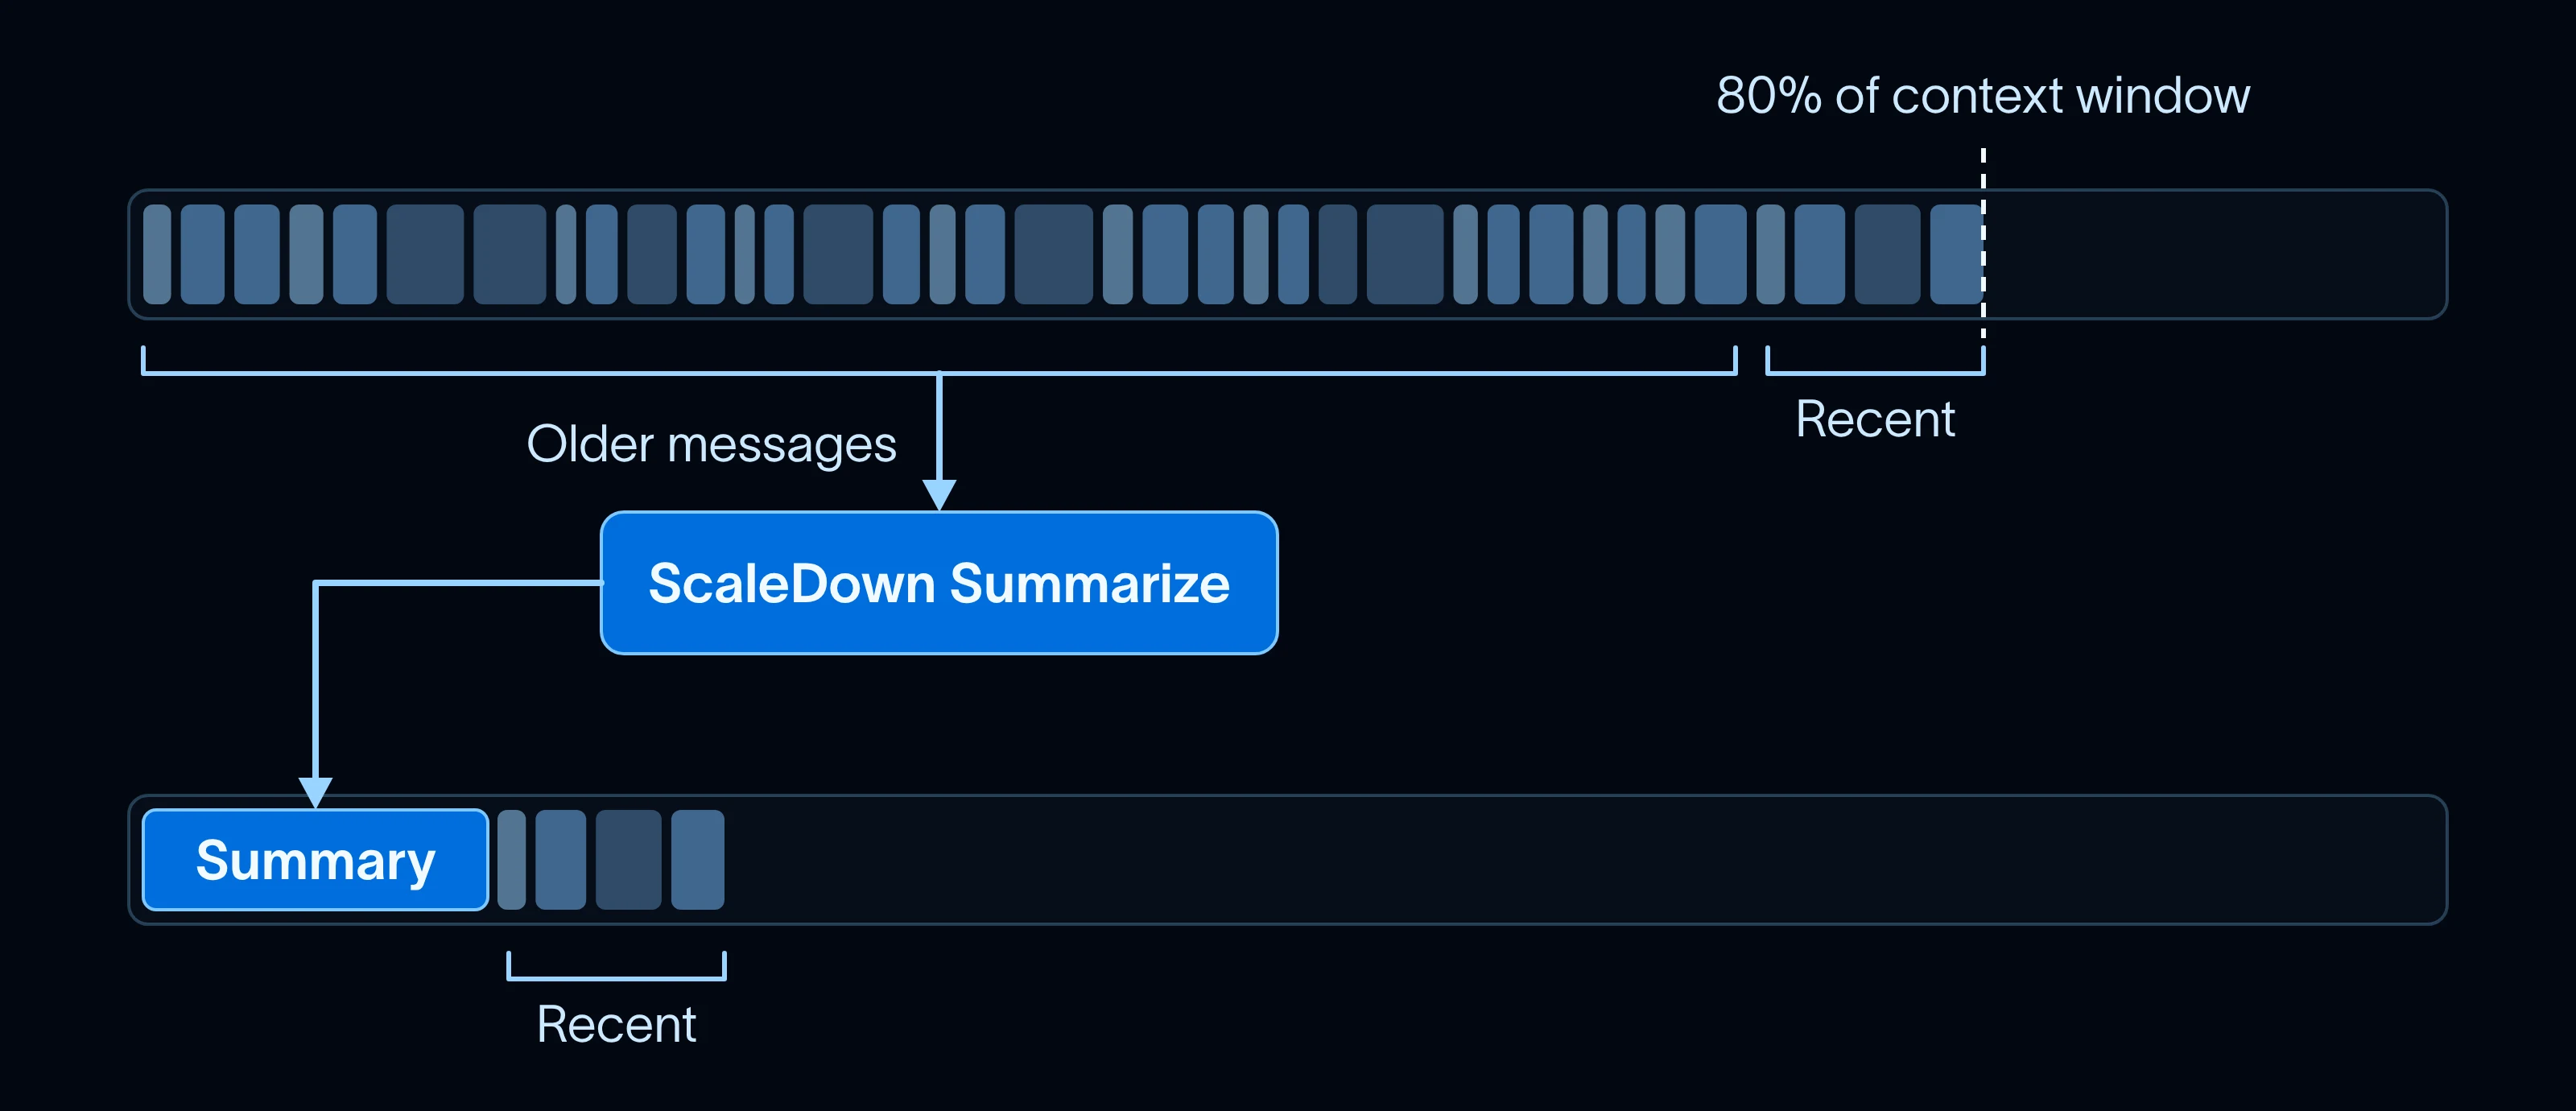
ScaledownSummarizationMiddleware 替换了 Deep Agents 内置的 摘要中间件。它使用相同的 trigger 和 keep 选项来决定何时进行摘要以及保留哪些近期消息,而摘要由 ScaleDown 来编写:
from deepagents import create_deep_agent
from langchain_scaledown import ScaledownSummarizationMiddleware

agent = create_deep_agent(
    model="openai:gpt-6-sol",
    tools=[run_tests],
    middleware=[
        ScaledownSummarizationMiddleware(
            "openai:gpt-6-sol",  # the agent’s model, used for its context window
            trigger=("fraction", 0.8),
            keep=("fraction", 0.1),
        ),
    ],
)
Agent 保留自己的模型用于规划和编写代码。只有摘要转移到 ScaleDown,它默认返回与 LangChain 摘要提示词相同的部分(意图、摘要、产物和下一步)。如果 ScaleDown 调用失败,中间件会保持历史记录不变,agent 继续运行。同一中间件也适用于 LangChain 的 create_agent.
压缩 工具结果
长时间运行的 agent 会调用大量工具,而每个较大的结果都会在剩余运行期间一直保留在上下文中。一个抓取的网页可能长达数万字符,而 agent 只需要其中一段。后续每一步都要再次为这些 token 付费,并且随着其 上下文 被填满,agent 在保持任务专注方面会变得更差。
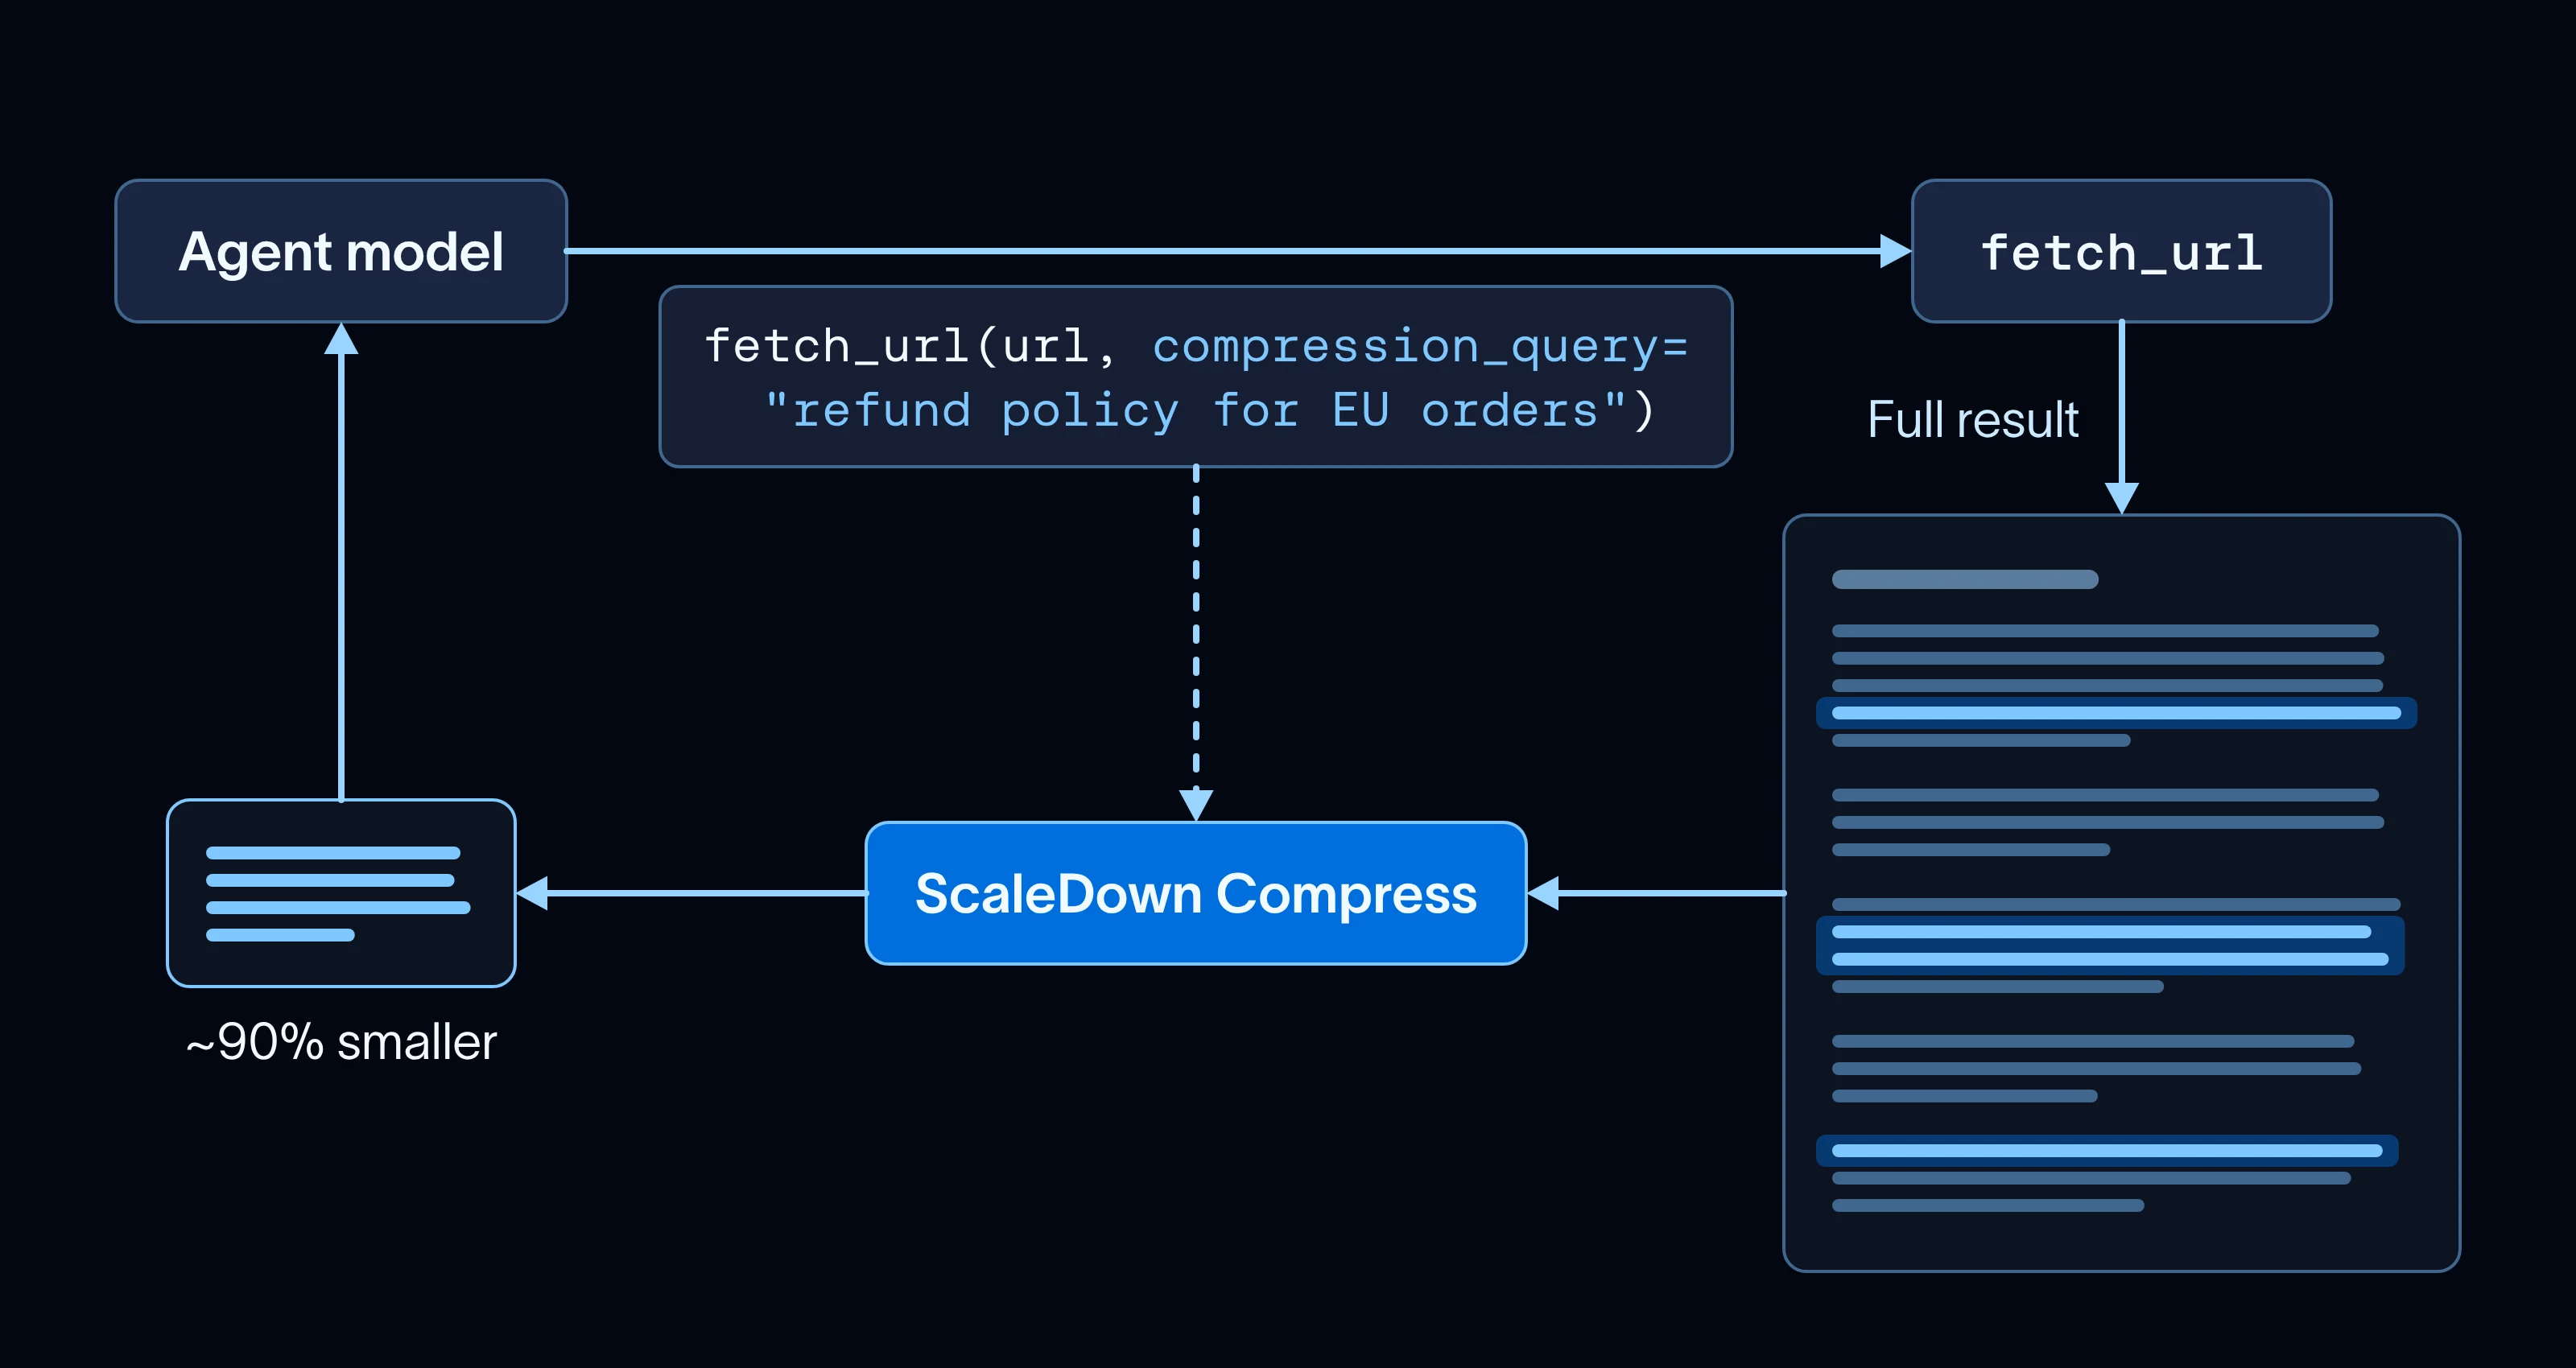
ScaledownToolCompressionMiddleware 为你的工具添加一个可选的 compression_query 参数。当模型只需要结果的一部分时,它会在工具调用中填入 compression_query ,例如 "refund policy for EU orders"。中间件会在工具运行前将其剥离,然后 ScaleDown 会在模型看到之前把输出压缩到相关部分:
from deepagents import create_deep_agent
from langchain_scaledown import ScaledownToolCompressionMiddleware

agent = create_deep_agent(
    model="openai:gpt-6-luna",
    tools=[search_docs, fetch_url],
    middleware=[ScaledownToolCompressionMiddleware(tools=["fetch_url"])],
)
你的工具不需要改变,因此这适用于任何工具,包括 MCP 工具。在 这次追踪中,ScaleDown 在模型看到之前把一个很长的文档页面裁剪了将近 90%。压缩后的结果以类似下面这样的说明开头,因此模型在需要完整页面时可以不带 compression_query 再次调用该工具:
[Compressed by ScaleDown for "refund policy for EU orders":
 18,402 -> 3,110 chars.
 Call this tool again without `compression_query` for the full output.]
提取 结构化数据
Agent 需要不断地从所读取的内容中提取特定值,例如一个 ID、一个日期,或下一次工具调用所需的某个字段。这种提取位于 agent 循环内部,因此必须足够快以免给每一轮增加延迟,并且必须足够精确以便工具能够直接使用该值。
例如,在一个支持 agent 提交工单之前,它需要订单号、错误消息和客户的电子邮箱。主模型可以将这些填入工具参数,但它可能会转述错误代码,或敲错电子邮箱地址,而不是原样复制。
ScaledownExtractionMiddleware 把这一步交给 ScaleDown。你用自然语言描述每个字段,Extract 会从文本中复制该值。字段也可以是一组标签,ScaleDown 会用 Classify 来回答,这样工单就可以按问题类型进行路由。在一次运行的第一次模型调用之前,中间件会把用户的消息发送给 Extract,并将字段保存到 agent 状态中的 scaledown_extraction下,你的工具可以在那里读取它们:
from deepagents import create_deep_agent
from langchain.tools import ToolRuntime, tool
from langchain_scaledown import ScaledownExtractionMiddleware

ticket = ScaledownExtractionMiddleware(
    entities={
        "order_id": "Order number the customer mentions",
        "error_message": "Exact error message or code the customer saw",
        "customer_email": "Customer's email address",
        "issue_type": {
            "labels": [
                {"name": "billing", "rubric": "Is this about a charge, refund, or payment?"},
                {"name": "technical", "rubric": "Is this about a bug or something not working?"},
                {"name": "account", "rubric": "Is this about login, password, or account settings?"},
            ]
        },
    },
    context_chars=0,  # skip evidence snippets to keep state small
)


@tool
def file_ticket(runtime: ToolRuntime) -> str:
    """File a support ticket with the details gathered so far."""
    fields = runtime.state.get("scaledown_extraction", {}).get("fields", {})
    return crm.create_ticket(**fields)  # your ticketing system


agent = create_deep_agent(model="openai:gpt-6-sol", tools=[file_ticket], middleware=[ticket])
Extract 只读取用户的消息,从不读取 agent 的回复,因此每个值都是客户实际说过的话。With a checkpointer,提取操作每轮都会重新运行,因此随着客户补充细节,记录会逐步填充。对于 “订单 A-1042 支付失败,错误代码为 ERR_PAYMENT_DECLINED。我已经试过另一张卡了。”,各字段返回结果为:
{
    "order_id": "A-1042",
    "error_message": "ERR_PAYMENT_DECLINED",
    "customer_email": None,  # not mentioned yet
    "issue_type": "billing",
}
分类 漂移
智能体根据其当前状态决定下一步操作,例如任务是否已完成或上一次工具调用是否成功。对这种状态的分类每一轮都会进行,因此它必须廉价且快速。
在长时间运行的智能体中,一种值得捕获的状态是漂移:在同一个失败的工具调用上循环,或陷入无效的循环。对此没有预构建的中间件,但你可以在自己的 自定义中间件中调用任何 ScaleDown 模型。下面是一个断路器,它在每次模型调用后运行,将历史记录发送给 ScaleDown Classify,并在运行偏离轨道时停止运行:
import os

import requests
from deepagents import create_deep_agent
from langchain.agents.middleware import after_model
from langchain_core.messages import AIMessage, get_buffer_string

LABELS = [
    {"name": "progressing", "rubric": "Is the agent making new progress on the user's task?"},
    {"name": "looping", "rubric": "Is the agent repeating the same steps without new results?"},
    {"name": "drifting", "rubric": "Is the agent working on something the user did not ask for?"},
]


@after_model(can_jump_to=["end"])
def circuit_breaker(state, runtime):
    result = requests.post(
        "https://api.scaledown.xyz/classify",
        headers={"x-api-key": os.environ["SCALEDOWN_API_KEY"]},
        json={"text": get_buffer_string(state["messages"]), "labels": LABELS},
    ).json()

    label = result["top_label"]
    if label != "progressing" and result["scores"][label] > 0.8:
        return {"jump_to": "end", "messages": [AIMessage(f"Stopped: {result['reasoning']}")]}
    return None


agent = create_deep_agent(model="openai:gpt-6-sol", tools=[run_tests], middleware=[circuit_breaker])
Classify 会为每个标签返回一个概率,因此你可以选择断路器触发前所需的确信度。它的一行原因说明会显示在最终消息中,因此你可以看到运行停止的原因。一种更温和的版本不会在首次触发时结束运行:它将原因添加到对话中作为改变方向的提示,只有当智能体再次漂移时才停止。
这四个部分展示了 ScaleDown 模型适用的一些场景,而且这个列表并不详尽。你可以组合使用它们,例如对长的工具结果运行 extract / summarize,或使用分类进行运行时模型路由。请查看 ScaleDown Cookbooks 了解在不同类型的数据上使用 CDMs 模型的其他方式。
LangSmith LLM 网关中的 ScaleDown
该 LangSmith LLM 网关 让您只需一个 LangSmith API 密钥即可调用多家供应商的模型,追踪每一次调用,并强制执行您的 支出 和 速率限制. ScaleDown 现在是其 直接模型访问提供商, 在 /scaledown 路径。
管理员将您的 ScaleDown 密钥添加到工作区的 提供商机密 作为 SCALEDOWN_API_KEY 一次。然后指向 langchain-scaledown 该网关并使用你的 LangSmith 密钥进行身份验证:
export SCALEDOWN_BASE_URL="https://gateway.smith.langchain.com/scaledown"
export SCALEDOWN_API_KEY="$LANGSMITH_API_KEY"
每次 ScaleDown 调用随后都会显示为一条 LangSmith 跟踪记录 并计入与你其他模型调用相同的限额。
何时不使用 ScaleDown
对于开放式生成任务(如编写代码、起草回复和规划),请保留一个通用 LLM。这遵循了我们 Jev 文章中的“默认用廉价模型,例外用前沿模型”方法:将大型通用 LLM 用于困难部分,而将其周围的高吞吐量步骤交给专用模型。
ScaleDown 足够快速且廉价,可以在每一轮都运行,因此你的代理可以做出上下文管理所依赖的结构化决策,而不会拖慢主循环,也不必为这些决策支付前沿模型的价格。在一个长期运行的代理中,这些决策几乎在每一轮都会发生,因此节省的成本会迅速累积。
开始使用
安装该集成 并 设置你的 ScaleDown API 密钥:
uv pip install -U langchain-scaledown
export SCALEDOWN_API_KEY="..."
新 ScaleDown 账户可获得 50M 免费令牌。 ScaleDown 集成文档 涵盖了每个中间件的配置选项。试用一下 langchain-scaledown ,并在以下平台告诉我们你的想法: LangChain 论坛, X,或 GitHub.