
LFM2.5-24B-A2B 是一款 24B 参数的推理模型,激活参数仅 2B,专为在设备上运行的快速、私密智能体而构建。它在回答前先思考、调用工具,并在流行的智能体框架内完成多步骤任务。由于每个 token 仅激活 2B 参数,每个推理 token 的成本都很低,因此你可以在自己的硬件上持续运行智能体。
- 同类最佳的智能体表现: 与 Qwen3.6-35B-A3B(总参数和激活参数多约 50% 的模型)在智能体和工具使用任务上具有竞争力,在 LiveClaw 上得分为 48.09,而后者为 38.19。
- 以 MoE 速度进行推理: 总是先思考再回答。每个 token 仅 2B 激活参数,每个推理 token 的成本都很低。
- 高效推理: 在 Apple M5 Max 上达到 184 tok/s,在单块 NVIDIA B300 GPU 上最高达到 21K 输出 tok/s。

我们如何构建具有 2B 激活参数的推理智能体
LFM2.5-24B-A2B 基于 LFM2-24B-A2B 构建,并保留其架构:40 层,每个 MoE 块 64 个专家并采用 top-4 路由,以及相同的门控短卷积与 GQA 混合结构。上下文窗口从 32K 增长到 131K token,并通过 原地分词器扩展 将词表从 65K 翻倍至 128K token,以改善非拉丁文字的 tokenization。与其前身不同,它是一个仅推理模型,在给出最终答案前会生成显式的思维链。
预训练规模从约 17T token 扩大到约 33T token。随后中期训练在 32K 上下文中加入 2T token,权重偏向推理、数学、代码、指令遵循和多语言文本;并在 131K 上下文中加入 300B token,权重偏向长上下文数据。工具调用和多轮轨迹贯穿这两个阶段。后训练通过五个阶段将基础模型变成智能体:
- 监督微调(SFT)
- 教师专门化
- 多域在策略蒸馏(MOPD),非智能体: 在非智能体任务上蒸馏专门化教师。
- MOPD,智能体: 第二阶段蒸馏,专注于智能体任务。
- 智能体强化学习(Agentic RL): 在智能体框架内训练模型,例如 OpenClaw, Hermes Agent, Pi以及 OpenCode.
基准测试结果
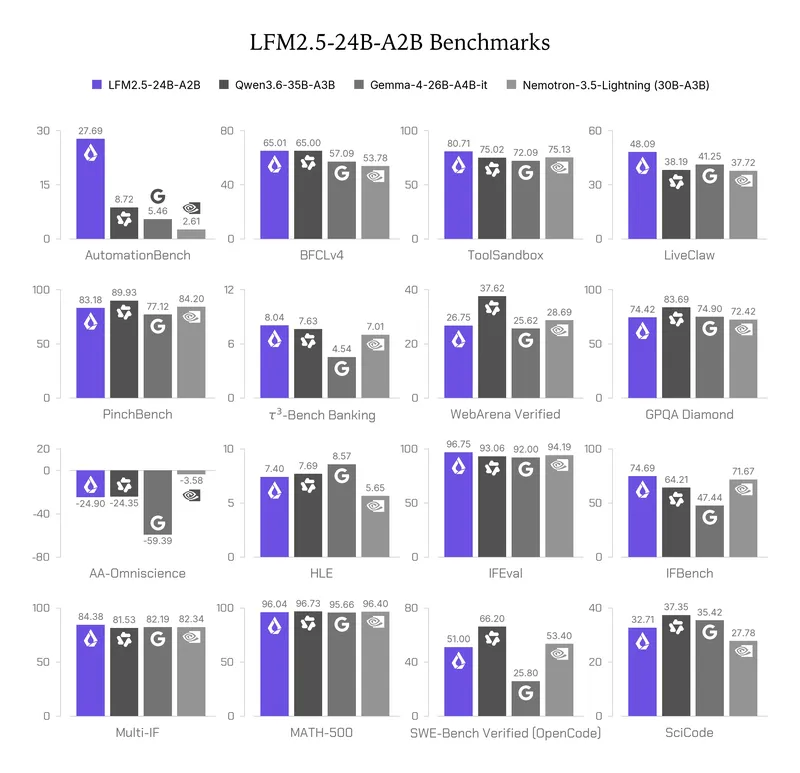
我们在 16 个基准上对 LFM2.5-24B-A2B 与 Qwen3.6-35B-A3B、Gemma-4-26B-A4B-it 和 Nemotron-3.5-Lightning 进行了评估,涵盖工具使用与智能体工作流、知识、指令遵循、数学和编程。它是该组中最小的模型,却与总参数和激活参数多约 50% 的 MoE 模型不相上下。
| 基准测试 | LFM2.5-24B-A2B | Qwen3.6-35B-A3B | Gemma-4-26B-A4B-it | Nemotron-3.5-Lightning (30B-A3B) |
|---|---|---|---|---|
| AutomationBench | 27.69 | 8.72 | 5.46 | 2.61 |
| BFCLv4 | 65.01 | 65.00 | 57.09 | 53.78 |
| ToolSandbox | 80.71 | 75.02 | 72.09 | 75.13 |
| LiveClaw | 48.09 | 38.19 | 41.25 | 37.72 |
| PinchBench | 83.18 | 89.93 | 77.12 | 84.20 |
| τ³-Bench Banking | 8.04 | 7.63 | 4.54 | 7.01 |
| WebArena Verified | 26.75 | 37.62 | 25.62 | 28.69 |
| GPQA Diamond | 74.42 | 83.69 | 74.90 | 72.42 |
| AA-Omniscience | -24.90 | -24.35 | -59.39 | -3.58 |
| HLE | 7.40 | 7.69 | 8.57 | 5.65 |
| IFEval | 96.75 | 93.06 | 92.00 | 94.19 |
| IFBench | 74.69 | 64.21 | 47.44 | 71.67 |
| Multi-IF | 84.38 | 81.53 | 82.19 | 82.34 |
| MATH-500 | 96.04 | 96.73 | 95.66 | 96.40 |
| SWE-Bench Verified (OpenCode) | 51.00 | 66.20 | 25.80 | 53.40 |
| SciCode | 32.71 | 37.35 | 35.42 | 27.78 |
*所有模型均通过 vLLM 进行评估,并采用每个基准测试推荐的生成参数。
对于您的应用来说,模型的优势在于工具使用和指令遵循。LFM2.5-24B-A2B 在八项工具使用和智能体基准测试中的五项(AutomationBench、BFCLv4、ToolSandbox、LiveClaw 和 τ³-Bench Banking)上领先或持平竞争对手,并且在 AutomationBench 上的得分是次优模型的三倍以上。它还在全部三项指令遵循基准测试中领先。更大的模型在 GPQA Diamond、HLE 和 AA-Omniscience 等知识密集型基准测试以及 SWE-Bench Verified (OpenCode) 和 SciCode 等编码基准测试上仍保持优势,因此对于知识密集型工作负载,请将 LFM2.5-24B-A2B 与检索或网络搜索配合使用。
这些结果使 LFM2.5-24B-A2B 成为需要推理、调用工具并在您的设备上可靠运行的智能体的强大基础。
CPU 和 GPU 上的推理速度
LFM2.5-24B-A2B 从发布首日起就获得整个推理生态系统的支持,包括 llama.cpp、MLX、vLLM、SGLang 和 ONNX。
边缘推理。 LFM2.5-24B-A2B 是所对比的 MoE 模型中最快的,在 M5 Max 上解码速度为 184 tokens/s,在 Ryzen AI Max+ 395 上为 114 tokens/s。这比次优模型最高快 1.7 倍,同时占用的内存最少。

GPU 推理。 LFM2.5-24B-A2B 是其尺寸级别中最快的模型,在单块 B300 上高并发时可达到每秒超过 21K 个输出 token。

如何使用 LFM2.5-24B-A2B
当您需要能够推理、调用工具并在您的设备上可靠运行的智能体时,请选择 LFM2.5-24B-A2B。
安装最新版本的 transformers (兼容 transformers>=5.0.0):
pip install -U transformers
然后加载并运行模型:
from transformers import AutoModelForCausalLM, AutoTokenizer, TextStreamer

model_id = "LiquidAI/LFM2.5-24B-A2B"
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    dtype="bfloat16",
#   attn_implementation="flash_attention_2" <- uncomment on compatible GPU
)
tokenizer = AutoTokenizer.from_pretrained(model_id)
streamer = TextStreamer(tokenizer, skip_prompt=True, skip_special_tokens=True)

prompt = "What is C. elegans?"

input_ids = tokenizer.apply_chat_template(
    [{"role": "user", "content": prompt}],
    add_generation_prompt=True,
    return_tensors="pt",
    tokenize=True,
)["input_ids"].to(model.device)

output = model.generate(
    input_ids,
    do_sample=True,
    temperature=0.1,
    top_k=50,
    repetition_penalty=1.05,
    max_new_tokens=512,
    streamer=streamer,
)
在您的智能体框架中使用它
通过任何 OpenAI 兼容的后端在本地部署 LFM2.5-24B-A2B,然后将您的智能体框架指向它。例如,使用 Hermes Agent:
hermes config set model.provider custom
hermes config set model.base_url http://localhost:8080/v1
hermes config set model.default LFM2.5-24B-A2B
hermes config set model.context_length 131072
hermes config set model.api_mode chat_completions
hermes config set agent.tool_use_enforcement true
端口取决于您的部署后端:llama.cpp 和 MLX 使用 8080,vLLM 使用 8000,SGLang 使用 30000,LM Studio 使用 1234。请查看 模型卡 了解 OpenClaw 和 Pi 配置,并参阅 我们的指南 了解完整设置。欢迎查看我们的 发布博客 观看视频示例。
开始使用 LFM2.5-24B-A2B
LFM2.5-24B-A2B 和 LFM2.5-24B-A2B-Base 均为开放权重模型,现已在 Hugging Face 上提供:
- 下载: LFM2.5-24B-A2B-Base 和 LFM2.5-24B-A2B 在 Hugging Face 上。
- 在你的测试工具中使用: 关注我们的 指南 关于如何运行本地智能体,例如 OpenClaw、Hermes Agent 和 Pi。
- 微调: 通过我们的教程将 LFM2.5-24B-A2B 适配到你的任务 微调教程.
我们迫不及待想看到你构建的作品。
引用
如果你使用了这项工作,请引用发布博客:
@article{liquidAI202624BA2B,
  author  = {Liquid AI},
  title   = {LFM2.5-24B-A2B: Built for Fast On-Device Agents},
  journal = {Liquid AI Blog},
  year    = {2026},
  note    = {www.liquid.ai/blog/lfm2-5-24b-a2b},
}