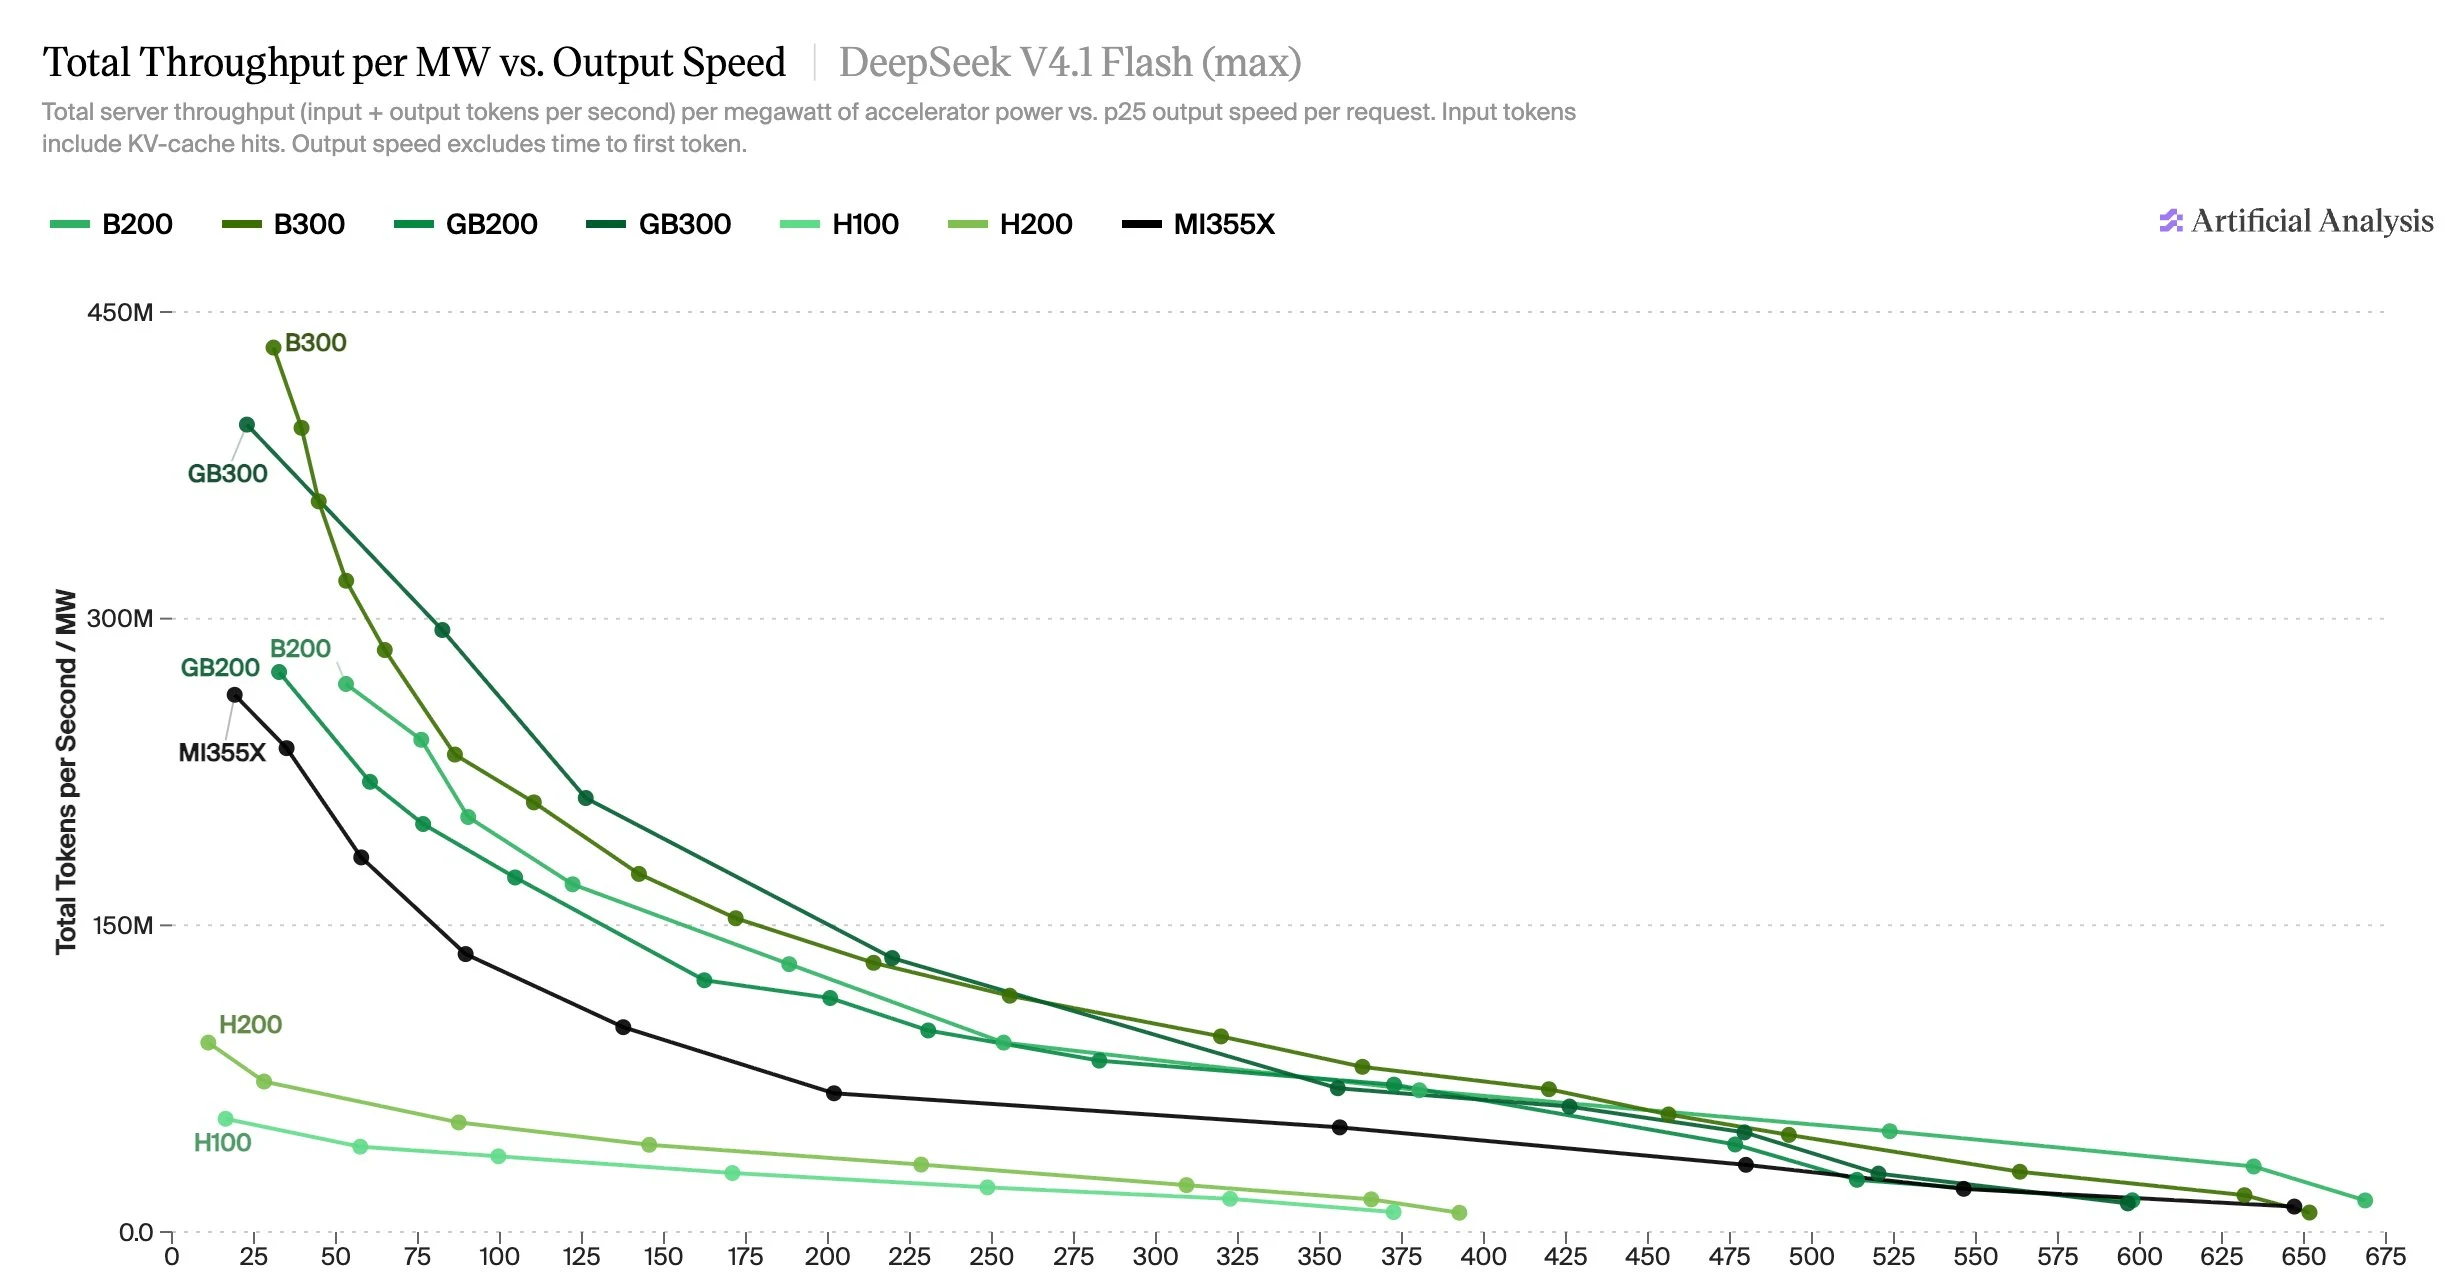
我们已将 DeepSeek V4.1 Flash 加入 AA-AgentPerf,并提供了 NVIDIA 和 AMD 硬件的结果。在每用户 100 tokens/s 时,NVIDIA GB300 位居第一,吞吐量高达每 MW 261M tokens/s。
AA-AgentPerf 是我们的智能体推理性能基准。它重放真实的智能体编程会话,包括提示词缓存和工具调用延迟,以便对日常智能体工作负载中的推理性能给出符合现实的衡量。我们测量每兆瓦运行功耗的系统总吞吐量,以及不同并发级别下的单智能体输出速度,以展示系统利用率与单个用户体验之间的权衡。
DeepSeek V4.1 Flash 于今日加入排行榜。它使排行榜上的精选模型达到四个,与 DeepSeek V4 Pro 0813、Kimi K3 和 GLM-5.2/5.3 同列。随着流行的新开源权重模型发布,我们会不断更新精选模型,并对未来重要发布提供第 0 天的结果。
关于 DeepSeek v4.1 Flash 的背景:
➤ 它在 Artificial Analysis Intelligence Index 上得分为 39,领先于 DeepSeek 此前的 V4 Pro 0813 的 36 分,而参数量约为后者的三分之一(552B ‘主干’参数和 16B 激活参数,对比 1.6T 和 49B)
➤ 它基于一种全新架构,采用因果式编码器-解码器设计,每个输入 token 激活 8B 参数,每个输出 token 激活 16B 参数。它还使用了额外的 196B 参数的 Engram n-gram 记忆,可以放在主机内存而非加速器上,并采用压缩稀疏注意力,其每 token 的 KV 缓存需求约为早前 V4 Flash 模型的四分之一
➤ 这使其服务效率高得多,因为权重可以装进更少的 GPU,而更小的 KV 缓存为每块 GPU 运行更多并发智能体留出了空间
DeepSeek V4.1 Flash 的初步 AA-AgentPerf 结果:
➤ V4.1 Flash 最少只需 2 块 GPU 即可运行,因此机架级系统相比 B300 等 8-GPU 单节点优势减小,后者在整个曲线上与机架级 GB300 NVL72 的差距保持在约 20% 以内,并在两端领先
➤ 在每用户 100 tok/s 时,GB300 以每 MW 约 261M tokens/s 领先,超过 B300(约 220M)、B200(约 193M)、GB200(约 178M)和 MI355X(约 128M)
➤ 所有 Blackwell 系统和 MI355X 在单个智能体(即批大小为 1)时均可达到约 600 至 670 tok/s 的输出速度,而 H100 和 H200 为 372 至 392 tok/s
➤ V4.1 Flash 既比 V4 Pro 0813 更智能,服务成本也低得多,在每用户 100 tok/s 时,每 MW 吞吐量约为其更大兄弟模型的 ~1.3 倍(GB300)至 ~6.2 倍(B200)