

旨在阻止黑客的 AI 防护规则现在却阻碍了防御措施,Orion-1 旨在填补这一空白
 Jonathan Kemper
查看 Jonathan Kemper 的 LinkedIn 个人资料
2026年10月14日
 Nano Banana Pro 由 THE DECODER 提示
关键要点
- Artemis Security 已推出 Orion-1,这是一种人工智能模型,能够自主调查并应对企业网络上的网络攻击。
- 它将来自网络、端点和云服务的分散日志数据连接起来,从而能够追踪攻击的来源,找到对应的执行者,并启动相应的对策。
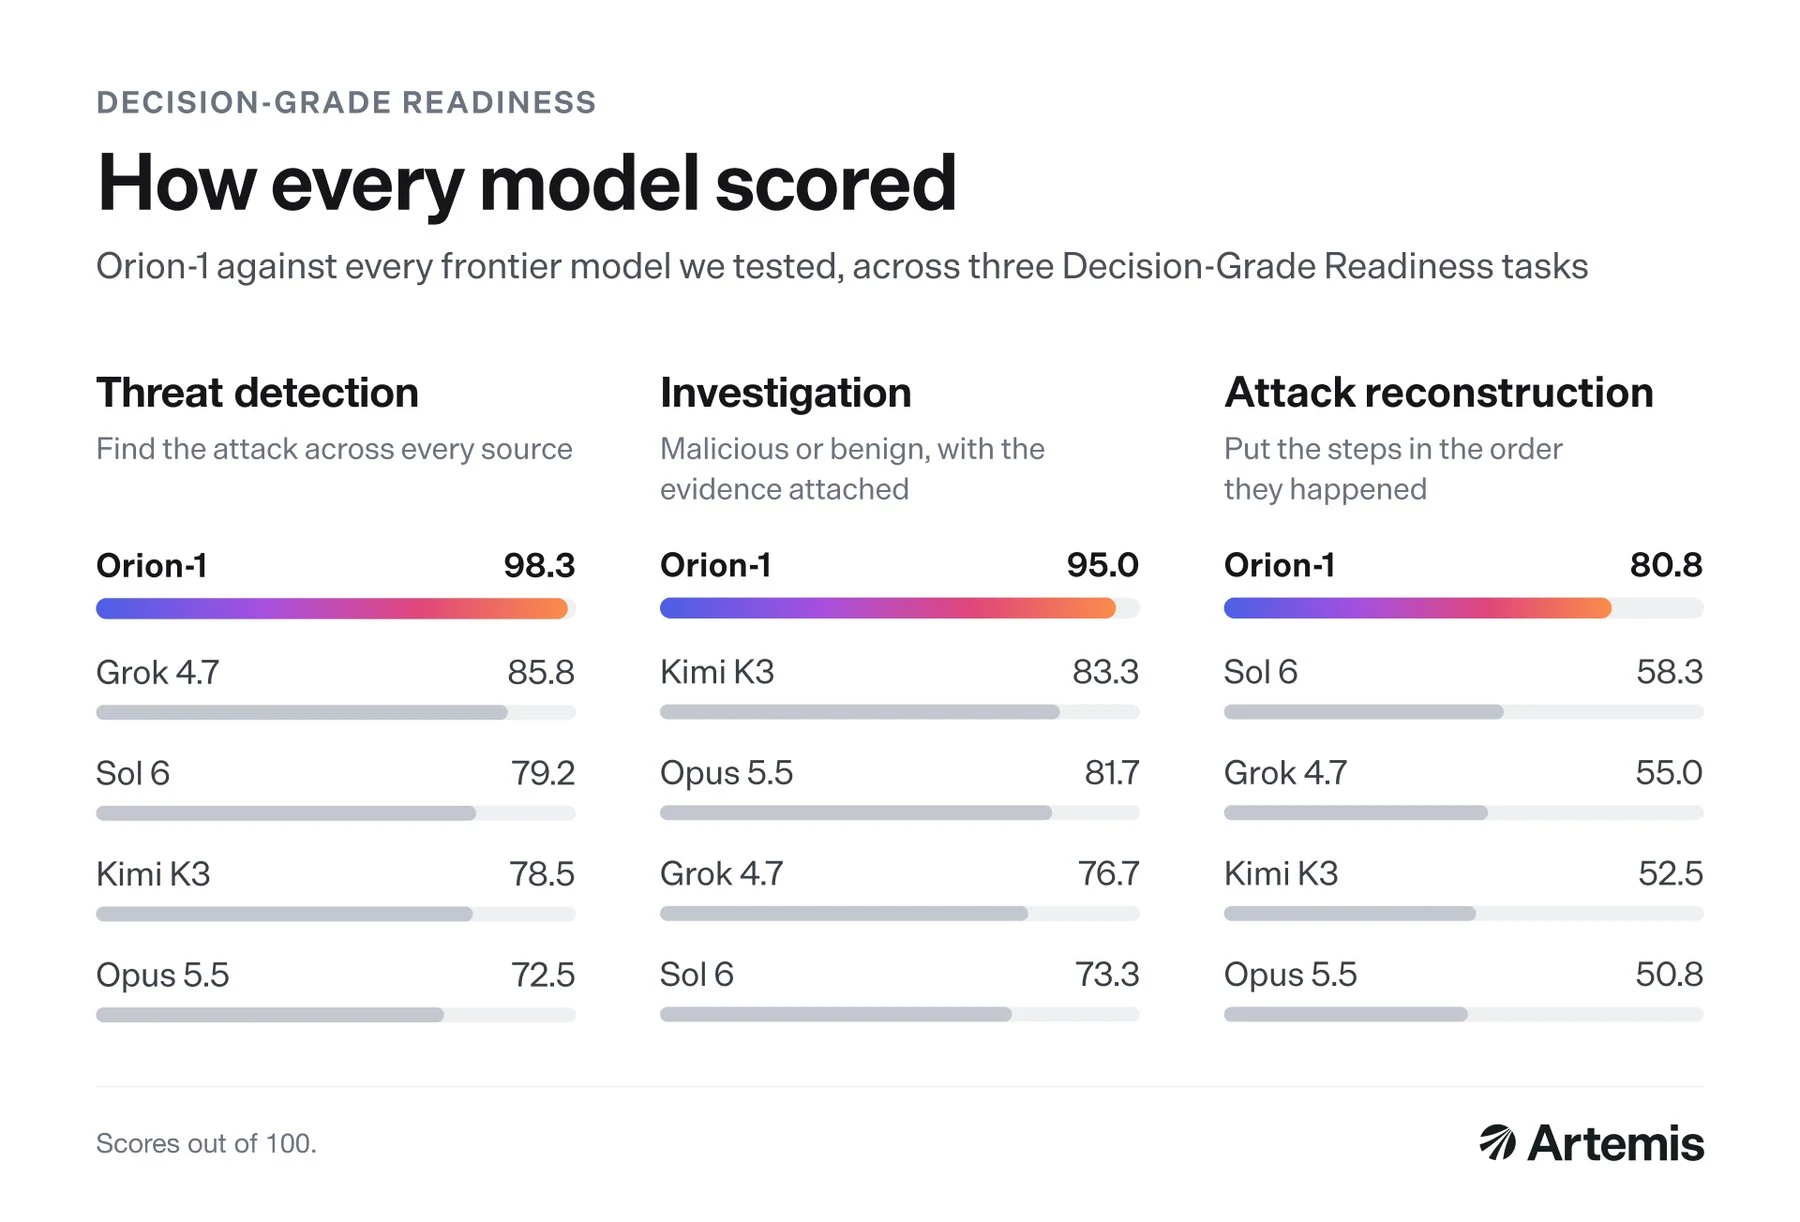
- 在该公司的自身基准测试中,Orion-1 优于 Claude Opus 5.5 和 GPT-6 Sol 等通用模型,在攻击重建方面的差距最大,为 80.8 分对 58.3 分。
通用人工智能模型正成为安全团队面临日益严重的问题,因为同样的技能也会帮助攻击者。Artemis Security 希望通过专用模型来填补这一空白。
美国初创公司 Artemis Security 推出了 Orion-1。该模型能够独立调查并应对企业网络上的攻击,在公司的自身基准测试中表现优于 Claude Opus 5.5 和 GPT-6 Sol。Orion-1 能够处理来自认证服务、云设置、企业端点、SaaS 应用以及网络设备的日志数据,然后将企业账户登录、新的云权限以及新创建的电子邮件收件箱规则等单个信号与单一攻击者联系起来。一旦掌握事件全貌后,该模型会给出置信度评分,确定判断结果,并建议或启动应对措施。
根据 Artemis 的说法,通用模型在处理数十亿个事件时会失去追踪能力,或者将无害但奇怪的活动误判为攻击。Artemis 通过自身安全操作任务对 Orion-1 进行了优化调整,这些任务包括从日志数据中识别可疑模式、寻找已知的攻击技术、编写新的检测规则以及阻止实时攻击。该公司表示,在训练过程中没有使用任何客户数据。Artemis 将 Orion-1 称为“Frontier Foundation Model”,但仅在其 博客文章中描述了这一优化过程,目前尚不清楚该公司是建立在其他供应商现有的模型之上。
阿尔泰米斯制定了自己的基准测试,用于衡量对安全决策的信任度
Artemis 开发了一个名为“决策等级准备度”(DGR)的基准测试,用于进行比较。目前大多数安全测试模型都基于攻击技术,或者让模型解决黑客难题,而 DGR 则给每个模型相同的初始警报、相同环境数据以及安全团队所拥有的相同工具,然后要求模型判断攻击是否正在进行中。 数千项任务都有明确的结果,有些则完全不包含攻击行为,或者包含旨在看起来具有恶意的正常数据。模型的评分取决于其判断结果以及所呈现的证据。
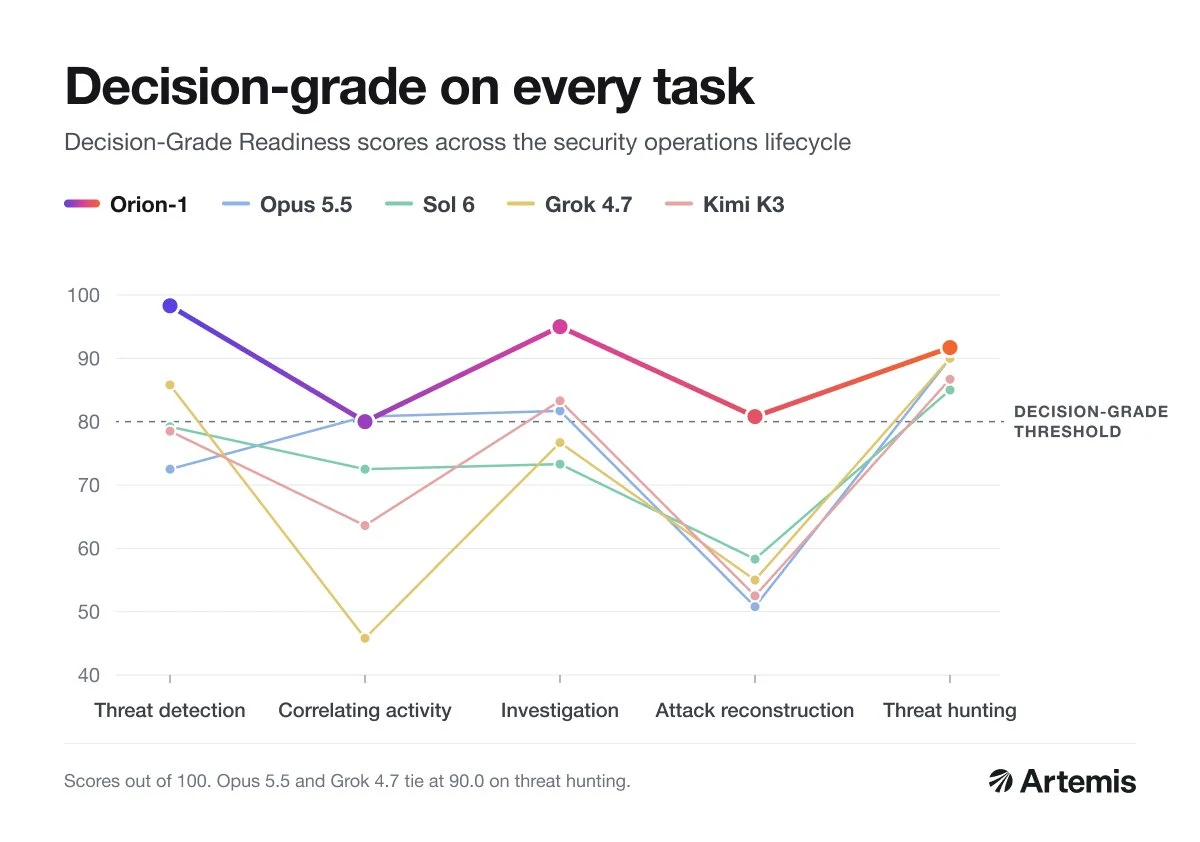
Artemis 在五项任务中报告了结果,并测试了 Grok 4.7 和 Kimi K3,同时还测试了 Opus 5.5 和 GPT-6 Sol。最大的差距出现在攻击重建任务中,其中 Orion-1 的得分为 80.8,而次优模型的得分仅为 58.3。
Orion-1 正在 Artemis 平台上为部分客户提供私人预览版本,客户可以设定每种操作类型的限制,以规定模型自行决策的程度。高影响操作默认需要人工审批。Artemis 在成立约六个月后于四月从隐藏状态中公开,并获得了 7000 万美元的种子轮和 A 轮资金。
针对攻击者的防护规则也阻碍了防御者
复杂的边界模型让安全团队难以操作,因为供应商不断限制其网络能力。OpenAI认为其 Astra 模型是第一个能够达到最高网络安全风险等级的模型,在这种状态下,模型可以自行开发并执行网络攻击。Claude Opus 5.5 将大多数网络安全任务分配给更旧的 Opus 4.8,当 Hugging Face 在七月试图使用商业边界模型分析一次完全自主的 AI 攻击其自身基础设施的情况时,其防护机制完全阻止了攻击数据的分析。最终,团队转而使用运行在其服务器上的开放权重模型 GLM 5.2。
为了防御,供应商正在提供具有限制访问权限的专用模型。OpenAI 则只提供访问权限较宽松的模型。 GPT-5.5-网络 经过验证的防御者,Anthropic 对其最强大的模型也采用类似方法,通过 Claude Mythos 5 进行运行 克劳德安全扫描器及合作伙伴安全产品. 两者 神话 5 以及 OpenAI 最强大的模型 GPT-6 Astra 未出现在 Orion-1 对比中,而使用 Opus 5.5 时,基准测试结果可能在很大程度上反映了较旧的 Opus 4.8 的结果。
AI新闻——无炒作,由人类整理
订阅 THE DECODER,即可享受无广告阅读体验、每周 AI 通讯、每年六次的独家 “AI Radar” 前沿报告、完整存档功能,以及评论区访问权限。
来源:Artemis Security