
Introducing OpenCompute
作者:Walker Hildebrand、Sherry Bai - 2026年10月14日 - 阅读时间 7 分钟
产品
分享
在一个智能体可以在你睡觉时工作的世界里,我们如何让它们运行在你自己的基础设施上?
当智能体存在于聊天窗口中时,答案很简单:它运行在你为该会话设置的机器上。但当智能体调查警报、响应异步请求、执行定时 Automations,并在一天中随时处理问题时,问题就变成了按需计算。你不再只需要某个运行智能体的地方。你需要一个能够跟上工作节奏的计算集群。
今天,我们推出 OpenCompute——Factory 的自托管智能体沙盒编排器,支持你选择的运行时,现已开启私密预览。
OpenCompute 为客户控制的基础设施带来按需配置和生命周期管理,并与 Factory 体验集成,涵盖 Environments, Automations以及 Remote Control。你的智能体在需要时获得计算机。你选择这些计算机在哪里运行。
它的构建基于一个信念:采用自主软件开发不应要求把基础设施的钥匙交到别人手里。
那么,我们是如何在六周内构建出一个能让我们在两天内部署到定制本地环境的东西的?
基于 Remote Control 构建
2026年4月,我们推出了 Droid Computers:用于编排 Droid 的持久化机器。客户可以在 Factory 的云中创建计算机,或通过 Remote Control 注册自己的机器。
Remote Control 体验使与 Factory 的集成独立于计算层。在任何机器上运行 Droid,将其连接到 Factory,然后远程使用它。这台机器可以是工作站、云 VM,或私有网络内的服务器。由于智能体执行循环运行在该机器上,Droid 可以访问内部环境中的私有仓库、软件包注册表和服务。客户无需将这些系统公开暴露即可让智能体使用它们。我们对 BYOK 和自托管推理的支持为数据主权提供了额外的控制。
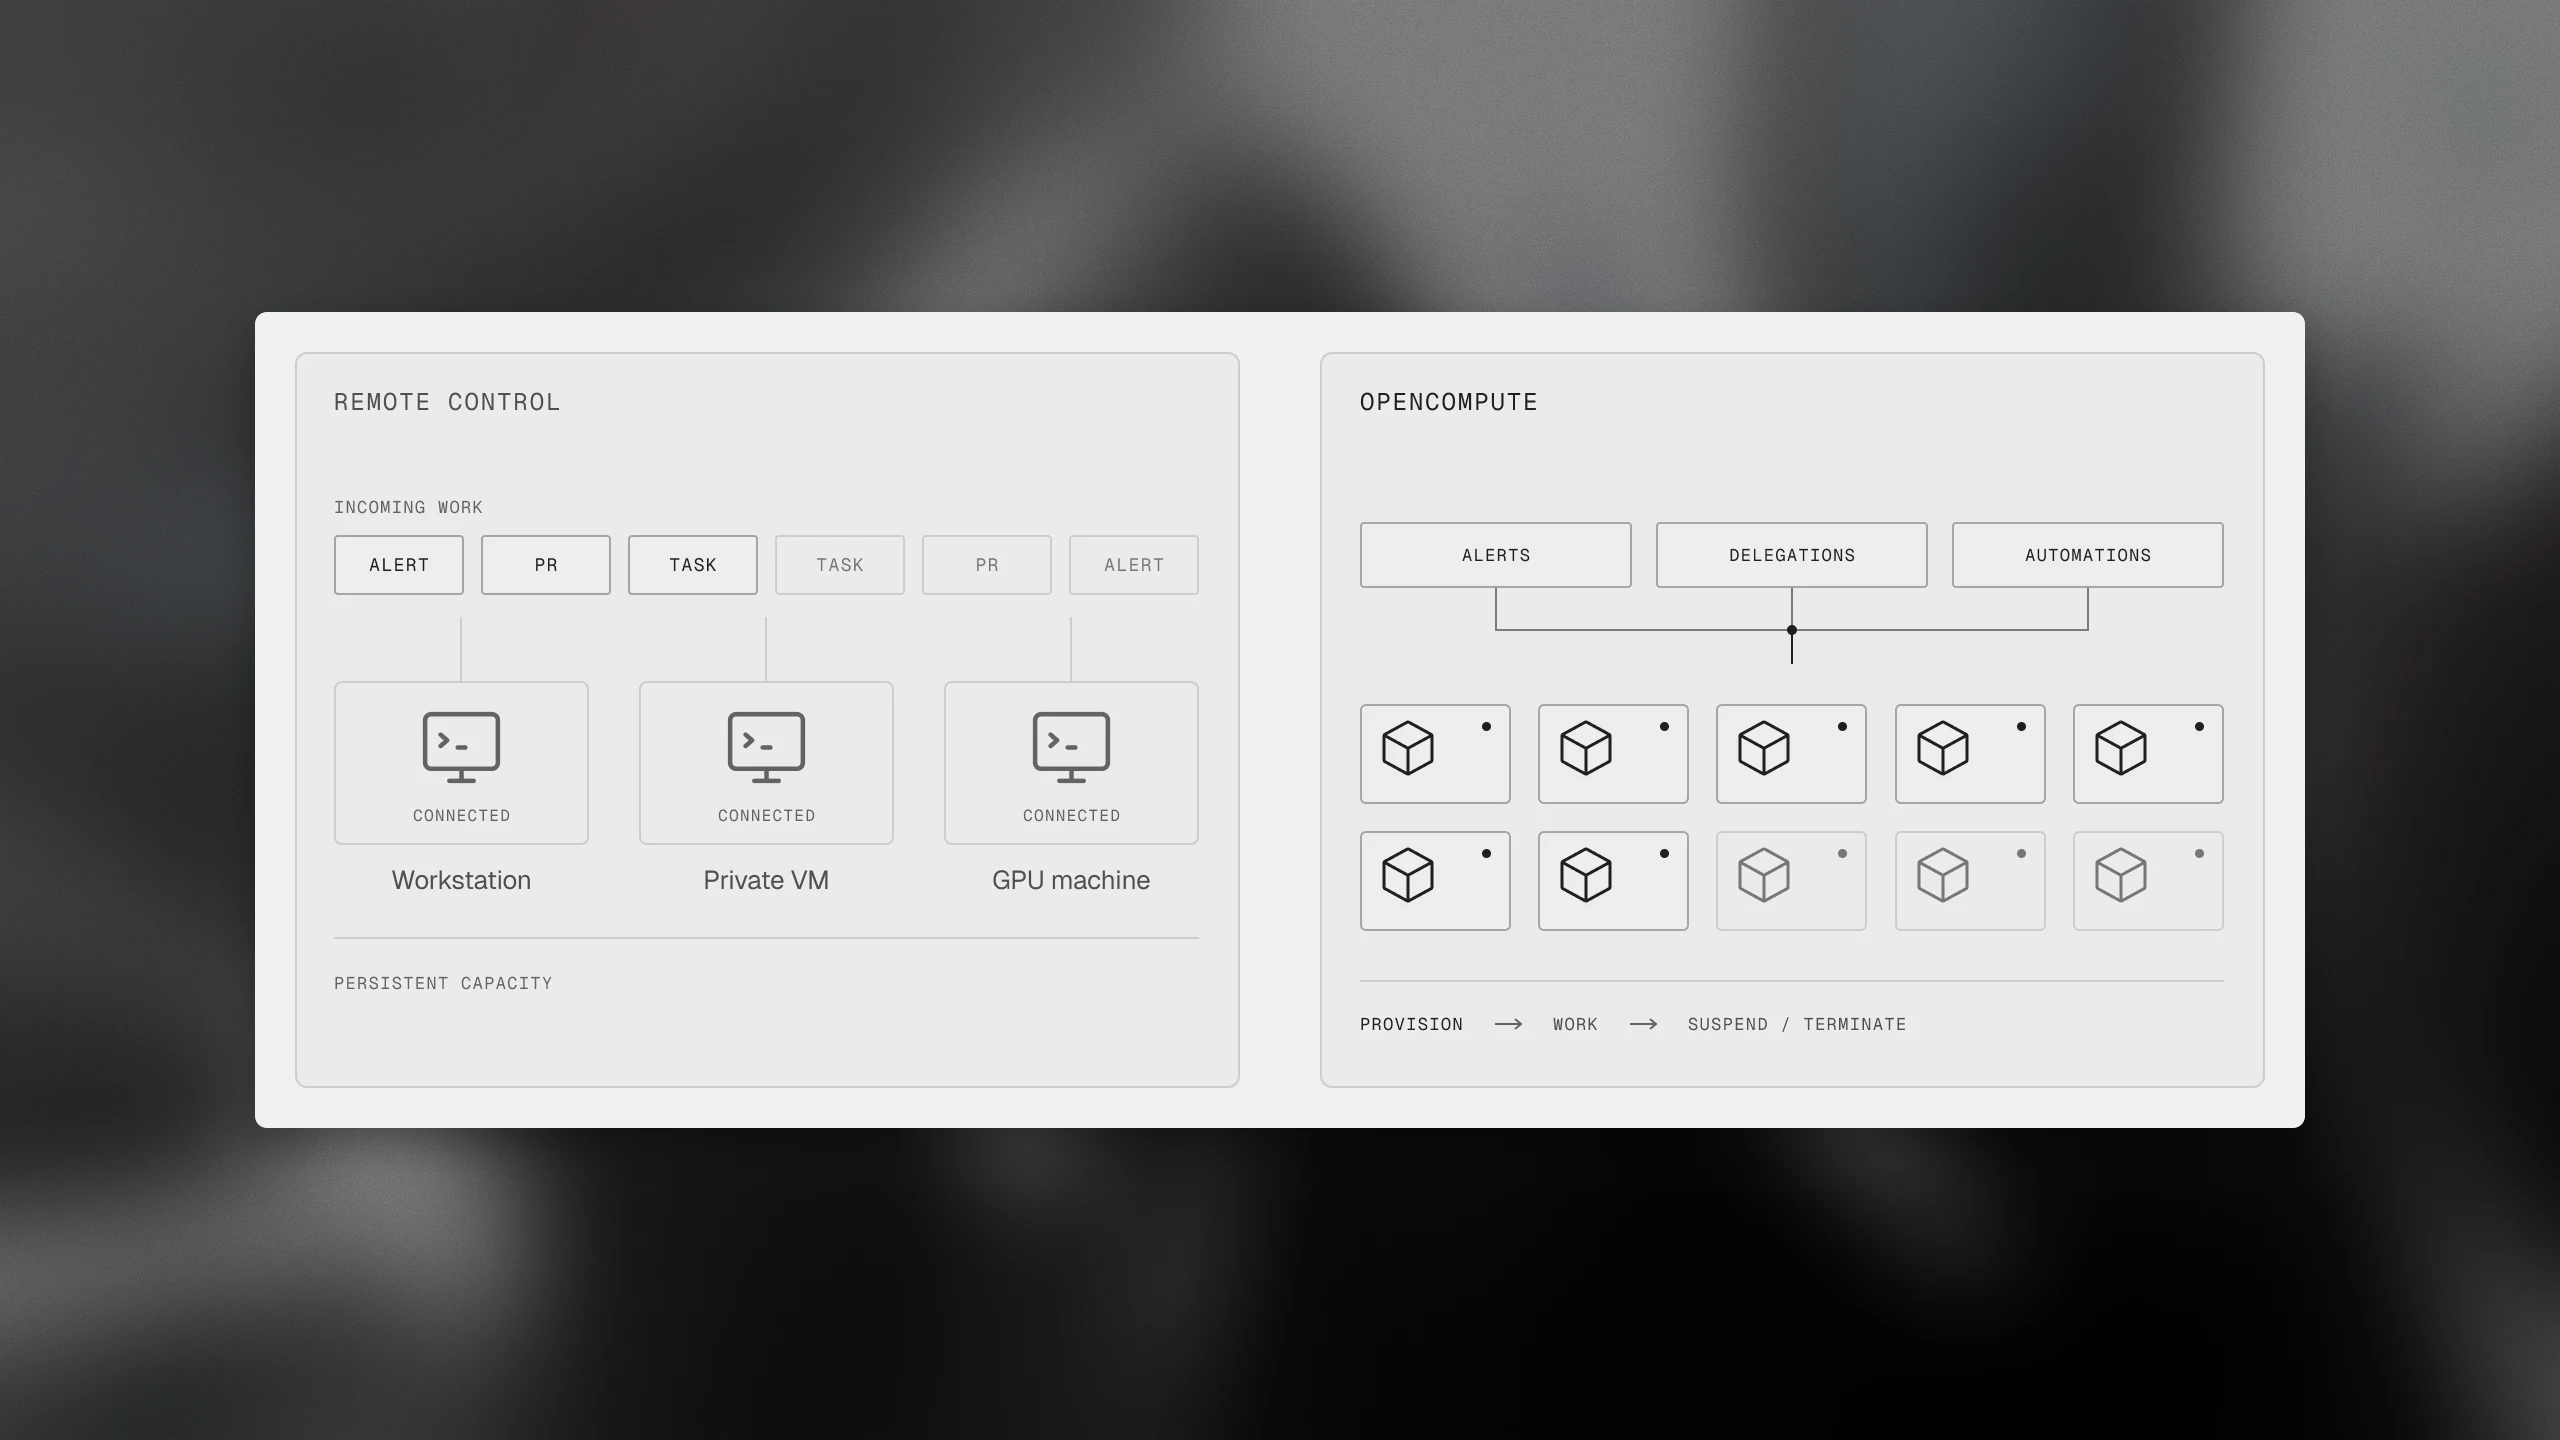
Remote Control 证明了这一模式的价值,整个行业也在朝着同一方向发展。但我们开始看到另一个明显的缺口:我们的企业客户需要一个管理计算机集群的解决方案,而不是一次管理一台计算机。
一台机器不等于一个集群
Remote Control 非常适合单个用户或服务的持久化机器:一台配置好的工作站、一个开发 VM,或一台配备专用硬件的机器。它回答的问题是:如何把智能体带到我最需要它们的地方?
但我们需要计算能力满足整个组织的需求,既支持交互式会话,又能让智能体在工作出现时独立运行。
一个警报应该能够在无需有人先配置 VM 的情况下触发调查。一波 Slack 委派任务不应该让团队去清点可用机器的数量。一个已完成的任务不应该让空闲资源无限期地运行下去。
我们的托管服务已经处理了该生命周期的一部分。自托管机器没有同样原生的配置、挂起和恢复集成。客户可以在他们想要的地方运行 Droid,但他们只能自己运营集群。
沙盒无处不在
我们看到了客户云基础设施之间的巨大差异。有些客户希望智能体运行在现有的 Kubernetes 集群上,有些希望运行在专用硬件上,还有一些希望运行在他们的开发人员已经依赖的内部平台上。其他客户正在引入新的 microVM 基础设施,或正在寻找解决方案。
我们的任务不仅仅是为客户提供沙盒集群。我们必须让集群管理在任何基础设施上都能工作。我们需要把编排能力带到客户的环境中,而不是把每个客户都拉进我们的环境。
面向智能体的沙箱环境方面的工作并不少见。第三方云沙箱平台包括 E2B、Daytona 和 Modal。诸如 Kubernetes Agent Sandbox、Google 的 Agent Substrate 以及 AWS Lambda MicroVMs 等项目也显示出对自带云(bring-your-own-cloud)和自带基础设施(bring-your-own-infrastructure)解决方案日益增长的需求。
每个平台在隔离性、持久性、启动速度、运维简易性和部署灵活性之间做出不同的权衡。适用于短生命周期任务的后端未必适用于持久性的开发环境。对初创公司运作良好的服务,可能在受监管企业的网络内不可用。而六个月后最好的选择,可能与今天最好的选择有所不同。
我们决定在计算基础设施之上构建一层。OpenCompute 负责公共生命周期:请求一台计算机,将其置入目标状态,跟踪其活动,并根据策略和供应商能力将其挂起或终止。供应商则拥有使这些操作得以实现的基础设施机制。这让我们能够受益于整个生态系统的改进,而无需让客户等待我们替换产品的基础。
让接口来完成任务
OpenCompute 的开发从一开始就是面向智能体(agent-native)的,起点是一个 Mission ,用来验证这个概念。我们的工作是定义边界、明确行为,并让正确性可被测试。其余工作由 Droids 在人类指导下完成。
这使得接口设计尤为重要。“为这个 provider 构建支持”是一个开放式任务。“实现这个契约并通过这些一致性测试”则给智能体一个有边界的问题和可验证的成功定义。
正是这种让 OpenCompute 对客户灵活的分离方式,也使它的构建变得可行。新的驱动程序,即针对每个 provider 的集成,可以专注于其 provider 而无需重写集群管理。共享的控制平面可以在不了解其他云 API 的情况下持续改进。
这种方法使我们能够在 AWS Lambda MicroVMs、Kubernetes、EC2、Agent Sandbox、Agent Substrate 以及其他实验性 provider 上开发和评估集成。这些并非完全相同的实现,也不是成熟度相当的后端。这正是重点所在:架构可以容纳差异,而不必把每一个差异变成一个独立的产品。
六周实现首次部署
最清晰的考验来自我们的首次客户部署。该客户需要在一个带有自研 provider 接口的定制本地环境中使用 OpenCompute。就在登上前往客户现场的航班之前,我们启动了一个 Mission,利用当时掌握的信息为其环境构建初始驱动程序。
当我们落地时,驱动程序已经构建完成。在现场驻留两天后,客户通过 OpenCompute 开通了他们的第一个沙箱。从用户的角度来看,这就像创建一个托管的 Droid Computer,但沙箱运行在客户自己的数据中心里。我们不需要为该客户发明新的架构。我们需要做的只是把它的基础设施连接到一个我们早已定义好的接口上。
从早期原型到首次客户部署:六周。
首次集成并非工程工作的终点。持久化、恢复、部署工具和运维加固在之后继续进行。但它验证了核心赌注:集成一个新 provider 可以只是一个驱动程序问题,而不是一次平台重写。
架构概览
OpenCompute 是一个自托管服务,它将 Factory 后端连接到客户的底层计算平面。
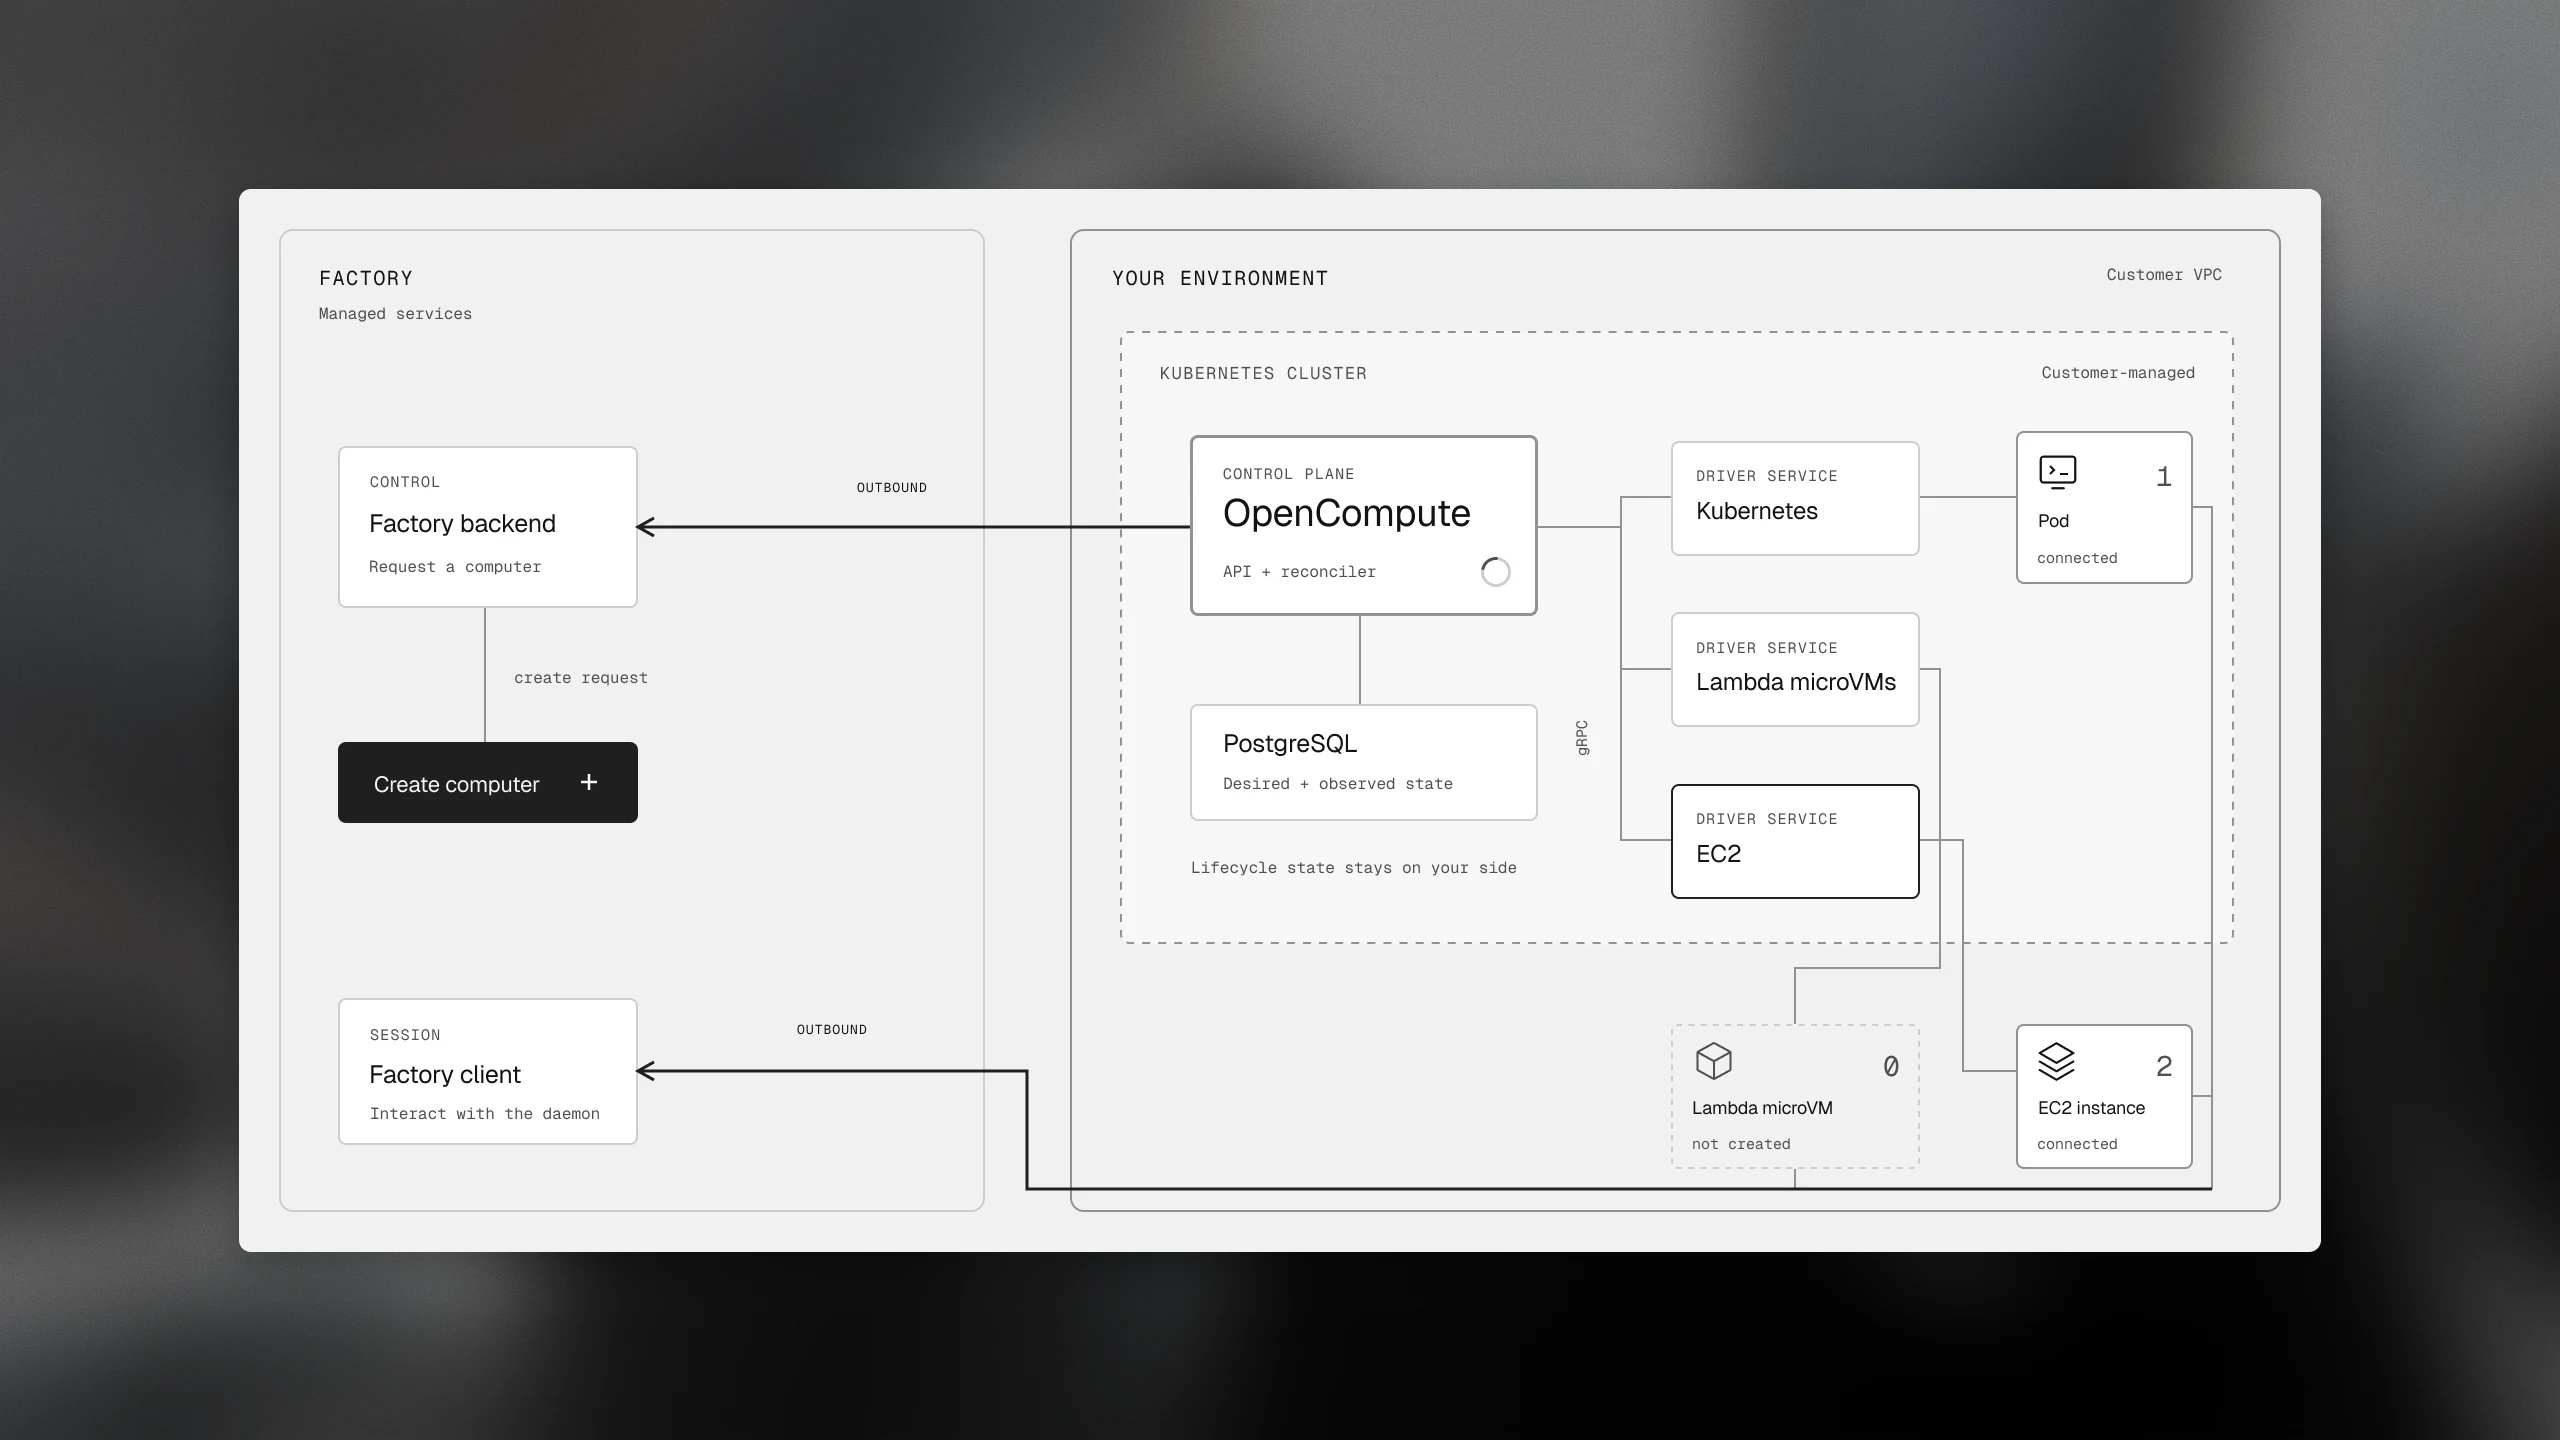
向外连接,向内执行
OpenCompute 在你的环境中运行,并建立一条到 Factory 的出站、TLS 加密的 WebSocket 连接。Factory 通过该连接发送经过授权的计算请求。你无需为 Factory 暴露公开的 OpenCompute 端点或开放入站防火墙端口。
在注册(enrollment)时,你的 OpenCompute 部署会向 Factory 注册一个公钥。在连接时,它通过签署一个新的挑战来证明拥有对应的私钥。私钥始终由你掌控,并且可以存放在受支持的云 KMS 中。
OpenCompute 开通的每个沙箱都会建立自己的到 Factory 的出站连接,与如今远程受控的计算机完全一样。内部仓库和服务可以保持私有。Droid 可以从你的网络内部访问它们。
关于数据存放位置的说明: 计算放置与推理路由和会话存储是相互分离的。会话数据是否完全保留在本地取决于你的推理和同步配置。
先记录意图,再进行调和
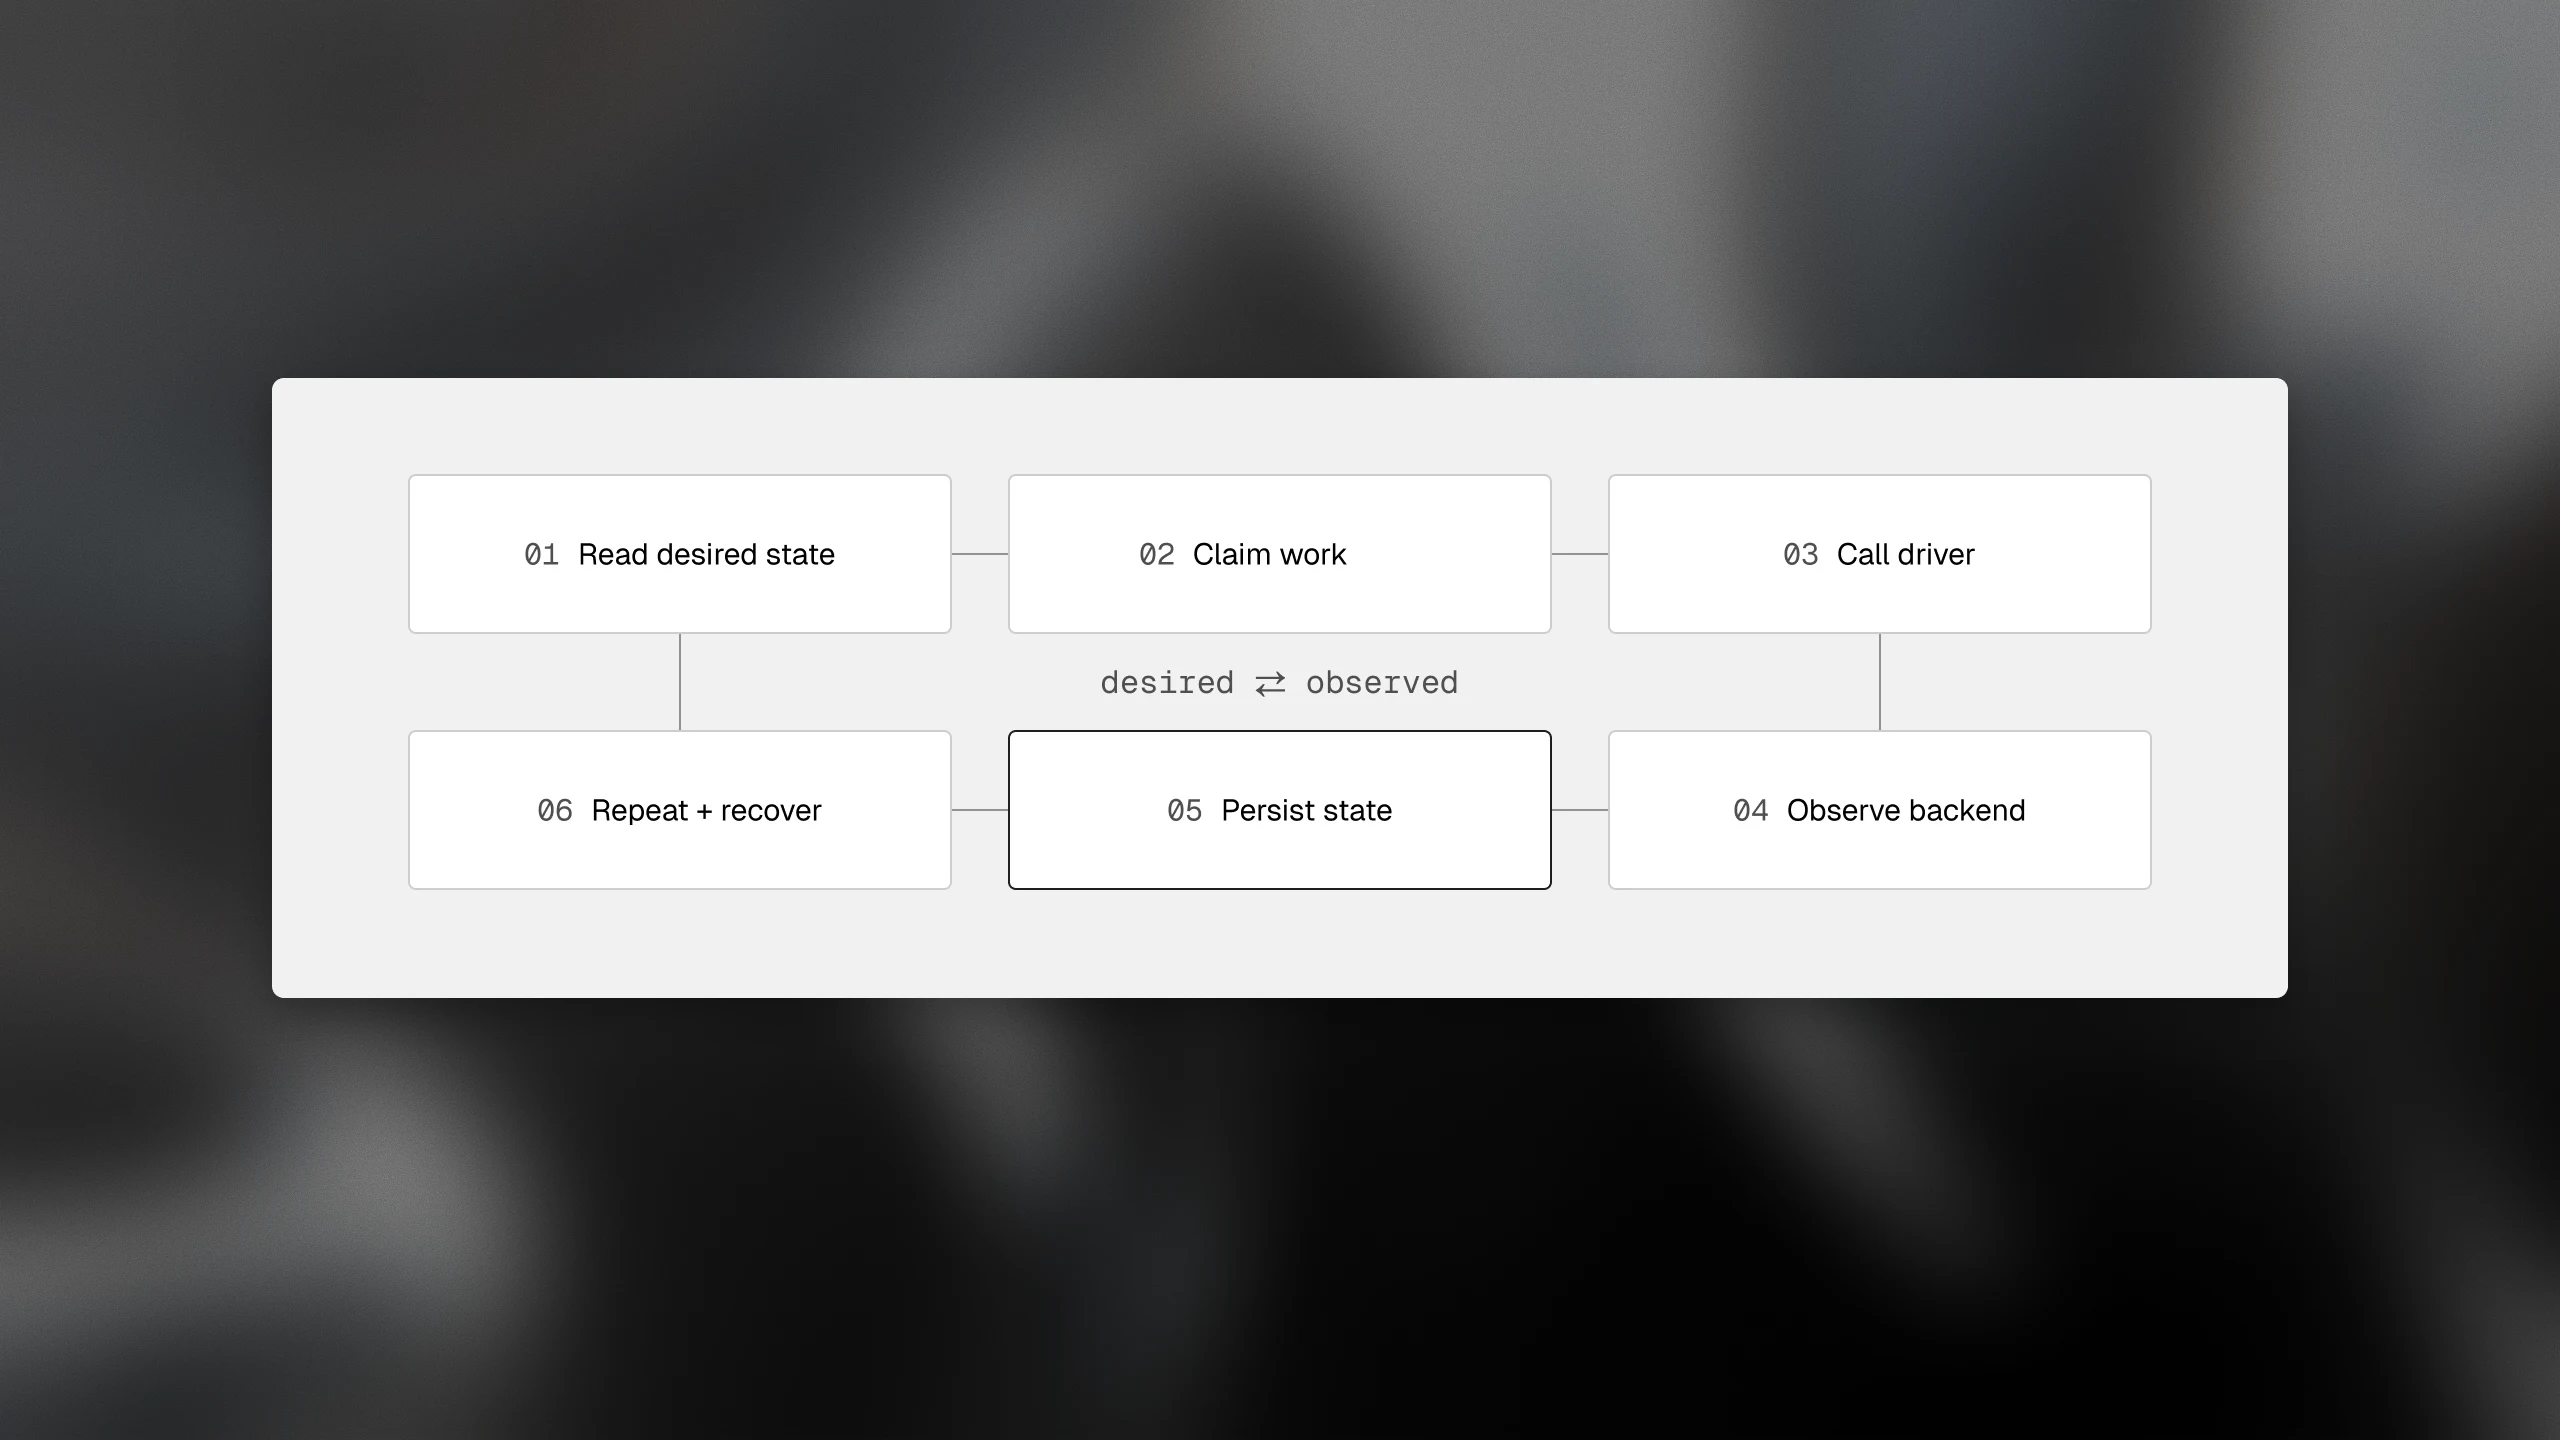
开通(Provisioning)并不是一次可靠的单次 API 调用,尤其是在面对陌生 provider 时。连接会消失。Provider 会限流。进程可能在请求成功之后、响应到达之前重启。OpenCompute 通过声明式生命周期模型来解决这一问题。其 Go 控制平面将期望状态和观测到的计算机状态记录在运行于你环境中的 Postgres 数据库里。一个调和器(reconciler)持续工作,使计算机达到所请求的状态。
创建计算机会记录持久的意图,而不是保持一个请求打开直到 provider 完成。调和器负责开通和观测、重试可恢复的失败,并驱动受支持的生命周期转换。由于意图是持久的,控制平面重启不会抹去未完成的工作。
计算机从不可变的 Builds 启动,将环境准备与机器创建分离。S3 兼容存储保存构建产物和快照载荷。活动信号和每台计算机的生命周期设置告诉控制平面何时保持计算机运行、何时执行生命周期操作。
标准化行为,而非基础设施
每个 provider 集成都作为一个独立的 gRPC 驱动程序运行。驱动程序将通用操作转换为后端原生的创建、观测、执行命令和销毁计算机的机制。
特定于 provider 的行为不会进入控制平面的数据库和调和逻辑。驱动程序可以使用适合其后端的传输和运行时,而不必采用某个强制的 guest agent。
但一个通用接口只有在对差异保持诚实的情况下才有用。并非每个后端都能挂起计算机、为磁盘创建快照或分叉计算机。因此,OpenCompute 定义了必需的 Core 一致性配置档以及可选的 Suspend、Snapshot 和 Fork 配置档。黑盒测试验证驱动程序声称支持的行为。不受支持的请求会在更改持久状态之前被拒绝,而不是在开通过程中途才以错误形式浮现。
该契约也是供应商中立的。Factory 是 OpenCompute 的一种可能客户端,驱动程序对 Factory 特有的功能保持不可知。OpenCompute 暴露自己的 API、CLI 和管理面板,因为管理你计算层的这一层应该独立于最初提出需求的产品而独立有用。
接下来是什么
我们计划将 OpenCompute 开源。目标不仅仅是发布实现代码,而是让契约、一致性测试和驱动程序模型对构建智能体系统的人们真正有用。
我们也将它视为 Factory 未来发展的基础。交互式会话、定时自动化、事故调查和委托工作不应各自需要一套独立的基础设施方案。它们应该能够通过同一个生命周期层来请求所需的环境,无论由 Factory 还是客户来运营。
我们很高兴能把这个基础交到更多人手中,并看到人们接下来会接入哪些提供商。
智能体工作负载的未来不会只运行在一家公司云中的某一种机器上。OpenCompute 就是我们为那个未来而构建的方式。
OpenCompute 现已进入私测预览阶段。如果你有兴趣探索 OpenCompute,请联系你在 Factory 的客户负责人。