
IDC 研究 表明,文档相关挑战使组织每年为每位信息工作者付出 19,732 美元的成本,并使生产力降低 21.3%。从数百家供应商接收发票的组织常常面临因开票方而异且会毫无通知地变化的版面。在这种规模下,基于模板的系统需要持续维护。员工可能将多达 30% 的时间花在文档相关任务上,人工数据录入错误率介于 1–4%之间。传统智能文档处理 (IDP) 解决方案可以解决部分负担,但它们需要为每种文档格式进行大量前期配置,并且在各供应商版面不同时会失效。
在这篇文章中,您将学习如何使用 Amazon Bedrock AgentCore 构建代理式 IDP 系统,以最少的人工干预对业务文档进行分类、提取、验证和学习。Amazon Bedrock AgentCore 是一个以任何框架或模型大规模构建、连接和优化代理的平台。您的代理会自动处理新的文档格式,例如供应商发票、采购订单、保险索赔和贷款申请。读完本文后,您可以:
- 部署多代理 IDP 系统,通常只需不到 20 分钟。
- 无需手动模板配置即可处理新的文档类型。
- 让代理针对每种新文档格式进行自我训练并复用所学内容,这样该类型的后续文档可以直接进入提取阶段而无需重新训练。
基于规则的文档处理面临的挑战
许多 IDP 流水线要求您为每种文档格式预先定义模板、提取规则和验证逻辑。当新供应商发送版面不同的采购订单时,流水线就会失效。这带来三大核心挑战:
- 模板僵化: 每种新文档格式都需要手动配置,即使是细微的版面变化也可能导致提取失败。
- 无法学习: 相同的提取错误在类似文档中反复出现,因为系统不会保留以往更正的知识。
- 扩展负担: 每个新供应商或文档变体都会成倍增加维护工作,处理来自数百个来源的文档的组织面临持续不断的运营成本。
代理式方法可以解决这些挑战。AI 代理不再使用静态模板,而是分析每份文档、生成提取指令、验证结果,并自动从更正中学习。随着时间推移,您的系统会建立一个文档格式知识库,从而以最少的额外配置处理类似文档。
解决方案概览
在此解决方案中,八个专用代理在运行于 Amazon Bedrock AgentCore 上的两个基于图的工作流中进行协作。
以下图表显示了使用 Strands Agents(一个用于构建 AI 代理的开源 SDK)构建的多代理工作流图。
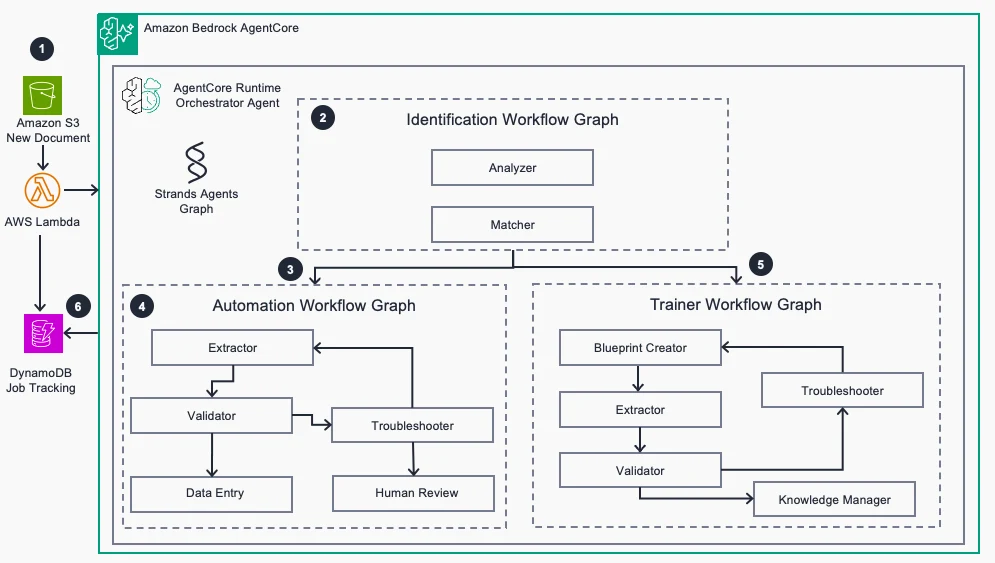
图 1:多代理编排工作流图
- 识别工作流:Analyzer 代理使用 Amazon Textract 提取文本并识别文档类型和发送方。Matcher 代理使用向量相似性在中搜索相似文档 Amazon S3 Vectors,Amazon Simple Storage Service (Amazon S3) 的一项功能。
- 训练工作流 (新文档类型):当未找到匹配时,Instructions agent 生成提取提示词,Extractor agent 提取结构化数据,Validator agent 根据 Amazon Aurora DSQL中的模式和业务规则检查结果。如果验证失败,Instructions Fixer agent 会优化提示词并重试。成功后,Save Instructions agent 会持久保存这些指令以供复用。
- 自动化工作流 (已知文档类型):当找到匹配时,Extractor agent 使用现有指令。如果验证失败,Troubleshooter agent 会直接修复提取的数据,而不修改指令。
工作原理
下图展示了该解决方案的基础设施架构。
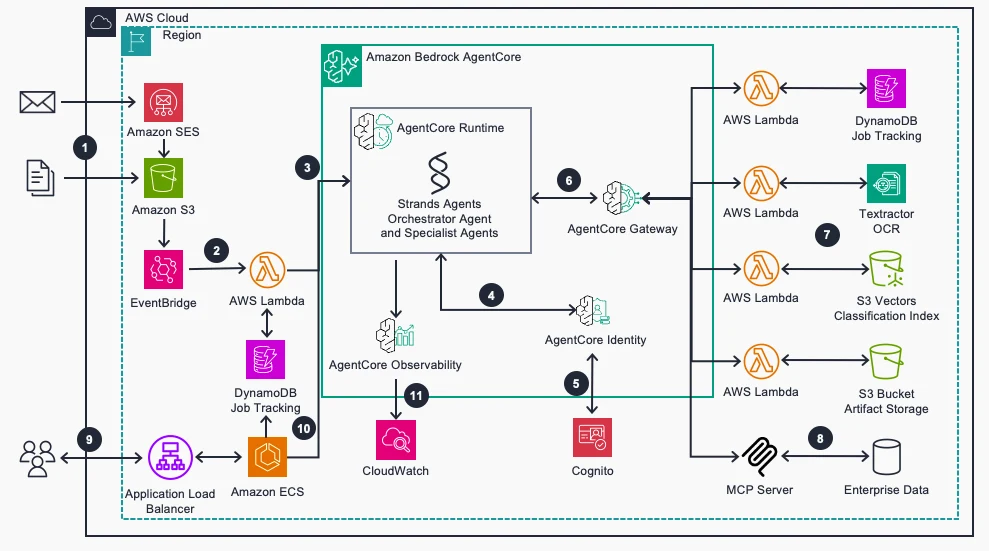
图 2:AWS 上的 Agentic IDP 基础设施架构
- 业务文档通过 Amazon Simple Email Service (Amazon SES)或直接上传到 Amazon S3 到达。
- Amazon EventBridge 触发一个 AWS Lambda 函数,该函数在 Amazon DynamoDB 中创建跟踪任务,并调用 AgentCore runtime,这是 Amazon Bedrock AgentCore 的一项功能。
- AgentCore runtime 通过 Strands Agents 协调文档处理。
- 您的智能体通过由 AgentCore Identity(Amazon Bedrock AgentCore 的一项功能)管理的机器对机器凭证安全地访问 AWS 资源,并且 Amazon Cognito.
- 通过 Amazon Bedrock AgentCore 的一项功能 AgentCore Gateway 的 Model Context Protocol (MCP) 接口,您的 Lambda 函数将成为与代理兼容的工具。
- 智能体使用 Amazon Textract 提取文本,使用 S3 Vectors 中的向量嵌入对文档进行分类,并根据 Aurora DSQL 中的业务规则验证数据。
- 代理通过 MCP 服务器访问企业数据,以根据业务规则验证提取的内容。
- 您通过一个托管在以下位置的启用聊天功能的仪表板来监控状态并排查问题 Amazon Elastic Container Service (Amazon ECS)。
- 您可以通过 AgentCore Observability(Amazon Bedrock AgentCore 的一项功能)了解代理的性能表现,以及 Amazon CloudWatch 遥测。
部署解决方案
按照以下步骤将该解决方案的基础设施和Web UI部署到您的AWS账户。
前提条件
要部署此解决方案,您必须具备:
- 一个 AWS 账户.
- 访问 Amazon Bedrock 支持 Amazon Nova 和 Anthropic (Claude) 模型。有关各 AWS 区域的模型可用性,请参阅 Amazon Bedrock 中各 AWS 区域支持的模型.
- 在3中获得对 Amazon Bedrock AgentCore(Runtime、Gateway、Identity)、S3 Vectors 和 Amazon Aurora DSQL 的访问 支持区域.
- AWS Cloud Development Kit (AWS CDK) v2 已安装。
- Docker 已安装并运行(构建和部署容器镜像所必需)。
- 需要 Python 3.11+ 和 Node.js 18+。
- AWS Identity and Access Management (IAM) 权限,以创建 S3 存储桶、Lambda 函数、DynamoDB 表、Cognito 用户池、Amazon Elastic Container Registry (Amazon ECR) 仓库和 Amazon ECS 服务。
- 克隆该 仓库 并设置环境:
git clone https://github.com/aws-samples/agenticidp-guidance.git cd agenticidp-guidance uv venv source .venv/bin/activate uv pip install -r requirements.txt cd ui/orchestrator npm install cd ../.. - 部署堆栈:
uv run deploy.py --admin-email your-email@example.com
这会部署六个 AWS CloudFormation 堆栈:核心层(S3、Cognito、DynamoDB)、网关层(Lambda 工具、AgentCore Gateway)、数据库层(Amazon Aurora DSQL)、代理层(AgentCore 运行时、容器)、UI 编排层(API 端点)以及现代 UI(React 应用,运行于 Amazon CloudFront)。部署大约需要 15–20 分钟。
- 通过检查每个堆栈是否显示来验证部署
CREATE_COMPLETE在 CloudFormation 控制台中。
处理文件并查看结果
部署后,您会收到一封电子邮件,其中包含 CloudFront URL、用户名和临时密码。
处理文档
- 登录 Web UI 并选择 流程文档.
- 上传一份来自以下平台的采购订单样本:
infrastructure/sample_data/purchase_orders/training/. - 该文档进入代理工作流:
- Analyzer 代理提取文本并识别发件人和文档类型。
- Matcher 代理在向量存储中搜索相似的文档。
- 对于新的文档类型,训练工作流会生成提取指令、提取数据、进行验证,并保存这些指令以供将来使用。
- 对于已知的文档类型,自动化工作流会使用现有指令提取数据并进行验证。
- 在 Review Jobs and Instructions 标签页中查看结果,以核实提取的数据、验证结果和生成的指令。
示例:新文档类型(训练工作流)
假设您上传了来自新零售商 Two Wheel Store 的第一份采购订单。Matcher 代理搜索向量存储,未找到相似文档,于是将任务路由至训练工作流。
Analyzer 代理使用 Amazon Textract 提取原始文档文本:
# PURCHASE ORDER
FROM: Two Wheel Store
Order #: PO-2026-0102-2584
Date: 2026-01-02

## Items Ordered
AC-021  Advanced Computer     Qty: 1   $75.61
        Colors: cr4321        @ $75.61
...
SB-004  Folding Classic       Qty: 8   $9634.32
        Colors: cb8901 I Sizes: S     @ $1204.29

TOTAL: $14931.54
Instructions 代理根据 schema 生成提取提示词,Extractor 代理生成结构化 JSON:
{
  "po_number": "PO-2026-0102-2584",
  "retailer_name": "Two Wheel Store",
  "order_date": "2026-01-02T00:00:00Z",
  "line_items": [
    { "sku": "AC-021", "product_name": "Advanced Computer", "quantity": 1, "unit_price": 75.61, "line_total": 75.61 },
    { "sku": "SB-004", "product_name": "Folding Classic",   "quantity": 8, "unit_price": 1204.29, "line_total": 9634.32 }
  ],
  "order_total": 14931.54
}
Validator 代理根据 schema 检查结果,结果 失败:
validation_status: INVALID
error: 'SB-004' does not match '^AB-[A-Z]{2}-\d{3}$'
供应商的 SKU 格式(SB-004)与 Acme Bikes 的内部格式(AB-SB-004)不匹配。Instructions Fixer 代理诊断出这一不匹配,并在提取提示词中添加了一条明确的 SKU 转换规则:为供应商 SKU 添加前缀 AB-。第二轮处理时,七个行项目全部验证成功,Save Instructions 代理将优化后的提示词持久化到向量存储中。首次运行的端到端耗时:3 分 49 秒。
示例:已知文档类型(自动化工作流)
当来自 Two Wheel Store 的第二份采购订单到达时,Matcher 代理以 3.946 的置信度分数(阈值:3.7)找到首次运行时存储的指令,并将任务路由至自动化工作流:
- Extractor 代理直接应用存储的指令,因此编排器跳过提示词生成。训练期间学到的 SKU 转换规则自动生效(
EL-002→AB-EL-002,HB-071→AB-HB-071,PD-002→AB-PD-002). - 三个行项目在第一轮即验证通过,订单总额为 $5,979.19。
- 端到端处理在 1 分 30 秒内完成,低于首次运行的 3 分 49 秒。
使用交互式聊天
仪表板包含一个用于故障排查的聊天界面:
- 询问
what tools do you have以查看可用的代理功能。 - 询问
list instructions以查看存储的提取指令。 - 询问
what is the status of job XXXX以检查处理进度。 - 询问
what went wrong with job XXXX, how can we update the instructions?以诊断故障。
理解准确性如何随时间提升
系统通过两个反馈回路随时间不断改进:
- 训练回路:当 Instructions Fixer 代理在验证失败后优化提取提示词时,改进后的指令会被保存并供相似文档复用。
- 处理回路:当 Troubleshooter 代理修复提取错误时,它会提供详细分析,有助于识别文档格式变化中的模式。
更换模型时,请使用 AgentCore Evaluations(Amazon Bedrock AgentCore 的一项功能),以确认提取质量仍然可以接受。该解决方案已经使用了 AgentCore Observability,因此具备所需的检测能力。
预估成本
您只需为实际使用的部分付费,因为该解决方案运行在无服务器和按需资源上,没有闲置成本。对于每月在美国东部(弗吉尼亚北部)处理10份训练文档和1,000份已处理文档的工作负载,估计成本约为每月58美元。通过 Amazon Bedrock 进行的基础模型(FM)推理约占总成本的85%,即每份文档约0.055美元。实际成本在很大程度上取决于分配给每个智能体的模型。模型选择集中在 agents/orchestratorgraph/utils/config.py因此,您可以在较简单的任务中使用成本较低的模型,并在需要时使用更强大的模型。有关详细定价,请参阅 Amazon Bedrock 定价 页面。
为您的用例定制解决方案
您将获得一个包含合成自行车公司数据集的采购订单处理用例、一个预构建的 JSON 模式,以及一个验证 Lambda 函数,该函数会将提取的数据与模拟 ERP 数据库中的产品和供应商记录进行核对。要处理您自己的文档,您必须将所包含的模式和验证逻辑替换为您自己的内容和逻辑。
定义您的文档模式
创建一个 JSON 模式,用于定义您希望针对每种文档类型提取的字段。 agents/orchestratorgraph/doc_schema/purchase_order_schema.json 中的示例采购订单模式可提供参考。您的模式应指定字段名称、数据类型,以及每个字段是在文档中明确声明还是从上下文中推断得出。
构建您的验证流程
所包含的验证器会对照 Aurora DSQL 中的合成供应商表和产品表检查采购订单数据。您的生产环境实现需要一个符合您业务规则的验证流程。例如:
- 发票验证器可能会对照您的应付账款系统检查供应商 ID,并核实各明细项总额与发票总额一致。
- 合同验证器可能会核实文档包含必需的条款,并且日期和当事方名称与您的记录相符。
- 理赔验证器可以对照您的保单管理系统检查保单号、承保限额和索赔人信息。
要添加新的验证器,请创建一个接受提取的 JSON 并返回带详细错误信息的通过/失败结果的 Lambda 函数,然后将其注册为 AgentCore Gateway 中的工具。实现模式请参阅 gateway/tools/po_validator_tool/ 。
更新代理提示词
中的代理提示词 agents/orchestratorgraph/prompts/ 引用了采购订单术语。请更新这些提示词以反映您的文档类型和提取要求。Orchestrator 代理、Validator 代理和 Instructions 代理各自包含特定于文档类型的语言,您应当进行调整。
最佳实践
在训练和运营您的代理式 IDP 系统时,请牢记以下建议。
- 从代表性样本开始:训练时每种类型上传 5–10 份文档,包括格式变化的边缘案例,以构建可靠的提取指令。
- 使用业务规则验证:将验证器连接到 Aurora DSQL 中的参考数据(供应商列表、产品目录),以便尽早发现提取错误。
- 监控代理性能:使用 AgentCore Observability 和 CloudWatch 跟踪执行路径、识别瓶颈,并随时间衡量提取准确性。
- 逐步增加文档类型:为每种新文档类型创建一个 JSON schema 和相应的验证 Lambda 函数。其余工作由代理完成。
- 为生产环境添加护栏:应用 Amazon Bedrock Guardrails 对代理输出实施内容过滤和接地检查。在处理保险理赔或贷款申请等敏感文档类型时,这一点尤为重要。
- 查看面向 LLM 的 OWASP Top 10:在构建使用大型语言模型(LLM)的应用程序时,请参考 OWASP Top 10 for LLMs and Generative AI Apps 中的安全注意事项。
清理
重要提示: 在运行清理之前,请导出您想保留的数据。该 destroy.py 脚本会永久删除已处理的文档(S3)、任务历史(DynamoDB)、验证数据(Aurora DSQL)以及学习到的提取指令(向量存储)。
为避免持续产生费用,请移除已部署的资源:
uv run destroy.py在控制台上确认以下六个 CloudFormation 堆栈已删除:AgenticIDP-Core-Dev、AgenticIDP-Gateway-Dev、AgenticIDP-Aurora-Dev、AgenticIDP-Agent-Dev、AgenticIDP-UIOrchestr-Dev 和 AgenticIDP-ModernUI-Dev。
结论
在这篇文章中,您学习了如何使用 Amazon Bedrock AgentCore 构建自我改进的文档处理系统,其中专门的 AI 代理协作对业务文档进行分类、提取、验证和学习。这种代理式方法可以自动适应新的文档格式,并通过反馈循环随时间提高准确性,以自主学习取代手动模板配置。
后续步骤:
- 部署 示例解决方案 并使用随附的采购订单示例进行测试。
- 通过创建 JSON 模式和验证规则来添加您自己的文档类型。
- 探索如何将提取的数据与下游系统(如 ERP、CRM 或内容管理工具)集成。
要了解本文中使用的服务和模式,请参阅以下资源:
- 要深入了解此解决方案中使用的代理框架,请参阅 Strands Agents SDK:深入了解代理架构和可观测性的技术文章.
- 要了解 AgentCore Gateway 如何将 API 转换为代理兼容的工具,请参阅 Introducing Amazon Bedrock AgentCore Gateway:改变企业 AI 代理工具开发.
- 要了解 Model Context Protocol 的背景及其如何与 AWS 服务集成,请参阅 解锁 AWS 上 Model Context Protocol (MCP) 的强大功能.
- 要了解代理如何在会话之间保留上下文,请参阅 Amazon Bedrock AgentCore Memory:构建具有上下文感知能力的代理.
- 有关 Amazon Bedrock AgentCore 功能的详细信息,请参阅 Amazon Bedrock AgentCore 文档.
如需构建文档处理解决方案的专业指导, AWS Professional Services 和 AWS Partners 可以提供帮助。