
vLLM 是一个面向大型语言模型(LLM)的开源推理与服务引擎。LLM 推理包含两个不同的阶段:prefill,它处理输入提示并构建键值(KV)缓存;decode,它利用该缓存逐个 token 生成输出。这两个阶段在计算、内存和扩展特性上各不相同。 Prefill-decode(P-D)分离 将这两个阶段运行在独立的引擎实例上,使每个阶段可以独立扩展和优化。这可以在负载下改善资源利用率、吞吐量和延迟。然而,它也要求在 token 生成开始之前将 KV 缓存从 prefill 实例传输到 decode 实例,这使得高效的 KV 传输对首 token 时间(TTFT)至关重要。
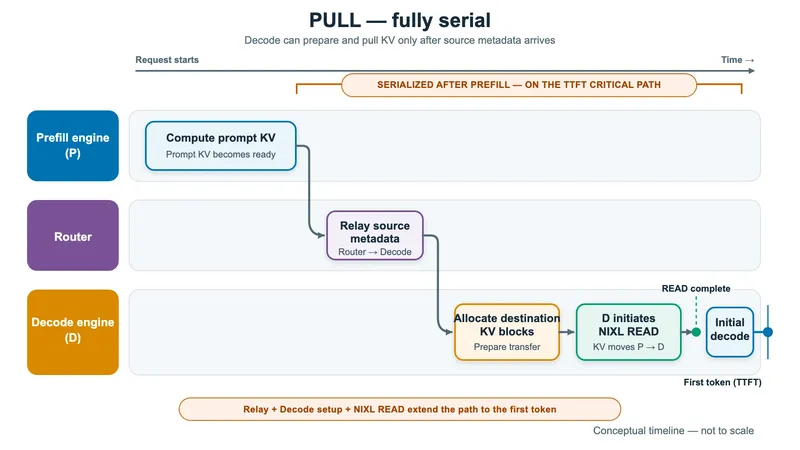
vLLM 执行这种传输的方式之一是通过 NVIDIA Inference Xfer Library(NIXL) 连接器,它在支持 RDMA 的互连(如 AWS Elastic Fabric Adapter(AWS EFA,AWS 中跨服务器使用的低延迟 RDMA 网络))上移动 KV 块。在 支持的实例类型上,AWS EFA 支持 GPUDirect RDMA 和 Neuron Direct RDMA,使 NIXL 能够直接在 GPU 或 Trainium 设备内存之间传输 KV 块,而无需经过主机内存中转。NIXL 连接器的默认模式是 拉取式(pull-based):在 prefill 实例完成提示 KV 缓存的计算后,路由器将源元数据(包括 prefill 块 ID)中继给 decode 实例。decode 实例随后分配目标块、准备 NIXL 传输,并发起 NIXL READ 从 prefill 实例拉取 KV 块。由于这些协调和设置步骤是在 prefill 之后、decode 开始之前按顺序执行的,它们延长了 TTFT 关键路径,如下图所示的时间线。
本文介绍一种 推送式(push-based) NIXL 连接器,它将 prefill 之后的传输协调和设置从关键路径上移走。对于使用 vLLM 运行分离式 prefill/decode 推理的客户,这可以通过降低 TTFT 和 TPOT 来改善应用响应速度,尤其是在高请求速率下。
在我们基于通过 EFA 互连的 Amazon EC2 P5en 实例的 1P1D 部署基准测试中,对于 Qwen3-32B 模型,推送模式相比拉取模式实现了最高 3 倍的 TTFT 改善和最高 30% 的每输出 token 时间(TPOT)改善(参见 性能数据 节)针对 Qwen3-32B 模型;结果取决于工作负载和配置。
我们在通过 EFA 互连的 AWS Trainium 实例集群上构建并验证了该特性,随后将其作为一项加速器无关的特性贡献给了 vLLM。本文中的结果来自配备 EFA 的 AWS p5en(GPU)集群,表明这些收益同样适用于 GPU。本文将介绍推送式架构、传输流程、线程模型、性能结果以及如何复现基准测试。
Push-based KV transfer
架构概述
推送式传输在两个方面改善了 TTFT 和 decode 吞吐量:
- 它通过重叠生产者和消费者的工作,消除了拉取模型的串行化 。在生产者仍在计算 KV 的同时,decode 实例预先注册其目标块。一旦生产者的块就绪,传输便立即开始,而无需等待消费侧的标识符发现往返,从而将该往返从通往首个 token 的路径上移除。
- 它将传输设置时间从 decode 实例上移走 。该设置——准备 NIXL 描述符并提交传输——在 prefill 侧的后台线程上运行,因此 decode 实例不会在其延迟关键的 token 生成阶段耗费这些周期。
最终效果是 decode 实例上更低的 TTFT 和更高的输出 token 吞吐量。
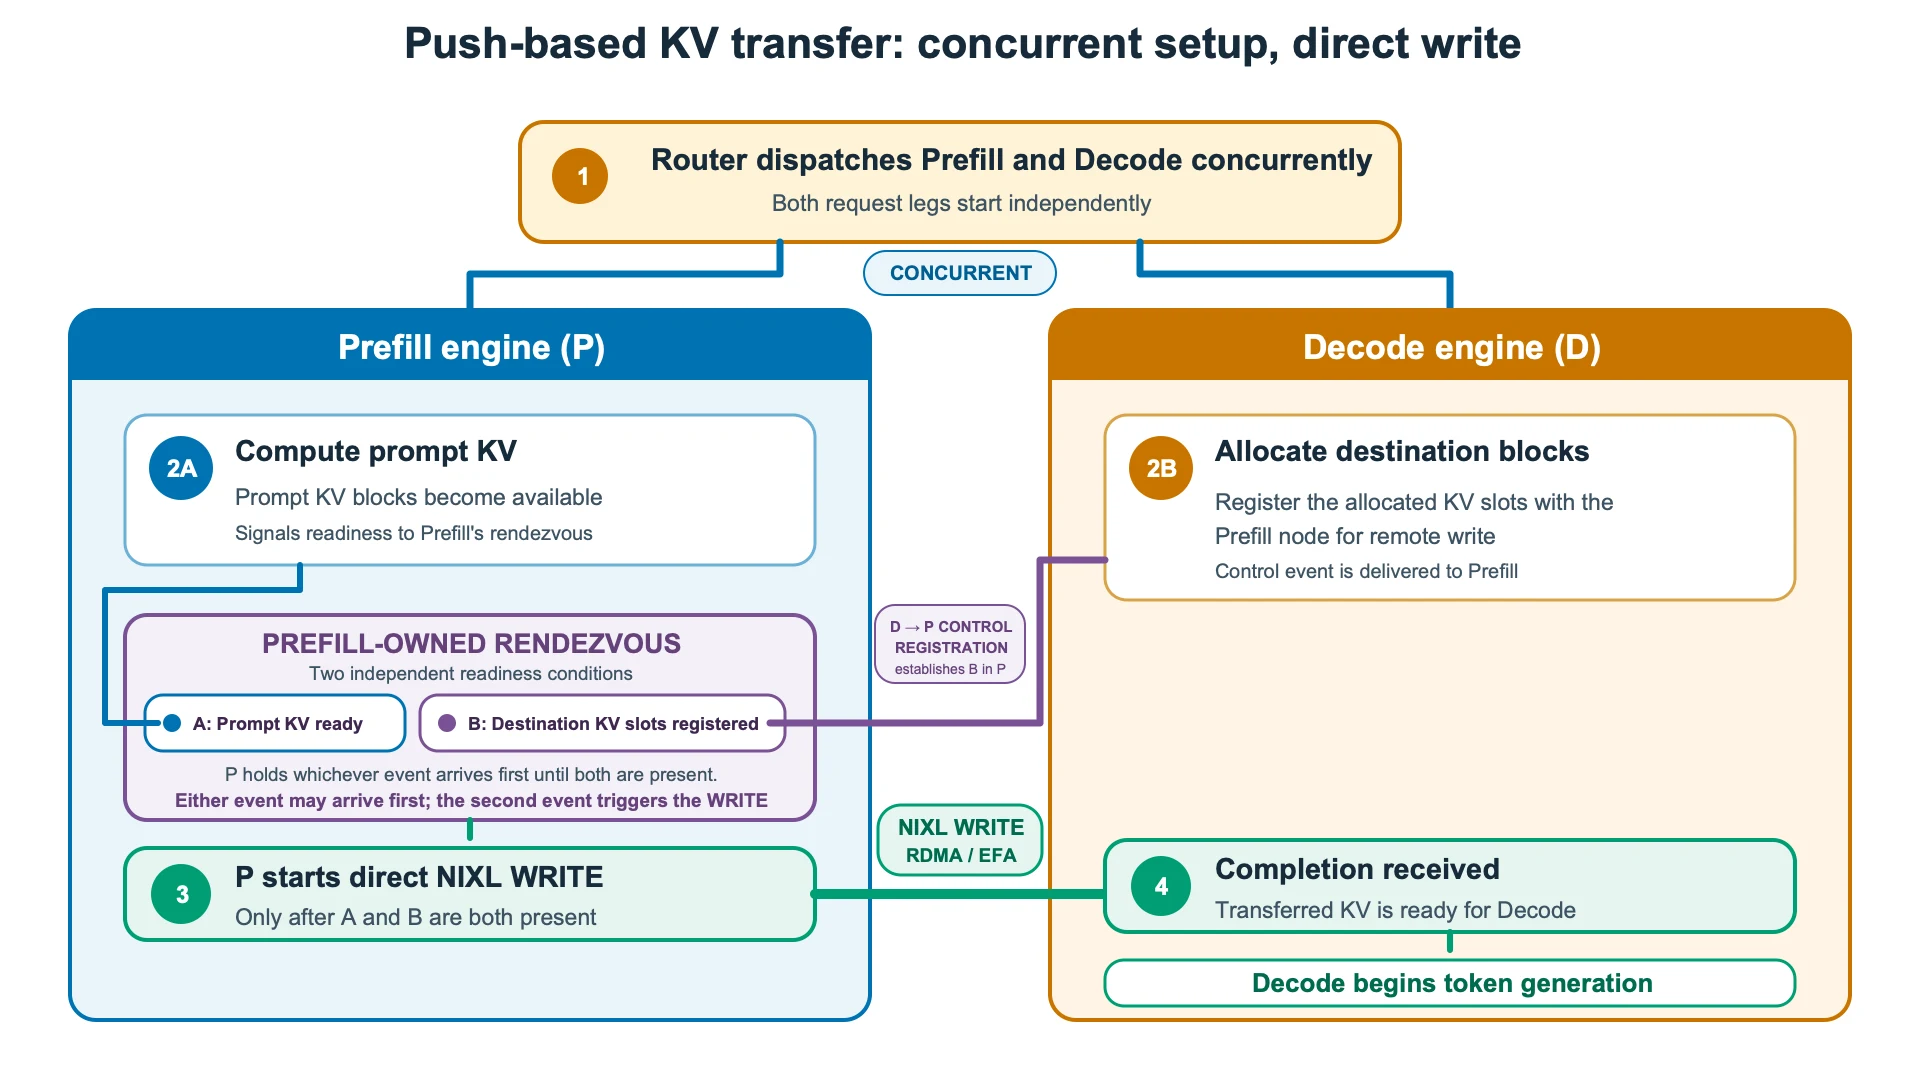
推送式连接器协调三个角色:预先注册其目标块的解码实例;匹配每个请求并发出传输的预填充实例;以及一个专用的后台线程,该线程将 KV 写入从引擎的前向传播循环中剥离出来。下面的图表展示了这些组件如何协同工作。
实现细节
该协议包含三个逻辑步骤。
1. 注册(解码侧)。 当解码实例为需要远程预填充的请求分配本地块时,它会准备一个注册信息,描述预填充实例应将 KV 写入何处:包括它自身的身份标识以及它刚刚预留的块位置。在同一个引擎步骤内,worker 将此注册信息作为 NIXL 通知发送给预填充实例。由于注册发生在分配时,连接器在预填充实例完成预填充之前就已经知道目标块。
2. 会合(预填充侧)。 来自解码器的注册信息和生产者上预填充的完成可能以任意顺序到达,连接器可以处理这两种情况。如果注册信息先到达,生产者会持有它,直到自身的预填充完成。如果预填充先完成,生产者会持有该请求的块,直到注册信息到达。后发生的那个事件会触发传输。连接器通过标识符配对请求,且匹配过程会考虑重新发出的请求,从而正确关联被抢占或重试的请求。
3. 传输(预填充侧)。 一旦请求被匹配,生产者就会与解码实例建立连接(如果尚不存在),并发出一个 NIXL WRITE,将 KV 块直接复制到解码器已注册的内存中,并寻址到每个目标张量并行 rank。生产者和消费者可能使用不同的内部块布局。每一方在传输时将块位置映射到自己的物理布局,从而允许双方使用不同的块大小。每个 WRITE 都携带一个完成通知,NIXL 会在数据到达后将其传递给解码实例。解码器会统计这些通知,每个向其写入数据的生产者 rank 产生一个通知,只有在所有预期的通知都已到达之后才认为 KV 已接收,此时请求才进入解码阶段。
线程模型
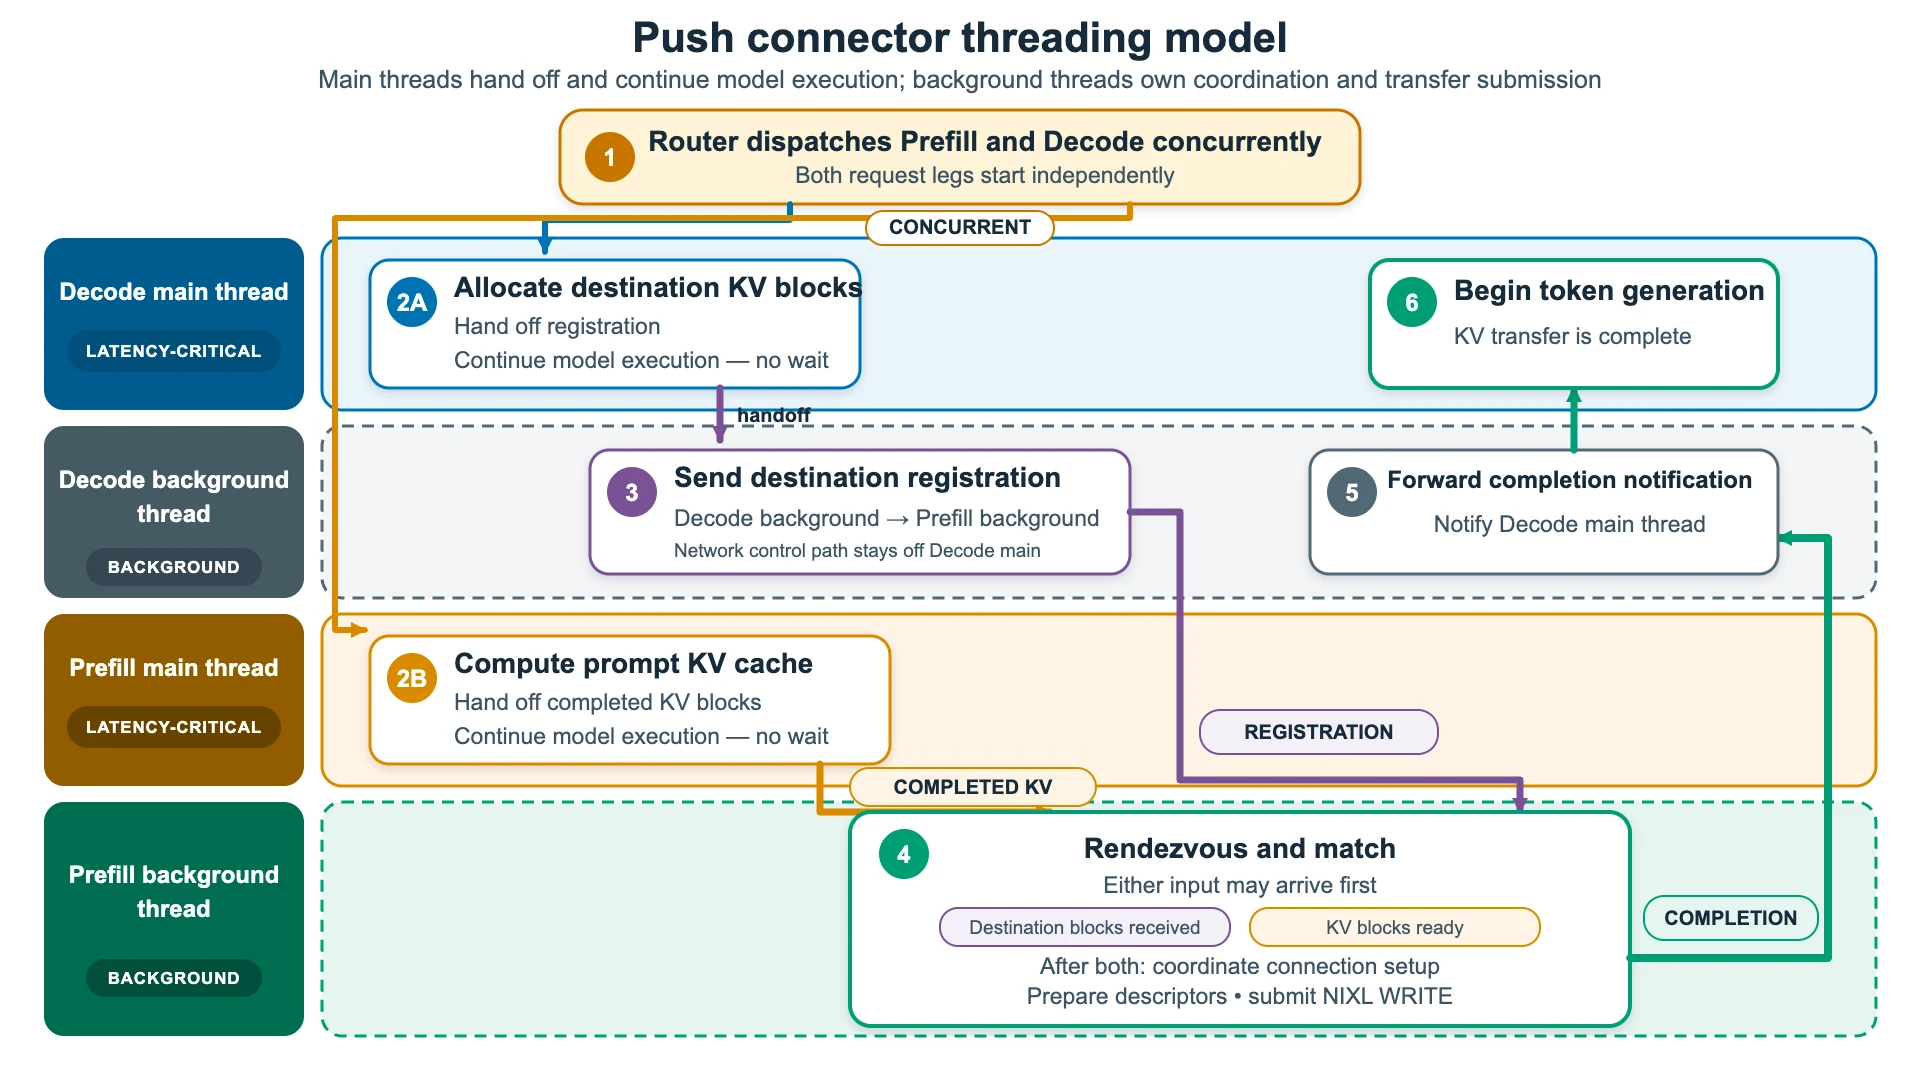
推送连接器通过在每个预填充 worker 上使用专用的后台传输线程,将模型执行与 KV 传输准备分离开来。在请求开始时,解码主循环分配其目标 KV 块并向预填充实例注册,同时预填充主循环计算提示词的 KV 缓存。在目标注册和提示词 KV 都就绪之后,预填充主循环将 KV 块交给后台线程,并迅速返回模型执行。
后台线程建立或复用 NIXL 连接,将请求的 KV 块 ID 映射为内存描述符,将连续的块合并为更大的传输区域,并将 NIXL WRITE 提交给解码实例。当 NIXL 完成传输后,它会向解码实例发送一个完成通知,解码实例随后开始生成 token。将描述符准备和传输提交从对延迟敏感的主循环中移出,可以防止这项针对每个请求的工作延迟模型执行。下图显示了单个请求在主循环和后台线程之间的这些交接过程。
时序对比:拉取 vs 推送
下图总结了前几节所述的拉取和推送传输流程,并突出显示了它们对 TTFT 的影响。尽管两种模式使用相同的 NIXL 和 EFA/RDMA 数据路径,但拉取模式在预填充之后执行元数据中继和解码侧设置,而推送模式将解码侧设置与预填充重叠进行。因此,推送模式将这些操作从预填充后的关键路径中移除,使解码能够更早开始。
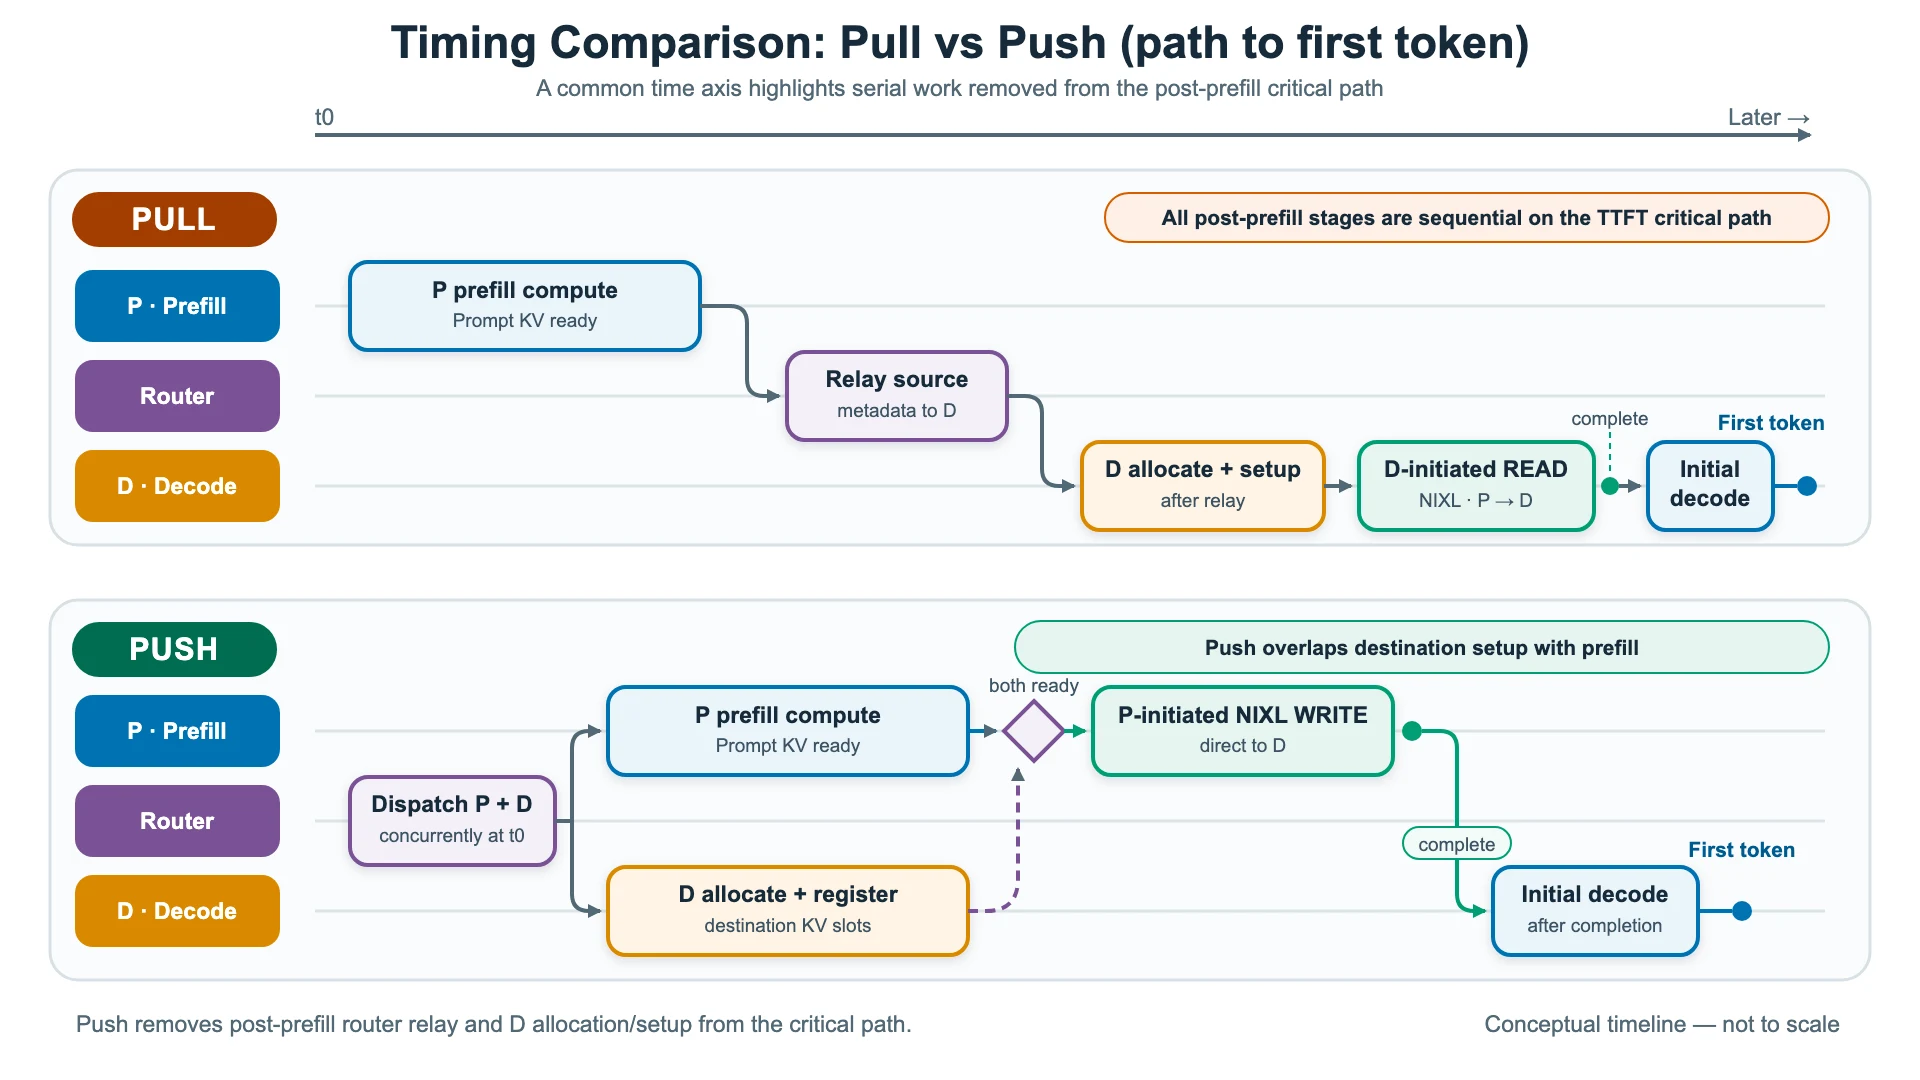
两种模式还涉及一个路由权衡。拉取模式允许路由器在预填充完成后再选择解码实例,这为负载感知路由和服务质量管理提供了更大的灵活性。推送模式更早选择解码实例,以便目标设置可以与预填充重叠。作为回报,在相近的负载下,预填充实例可以更早释放其 KV 块,因为只要提示词 KV 和目标注册都就绪,传输就会立即开始。
性能数据
为了进行评估,我们在使用 EFA 连接的 Amazon EC2 P5en 实例上的 1P1D 部署中使用了 Qwen3-32B 模型。为了隔离 P→D 传输性能,我们将基准测试配置为禁用前缀缓存,使用 --no-enable-prefix-caching。这种配置使解码节点为每个请求从预填充节点检索完整的 KV 缓存。否则,重叠的提示词可能会复用解码节点的本地缓存并绕过传输,从而产生误导性的比较结果。
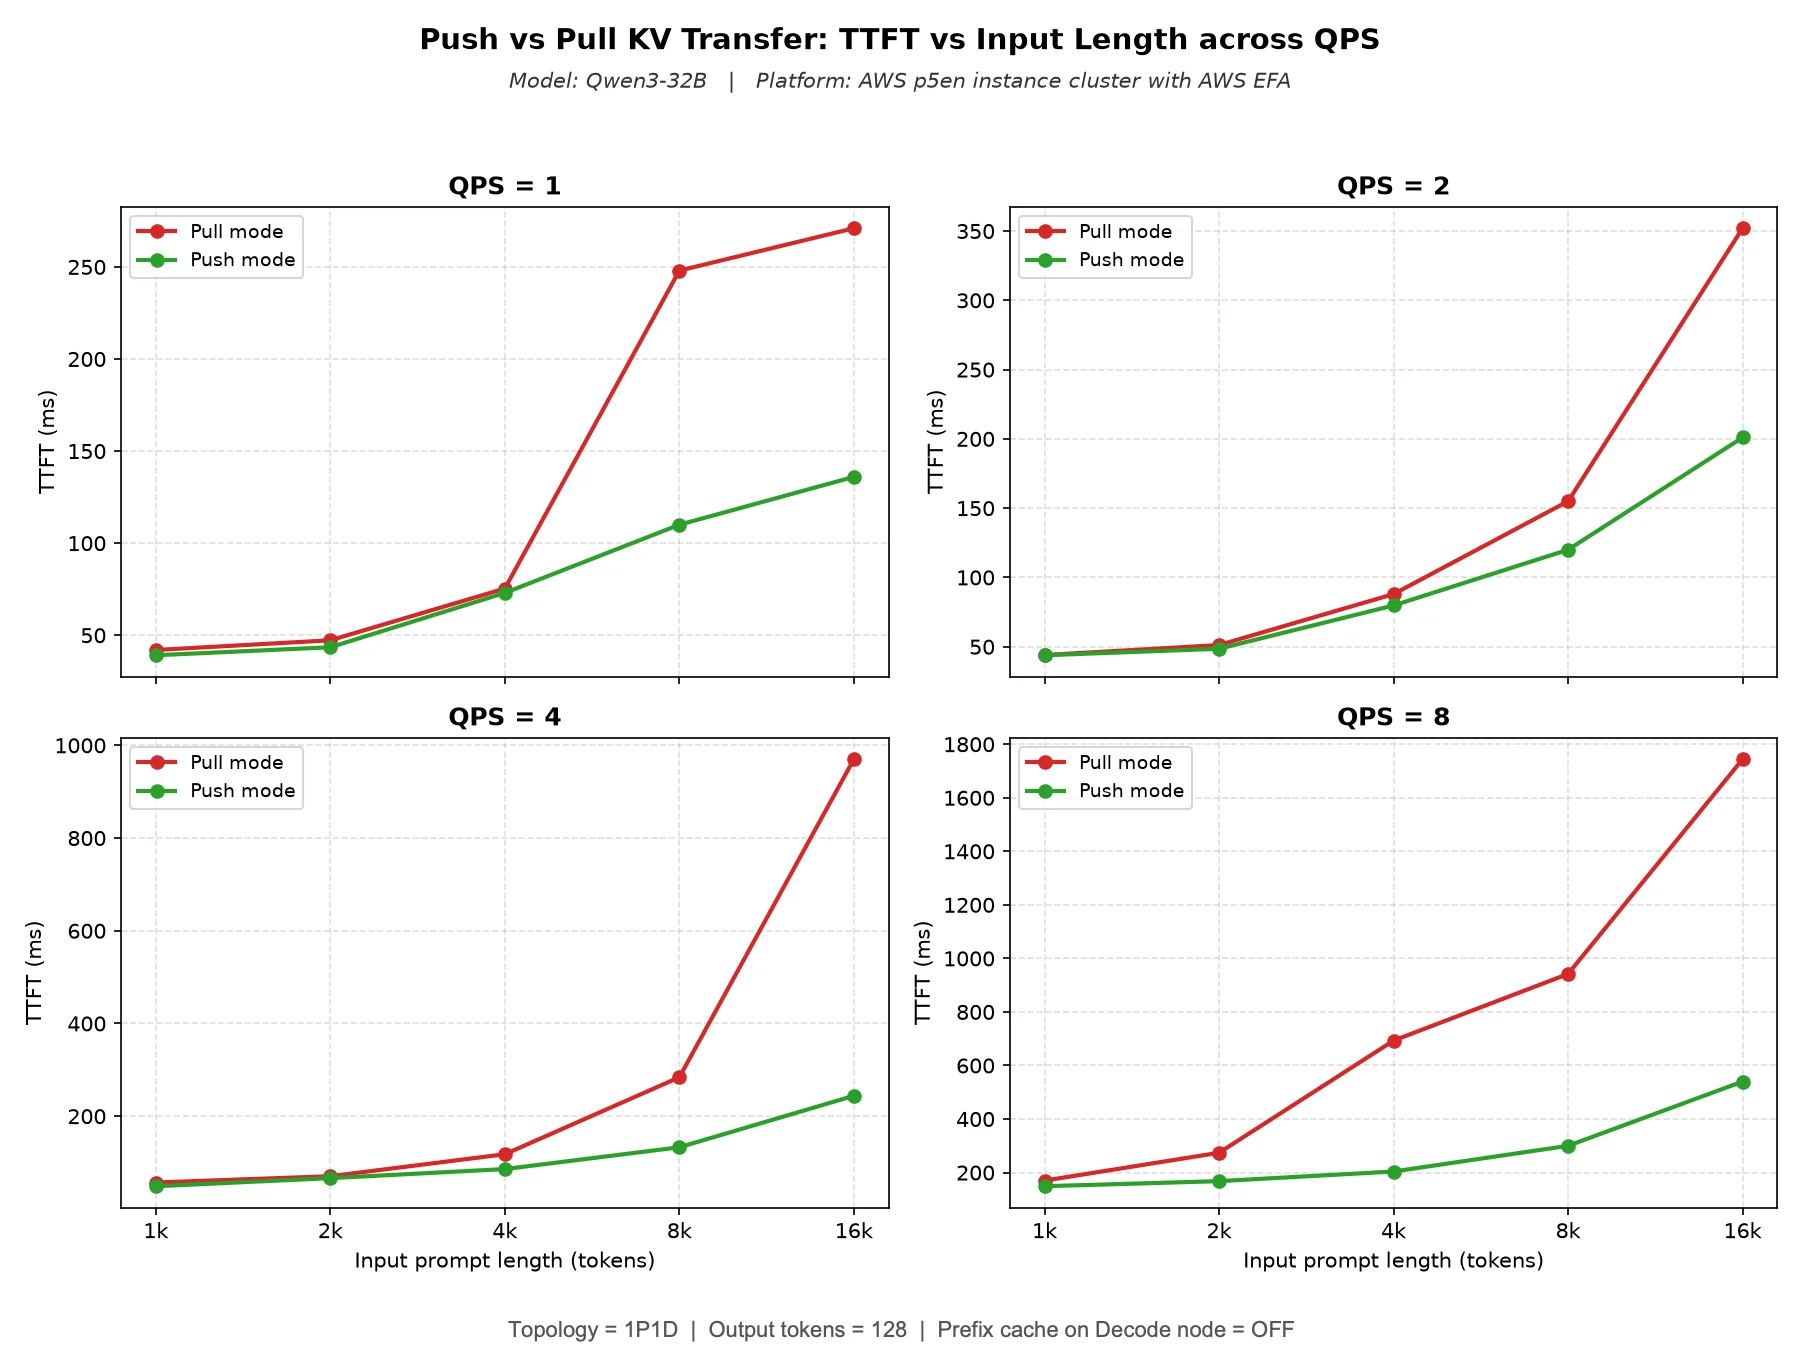
下图比较了推送和拉取 KV 传输的 TTFT。我们遍历 1k–16k 的输入长度和 1–8 QPS 的请求速率。在低负载和短提示词的情况下,两种模式的表现几乎相同。随着 QPS 和输入长度的增长,拉取模式急剧退化,在 8 QPS 和 16k 时达到约 1,744 毫秒。推送模式保持在低得多的水平,约为 540 毫秒,大约降低了 3 倍。差距的出现是因为拉取模式在解码 worker 上内联提交 NIXL 描述符,在其引擎循环内同步执行,从而阻塞了 token 生成。推送模式将这项工作移到后台线程,脱离了关键路径。
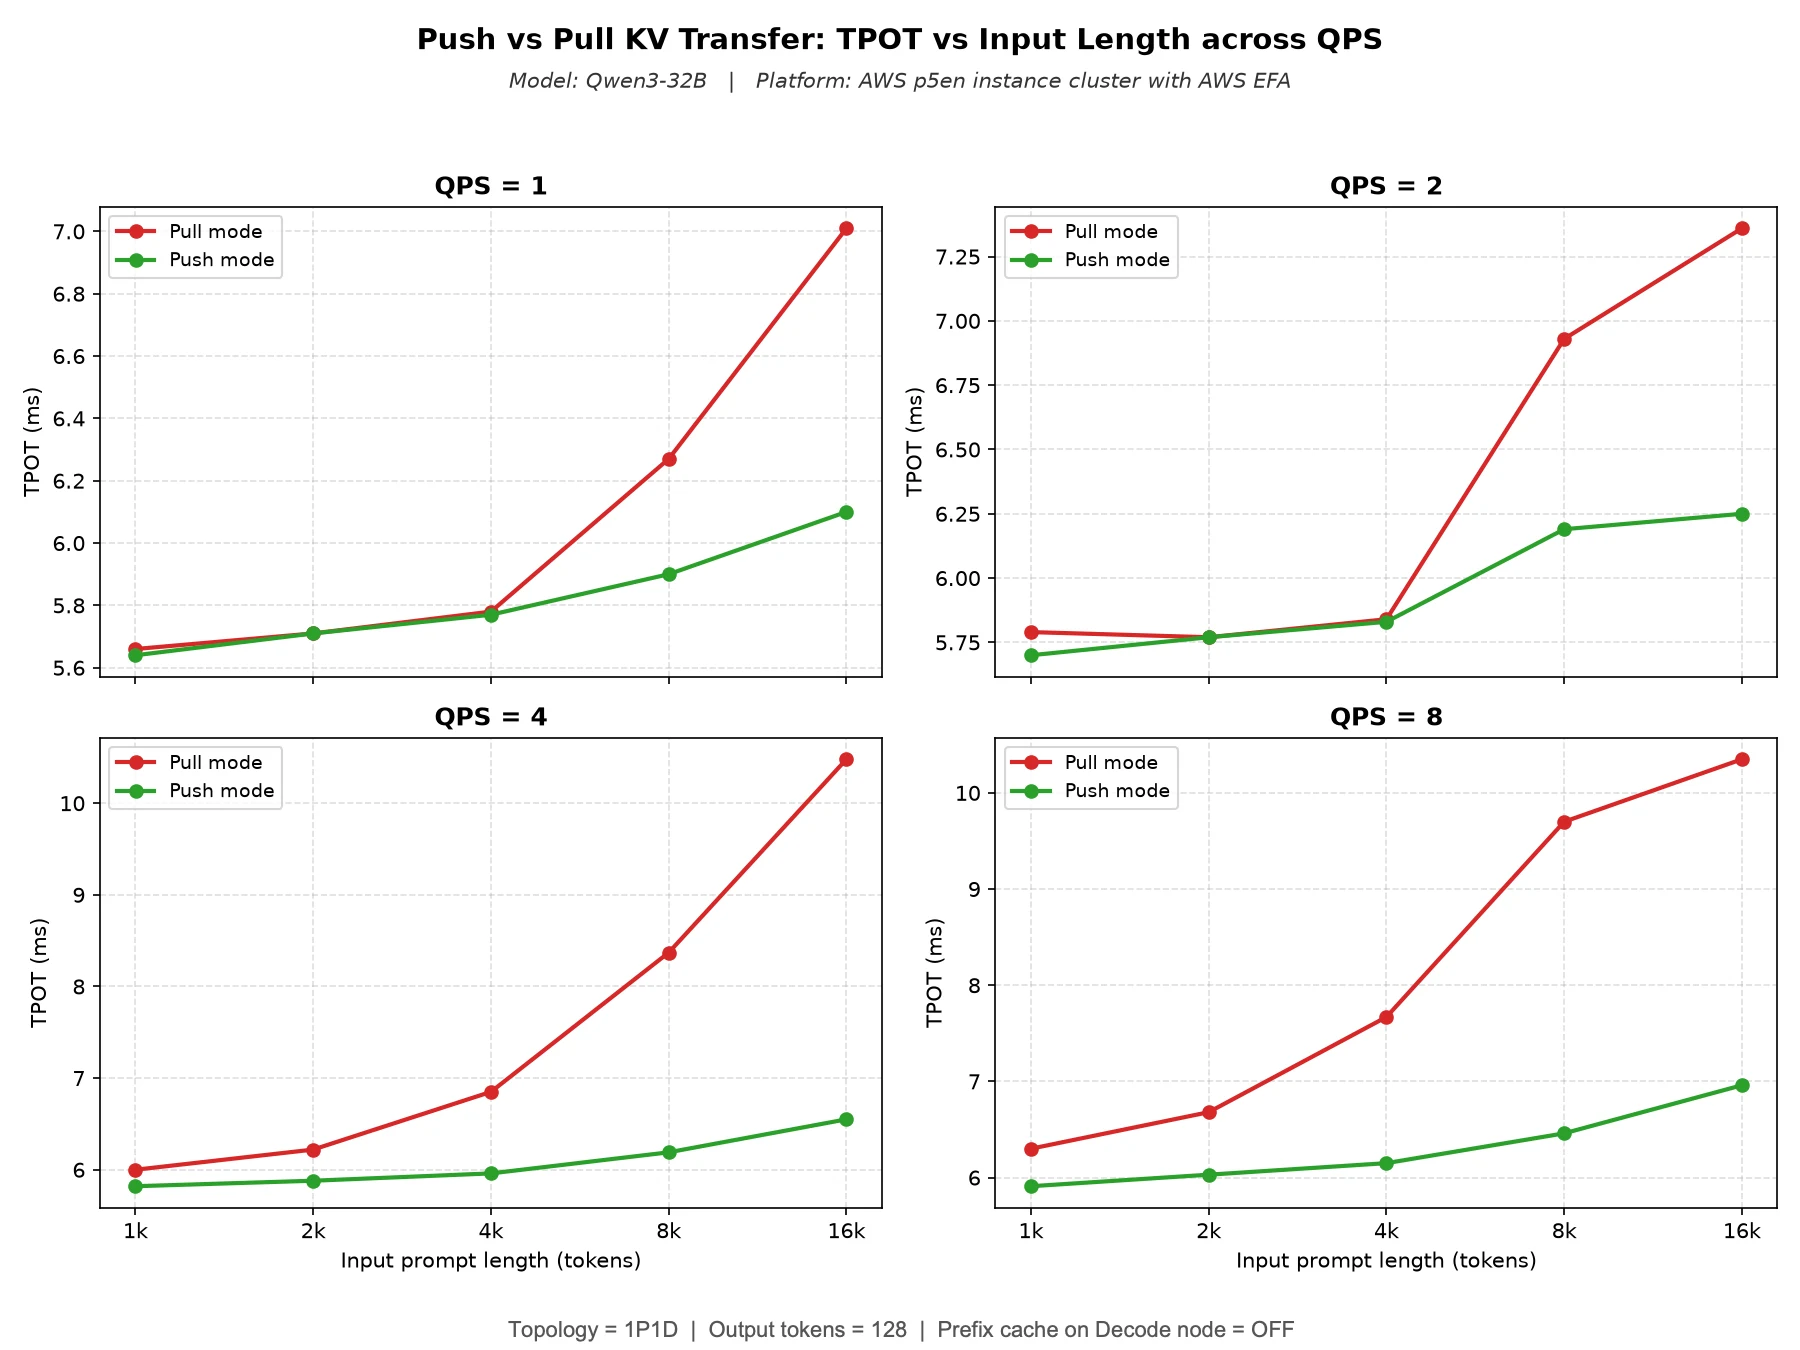
此图表展示了相同条件下的 TPOT。其模式与 TTFT 一致。在轻负载下,push 和 pull 接近,约为 5.6–5.8 ms。随着负载和输入长度的增加,pull 在 4–8 QPS 和 16k 时攀升至约 10.4 ms,而 push 保持在 7 ms 左右。原因是 push 将描述符准备和传输提交从 decode worker 中卸载出去。token 生成永远不会被饿死,因此即使在高并发和长上下文的情况下,每个 token 的延迟也保持平稳。
如何运行基准测试
要使用通过 EFA 连接的 Amazon EC2 P5en 实例来复现我们的 1P1D 基准测试配置(一个 prefill 节点和一个 decode 节点),请参阅“ 复现我们的结果 ”指南中的详细说明。该指南涵盖环境设置、启动 vLLM prefill 和 decode 服务器、运行基准测试以及收集结果。该功能可以在其他受支持的配置上运行,但性能结果会因硬件、模型、工作负载和网络配置而异。
结论
在这篇文章中,我们展示了基于 push 的 KV 连接器如何将 prefill 计算与 decode 端的块分配和注册重叠进行,从而将 prefill 后的路由器往返和 decode 端的传输设置从关键路径中移除。这降低了 TTFT 和 TPOT,尤其在高请求速率下。在我们使用通过 EFA 连接的 Amazon EC2 P5en 实例的 1P1D 部署上的 Qwen3-32B 基准测试中,与 pull 模式相比,push 模式将 TTFT 提升了高达 3 倍,将 TPOT 提升了 30%。结果因工作负载和配置而异。要使用 push 模式,请将 prefill 和 decode 服务器均配置为使用 NixlPushConnector 而不是 NixlConnector.
。当可以接受提前选择 decode 节点且较低 TTFT 是优先事项时,请选择基于 push 的连接器。对于需要双向 KV 传输或将 decode 实例选择延迟到 prefill 之后以进行负载感知路由的工作负载,基于 pull 的连接器仍然是更好的选择。vLLM 同时支持基于 push 和 pull 的 KV 连接器,允许用户选择最适合其部署的方式。
作为未来的改进方向,我们正在探索将后台 NIXL 线程模型引入 pull 模式连接器,将 NIXL 设置移出关键路径,从而使 pull 模式工作负载也能受益于相同的优化;我们已打开一个 pull request(#45211)来探索这一点。
相关资源
致谢
我们感谢 vLLM 社区对维护此功能的支持。
附录:复现我们的结果
该拓扑为两个 p5en GPU 节点(prefill 位于 :8100, decode 位于 :8200),均启用 EFA,外加一个运行代理和基准测试客户端的较小的第三个节点。三个脚本随本文一起提供: serve_pd.sh 以任一模式启动任一节点, run_sweep.sh 驱动扫描, cleanup.sh 进行全部清理。 plot_push_vs_pull.py 根据结果 JSON 重新绘制上述两张图。
测试环境
两个 GPU 节点的配置完全相同:
| 实例类型 | p5en.48xlarge (8x NVIDIA H200),一个用于 prefill,一个用于 decode |
| 区域 / 可用区 | ap-south-1 (孟买), ap-south-1b (可用区 ID aps1-az3),同一可用区中的两个节点 |
| 放置策略 | 无集群放置组;两个实例均启动到定向的按需容量预留中,默认租户 |
| AMI | 面向 Ubuntu 24.04 x86_64 的公有 AWS ParallelCluster 3.14.2 镜像, aws-parallelcluster-3.14.2-ubuntu-2404-lts-hvm-x86_64-202602121713 (ami-0133f195033a4baae 位于 ap-south-1;AMI ID 因区域而异)。该镜像附带内核 6.14.0-1018-aws、NVIDIA 驱动 570 和 CUDA 12.8,因此需要将驱动、CUDA 工具包和 EFA 安装程序升级到下述版本。 |
| 操作系统 / 内核 | Ubuntu 24.04.4 LTS, 6.14.0-1018-aws |
| NVIDIA 驱动 / CUDA | 驱动 580.126.16 (CUDA 13.0 驱动 API);CUDA 工具包 13.0 |
| EFA 接口 | 每个实例 16 个,每张网卡一个(网卡 0-15,所有接口类型均为 efa),每个 200 Gb/s,总计 3.2 Tb/s。8 个接口位于每个 NUMA 节点上,每个 GPU 通过 PCIe 交换机与其中 2 个共享。 |
| EFA 软件 | EFA 安装程序 1.50.0、EFA 内核模块 3.3.0g、libfabric 2.6.0amzn1.0、rdma-core 64.0amzn0 |
NIXL 的 EFA 设备选择。 LIBFABRIC 后端将全部 16 个 EFA 设备作为 rail 打开,使用 efa provider。随后它仅在共享该 GPU PCIe 交换机的 2 条 rail 上注册每个 GPU 的 KV cache,因此每次传输都保持在 PCIe 本地。没有设置任何 NIXL 或 libfabric 设备覆盖项;这是默认选择。要在你自己的节点上确认这一点,请使用以下参数启动服务器 NIXL_LOG_LEVEL=DEBUG 并检查注册行:
grep -E "Created rail [0-9]+ \(device=|mapped to rail" server.log1. 准备节点
在两个 GPU 节点上安装 EFA 用户态软件栈,并确认 provider 存在。我们使用的是安装程序 1.50.0:
curl -O https://efa-installer.amazonaws.com/aws-efa-installer-1.50.0.tar.gz
tar -xf aws-efa-installer-1.50.0.tar.gz && cd aws-efa-installer
sudo ./efa_installer.sh -y
fi_info --version         # libfabric 2.6.0amzn1.0
fi_info -p efa            # verify the EFA provider is present
两个 GPU 节点必须能在 8100/8200 上以及在 NIXL 侧信道(5600).
2. 安装 vLLM 和 NIXL
在两个 GPU 节点上:
python3.12 -m venv ~/vllm_env && source ~/vllm_env/bin/activate
pip install --upgrade pip
pip install vllm==0.29.0      # any build that includes the NIXL push connector
pip install nixl==1.4.1       # NIXL with the libfabric/EFA backend
在代理节点上(无需 GPU 运行时):
pip install vllm aiohttp fastapi uvicorn pandas datasets3. 下载模型
export HF_HOME=/shared/huggingface     # a large shared volume
hf download Qwen/Qwen3-32B
4. 启动 P/D 对
在每个 GPU 节点上运行 serve_pd.sh 一次。两种模式之间唯一的区别是 kv_connector: NixlConnector 表示 pull, NixlPushConnector 表示 push。端口、engine ID、角色和 rank 保持不变。
# on the prefill node
PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> ROLE=prefill MODE=pull ./serve_pd.sh
# on the decode node
PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> ROLE=decode  MODE=pull ./serve_pd.sh
在 prefill 一侧展开后为:
vllm serve Qwen/Qwen3-32B --served-model-name Qwen --dtype bfloat16 \
  --tensor-parallel-size 8 --max-model-len 32768 --max-num-seqs 8 --port 8100 \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_buffer_device":"cuda",
    "kv_role":"kv_producer","engine_id":"prefill-engine-001","kv_rank":0,
    "kv_parallel_size":2,"kv_connector_extra_config":{"backends":["LIBFABRIC"]}}'
decode 服务器额外添加了 --no-enable-prefix-caching,这会强制每个请求从 prefill 获取完整 KV——这正是我们要测量的内容。如果开启缓存,重叠的提示词可能会命中 decode 节点的本地缓存并跳过 P->D 传输,从而产生误导性的数字。在运行基准测试之前,请等待两个 /health 端点都返回 200。
5. 运行扫描
基准测试脚本位于 #57567;它会选择与该模式匹配的代理(disagg_proxy_demo.py 表示 pull, disagg_proxy_pushconnector_demo.py 表示 push),并使用 vllm bench serve.
git clone https://github.com/vllm-project/vllm.git ~/vllm && cd ~/vllm
git fetch origin pull/57567/head:pd-bench && git checkout pd-bench
export VLLM_SRC=~/vllm

VLLM_SRC=~/vllm PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> \
  MODE=pull ./run_sweep.sh
进行驱动。然后停止两台服务器,使用步骤 4 重新启动 MODE=push 在每个节点上,然后使用重新运行扫描 MODE=push。此外,推模式还需要预填充实例的 NIXL 坐标(PREFILL_ENGINE_ID, PREFILL_KV_HOST, PREFILL_SIDE_CHANNEL_PORT, PREFILL_TP_SIZE, PREFILL_PP_SIZE) 以便代理能告诉解码节点该在哪里注册; run_sweep.sh 使用上面所用的默认值填充这些内容。Keep QPS_LIST, INPUT_LENS以及 OUTPUT_LENS 在两次运行中保持一致,并确保 PREFILL_TP_SIZE 与 prefill 服务器实际的张量并行大小相匹配。
results/ 持有 <mode>_qps<q>_in<in>_out<out>_iter<i>.json (加上 .log)以及每次运行的 TTFT、ITL、吞吐量和端到端延迟。要重绘图表:
python plot_push_vs_pull.py --results-dir ./results --metric ttft
python plot_push_vs_pull.py --results-dir ./results --metric tpot
故障排除
- 服务器在处理第一个请求后立即崩溃 ——模式与连接器不匹配。Pull 需要
NixlConnector; push 需要NixlPushConnector,在 P 和 D 两者上。 Backend 404: model ... does not exist—SERVED_MODEL_NAME与服务器的--served-model-name(Qwen).- 代理就绪超时 —确认所选模式的代理配置存在于以下路径之下
$VLLM_SRC/examples/disaggregated/disaggregated_serving/,且P和D双方/healthreturn 200. - NIXL 握手或传输错误 — 验证 EFA(
fi_info -p efa),该侧信道端口(5600)在 P 和 D 之间开放,并且PREFILL_TP_SIZE与预填充服务器的张量并行大小匹配。
清理
./cleanup.sh proxy      # on the proxy / benchmark driver node
./cleanup.sh server     # on each GPU node
然后按照 AWS EC2 用户指南终止实例。