
决策模型在知识和推理任务上的校准很差。在几乎所有所选答案的概率水平上,所有决策模型的准确率都低于该概率。这一差距在 AA-Omniscience-Decision 和 HLE-MultiChoice 上最大,而大多数模型在 WildGuardTest(分类)和 When2Call(工具调用)上校准相对较好。
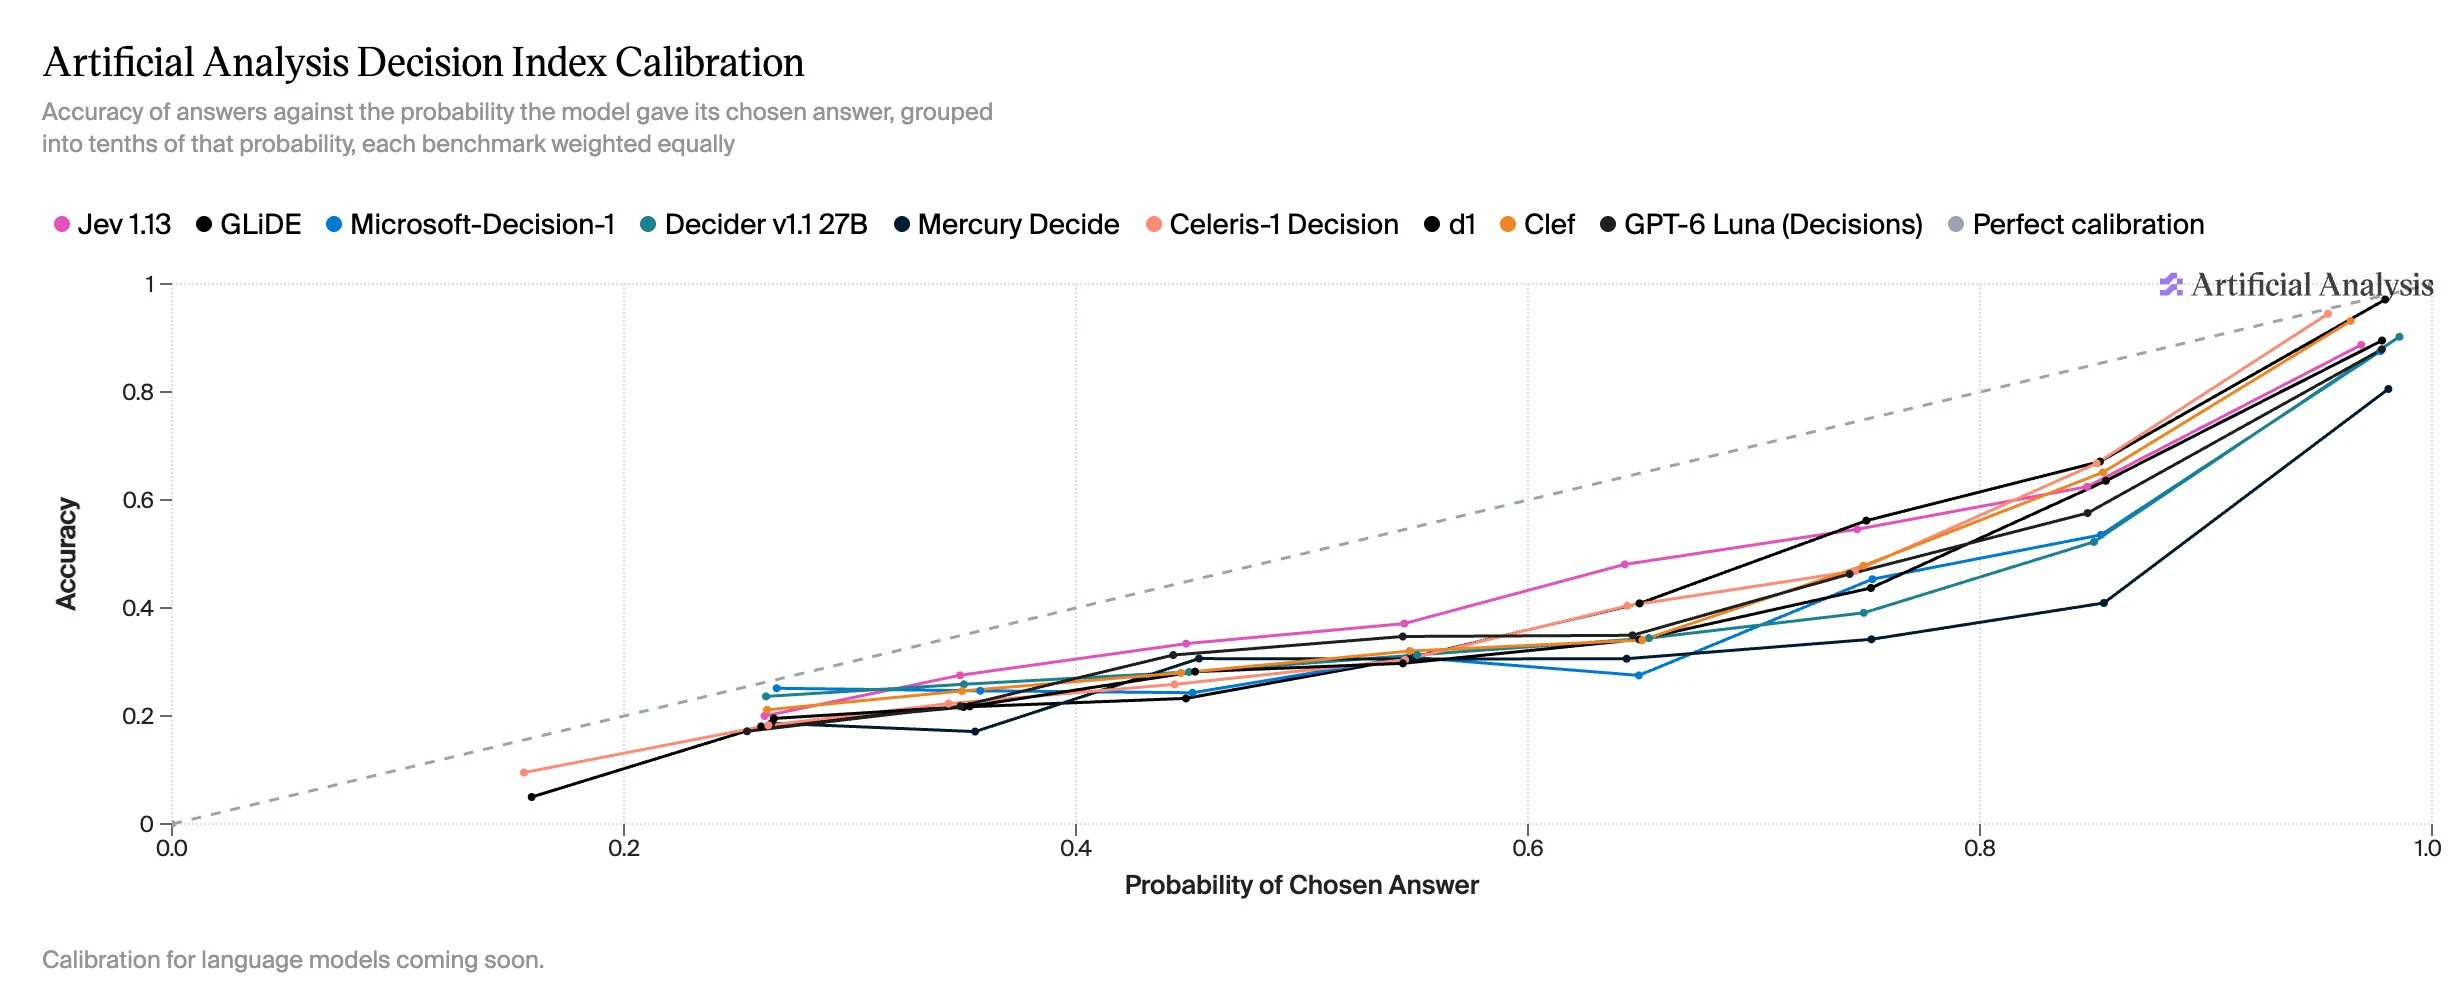
Artificial Analysis的分析称,决策模型在知识与推理任务上校准不佳:几乎所有概率水平下,所选答案的实际准确率都低于其自报概率,在AA-Omniscience-Decision和HLE-MultiChoice上差距最大,而多数模型在WildGuardTest分类与When2Call工具调用任务上相对校准良好。
决策模型在知识和推理任务上的校准很差。在几乎所有所选答案的概率水平上,所有决策模型的准确率都低于该概率。这一差距在 AA-Omniscience-Decision 和 HLE-MultiChoice 上最大,而大多数模型在 WildGuardTest(分类)和 When2Call(工具调用)上校准相对较好。
原始发布及相关权利归来源方。
机器翻译 · 请以原文为准