
要点概览
- 当长期运行的智能体积累的上下文超过模型所能容纳的量时,就会发生“上下文衰减”,导致准确率下降。
- Deep Agents 是 LangChain 的开源智能体框架,它使用五种技术来转移上下文 out 活动窗口(不删除它)以防止上下文腐化。
- Deep Agents 中智能体的记忆以纯文件形式存储在您控制的存储中,因此您可以在保留其所学全部内容的同时切换模型或提供商。
如果你曾在考试前一夜突击复习,你一定熟悉这种感觉:越学越发现前面的章节开始模糊。
智能体也有同样的问题。当它们承担更长的任务时,它们会接收越来越多的信息(指令、工具结果、文件等);最终这些信息变得远远超负荷。 context 以便舒适地容纳一个模特的 上下文窗口。模型承载的历史、噪音和工具输出越多,其准确性和推理能力往往就越差。
在智能体工程领域,我们称之为 上下文腐化。本博客介绍了管理智能体上下文窗口的各种技术,以及 Deep Agents 框架如何使用一种称为中间件(middleware)的概念,将这些技术注入到智能体的运行过程中。
理解上下文工程技术
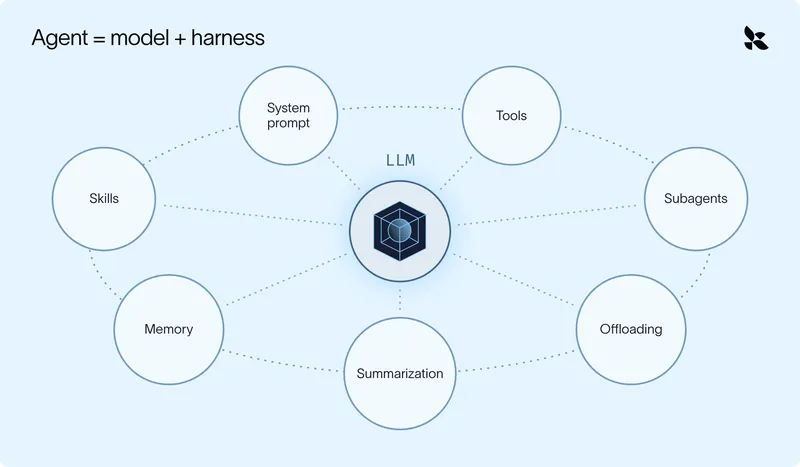
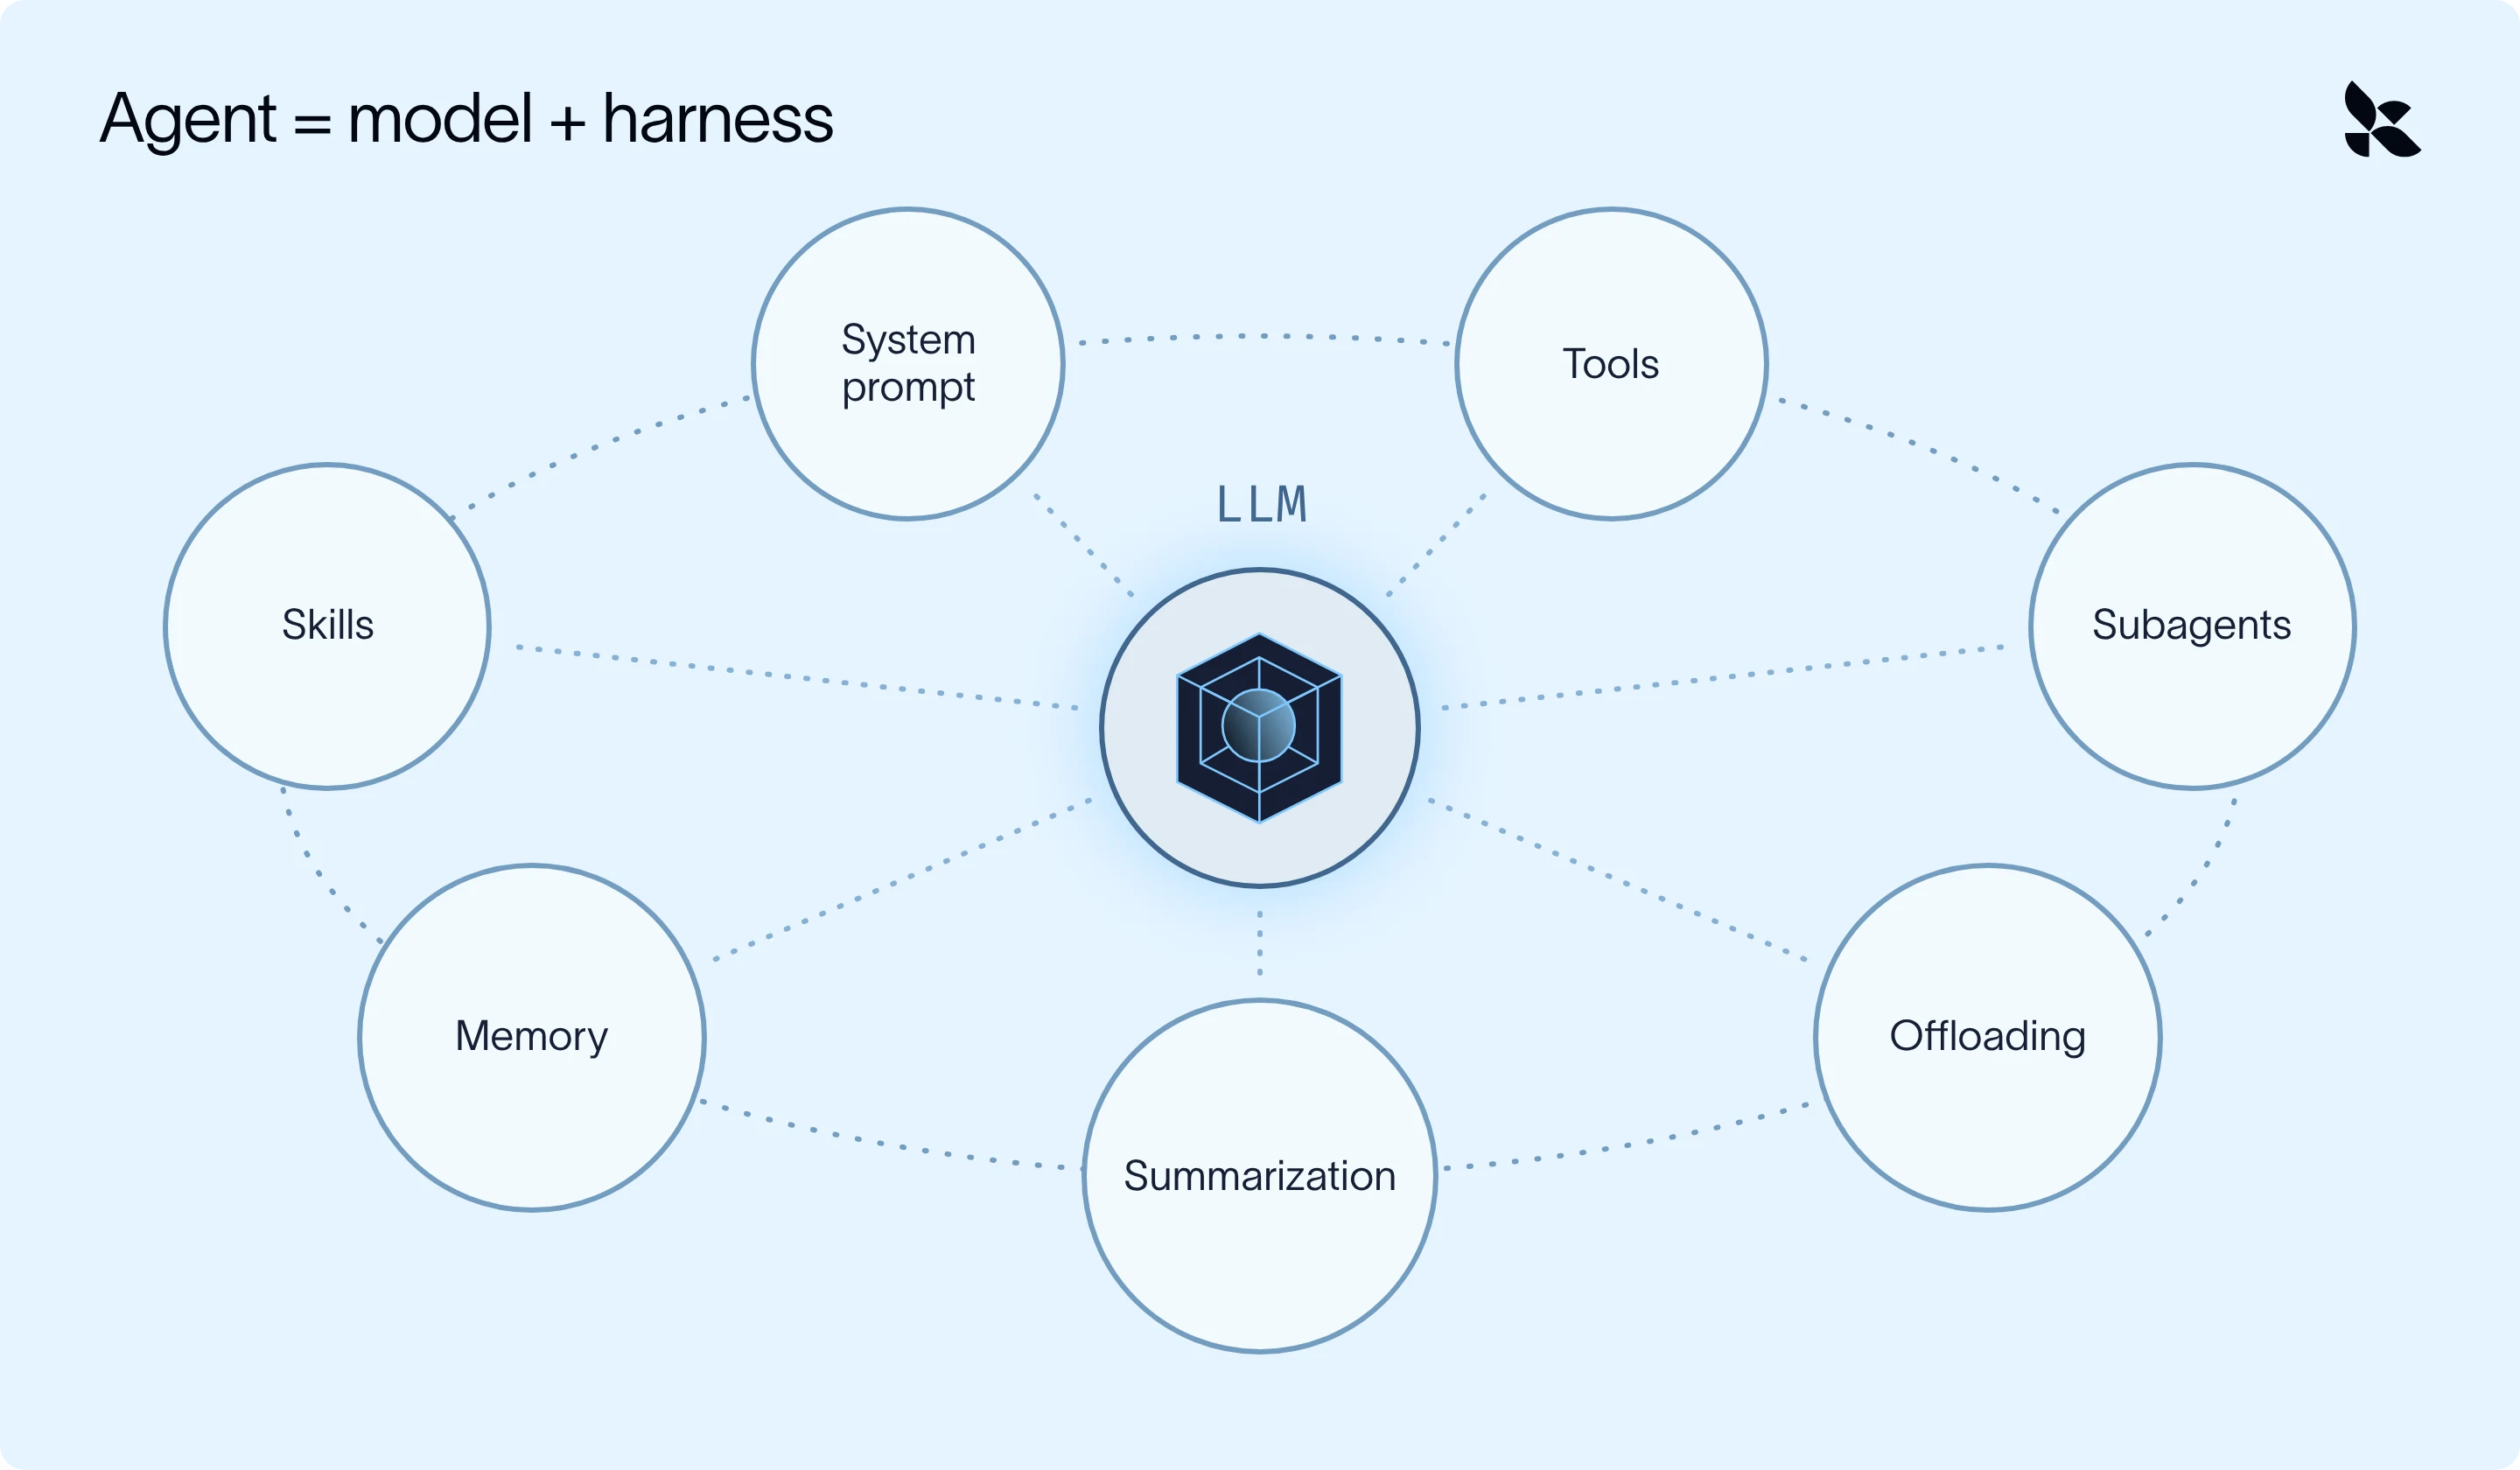
简单来说,智能体就是一个被框架(harness)包裹着的模型。
智能体可用来应对上下文腐化的上下文工程技术主要分为两类:
- 防止不必要的信息 进入 上下文窗口
- 管理和过滤 已经存在于 上下文窗口中的内容
框架会战略性地运用这些方法,为给定任务让模型 在恰当的时机获得恰当的上下文 。
现在要构建一个在这方面做得 很好的框架 说起来容易做起来难,而且需要大量工作(如果你是那种考前一晚才临时抱佛脚的人,那可能工作量太大了)。
Deep Agents 是 LangChain 的开源 harness。它将你选择的模型与一些把上下文从活动窗口移 出 的技术结合(移入文件、摘要或独立的 agent),这样主 agent 只携带所需内容(并且以后需要时可以恢复原始数据):
- 卸载(Offloading): 大型工具结果和用户消息被保存到文件系统,模型只看到预览。
- 摘要化(Summarization): 当对话接近上下文限制时,较旧的消息被压缩成摘要。
- 技能(Skills): 任务知识只在模型判断其相关时才加载。
- 子代理(Subagents): 嘈杂的工作在单独的上下文窗口中运行,只有结果被传回。
- 长期记忆(Long-term memory): agent 学到的东西被保存到一个文件中,并延续到下一次对话。
将上下文工程应用于常见用例
让我们看看上述技术如何应用于一个真实世界的用例:一个竞争分析 agent。每周一,该 agent 研究五家竞争对手,并按照团队的模板撰写报告。单次运行大致如下:
- 拉取 Company A 的市场数据导出(数万行)
- 搜索新闻,阅读几篇文章,并做笔记
- 对 Company B 到 E 重复上述步骤
- 起草报告,根据你的反馈进行修改,并排版
到第 4 步时,该 agent 在每次模型调用中都携带了五份原始导出、数十个搜索结果和两份过时的草稿。其中大部分对于最终报告的排版是无关的。
检索方法(RAG或文件系统搜索)帮助 agent 拉取 仅 它所需的内容,但这只解决了问题的一半。即使是精准的 agent 也会积累不必要的消息、工具结果和中间工作,因此 harness 还必须管理已存在于上下文窗口内外的事物。
如何实现这些技术:中间件
代理以循环方式运行:模型决定要做什么,调用工具,读取结果,然后重复这一过程直到任务完成。 中间件 是插入该循环中特定节点的代码:例如在代理启动之前、每次模型调用前后,或每次工具调用前后。
- 在每个节点上,它都可以读取上下文并在下一步运行之前对其进行修改。
- 本文中的每一种上下文工程技术都是挂接到上述某个节点的中间件。
- 其中大部分是内置的,因此使用这些技术无需编写任何中间件(除非你想定制某些特定内容)。
卸载:把内容移出上下文窗口
我们的代理并不总是需要看到 全部 每次工具调用或人类消息返回的数据,尤其当数据量很大时。
例如,每次 pull_market_report 工具调用都会返回一份完整的数据导出(数千行);然而,代理只需要其中的几个数字,因此可以限制模型只查看这些行。
FilesystemMiddleware 在每次工具被调用时运行:
- 当工具结果超过大约 20,000 个 token 时,完整结果会在进入对话之前被写入 /large_tool_results/{tool_call_id}。
- 模型只会看到一个简短的预览(开头和结尾的几行)以及文件路径。
- 当代理之后需要公司 B 的季度营收时,它会使用 read_file 逐页读取该文件。
过长的用户/人类消息,例如粘贴进来的通话记录,会在更高的阈值(50,000 个 token)下接受相同的处理,并保存到 /conversation_history/。
摘要:压缩已有的内容
尽管我们尽力卸载冗长的工具调用结果,但在长时间运行中,上下文仍会逐渐累积(例如五家公司的搜索、笔记和草稿)。摘要可用于将代理的整个上下文窗口压缩为迄今为止所发生事件的总结,使其能够继续执行研究任务。
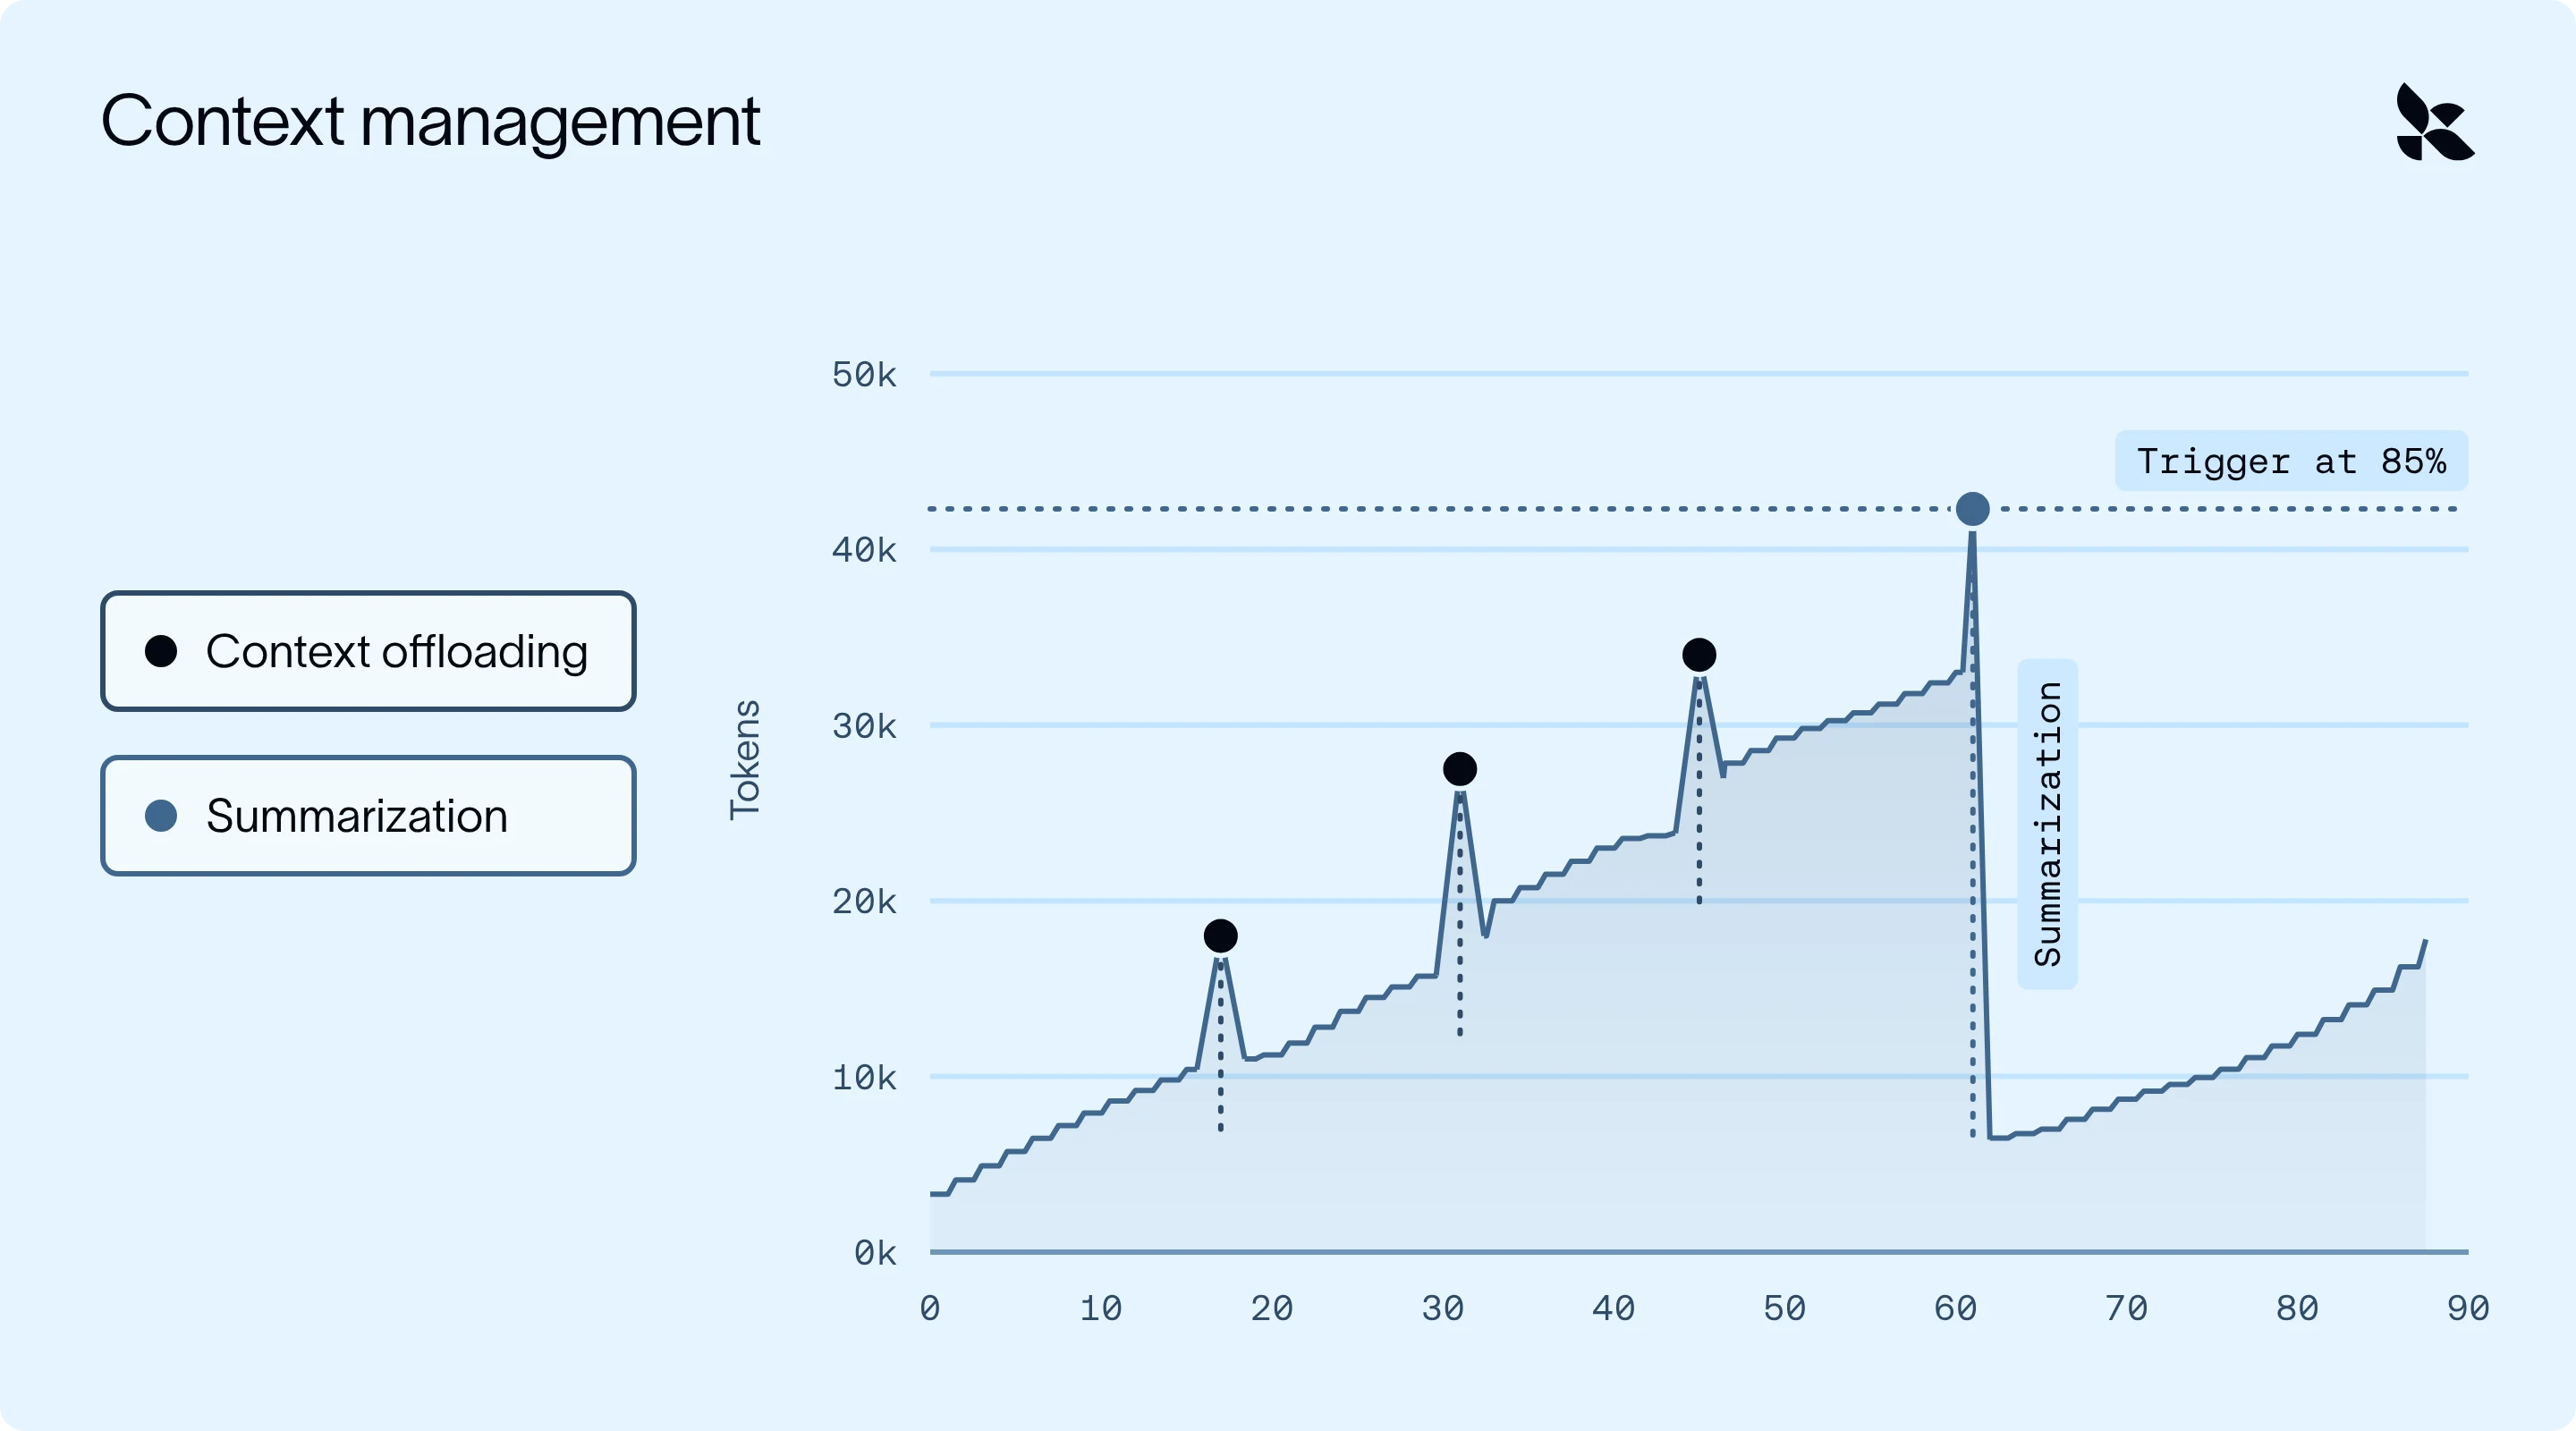
- 高峰指的是到来的大型工具结果/人类消息;卸载在模型看到它们之前将每一条替换为简短的预览,因此上下文只会增加一点点。
- 摘要则处理缓慢的攀升:一旦使用率达到 85%,较旧的消息会被压缩成一份摘要,上下文随之回落。
SummarizationMiddleware 在每次模型调用前检查 token 使用量:
- 一旦使用量越过阈值(默认为模型上下文窗口的 85%),一次单独的 LLM 调用会将较旧的消息压缩成单一摘要
- 较旧的消息会从上下文窗口中移除,而最近的消息则逐字保留。
- 模型现在首先看到摘要,然后是最近的消息(因此近期内容不会被改写)。
两个重要细节:
- 它是可恢复的。 被摘要的消息会写入 /conversation_history/{session_id}.md。如果代理在起草时需要公司 A 研究中的某个细节,它可以将其读回。
- 它会循环进行。 随着运行继续,使用量会再次攀升,下一次摘要会包含上一次的摘要。
你也可以在话题发生变化时进行摘要, 而不是只在某个 token 阈值才生效。自定义摘要提示词会很有帮助。
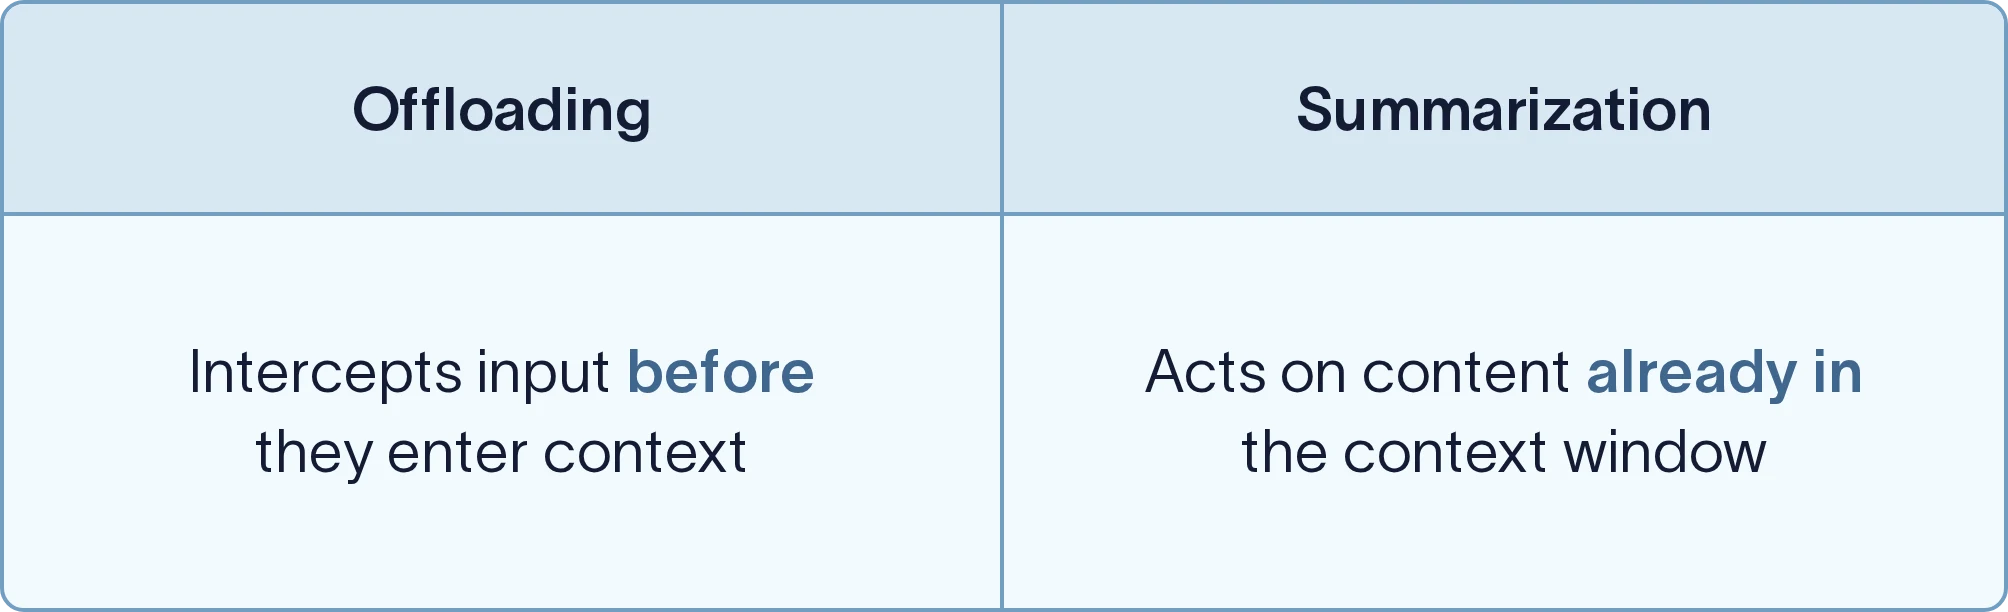
我们关于 Deep Agents 的上下文管理 的博文对这两点有更详细的介绍。
技能(Skills):仅在需要时加载信息
假设你的销售团队对季度业务回顾有特定的格式。智能体每季度只需要这些指令一次,因此把它们放在系统提示词中意味着每次调用都要为它们付费(以 token 和响应时间为代价)。更好的做法是,你可以把这些信息打包成一个技能。
技能是一个包含指令(以及可选的脚本和参考文档)的文件夹,为智能体提供完成专门任务所需的资料。
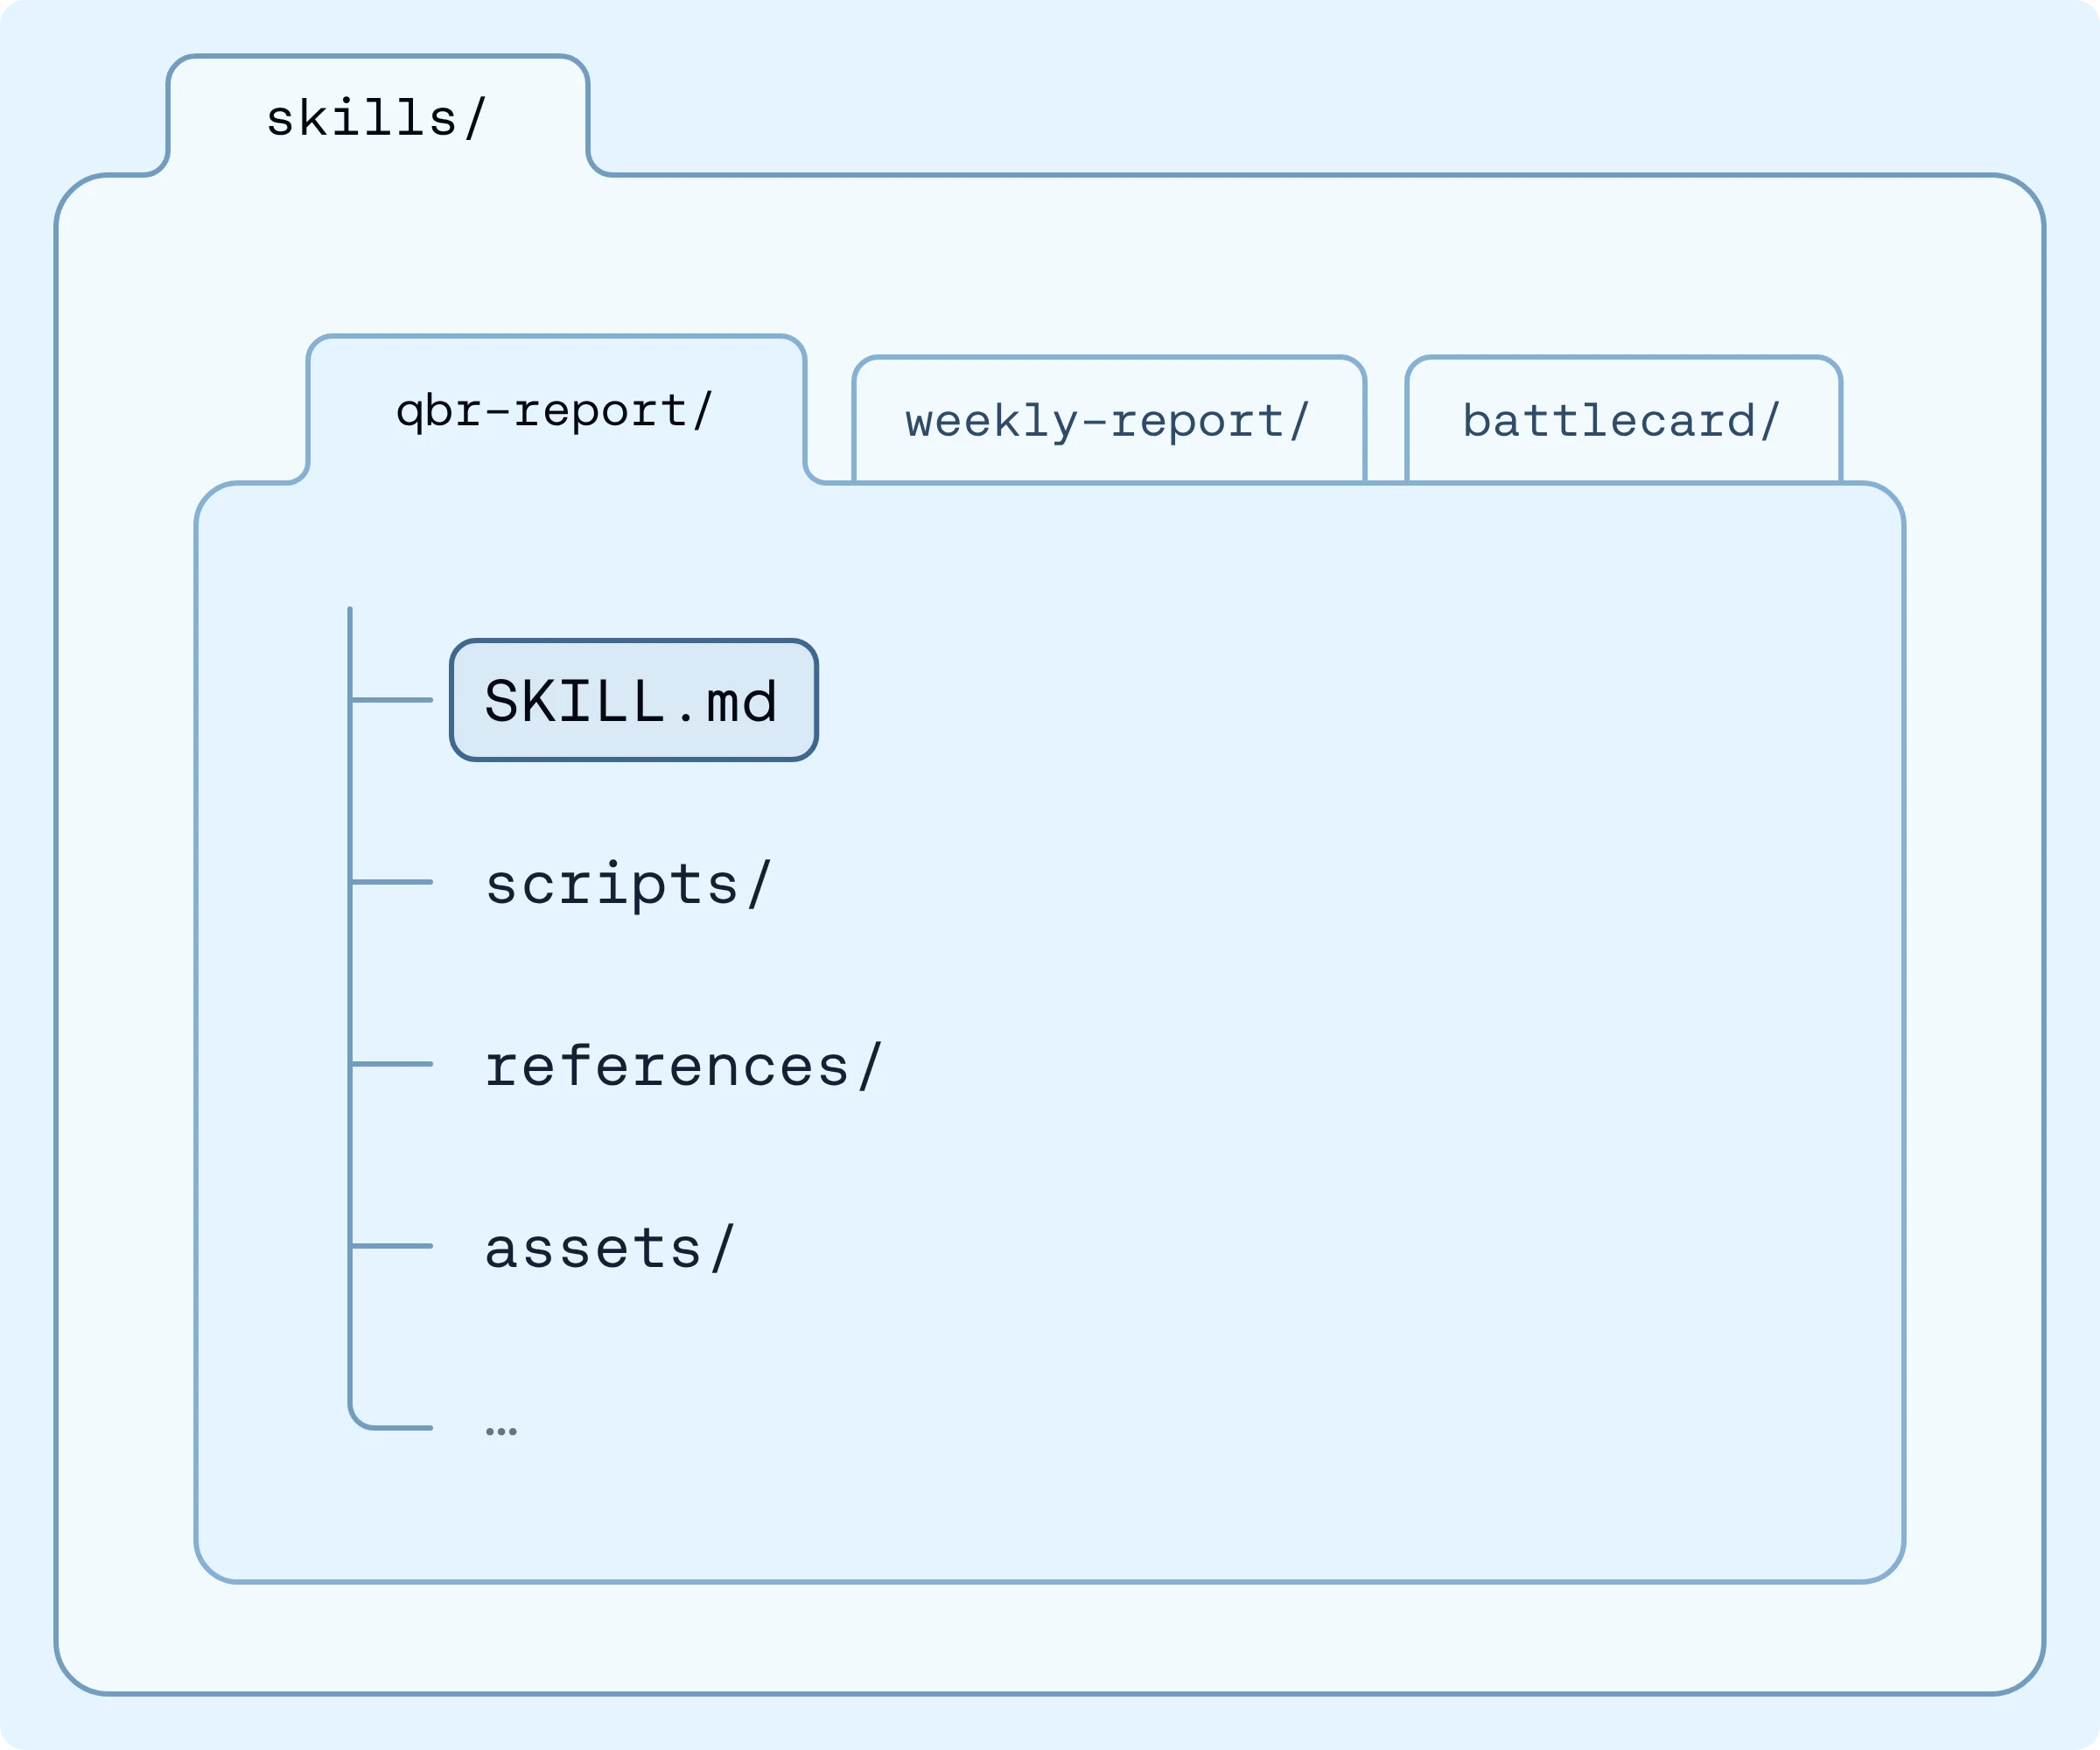
智能体一开始只看到一段简短的描述,只有当 QBR 到来时才会加载 qbr-report 的完整指令(其他任务从不携带这些指令)。
技能以分层方式加载上下文,因此只有在某些内容真正相关时,上下文窗口才会变大。这被称为渐进式披露(progressive disclosure):模型一开始只看到一个“菜单”,在需要时才拉入完整的方案,因此十个技能所占用的上下文大约相当于十行单行简介。
你将代理指向你的技能,SkillsMiddleware 使用两个钩子:
- 在智能体启动之前,它会扫描 skills 文件夹并仅读取每个 SKILL.md 的头部。
- 在每次模型调用时,它都会将这些名称和描述添加到系统提示词中。
完整的指令只有在模型判断某项技能相关时才会进入上下文(并通过 read_file 工具读取它),因此我们的智能体在没有模板的情况下进行研究,只在需要格式化 QBR 时才加载它。
子代理:隔离嘈杂的工作
卸载(offloading)能有效应对过大的结果,但对于你本来就已经……的工作而言,子代理是一个不错的*设计*选择。 知道 会变得嘈杂(例如,通过数十次搜索和多个页面来调研一家公司)。子代理会在自己的上下文窗口中完成这项工作,并只返回最终结果,这样主代理就永远看不到那些“噪音”。
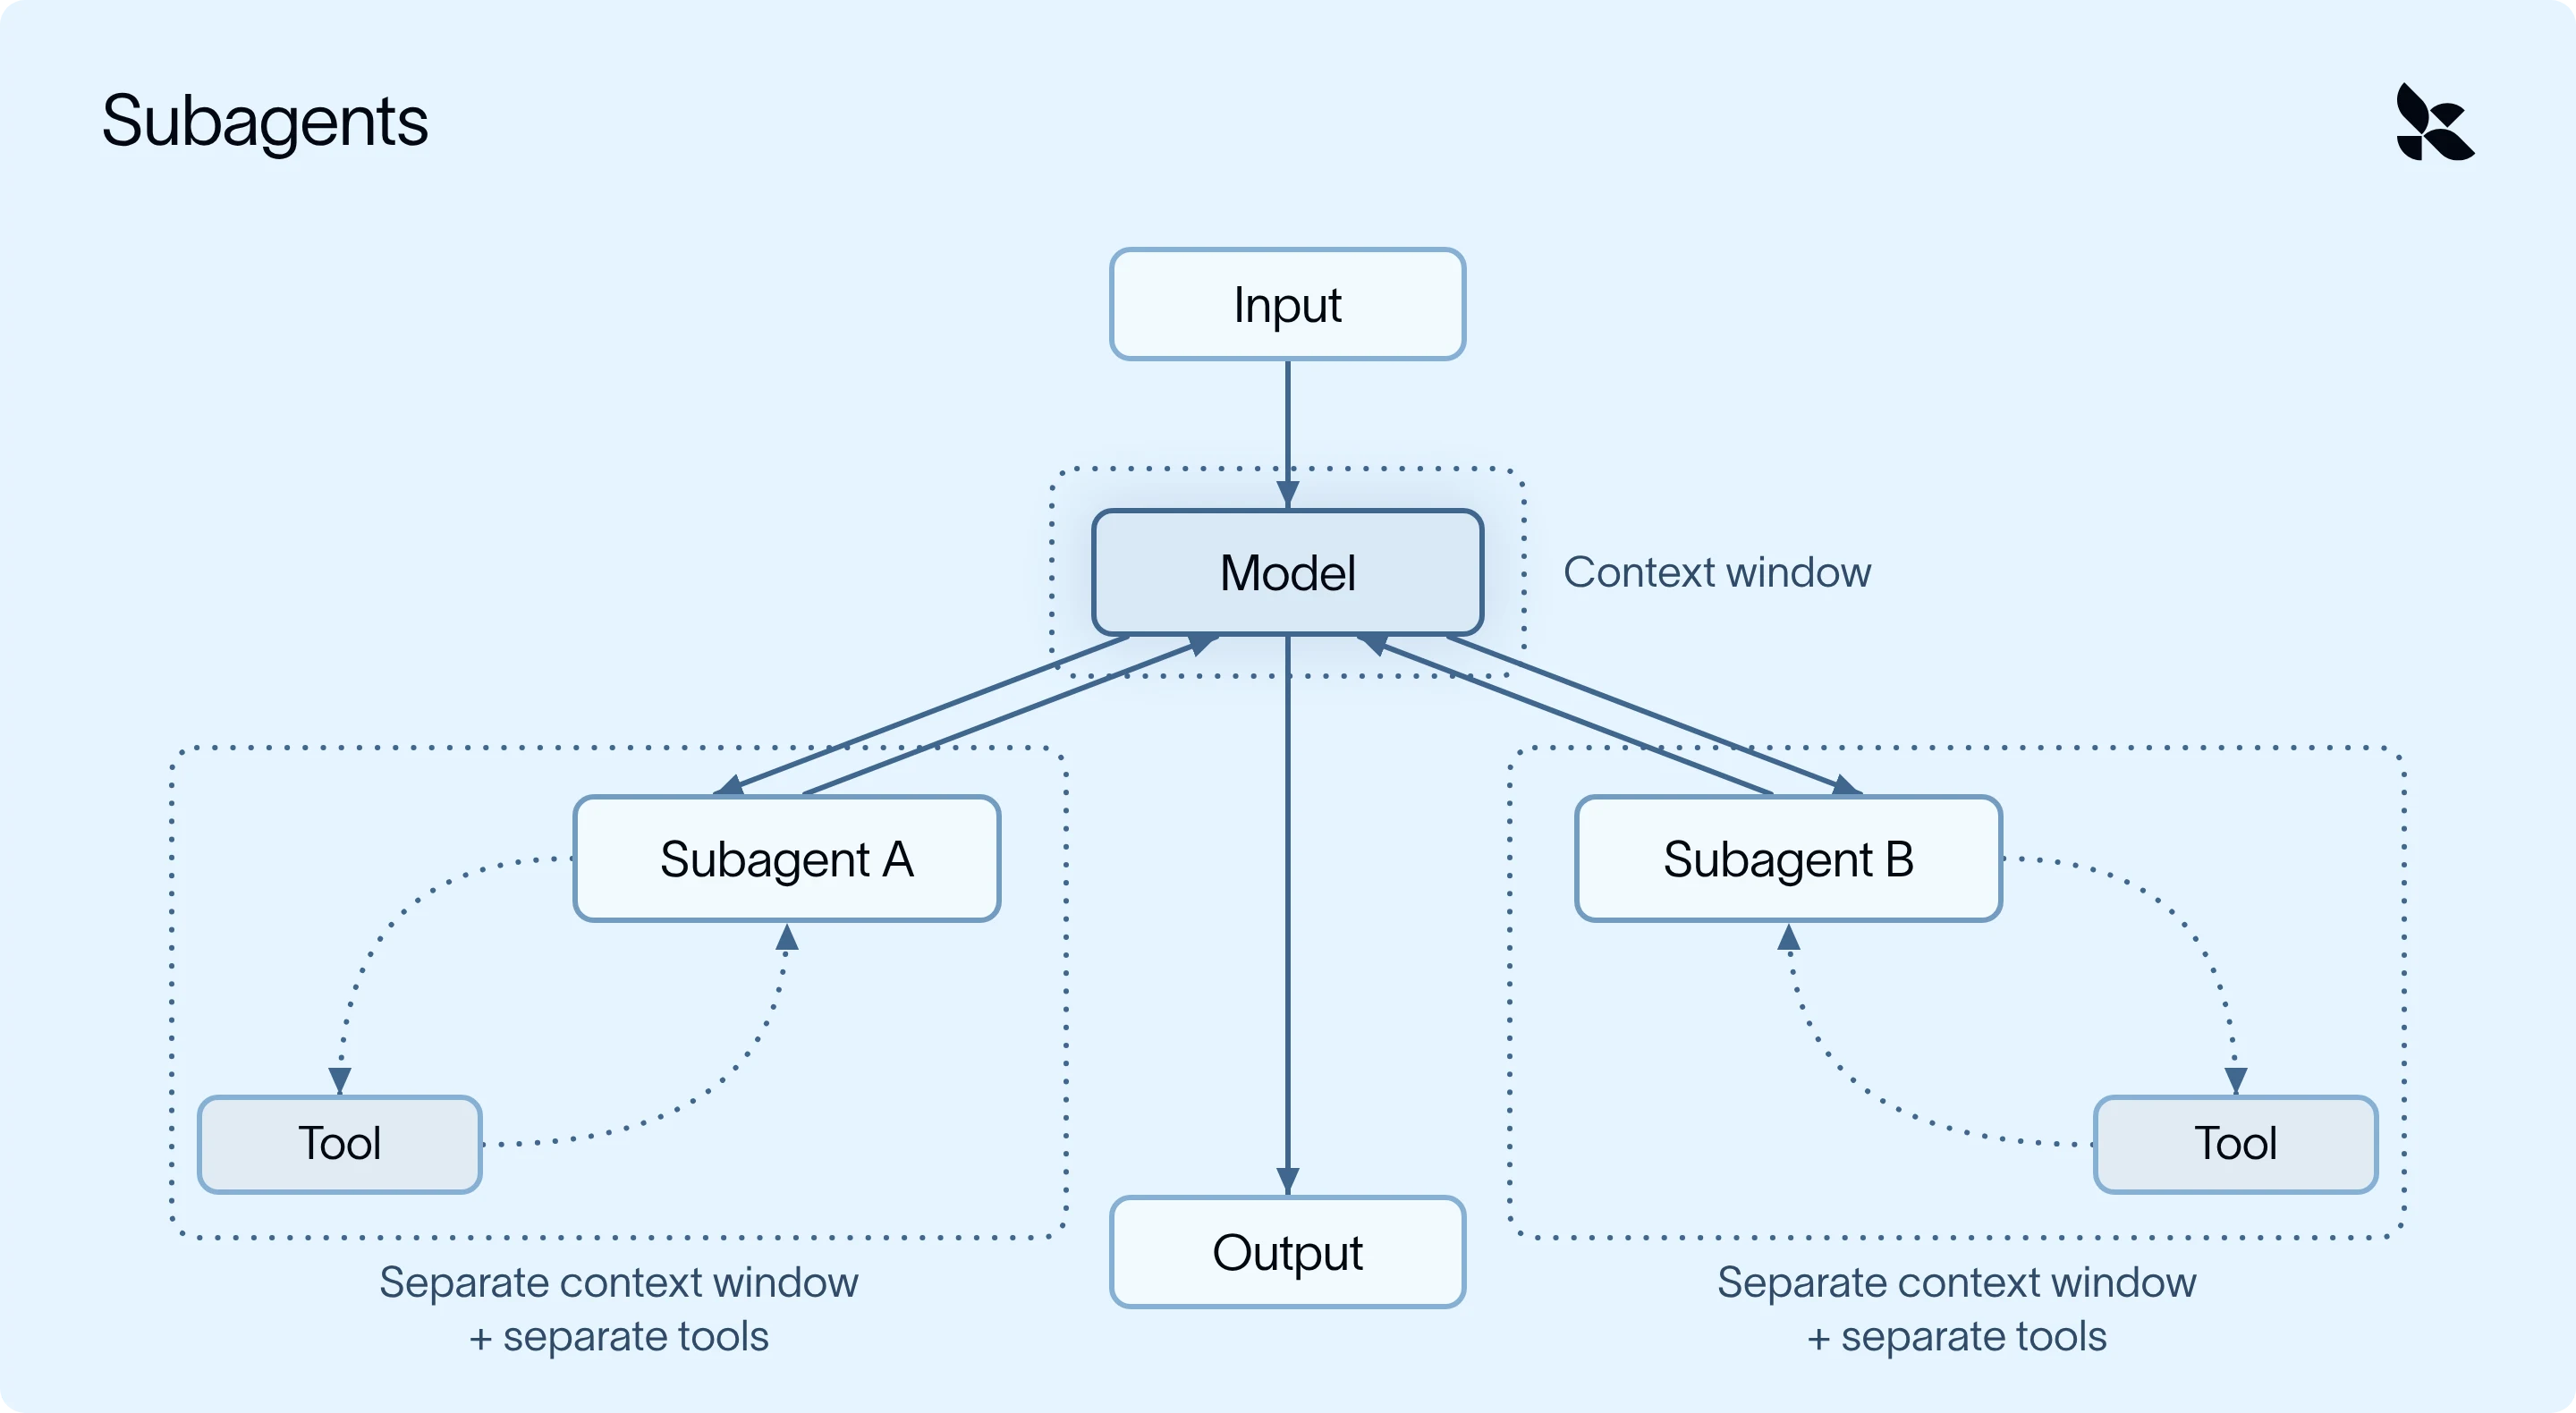
SubAgentMiddleware 允许我们自定义子代理可用的系统提示词和工具。
market_researcher = {
    "name": "market-researcher",
    "description": "Researches a company and returns the 3 most notable developments.",
    "system_prompt": "Use pull_market_report, then return 3 short bullet points. Do not return the raw report.",
    "tools": [pull_market_report],
}

agent = create_deep_agent(model=model, subagents=[market_researcher])
在我们的案例中,主智能体会把每家公司交给市场调研子智能体。
研究子代理在自己的上下文中阅读完整报告,并只返回三条要点,因此主代理只会看到这三条要点(甚至不会看到原始报告的预览)。此外,由于子代理的任务通常规模小且范围明确,它们往往可以在更便宜的模型上并行运行。
长期记忆:跨对话持久保存
到最后,你的智能体将学到很多东西。其中一些有用,一些没用。
假设你告诉你的智能体:“在摘要中使用要点,而不是段落。”如果没有记忆,你可能每周都得重复这句话。在 Deep Agents 中,长期记忆是一个 markdown 文件。你只需用一个参数将其指向该文件,MemoryMiddleware 会处理其余工作:
- 加载: 该文件在运行开始时被读取。
- 注入: 其内容会在每次模型调用时被添加到系统提示词中。
- 更新: 当智能体学到值得保留的内容(例如你的格式偏好)时,它会更新该文件。
更换模型,保留记忆
Deep Agents 与提供商无关,这一点也延伸到了记忆功能。由于记忆是你自己存储中的一个普通文件(而不是由提供商保管的),你可以将同一个后端指向不同的模型:
agent = create_deep_agent(
    model="openai:gpt-6",  # different provider, same memory
    memory=["/memories/AGENTS.md"],
    backend=backend,
    store=store,
)
下周,另一个模型可以读取同一个文件,并仍然以要点形式撰写摘要。
值得牢记的上下文工程策略
无论你是基于 Deep Agents 构建、使用其他工具框架,还是自己动手搭建,以下是一些需要注意的事项:
- 大型输入应当被卸载,而不是截断。 截断是有损的;卸载则使其仍可检索。
- 压缩应该是可恢复的。 摘要化之后,代理仍然可以取回它所需的细节。
- 专业知识应按需加载。 系统提示中每个任务的指令在每次调用时都会消耗上下文。
- 嘈杂的工作应当被隔离。 拥有独立上下文的子代理能让主代理保持专注。
- 你应当拥有这份记忆。 存储在你掌控之下的记忆能在更换模型或提供商后依然留存。
- 默认设置应当可以自定义。 适合某项任务的阈值很少能适合所有任务。
试一试
uv add deepagents想跟讲师现场学习更多内容?我将在11月3日进行讲解:注册 此处!
想深入了解上下文工程,请查看我们免费、自主进度的 LangChain Academy 深度代理(Deep Agents)课程。